SAM 3 / 3.1 是什么?
SAM 3 是 Meta Segment Anything Model 系列的新模型。
以前的 SAM 说到底只能 看出物体的形状,想切出指定的对象,还得用 BBOX 或坐标告诉它位置。
SAM 3 则可以像 VLM 一样用文本指定对象,靠它自己就能完成分割。
SAM 3.1 是 SAM 3 的更新版,改进了视频中多个对象的追踪处理。
下载模型
- sam3.1_multiplex_fp16.safetensors (1.75 GB)
📂ComfyUI/
└── 📂models/
    └── 📂checkpoints/
        └── sam3.1_multiplex_fp16.safetensors
工作流
静态图像
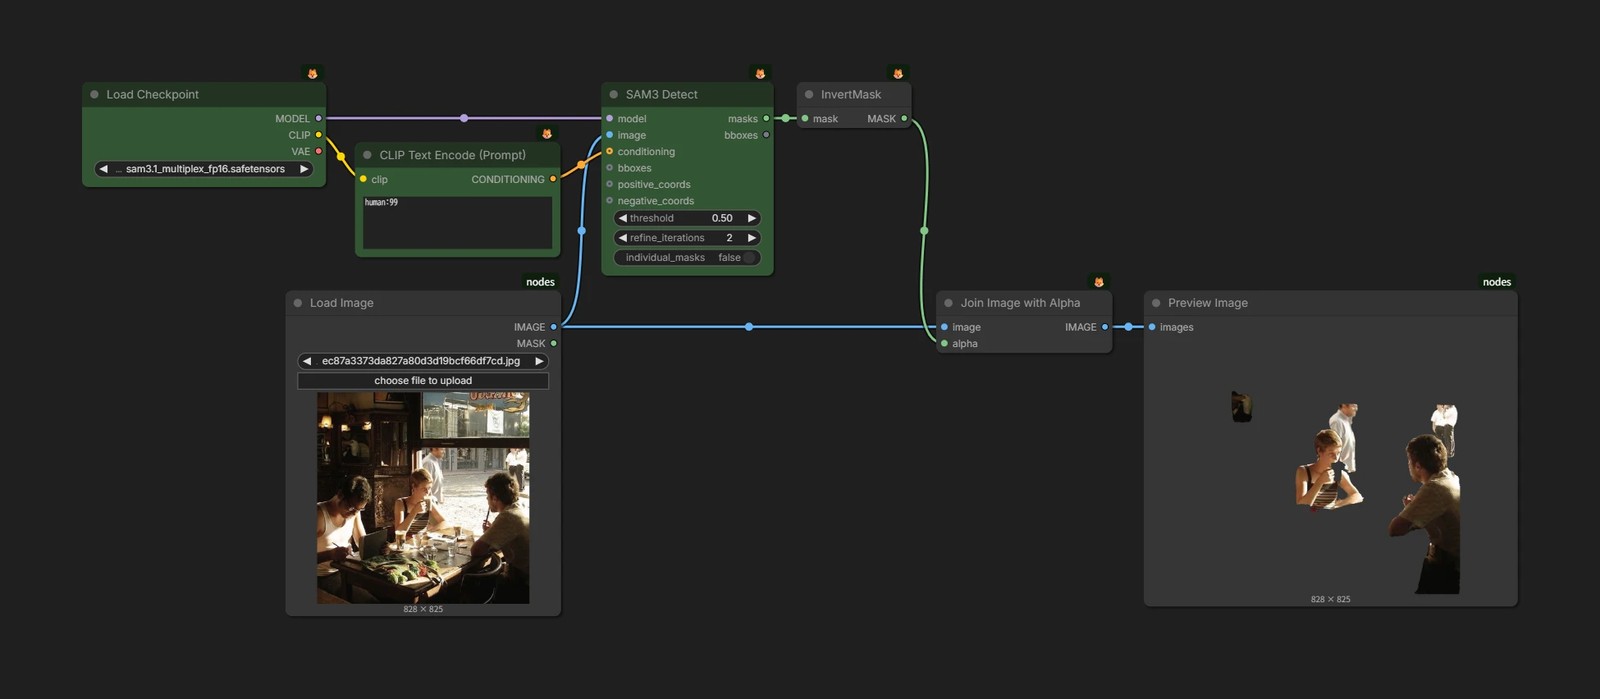
- 向
SAM3 Detect节点输入图像、蒙版,以及想切出的对象信息(文本提示词、BBOX、坐标)。 - 这里的规则有点绕:如果有多个对象符合提示词,只写
car的话,只会检测出其中最像的那一个。- 想分割出前 N 个,需要写成
car:N。 - 如果只是想把画面里出现的对象全部检测出来,直接写
car:99也无妨。
- 想分割出前 N 个,需要写成
视频
- 使用
SAM3 Video Track节点。 - 把输出传给
SAM3 Track to Mask节点,就能当作蒙版使用。 - 给
SAM3 Track Preview节点输入图像和track_data,它会给蒙版部分上色,方便查看。