什么是基于指令的图像编辑?
输入图像和文本指令(如果需要也可以输入参考图像),就会按照该指令编辑图像的模型,本网站称之为 基于指令的图像编辑模型。
以前,
- 画风转换 → LoRA 或 IP-Adapter
- 对象的去除・替换 → inpainting
- 换装 → 专用模型
像这样,必须针对每个任务构建不同的技术或工作流。
基于指令的图像编辑模型,是将这些任务进化为 “全部通过文本指令汇总处理” 的方向。 目前作为 SOTA 的 nano banana 也属于这个范畴。
发展的历史
让我们大致了解一下基于指令的图像编辑是如何发展起来的。
InstructPix2Pix ― 指令编辑构想的出发点
随着 2023 年发布的 InstructPix2Pix,“基于指令的图像编辑”之路被开启了。

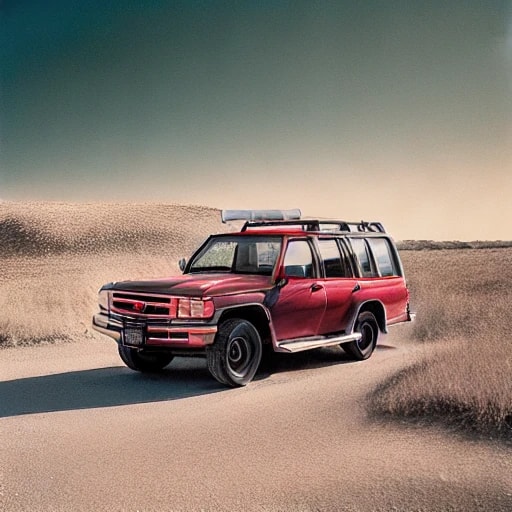
Turn the car red (把车变成红色)
该模型成对了学习“图像”和“对其的编辑指令文本”,旨在按照用户编写的指令编辑图像。
DiT 和 In-Context 系
这是后来发现的,Flux 等 DiT 系模型原本就具有 制作多张具有一致性图像的能力。
将这种性质应用到编辑中的框架就是 IC-LoRA / ACE++。
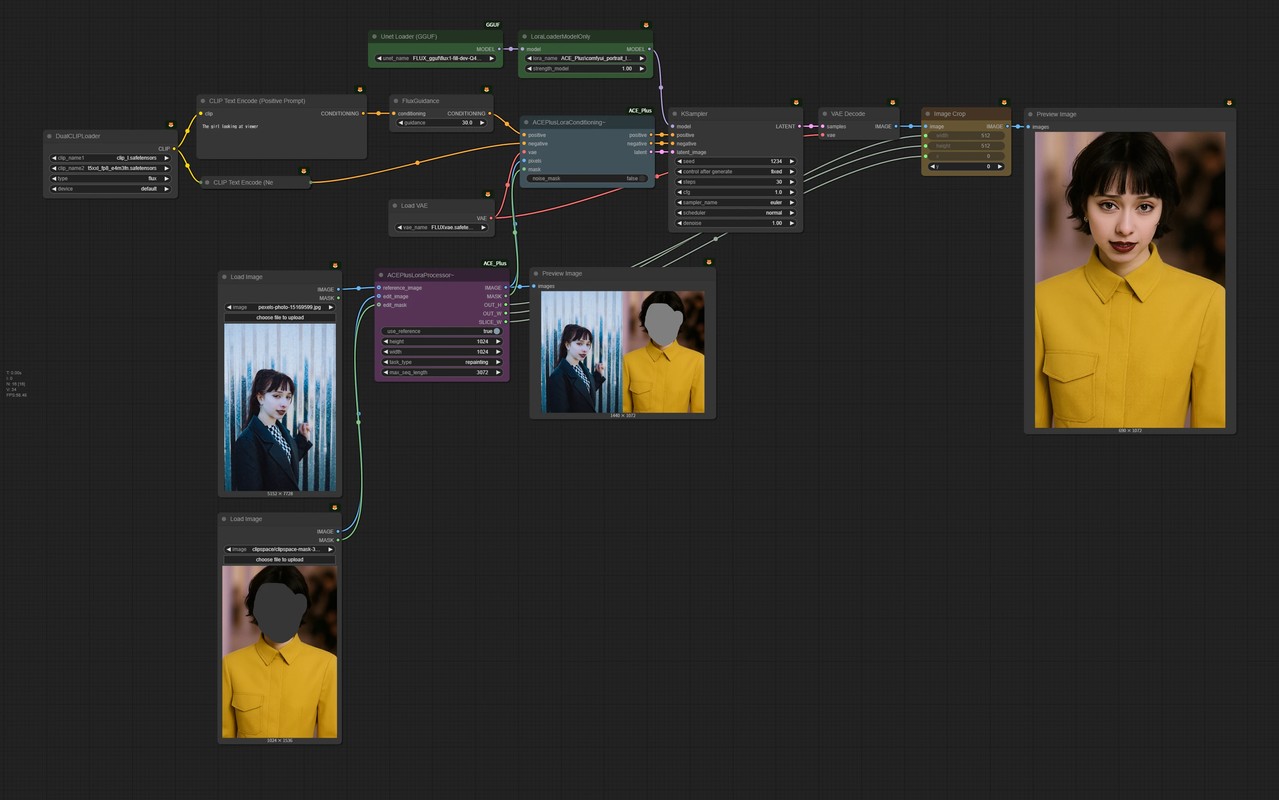
- 在图像画布的左侧放置“参考图像”
- 遮罩右侧并让其生成
- 结合文本指令,让它“看着左边编辑右边”
像这样,通过使用所谓的 并排技巧,证明了即使不通过特殊的适配器也能“保持参考图像的特征进行编辑”。
图像编辑模型的登场
之后,作为 text2image 模型的衍生,FLUX.1 Kontext、Qwen-Image-Edit、OmniGen 等“图像编辑”专用的模型登场,“图像编辑”开始被视为与 text2image 不同的一个类别。
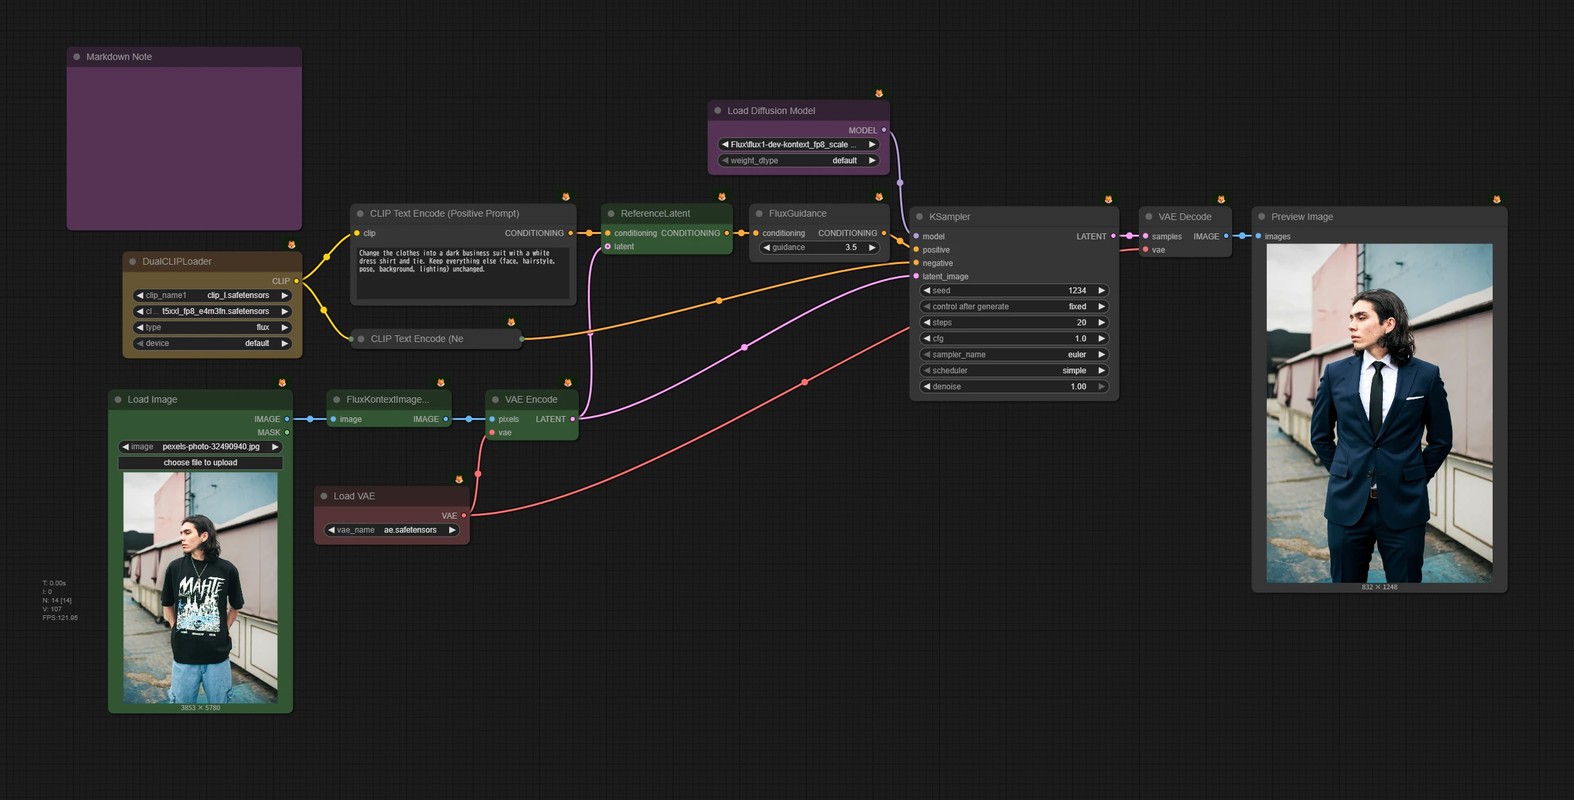
共同点是,通过一个模型(某种程度上)通用地处理理解输入图像的内容,根据文本指令调整“哪里改变多少”这样的编辑任务。
多参考时代
初期的基于指令的图像编辑,是以“图像 1 张”+“文本指令”→ 编辑结果这种 1 输入图像为前提的。
Qwen-Image-Edit-2509 或 Flux.2 以后,同时处理多个参考图像的趋势变强了。
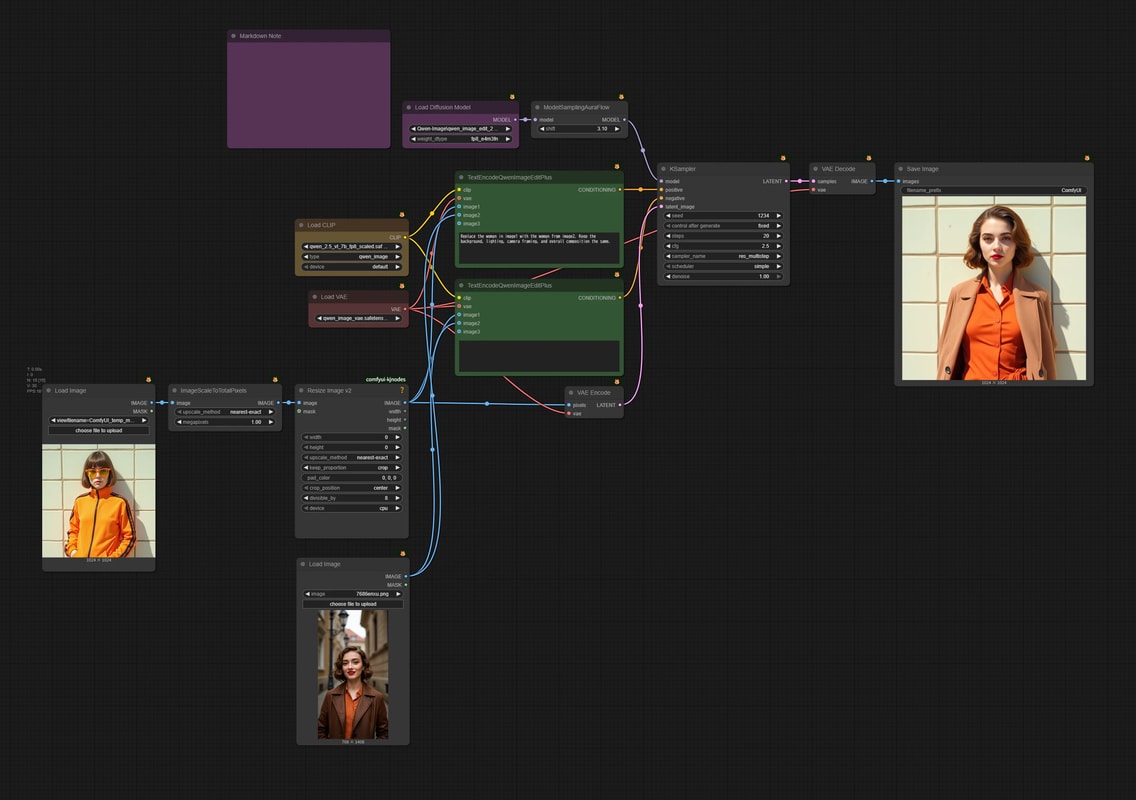
- 图像 A:人物(Subject)
- 图像 B:衣服(换装用)
- 图像 C:背景或风格
像这样,可以“混合”多个参考进行编辑,Subject 转移、ID 转移、换装、风格・光照的移植等任务,与基于指令的编辑开始有了相当大的重叠。
基于视频模型的编辑
作为另一个潮流,有将视频生成模型转用于编辑的系统。FramePack 的 1 帧推理 或 ChronoEdit 等是代表性的。
其思路是,视频模型原本就能处理“多帧的一致性”,如果把编辑前和编辑后视为“短视频”,那么即使是巨大的变化也能自然地连接起来。
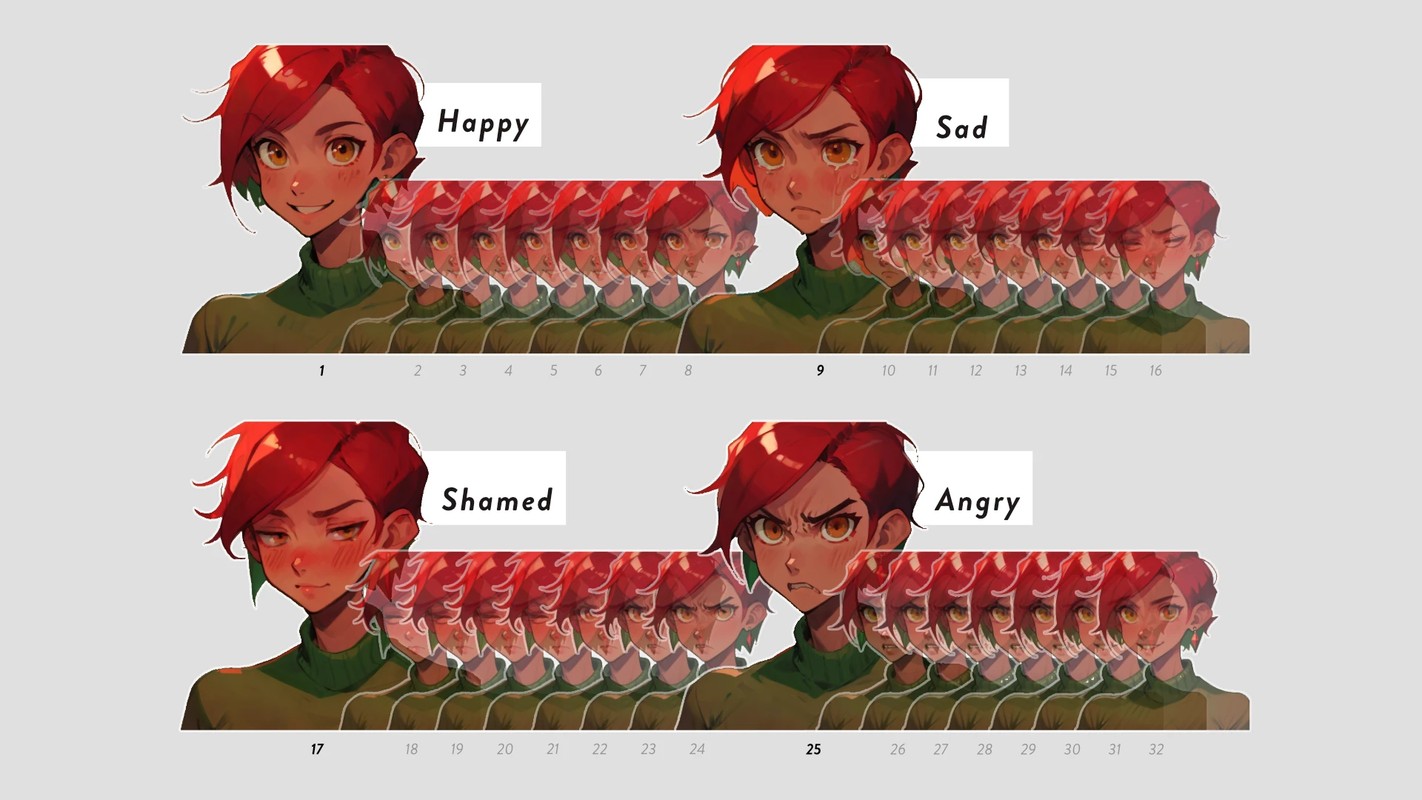
这个想法本身很早就有了,我在 AnimateDiff 是主流的时代,也做过制作做出各种表情的角色动画,来制作角色差分(Variations)这样的事情。
虽然还有很多问题,比如一致性太强导致难以进行大的变化,或者作为图像编辑只需要 1 张却作为视频输出了几十帧等,但这是今后值得关注的技术。
基于指令的图像编辑能做的事情
基于指令的图像编辑模型能处理的任务相当多,本网站会在个别页面详细介绍,这里先大致整理一下名字。
画风转换
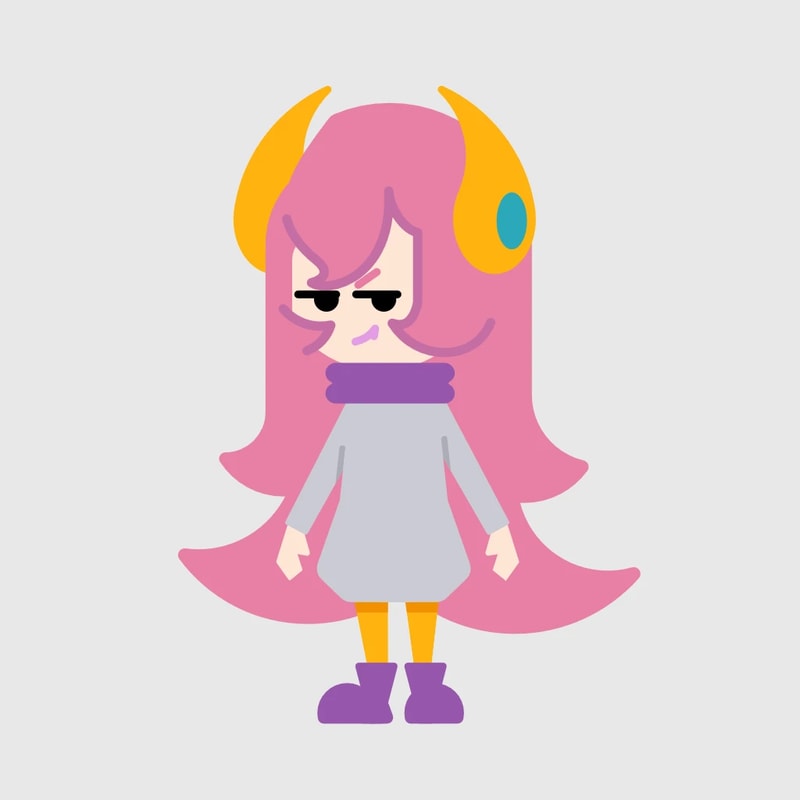
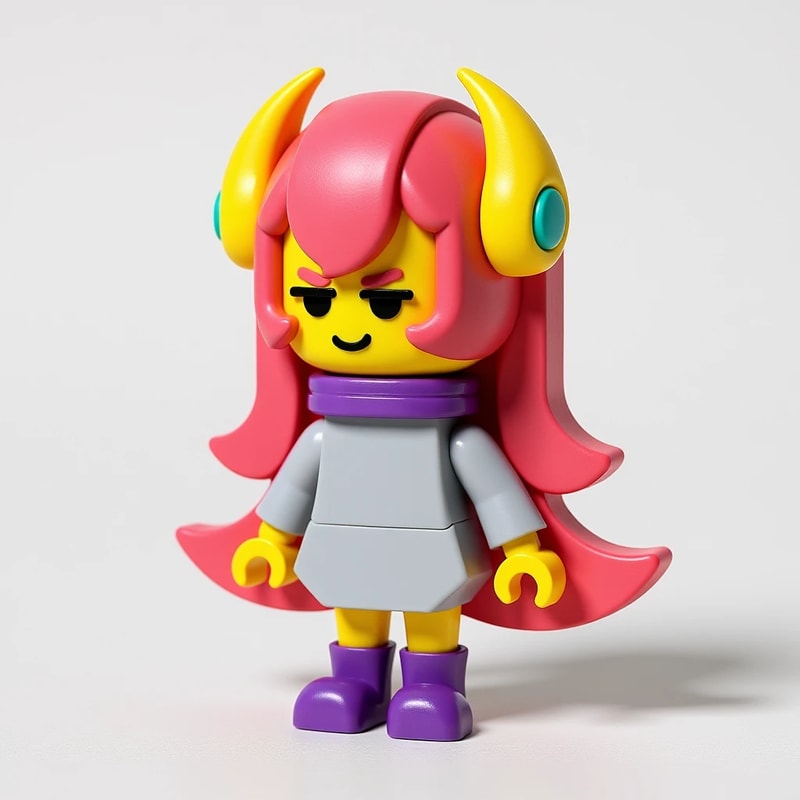
改变画风或风格,通过“油画风”、“变成动漫风”等指令进行转换。
对象替换
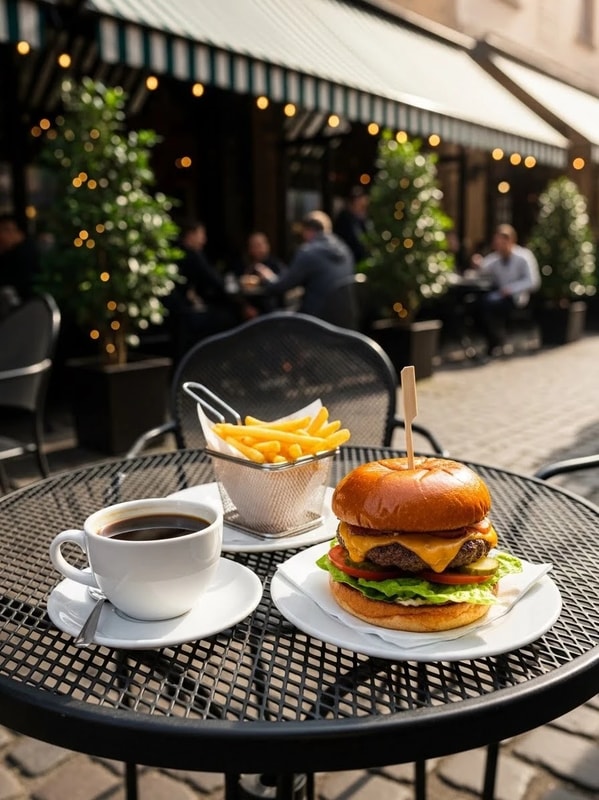
进行“把这个杯子变成马克杯”、“把车变成摩托车”等替换。
对象去除
去除行人、看板、垃圾等“不需要的东西”的任务。
背景变更
室内→海边、白天→夜晚等,只改变背景的编辑。
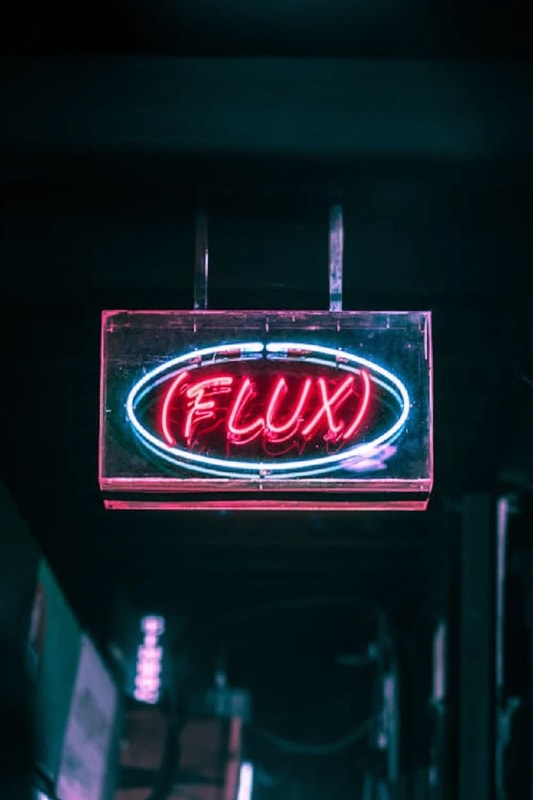
文本编辑
改变看板或包装上的文字,替换排版等。
摄像机角度的变更
“稍微拉远点”、“低角度”、“从侧面看的构图”等,进行构图方面的变更。
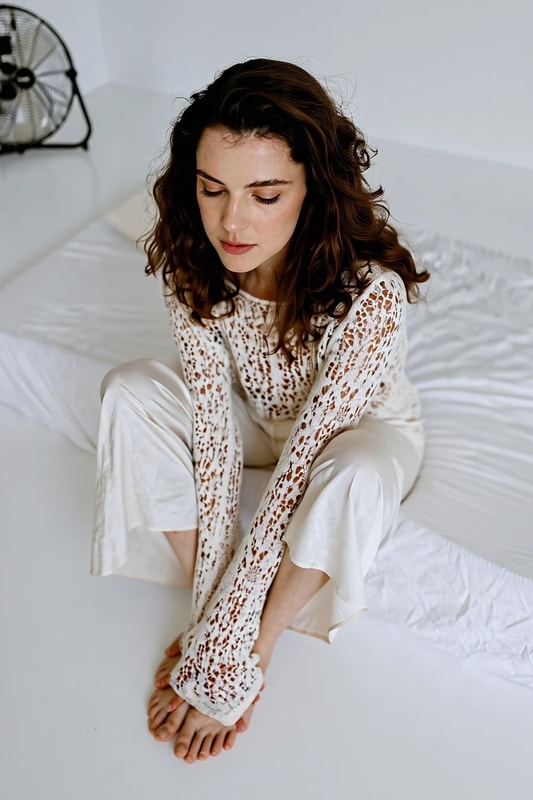
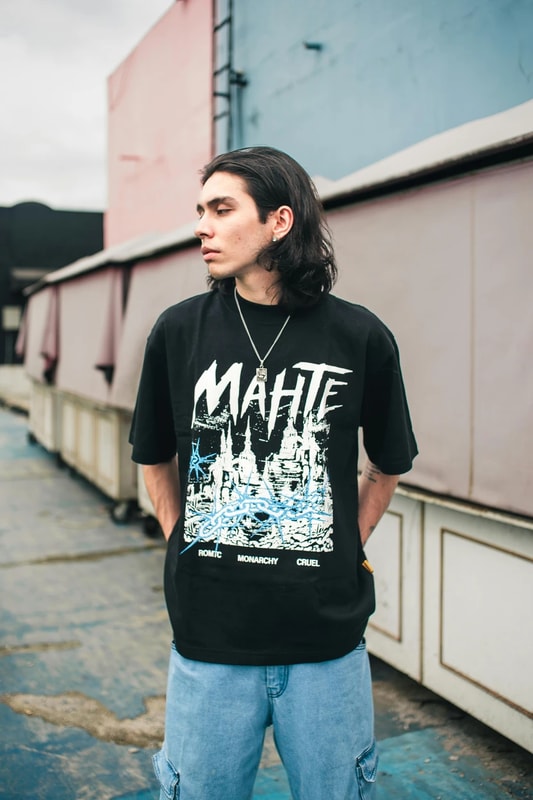
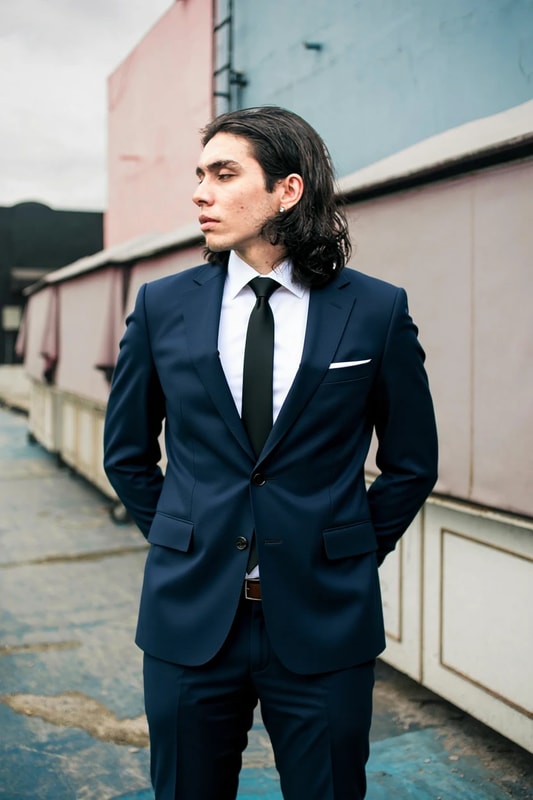
换装
改变人物或角色的服装的任务。
ControlNet 式生成
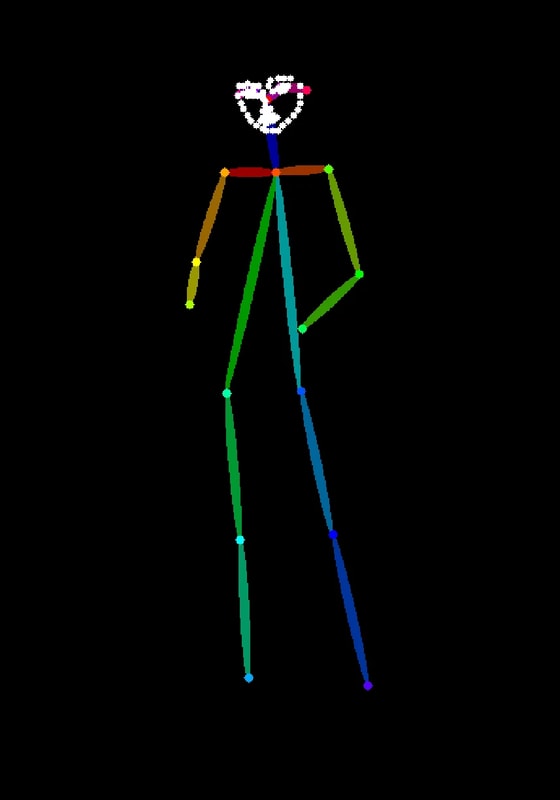
ControlNet 是火柴人或深度图等条件 + 文本进行图像生成的,这可以被视为一种“基于指令的图像编辑”。 现在的基于指令的图像编辑模型被训练为可以进行基本的 ControlNet 式图像生成。
杂项拼贴的优化
制作拼贴图像(杂项拼贴),并让其“编辑”使得看起来自然的任务。
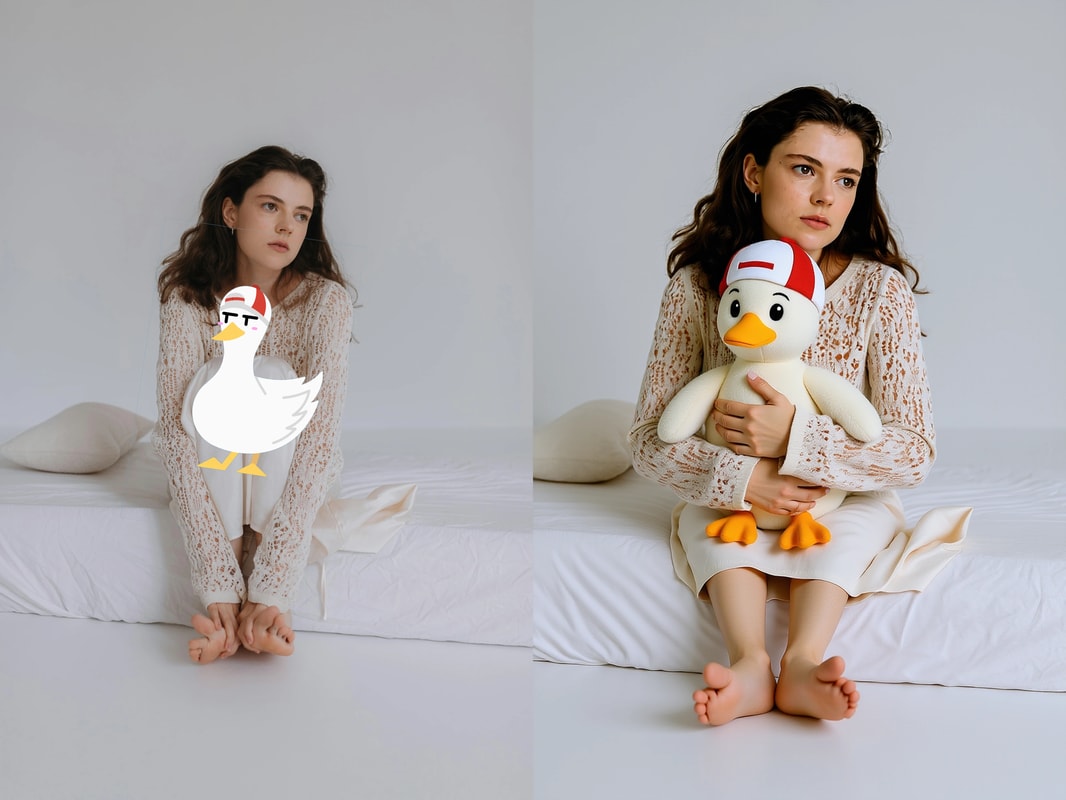
- 自己决定位置・大小并粘贴对象
- 然后指示“变成自然的照片”、“作为一张画没有违和感”
像这样,可以组合直观的布局指定和基于指令的编辑。 详情在“杂项拼贴的优化”页面介绍。
涂鸦指示
“让脸也朝向箭头的方向”、“在这个红圈的地方放一辆巴士”等,结合粗略的涂鸦和文本进行指示。
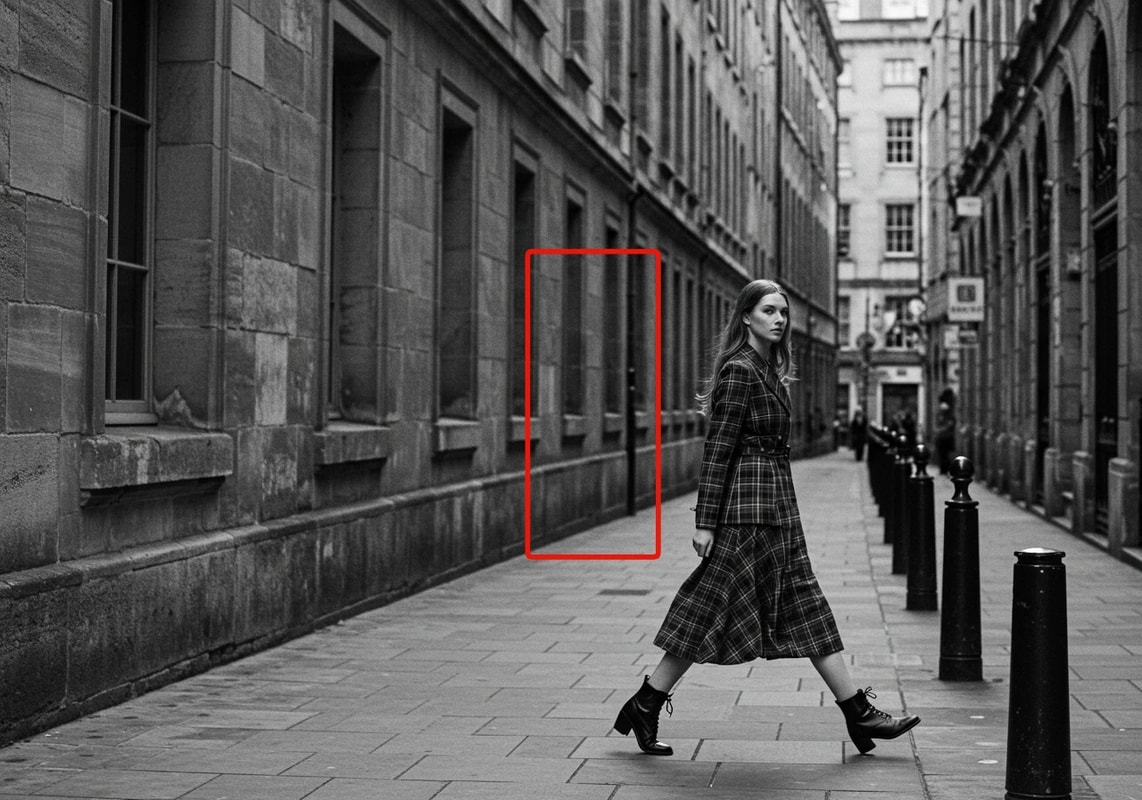
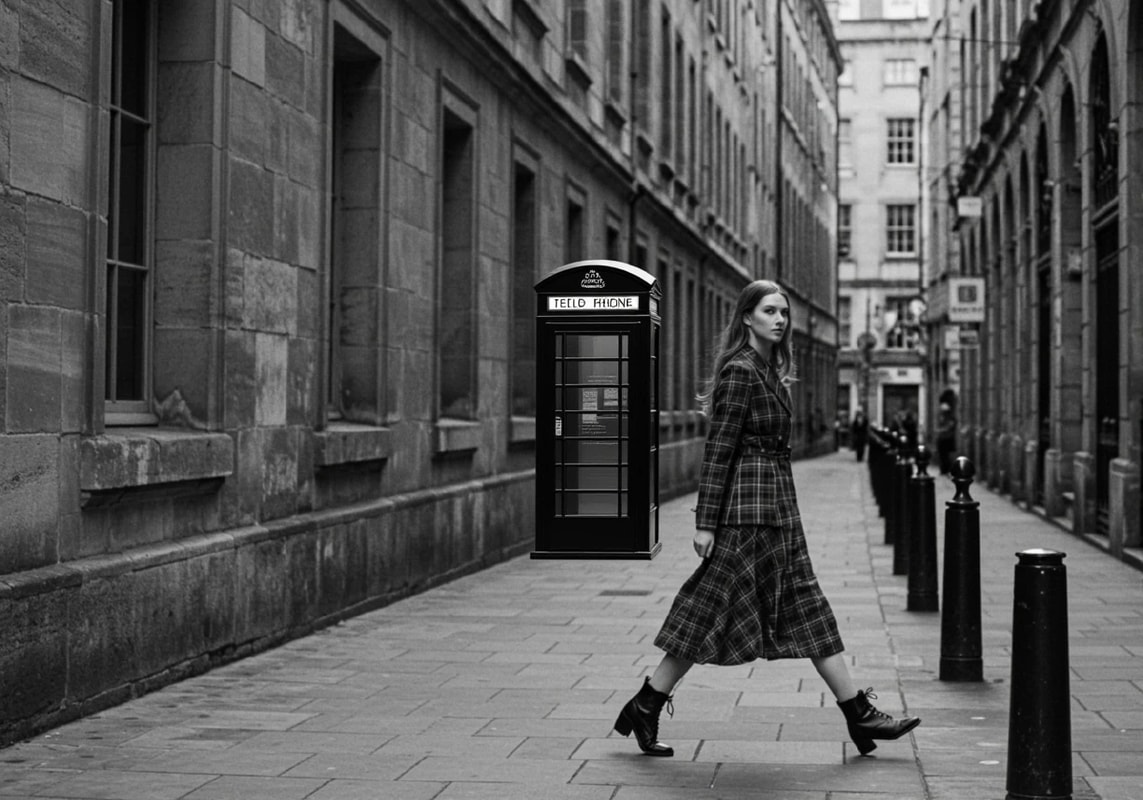
基于指令的图像编辑的弱点是,仅靠文本很难表现具体的位置和变化量。 就像制作人向设计师用笔进行指示一样,对 AI 也能“用笔指示”的话就理想了。
开源模型中能充分做到这一点的还不多,但如果完成了,将是理想的与 AI 协作的 UI/UX。
容易制作 LoRA
多亏了社区整顿的训练环境,制作编辑用 LoRA 相对容易。
如果是转换成自己插图画风的 LoRA,只要准备 10 张左右编辑前图像和编辑后图像的配对,就能制作出一定质量的 LoRA。
“杂项拼贴的优化”正是如此,但把什么视为“图像编辑”?实际上是一个自由度很高的问题。 也许会有还未被发现的革新性编辑。请务必挑战一下!