什么是 Wan2.1?
Wan2.1 是阿里巴巴开发的开源视频生成模型。
可以说是开源界正式进行视频生成的导火索,是令人印象深刻的模型。
支持 text2video、image2video、FLF2V 这 3 种模式。
另外,通过只生成 1 帧,也可以作为图像生成模型使用。
虽然是细节,但这并不是“视频生成包含图像生成”,而是 从一开始就被设计为也能进行图像生成的视频生成模型。
准备了 1.3B 和 14B 这 2 个模型尺寸,但 1.3B 实在是性能不足几乎不被使用,所以这里只使用 14B。
推荐设定
- 推荐分辨率
- 480p(854×480)〜 720p(1280×720)
- 最大帧数
- 81 帧
- FPS
- 经常以 16fps 附近输出
如果是 16fps 的话经常会变成像慢动作一样的视频,所以请以 24fps 保存,或者用丢帧来调整。
模型的下载
- diffusion models
- text encoder
- VAE
- gguf (任意)
📂ComfyUI/
└── 📂models/
    ├── 📂diffusion_models/
    │   ├── wan2.1_t2v_14B_fp8_e4m3fn.safetensors
    │   ├── wan2.1_i2v_720p_14B_fp8_e4m3fn.safetensors
    │   └── wan2.1_flf2v_720p_14B_fp8_e4m3fn.safetensors
    ├── 📂text_encoders/
    │   └── umt5_xxl_fp8_e4m3fn_scaled.safetensors
    ├── 📂unet/
    │   ├── wan2.1-t2v-14b-XXXX.gguf          ← 仅在使用 gguf 时
    │   ├── wan2.1-i2v-14b-720p-XXXX.gguf     ← 仅在使用 gguf 时
    │   └── wan2.1-flf2v-14b-720p-XXXX.gguf   ← 仅在使用 gguf 时
    └── 📂vae/
        └── wan_2.1_vae.safetensors
如果想使用 fp16 / bf16 版,请替换上面的 fp8 的文件名。基本的配置路径是相同的。
text2video
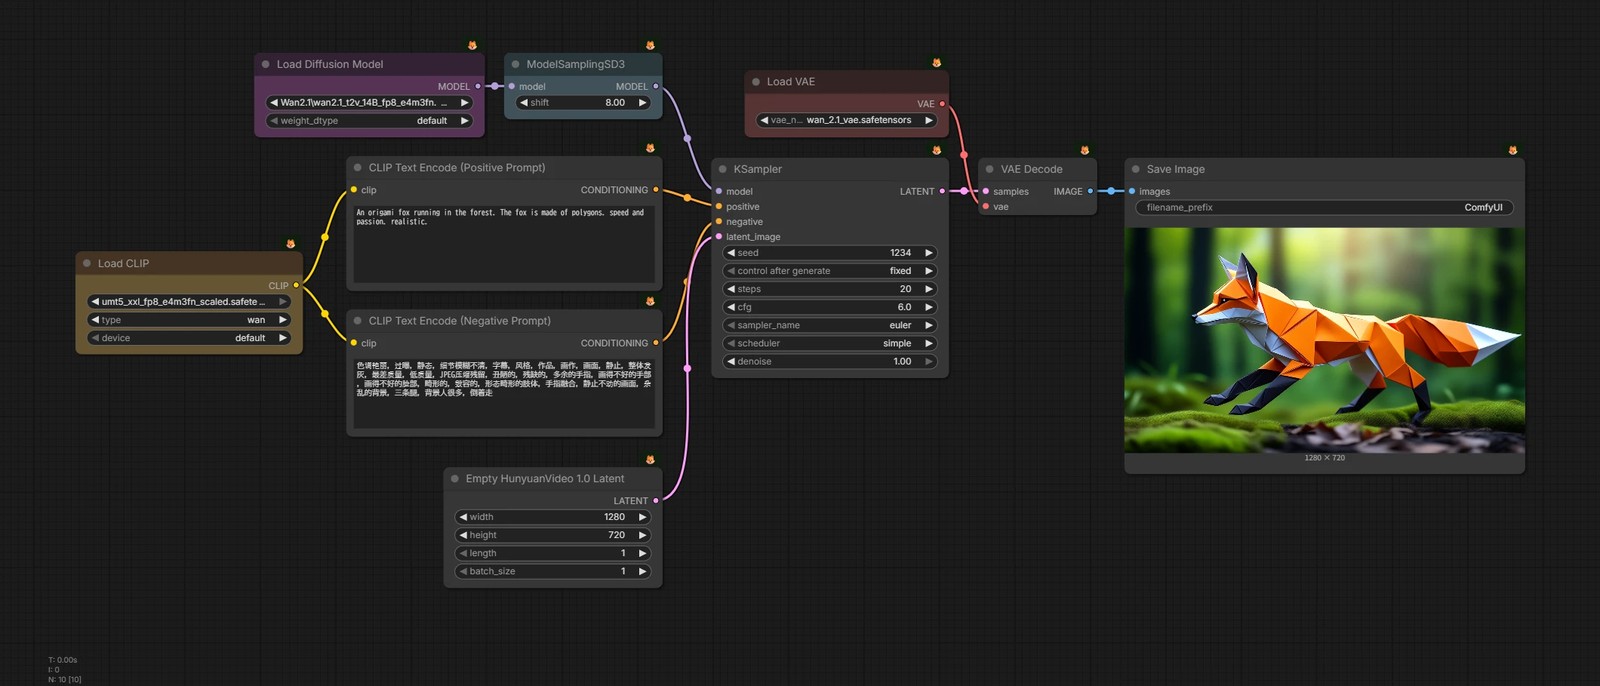
Wan2.1 的基础 text2video 的工作流。
-
🟦
ModelSamplingSD3节点的Shift是对动作幅度生效的参数。- 越提高运镜和被摄体的变化就越大,但太大的话会成为崩溃的原因。姑且保持
8没问题吧。 - cf. Wan2.1 parameter sweep
- 越提高运镜和被摄体的变化就越大,但太大的话会成为崩溃的原因。姑且保持
可能会提高品质的技术
虽然不是能体感到的程度,但作为核心节点实现了几乎没有缺点的提高品质的技术,所以用上吧。
-
🟦 UNetTemporalAttentionMultiply
- 增强帧间的一致性,抑制闪烁。
-
🟦 CFG-Zero
- 通过减弱采样序盘的 CFG,防止因过剩的修正导致的破绽。
image2video
给予图像的话,会从那个图像生成后续。
- 🟩 将适度调整尺寸的图像同时输入到
CLIP Vision Encode和WanImageToVideo。
FLF2V(First–Last Frame to Video)
给予 2 张图像,生成让其之间自然填补的视频。
- 🟩 将 2 张图像做成批次输入到
WanFirstLastFrameToVideo节点。
Self Forcing(高速生成)
本来是为了实时视频生成的技术,但在 ComfyUI 中作为单纯的通过数步生成的高速化手法使用。
模型的下载
-
loras
📂ComfyUI/
└── 📂models/
    └── 📂loras/
        ├── Wan21_T2V_14B_lightx2v_cfg_step_distill_lora_rank64.safetensors
        └── Wan21_I2V_14B_lightx2v_cfg_step_distill_lora_rank64.safetensors
工作流
- 在
LoraLoaderModelOnly节点读取 LoRA。 - 将
KSampler的steps设为 4 ~ 8,CFG设为 1.0。
Self Forcing 是“总之想高速运转时”的选择。
虽然不是无法容忍的程度,但劣化很大。
图像生成
即在 text2video 的工作流中,用 1 帧生成视频。