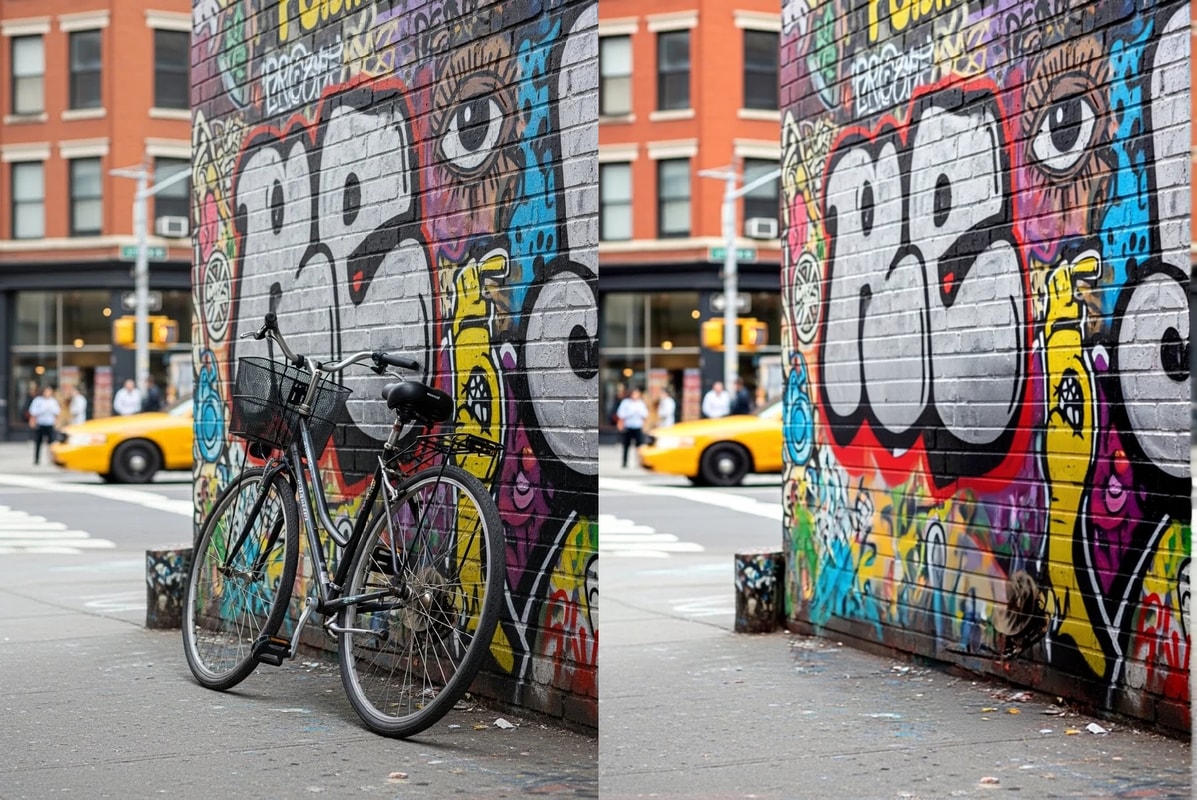
什么是 Qwen-Image-Edit?
Qwen-Image-Edit 是,以 Qwen-Image 为基础的 基于指示的图像编辑模型。
粗略地说,是 Flux.1 Kontext 的 Qwen-Image 版 这样的认识就可以。
Flux.1 Kontext 虽然只是基于 VAE 的编辑,但 Qwen-Image-Edit 可以使用 MLLM 实际上“看”参照图像,那分量能进行柔软的编辑。
其后过了一段时间,对应多参照的 Qwen-Image-Edit-2509 这个模型被发表了。
之前只是“编辑 1 张图像”,但在 Qwen-Image-Edit-2509 变得能做:
- “将图像 1 的人物的服装,变更为图像 2 的东西”
- “生成图像 1 和图像 2 站在同一个舞台的图像”
因为学习方法不同,2509 未必是无印版的上位互换,但迷茫的时候使用 2509 就可以吧。
Qwen-Image-Edit(无印)
关于能做什么,官方 GitHub、或 Flux.1 Kontext / 能做的事 也许也能作为参考。
模型的下载
-
diffusion_models
-
text_encoders
-
vae
-
gguf(任意)
-
QuantStack/Qwen-Image-Edit-GGUF
- 请选择 Q4_K_M 以上的模型。未满这个的话性能会一气下降。
- cf. Qwen-Image-Edit GGUF 模型比较
-
Qwen2.5-VL-7B-Instruct-mmproj-BF16.gguf
- 使用 gguf 的情况,这个 mmproj 文件是必须的。
-
📂ComfyUI/
└── 📂models/
    ├── 📂diffusion_models/
    │   └── qwen_image_edit_fp8_e4m3fn.safetensors
    ├── 📂text_encoders/
    │   ├── qwen_2.5_vl_7b_fp8_scaled.safetensors
    │   ├── Qwen2.5-VL-7B-Instruct.gguf                ← 仅在使用 gguf 的时候
    │   └── Qwen2.5-VL-7B-Instruct-mmproj-BF16.gguf    ← 仅在使用 gguf 的时候
    ├── 📂vae/
    │   └── qwen_image_vae.safetensors
    └── 📂unet/
        └── qwen-image-edit.gguf                       ← 仅在使用 gguf 的时候
工作流
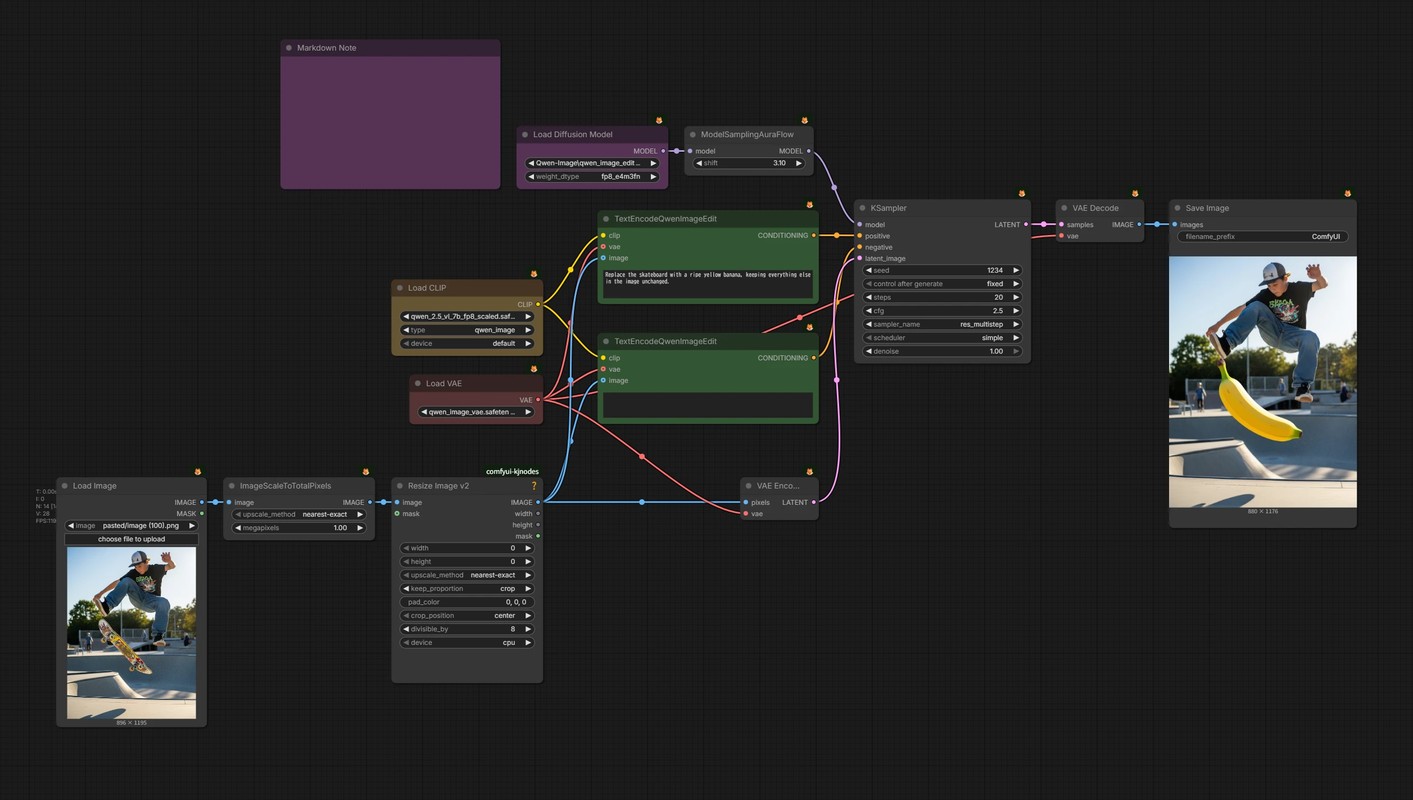
🟩 关于 TextEncodeQwenImageEdit 节点的举动,稍微补充一下。
在内部,粗略进行次那样的处理。
- 1. 将输入图像调整为 1M 像素程度
- 2. 从那个图像生成 latent
- 3. 文本+图像汇总传给 Qwen2.5-VL
因为自动进入图像的调整处理,生成的图像尺寸如果大大偏离 1M 像素,有变成非意图结果的可能性。
因此,在这个工作流预先进行了图像尺寸的下处理。
- 用
ImageScaleToTotalPixels节点调整为 1M 像素 - 用
Resize Image v2节点,让分辨率变为 8 的倍数那样裁剪
Qwen-Image-Edit,无论怎么工夫都无法“让输入图像和编辑后图像像素完美一致”。
虽然被提案了几个回避策略,但原本模型的设计就不是面向那种用途,这个前提最好先把握。
Qwen-Image-Edit-2509
Qwen-Image-Edit-2509 是,扩展了无印版的版本。 最大的区别是,可以输入复数枚参照图像。
模型的下载
-
diffusion_models
-
gguf(任意)
📂ComfyUI/
└── 📂models/
    ├── 📂diffusion_models/
    │   └── qwen_image_edit_2509_fp8_e4m3fn.safetensors
    └── 📂unet/
        └── qwen-image-edit-2509.gguf      ← 仅在使用 gguf 的时候
工作流(1 张)
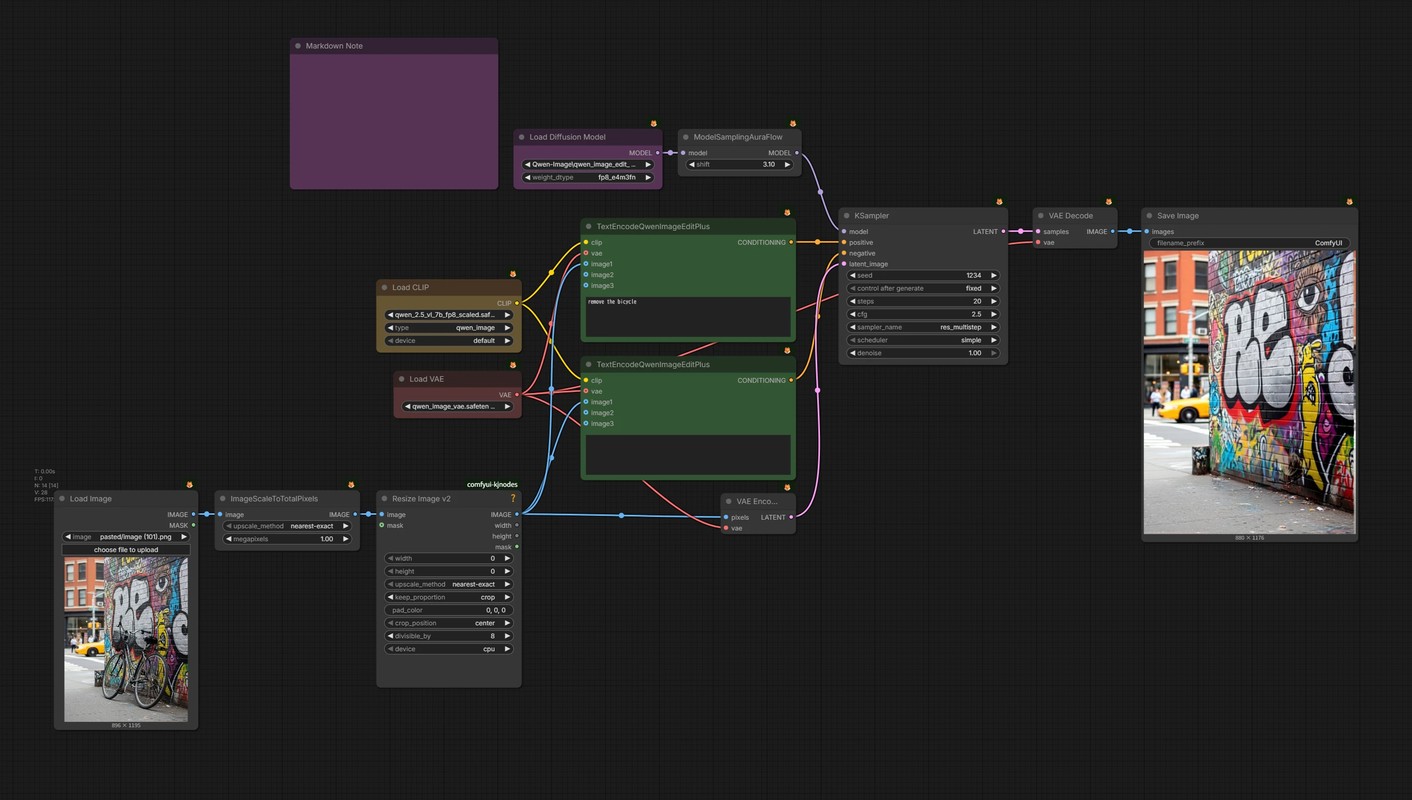
- 基本的流程与无印版相同,但将
TextEncodeQwenImageEdit节点替换为TextEncodeQwenImageEditPlus节点。
工作流(复数枚)
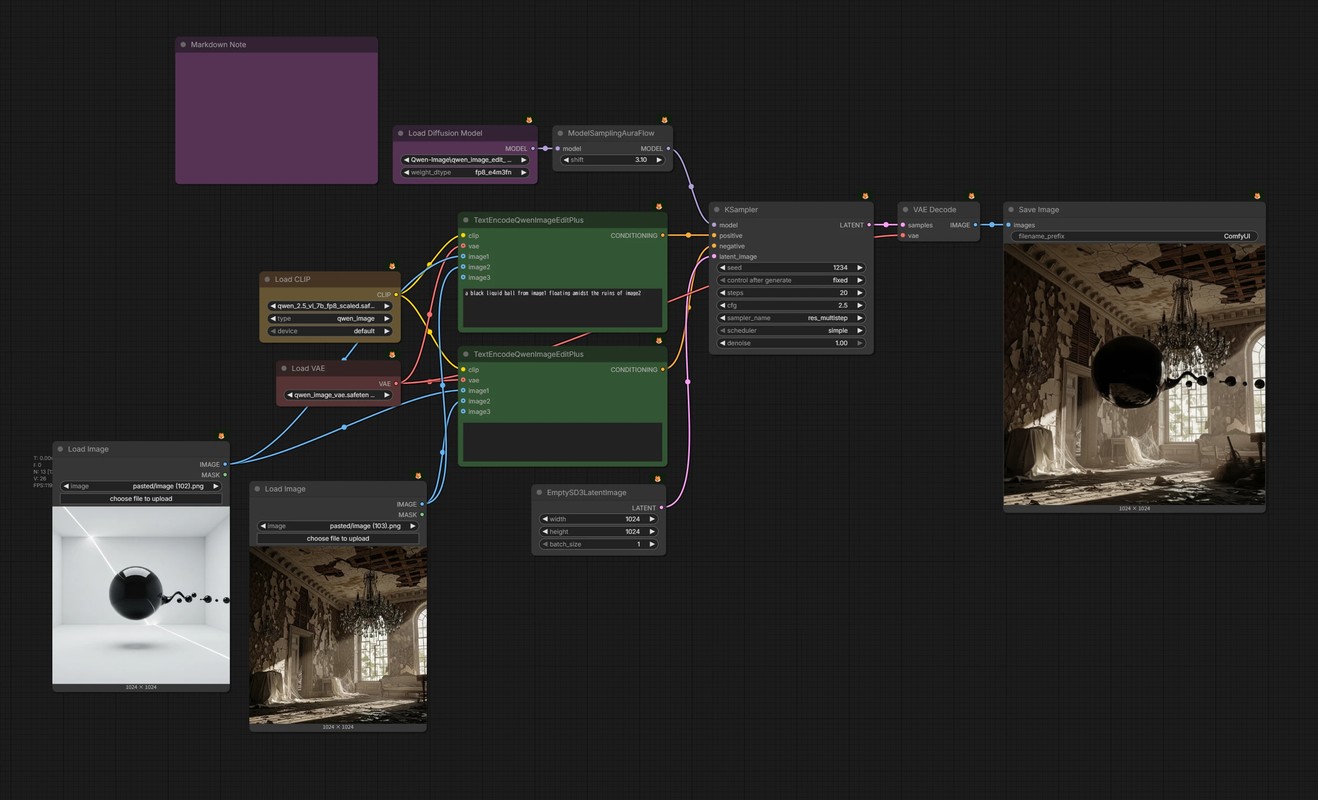
- 🟩 因为正经地看着图像,某种程度粗略的指示也能动,但像“image1 的〇〇”“image2 的〇〇”那样,也可以明示地指定是哪个图像。
之前,因为想让输入图像和编辑后图像完成尽量相同的尺寸,先进行调整处理,并将那个输入到 latent_image。
另一方面在“只想以参照图像为提示生成新图像”的例子,像 text2image 那样使用 EmptySD3LatentImage 节点也没问题。
Qwen-Image-Edit-2511
Qwen-Image-Edit-2511 是,改良了 2509 的新模型。
没有从无印到 2509 时那样的大幅度变化,但角色的一致性提高了,或者 Relighting LoRA 等有人气的 LoRA 模型被整合了,进行了着实的改良。
模型的下载
-
diffusion_models
-
gguf(任意)
📂ComfyUI/
└── 📂models/
    ├── 📂diffusion_models/
    │   └── qwen_image_edit_2511_fp8mixed.safetensors
    └── 📂unet/
        └── qwen-image-edit-2511-XXXX.gguf      ← 仅在使用 gguf 的时候
工作流
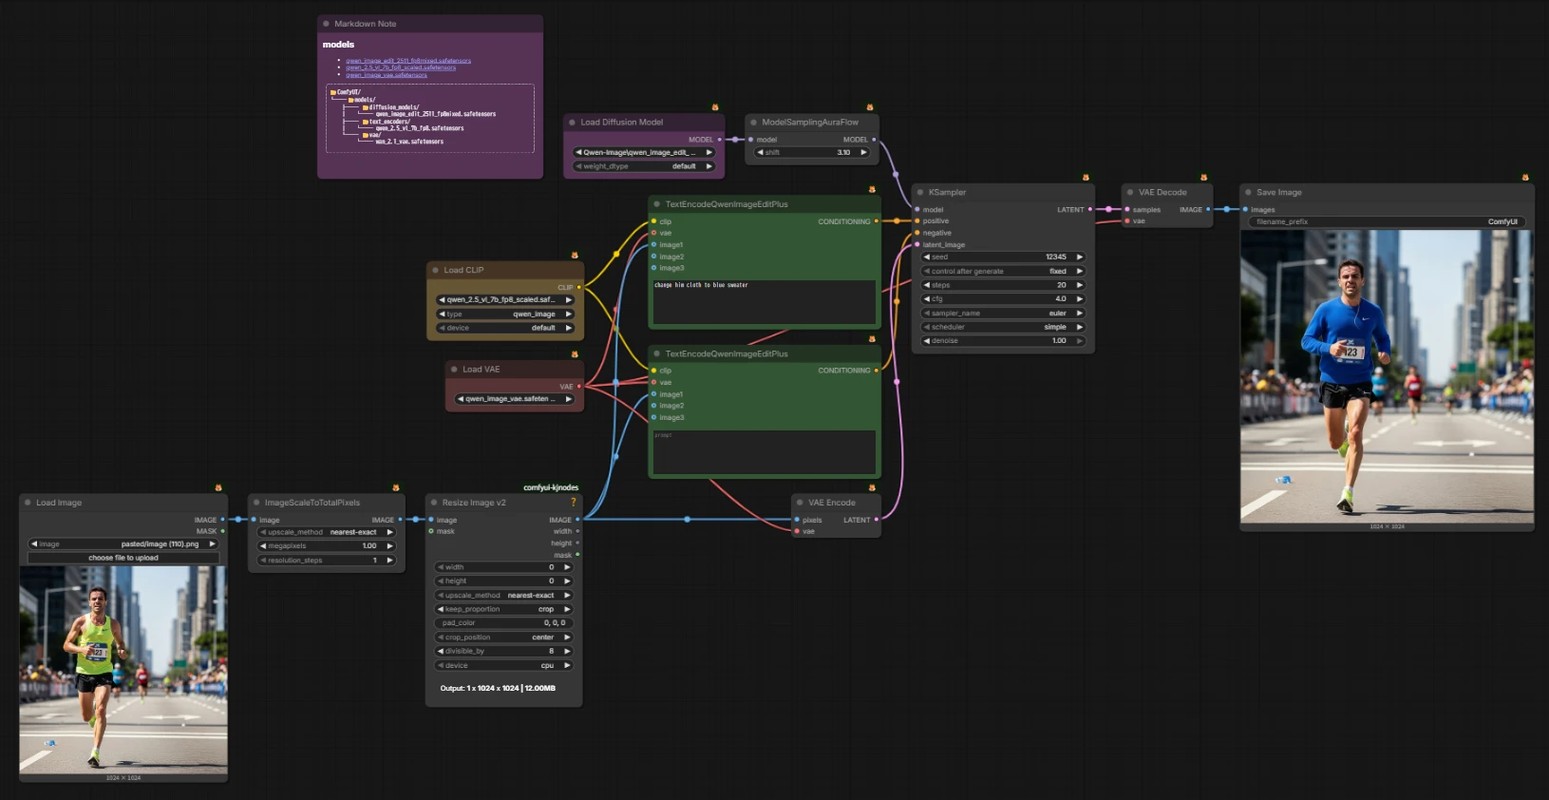
以与 2509 完全相同的工作流动作。
Lightning
Qwen-Image-Edit-Lightning 是,为了让 Qwen-Image-Edit 以 4 / 8 steps 运转而被蒸馏的 LoRA 组。
几乎没有劣化就能大幅减少步数,在很多工作流被采用。
模型的下载
-
loras
📂ComfyUI/
└── 📂models/
    └── 📂loras/
        ├── Qwen-Image-Edit-2509-Lightning-4steps-V1.0-bf16.safetensors
        ├── Qwen-Image-Edit-2509-Lightning-8steps-V1.0-bf16.safetensors
        └── Qwen-Image-Edit-2511-Lightning-4steps-V1.0-bf16.safetensors
Qwen-Image-Edit-2509
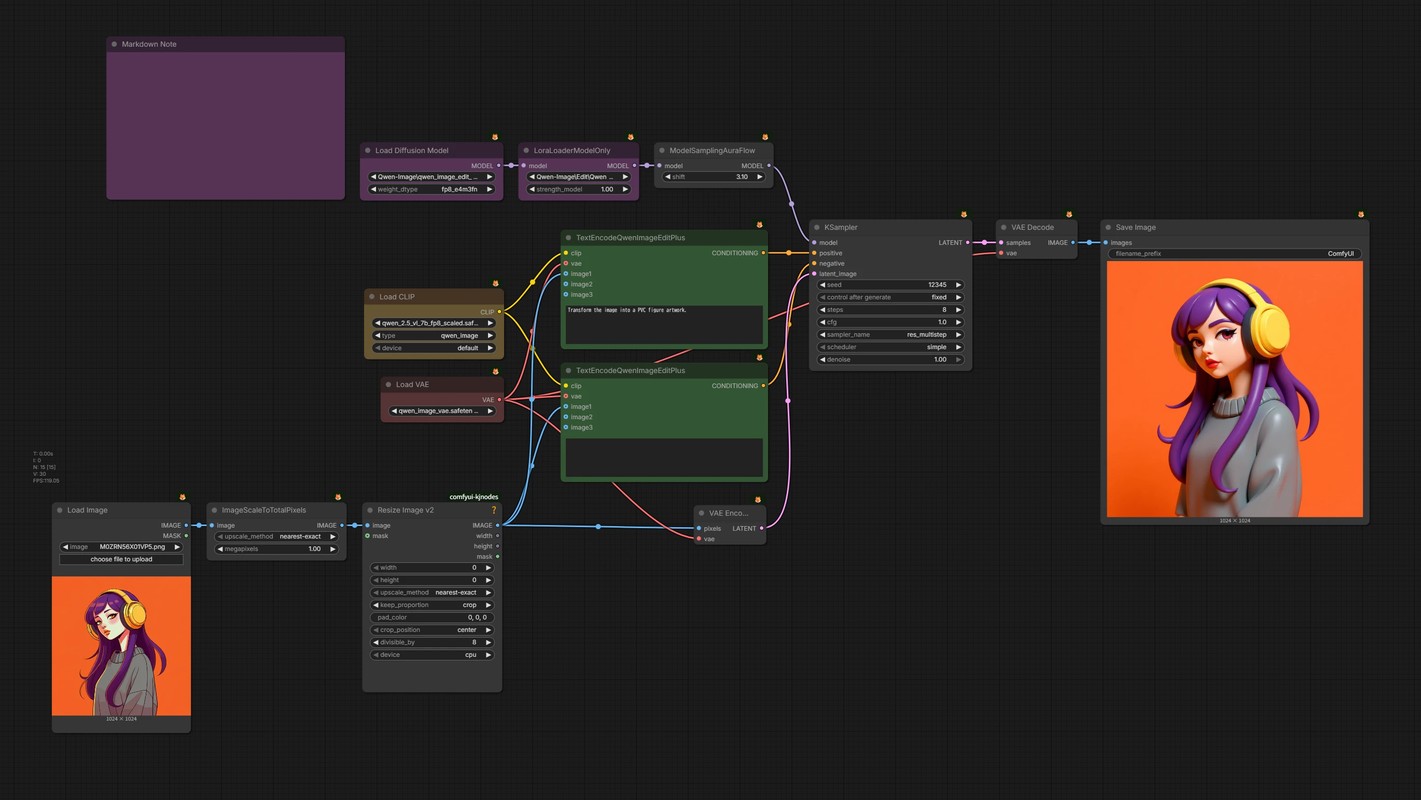
- 用
LoraLoaderModelOnly节点读取 Lightning LoRA。 - 将
KSampler的steps设定为 4 或 8,CFG设定为 1.0。
Qwen-Image-Edit-2511
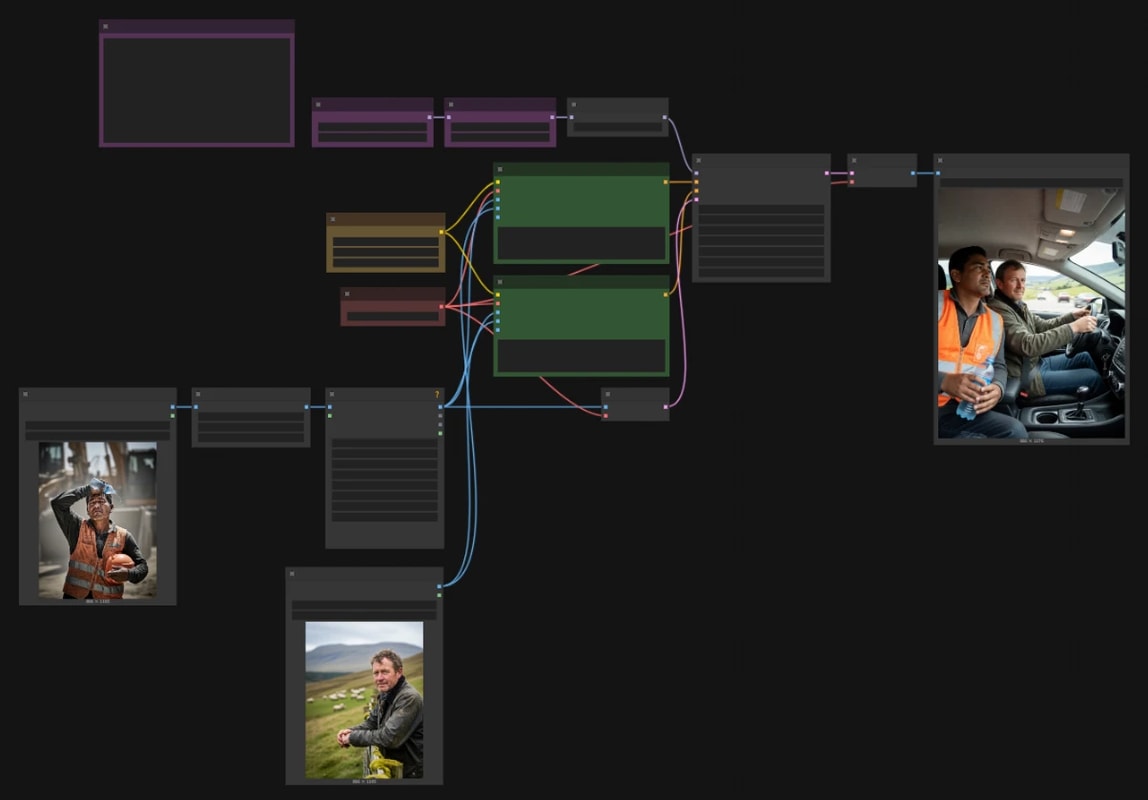
- 用
LoraLoaderModelOnly节点读取 Lightning LoRA。