什么是 WeVisOne-VL?
WeVisOne-VL 是腾讯发布的模型,它把 Qwen3-VL 专门针对感知任务做了微调。
目标检测、分割、计数、OCR,一个模型就能全部搞定。
类似的模型有 Florence-2,但基础模型已经进步了一大截,应对复杂提示词的能力也理所当然地提高了。
下载模型
- text_encoders
- wevisone_vl_4b_int8_convrot.safetensors (5.29 GB)
- wevisone_vl_2b_int8_convrot.safetensors (2.89 GB)
📂ComfyUI/
└── 📂models/
    └── 📂text_encoders/
        ├── wevisone_vl_2b_int8_convrot.safetensors
        └── wevisone_vl_4b_int8_convrot.safetensors
WeVisOne-VL Detect
切换 task 来选择要做的任务。
segmentation
用文字描述对象,就会输出遮罩和 BBOX。
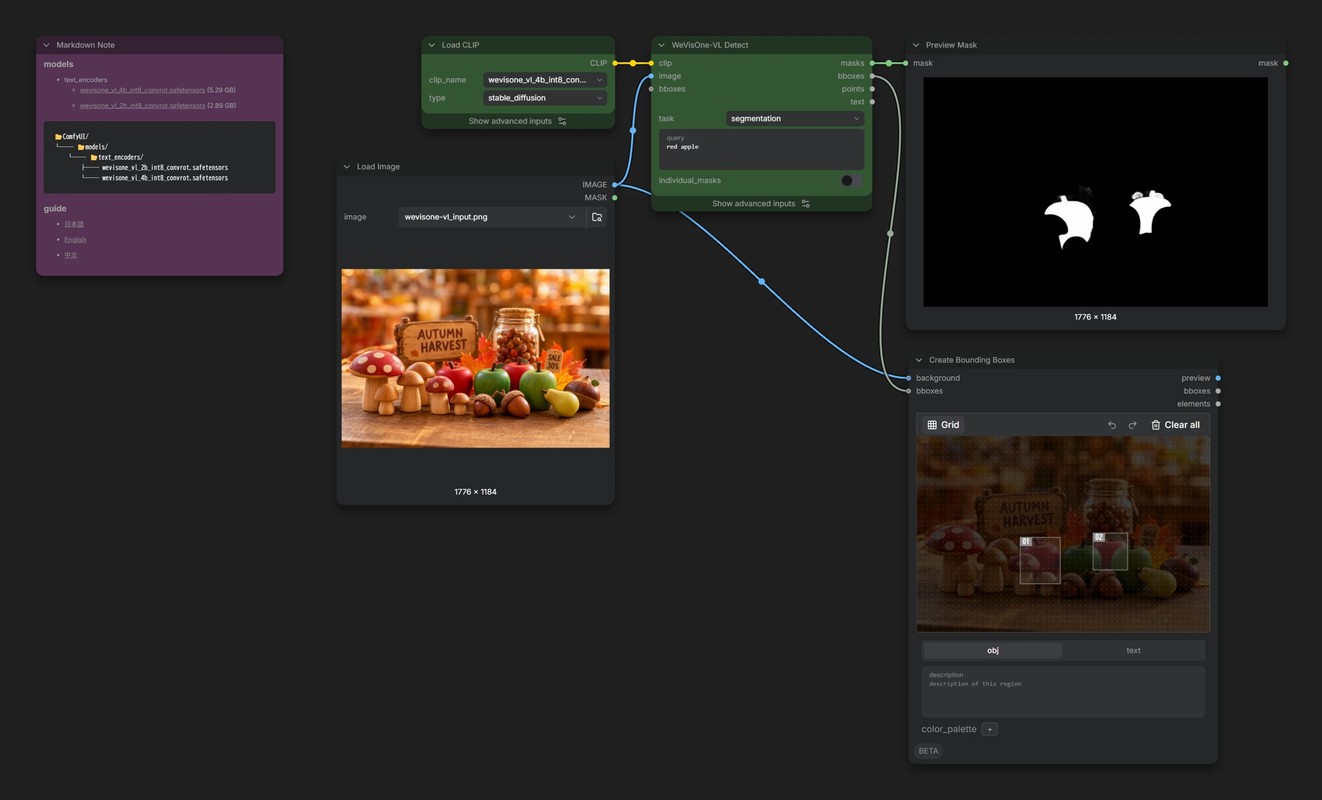
- 打开
individual_masks后,如果有多个对象,每个对象会分别输出为单独的遮罩。
detection / referring
基本上就是去掉了遮罩输出的 segmentation。
严格来说,detection 和 referring 在内部使用的是不同的提示词,但就我试下来,结果几乎一样。何况 segmentation 本身也会输出 BBOX,所以我觉得用到它们的场合不多。
point
不输出 BBOX,而是用坐标给出对象的位置。
count_box / count_point
统计对象的数量。
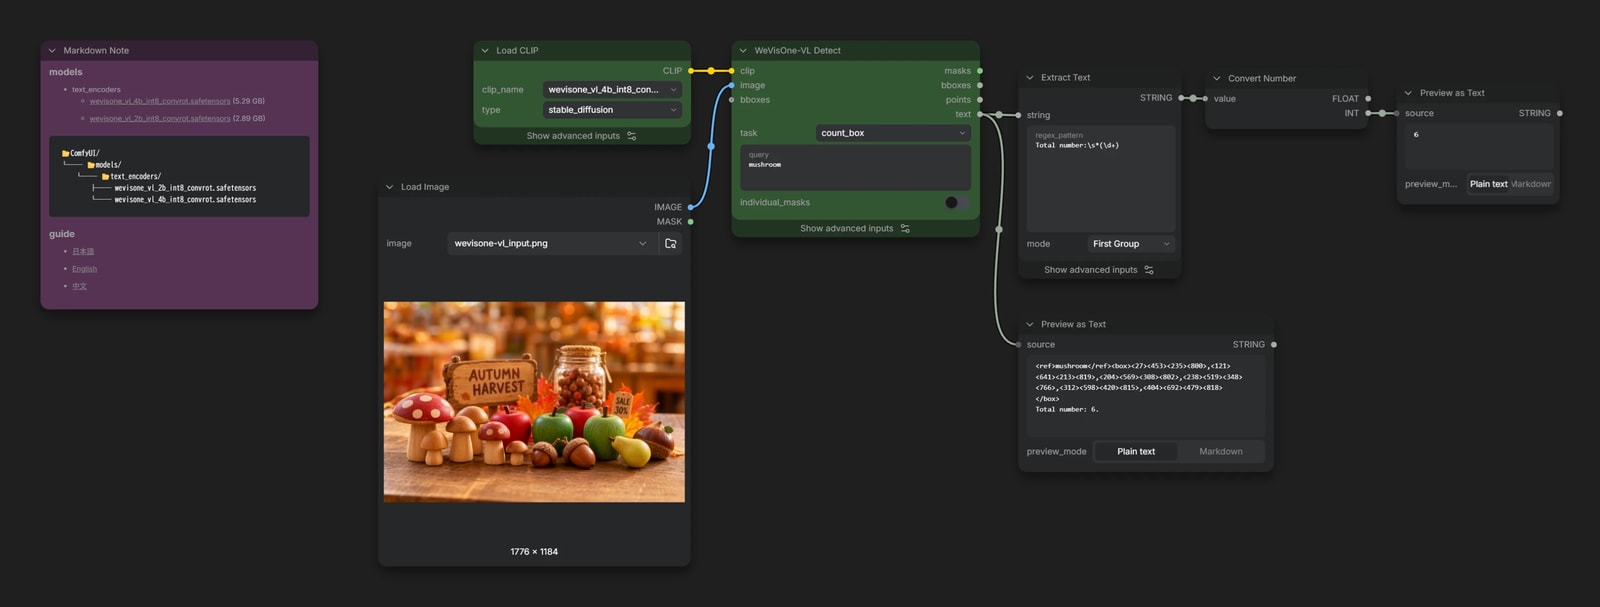
数量是以 Total number: 6. 这样的句子输出的,用起来有点不方便。
这个工作流用 Extract Text 的正则表达式只取出数字,再用 Convert Number 转成 INT。
ocr
提取图像中的文字。
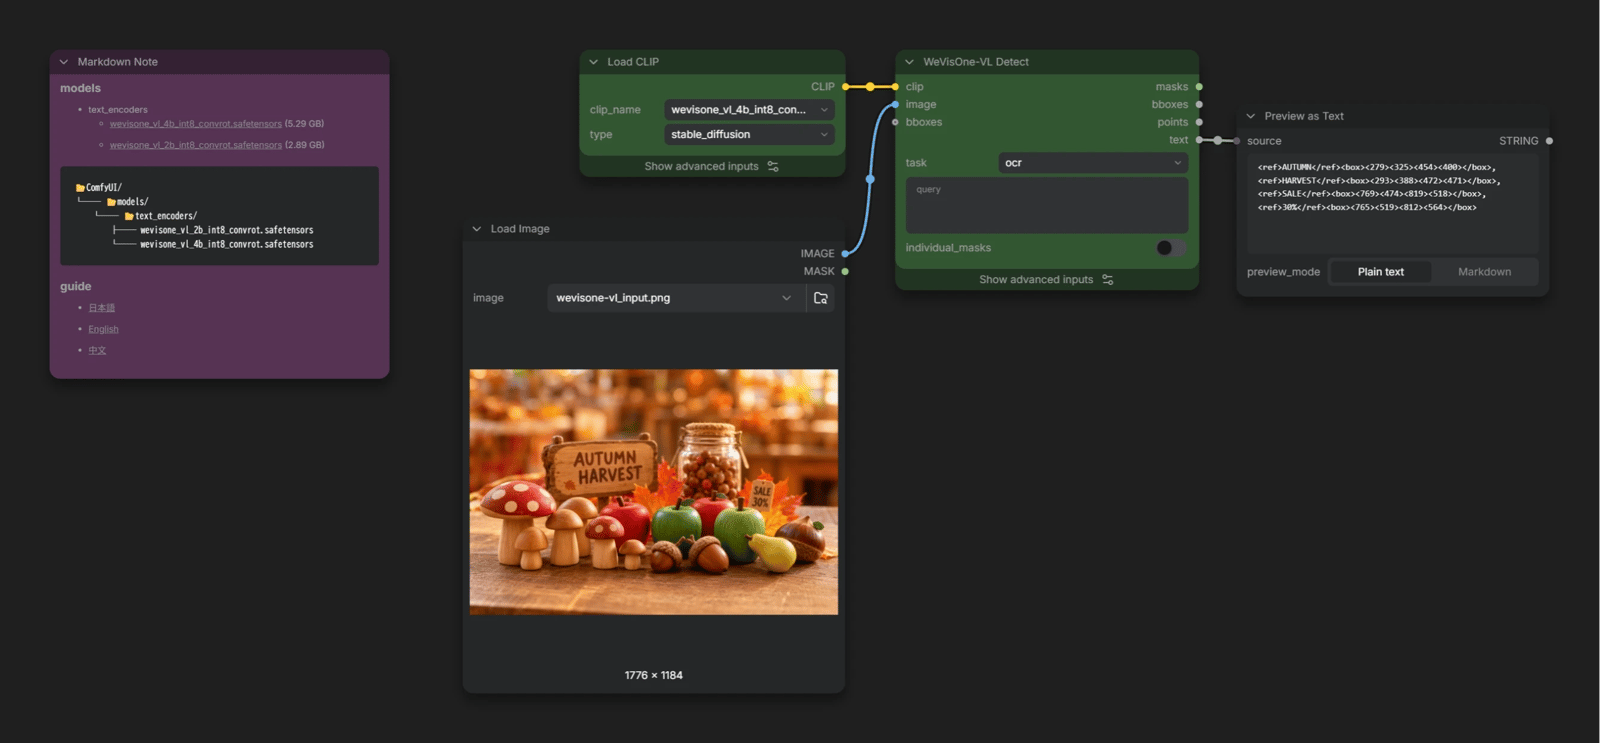
每个单词的坐标和内容会作为 text 输出。
可惜的是,它似乎不太擅长日语。
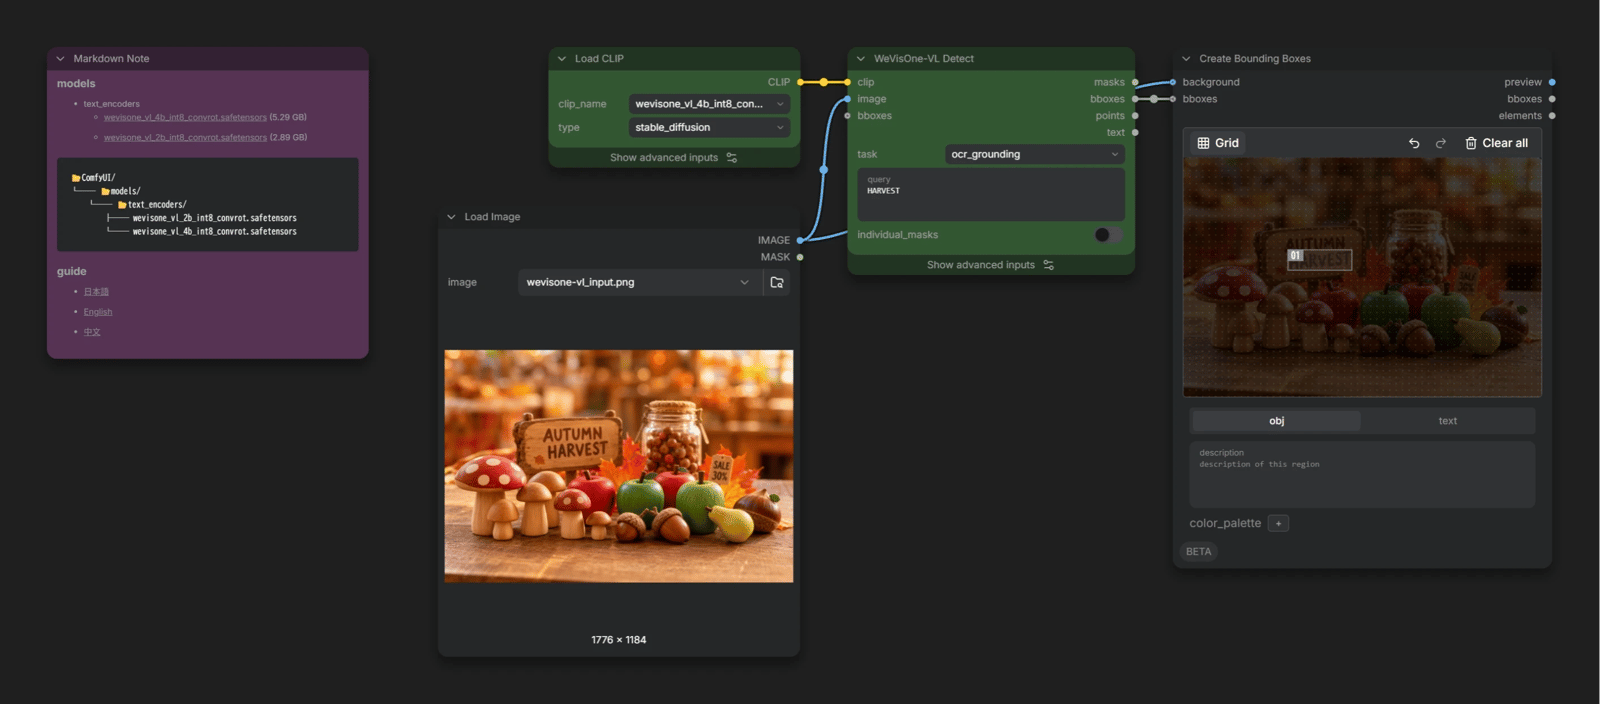
ocr_grounding
与 ocr 相反:写下要找的文字,它会用 BBOX 输出这段文字在图像中的位置。
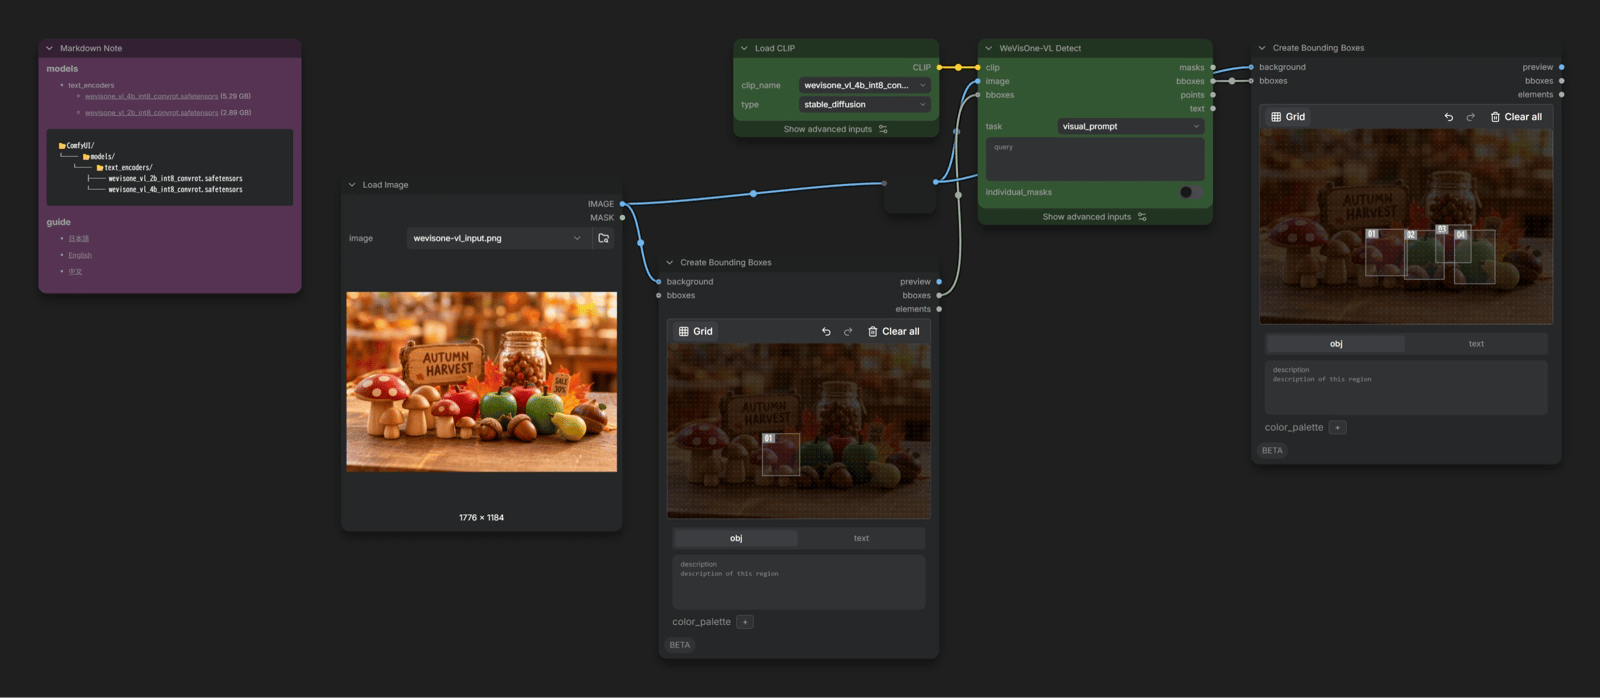
visual_prompt
在同一张图像中寻找与框选对象相同的东西。
它并不是使用参考图像那样的功能,所以可能不太好找到用武之地。
freeform
上面的任务都针对各自的用途整理好了输入和输出,而在这个模式下,query 里写的内容会原样作为提示词传给模型。
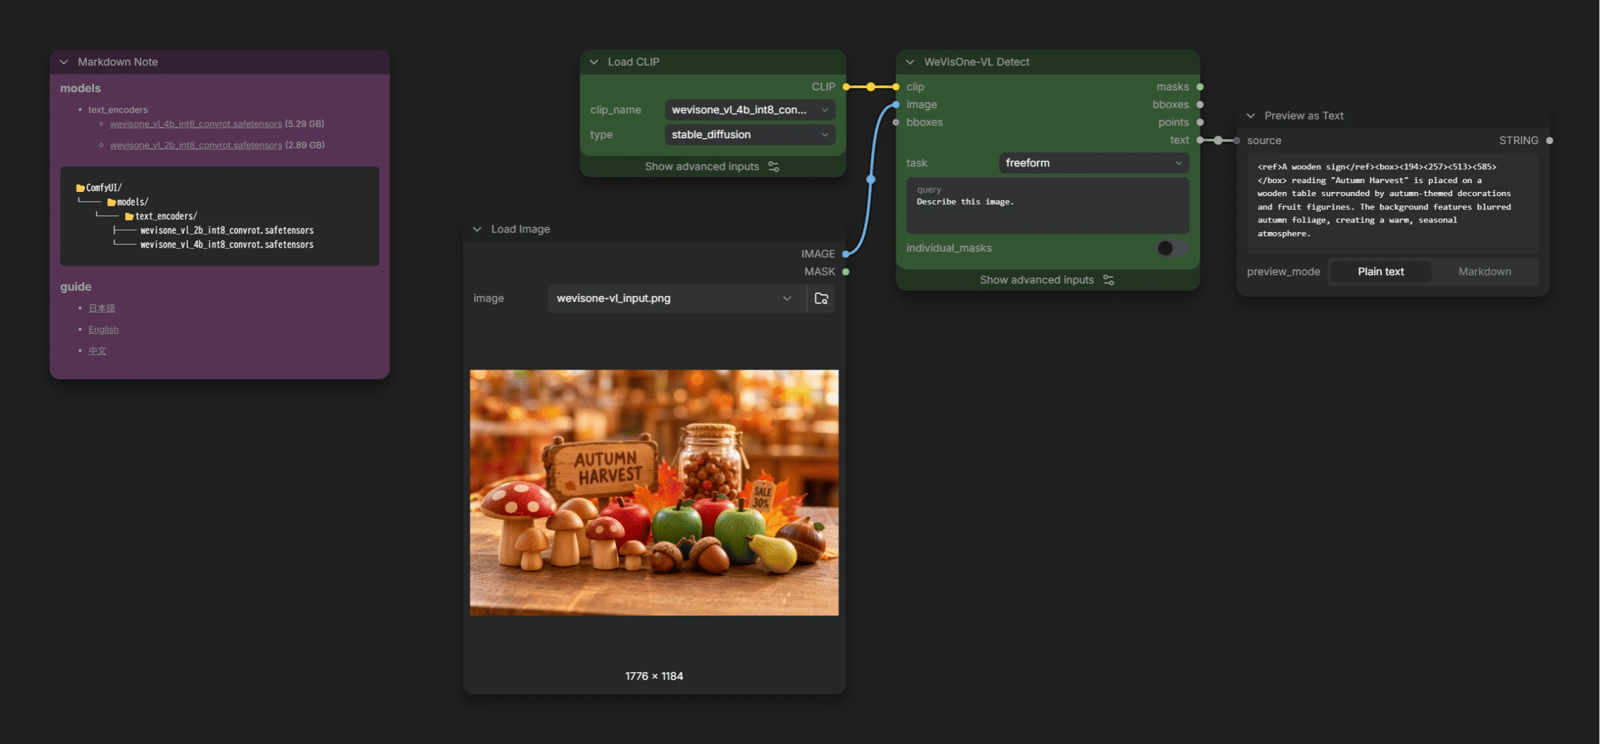
写上 Describe this image. 之类的内容,也可以当作普通的 VLM 来描述图像。不过它是为感知任务打造的模型,如果是这种用法,还是普通的 Qwen3-VL 更合适。
Samples