什么是 MiniMax H3?
MiniMax H3 是 MiniMax 发布的视频生成模型。
它采用一种简洁的架构,在同一个 Transformer 中处理文本、图像、视频和音频。在本地视频生成 AI 中,其性能与灵活性可以说格外突出。
模型分为两种。
- FL2VA
- 用于 text2video、image2video、First / Last Frame to Video
- Ref2VA
- 参考图像、视频和音频,将人物、动作、镜头、画风、声音等组合起来生成视频
推荐设置
- 分辨率
- 768p、约 1 MP
- 宽度和高度应为 32 的倍数
- FPS
- 24 FPS
- 帧数
17n + 5
- 视频长度
- 5~15 秒
模型下载
- diffusion_models
- text_encoders
- vae
- minimax_h3_audio_vae_fp32.safetensors (605 MB)
- minimax_h3_video_vae_fp16.safetensors (5.21 GB)
📂ComfyUI/
└── 📂models/
    ├── 📂diffusion_models/
    │   ├── minimax_h3_fl2va_pruned_int8_convrot.safetensors
    │   └── minimax_h3_ref2va_pruned_int8_convrot.safetensors
    ├── 📂text_encoders/
    │   └── qwen3vl_32b_minimax_h3_int8_convrot.safetensors
    └── 📂vae/
        ├── minimax_h3_audio_vae_fp32.safetensors
        └── minimax_h3_video_vae_fp16.safetensors
提示词
使用普通自然语言也能运行,但要发挥模型的性能,需要按照推荐的格式编写提示词。
这种格式对人来说实在太复杂了,请把 MiniMax 官方的提示词指南交给 ChatGPT 或 Claude,让它帮你生成提示词。
- MiniMax H3 Skills
- Video Prompt Writing Guide
- 面向 T2VA、I2VA、FL2VA、L2VA
- Full-Reference Prompt Guide
- 面向 Ref2VA
不过,为了方便确认生成的提示词是否正确,这里还是简单介绍一下基础格式。
FL2VA
在 T2VA / I2VA / FL2VA / L2VA 中,视频和音频内容分成 3 个部分来写。
integrated_multimodal_description:
[Shot 1] 描述画面、人物动作、镜头、台词和音效。

overall_soundscape:
描述环境音和物理音效。

non_diegetic_music:
描述 BGM。没有时填写 N/A。
如果想要一个连续镜头,请在正文中明确写明不要切镜头。
[Shot 1] Single continuous shot, one take, no cuts. ...
如果要生成多个镜头,第一个镜头不写时间,从第二个镜头开始写明切换时间。
[Shot 1] 描述第一个镜头。
[Shot 2] At 00:02.000, the camera cuts to ...
[Shot 3] At 00:04.000, the shot changes to ...
Ref2VA
Ref2VA 使用专用的 6 个部分来编写提示词。
subject_definitions:
定义要参考的人物、物体、视频和音频。

summary:
简要描述要生成的内容。

retention_analysis:
描述需要保留或迁移参考素材中的哪些内容。

detailed_description:
描述画面、动作、镜头、台词和音效。

overall_soundscape:
描述环境音和物理音效。

non_diegetic_music:
描述 BGM。没有时填写 N/A。
连接的素材使用 <Picture 1>、<Video 1>、<Audio 1> 这样的标签来指定,并写清楚要使用各素材中的哪些内容。
如果只想使用素材中的一部分,例如照片里的人物,可以将其定义为 <Subject 1>。
<Subject 1> is the woman in <Picture 1>.
台词需要放在 <d> 标签中,并用 [Japanese] 这样的形式指定语言。
<Subject 1> (S1) says: <d>[Japanese] こんにちは。</d>
关于轻量化与加速
MiniMax H3 的质量很高,但也是一个非常重的模型。
因此,目前已经出现了许多降低 VRAM 占用、提升生成速度的技术。这些技术都很出色,但或多或少都会影响质量。
选择时需要权衡各自的优缺点,而这其实相当困难。因此,本页的工作流只使用 Comfy Kitchen Attention(CK Attention),不使用其他优化。
更详细的信息整理在下面的页面中。
等相关技术稳定一些后,我打算再单独整理成一篇文章。
text2video / T2VA
使用模型:fl2va
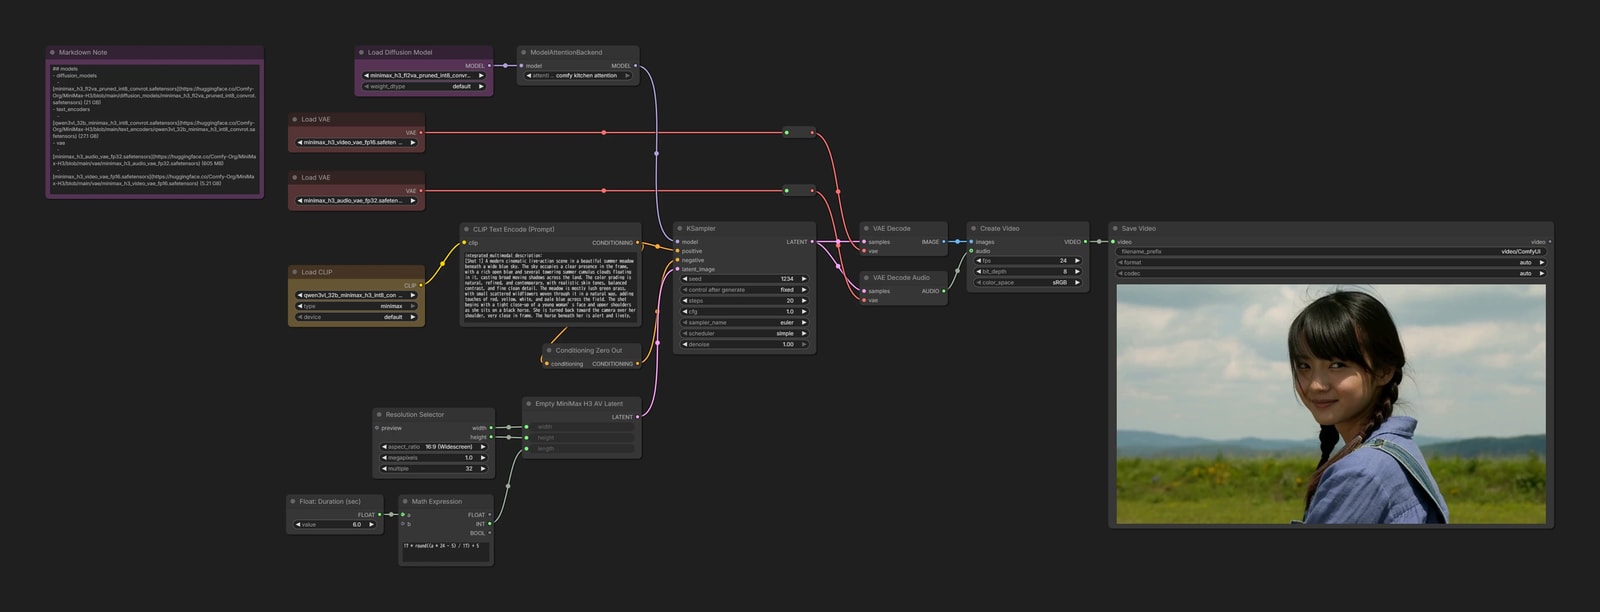
{
"id": "0e41d131-d23d-4699-9dc2-7bb198629652",
"revision": 0,
"last_node_id": 96,
"last_link_id": 166,
"nodes": [
{
"id": 75,
"type": "ConditioningZeroOut",
"pos": [
611.5653149414063,
456.0866027132518
],
"size": [
218.4346850585937,
26
],
"flags": {},
"order": 13,
"mode": 0,
"inputs": [
{
"name": "conditioning",
"type": "CONDITIONING",
"link": 153
}
],
"outputs": [
{
"name": "CONDITIONING",
"type": "CONDITIONING",
"links": [
130
]
}
],
"properties": {
"Node name for S&R": "ConditioningZeroOut",
"cnr_id": "comfy-core",
"ver": "0.30.0"
}
},
{
"id": 77,
"type": "VAEDecodeAudio",
"pos": [
1308.6980183050962,
296.9762089835968
],
"size": [
194.25299723441972,
46
],
"flags": {},
"order": 16,
"mode": 0,
"inputs": [
{
"name": "samples",
"type": "LATENT",
"link": 132
},
{
"name": "vae",
"type": "VAE",
"link": 150
}
],
"outputs": [
{
"name": "AUDIO",
"type": "AUDIO",
"links": [
160
]
}
],
"properties": {
"Node name for S&R": "VAEDecodeAudio",
"cnr_id": "comfy-core",
"ver": "0.30.0"
}
},
{
"id": 91,
"type": "CreateVideo",
"pos": [
1544.2637529711267,
188.1918182373047
],
"size": [
270,
126
],
"flags": {},
"order": 17,
"mode": 0,
"inputs": [
{
"name": "images",
"type": "IMAGE",
"link": 159
},
{
"name": "audio",
"shape": 7,
"type": "AUDIO",
"link": 160
}
],
"outputs": [
{
"name": "VIDEO",
"type": "VIDEO",
"links": [
158
]
}
],
"properties": {
"Node name for S&R": "CreateVideo",
"cnr_id": "comfy-core",
"ver": "0.33.0"
},
"widgets_values": [
24,
8,
"sRGB"
],
"widgets_values_named": {
"fps": 24,
"bit_depth": 8,
"color_space": "sRGB"
}
},
{
"id": 8,
"type": "VAEDecode",
"pos": [
1308.6980183050962,
188.1918182373047
],
"size": [
194.25299723441972,
46
],
"flags": {},
"order": 15,
"mode": 0,
"inputs": [
{
"name": "samples",
"type": "LATENT",
"link": 35
},
{
"name": "vae",
"type": "VAE",
"link": 140
}
],
"outputs": [
{
"name": "IMAGE",
"type": "IMAGE",
"slot_index": 0,
"links": [
159
]
}
],
"properties": {
"Node name for S&R": "VAEDecode",
"cnr_id": "comfy-core",
"ver": "0.3.33"
}
},
{
"id": 39,
"type": "VAELoader",
"pos": [
52.62317611836556,
-51.18135864304374
],
"size": [
301.3524169921875,
58
],
"flags": {},
"order": 0,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "VAE",
"type": "VAE",
"slot_index": 0,
"links": [
139
]
}
],
"properties": {
"Node name for S&R": "VAELoader",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
"minimax_h3_video_vae_fp16.safetensors"
],
"widgets_values_named": {
"vae_name": "minimax_h3_video_vae_fp16.safetensors"
},
"color": "#322",
"bgcolor": "#533"
},
{
"id": 82,
"type": "Reroute",
"pos": [
1138.7548217773438,
76.42865257257024
],
"size": [
75,
26
],
"flags": {},
"order": 10,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 149
}
],
"outputs": [
{
"name": "",
"type": "VAE",
"links": [
150
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 79,
"type": "Reroute",
"pos": [
1138.7548217773438,
-51.18135864304374
],
"size": [
75,
26
],
"flags": {},
"order": 7,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 139
}
],
"outputs": [
{
"name": "",
"type": "VAE",
"links": [
140
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 86,
"type": "ModelAttentionBackend",
"pos": [
555.6042177585902,
-198.51277317993834
],
"size": [
270,
58
],
"flags": {},
"order": 9,
"mode": 0,
"inputs": [
{
"name": "model",
"type": "MODEL",
"link": 163
}
],
"outputs": [
{
"name": "MODEL",
"type": "MODEL",
"links": [
164
]
}
],
"properties": {
"Node name for S&R": "ModelAttentionBackend"
},
"widgets_values": [
"comfy kitchen attention"
],
"widgets_values_named": {
"attention": "comfy kitchen attention"
}
},
{
"id": 87,
"type": "ComfyMathExpression",
"pos": [
295.16927647456066,
788.0631428882084
],
"size": [
210,
128
],
"flags": {},
"order": 8,
"mode": 0,
"inputs": [
{
"label": "a",
"name": "values.a",
"type": "FLOAT,INT,BOOLEAN",
"link": 166
},
{
"name": "values.b",
"shape": 7,
"type": "FLOAT,INT,BOOLEAN",
"link": null
}
],
"outputs": [
{
"name": "FLOAT",
"type": "FLOAT",
"links": null
},
{
"name": "INT",
"type": "INT",
"links": [
162
]
},
{
"name": "BOOL",
"type": "BOOLEAN",
"links": null
}
],
"properties": {
"Node name for S&R": "ComfyMathExpression",
"cnr_id": "comfy-core",
"ver": "0.33.0"
},
"widgets_values": [
"17 * round((a * 24 - 5) / 17) + 5"
],
"widgets_values_named": {
"expression": "17 * round((a * 24 - 5) / 17) + 5"
}
},
{
"id": 94,
"type": "PrimitiveFloat",
"pos": [
48.485653251377876,
788.0631428882084
],
"size": [
214.65850806503283,
58
],
"flags": {},
"order": 1,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "FLOAT",
"type": "FLOAT",
"links": [
166
]
}
],
"title": "Float: Duration (sec)",
"properties": {
"Node name for S&R": "PrimitiveFloat"
},
"widgets_values": [
6
],
"widgets_values_named": {
"value": 6
}
},
{
"id": 95,
"type": "MarkdownNote",
"pos": [
-480.03631463650436,
-198.51277317993834
],
"size": [
480.26512898835654,
306.99991194075415
],
"flags": {},
"order": 2,
"mode": 0,
"inputs": [],
"outputs": [],
"properties": {},
"widgets_values": [
"## models\n- diffusion_models\n - [minimax_h3_fl2va_pruned_int8_convrot.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/diffusion_models/minimax_h3_fl2va_pruned_int8_convrot.safetensors) (21 GB)\n- text_encoders\n - [qwen3vl_32b_minimax_h3_int8_convrot.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/text_encoders/qwen3vl_32b_minimax_h3_int8_convrot.safetensors) (27.1 GB)\n- vae\n - [minimax_h3_audio_vae_fp32.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/vae/minimax_h3_audio_vae_fp32.safetensors) (605 MB)\n - [minimax_h3_video_vae_fp16.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/vae/minimax_h3_video_vae_fp16.safetensors) (5.21 GB)\n\n```text\n📂ComfyUI/\n└── 📂models/\n ├── 📂diffusion_models/\n │ └── minimax_h3_fl2va_pruned_int8_convrot.safetensors\n ├── 📂text_encoders/\n │ └── qwen3vl_32b_minimax_h3_int8_convrot.safetensors\n └── 📂vae/\n ├── minimax_h3_audio_vae_fp32.safetensors\n └── minimax_h3_video_vae_fp16.safetensors\n```"
],
"widgets_values_named": {
"text": "## models\n- diffusion_models\n - [minimax_h3_fl2va_pruned_int8_convrot.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/diffusion_models/minimax_h3_fl2va_pruned_int8_convrot.safetensors) (21 GB)\n- text_encoders\n - [qwen3vl_32b_minimax_h3_int8_convrot.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/text_encoders/qwen3vl_32b_minimax_h3_int8_convrot.safetensors) (27.1 GB)\n- vae\n - [minimax_h3_audio_vae_fp32.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/vae/minimax_h3_audio_vae_fp32.safetensors) (605 MB)\n - [minimax_h3_video_vae_fp16.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/vae/minimax_h3_video_vae_fp16.safetensors) (5.21 GB)\n\n```text\n📂ComfyUI/\n└── 📂models/\n ├── 📂diffusion_models/\n │ └── minimax_h3_fl2va_pruned_int8_convrot.safetensors\n ├── 📂text_encoders/\n │ └── qwen3vl_32b_minimax_h3_int8_convrot.safetensors\n └── 📂vae/\n ├── minimax_h3_audio_vae_fp32.safetensors\n └── minimax_h3_video_vae_fp16.safetensors\n```"
},
"color": "#323",
"bgcolor": "#535"
},
{
"id": 37,
"type": "UNETLoader",
"pos": [
198.95419944148816,
-198.51277317993834
],
"size": [
305.3782043457031,
82
],
"flags": {},
"order": 3,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "MODEL",
"type": "MODEL",
"slot_index": 0,
"links": [
163
]
}
],
"properties": {
"Node name for S&R": "UNETLoader",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
"minimax_h3_fl2va_pruned_int8_convrot.safetensors",
"default"
],
"widgets_values_named": {
"unet_name": "minimax_h3_fl2va_pruned_int8_convrot.safetensors",
"weight_dtype": "default"
},
"color": "#323",
"bgcolor": "#535"
},
{
"id": 81,
"type": "VAELoader",
"pos": [
52.62317611836556,
76.42865257257024
],
"size": [
301.3524169921875,
58
],
"flags": {},
"order": 4,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "VAE",
"type": "VAE",
"slot_index": 0,
"links": [
149
]
}
],
"properties": {
"Node name for S&R": "VAELoader",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
"minimax_h3_audio_vae_fp32.safetensors"
],
"widgets_values_named": {
"vae_name": "minimax_h3_audio_vae_fp32.safetensors"
},
"color": "#322",
"bgcolor": "#533"
},
{
"id": 38,
"type": "CLIPLoader",
"pos": [
52.62317611836556,
284
],
"size": [
301.3524169921875,
106
],
"flags": {},
"order": 5,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "CLIP",
"type": "CLIP",
"slot_index": 0,
"links": [
145
]
}
],
"properties": {
"Node name for S&R": "CLIPLoader",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
"qwen3vl_32b_minimax_h3_int8_convrot.safetensors",
"minimax",
"default"
],
"widgets_values_named": {
"clip_name": "qwen3vl_32b_minimax_h3_int8_convrot.safetensors",
"type": "minimax",
"device": "default"
},
"color": "#432",
"bgcolor": "#653"
},
{
"id": 80,
"type": "CLIPTextEncode",
"pos": [
430,
190
],
"size": [
400,
200
],
"flags": {},
"order": 11,
"mode": 0,
"inputs": [
{
"name": "clip",
"type": "CLIP",
"link": 145
}
],
"outputs": [
{
"name": "CONDITIONING",
"type": "CONDITIONING",
"links": [
146,
153
]
}
],
"properties": {
"Node name for S&R": "CLIPTextEncode",
"cnr_id": "comfy-core",
"ver": "0.30.0"
},
"widgets_values": [
"integrated_multimodal_description:\n[Shot 1] A modern cinematic live-action scene in a beautiful summer meadow beneath a wide blue sky. The sky occupies a clear presence in the frame, with a rich open blue and several towering summer cumulus clouds floating in it, casting broad moving shadows across the land. The color grading is natural, refined, and contemporary, with realistic skin tones, balanced contrast, and fine clean detail. The meadow is mostly lush green grass, with small scattered wildflowers woven through it in a natural way, adding touches of red, yellow, white, and pale blue across the field. The shot begins with a tight close-up of a young woman’s face and upper shoulders as she sits on a black horse. She is turned back toward the camera over her shoulder, very close in frame. The horse beneath her is alert and lively, shifting and swaying with restless energy, so her body moves gently with it. She is a slim young woman of mixed Asian and European appearance, with a natural lean face, sharp fox-like eyes, sun-touched skin, almost no makeup, and a plain rustic beauty. Her expression is gentle, warm, and softly playful, with kind attentive eyes and a small tender smile. She has straight bangs and braided twin tails that are slightly loose, wind-tousled, and a little messy, with soft stray hairs moving in the breeze. She wears faded blue jeans, worn denim overalls, a short-sleeved blue shirt, and rugged heavy leather boots. The handheld camera feels intimate and physical. She looks directly toward the camera and speaks softly and kindly to one specific person close behind her, with the light, easy feeling of saying “I’m heading off, okay.” The woman with a gentle, youthful, intimate voice (S1) says: <d>[Japanese] 行くよ。</d>\n\n[Shot 2] At 00:01.700, the camera cuts to a clearly different wide rear-side shot from farther away, showing the full black horse and rider already in a fast gallop across the open meadow. The horse is fully in motion from the first instant of the shot, running with strong speed and confidence. The rider is facing forward and moving naturally with the rhythm of the gallop. Her bangs, loose braided twin tails, and blue shirt stream in the wind. The meadow spreads out beautifully, mostly green and sunlit, with many subtle scattered patches of small wildflowers blending into the grass and giving the landscape quiet richness. The wide blue sky remains prominent above, with towering summer clouds and large drifting bands of sunlight and shadow moving across the field. The camera begins with energetic handheld motion, then settles into a calmer hold while the rider and horse continue running farther away into the distance.\n\noverall_soundscape:\nA steady summer wind moves through the meadow. In Shot 1, the black horse shifts its weight with restless energy, breathing softly, with subtle tack creaks and grass brushing around its legs. The rider’s voice is close, soft, and intimate, spoken directly toward the camera. In Shot 2, the horse is already at speed, and strong rhythmic hoofbeats, leather creaks, and rushing wind fill the soundscape as the rider and horse race deeper into the meadow, gradually receding into the distance.\n\nnon_diegetic_music:\nN/A"
],
"widgets_values_named": {
"text": "integrated_multimodal_description:\n[Shot 1] A modern cinematic live-action scene in a beautiful summer meadow beneath a wide blue sky. The sky occupies a clear presence in the frame, with a rich open blue and several towering summer cumulus clouds floating in it, casting broad moving shadows across the land. The color grading is natural, refined, and contemporary, with realistic skin tones, balanced contrast, and fine clean detail. The meadow is mostly lush green grass, with small scattered wildflowers woven through it in a natural way, adding touches of red, yellow, white, and pale blue across the field. The shot begins with a tight close-up of a young woman’s face and upper shoulders as she sits on a black horse. She is turned back toward the camera over her shoulder, very close in frame. The horse beneath her is alert and lively, shifting and swaying with restless energy, so her body moves gently with it. She is a slim young woman of mixed Asian and European appearance, with a natural lean face, sharp fox-like eyes, sun-touched skin, almost no makeup, and a plain rustic beauty. Her expression is gentle, warm, and softly playful, with kind attentive eyes and a small tender smile. She has straight bangs and braided twin tails that are slightly loose, wind-tousled, and a little messy, with soft stray hairs moving in the breeze. She wears faded blue jeans, worn denim overalls, a short-sleeved blue shirt, and rugged heavy leather boots. The handheld camera feels intimate and physical. She looks directly toward the camera and speaks softly and kindly to one specific person close behind her, with the light, easy feeling of saying “I’m heading off, okay.” The woman with a gentle, youthful, intimate voice (S1) says: <d>[Japanese] 行くよ。</d>\n\n[Shot 2] At 00:01.700, the camera cuts to a clearly different wide rear-side shot from farther away, showing the full black horse and rider already in a fast gallop across the open meadow. The horse is fully in motion from the first instant of the shot, running with strong speed and confidence. The rider is facing forward and moving naturally with the rhythm of the gallop. Her bangs, loose braided twin tails, and blue shirt stream in the wind. The meadow spreads out beautifully, mostly green and sunlit, with many subtle scattered patches of small wildflowers blending into the grass and giving the landscape quiet richness. The wide blue sky remains prominent above, with towering summer clouds and large drifting bands of sunlight and shadow moving across the field. The camera begins with energetic handheld motion, then settles into a calmer hold while the rider and horse continue running farther away into the distance.\n\noverall_soundscape:\nA steady summer wind moves through the meadow. In Shot 1, the black horse shifts its weight with restless energy, breathing softly, with subtle tack creaks and grass brushing around its legs. The rider’s voice is close, soft, and intimate, spoken directly toward the camera. In Shot 2, the horse is already at speed, and strong rhythmic hoofbeats, leather creaks, and rushing wind fill the soundscape as the rider and horse race deeper into the meadow, gradually receding into the distance.\n\nnon_diegetic_music:\nN/A"
}
},
{
"id": 73,
"type": "ResolutionSelector",
"pos": [
238.17333184289282,
597.3747096404333
],
"size": [
270,
126
],
"flags": {},
"order": 6,
"mode": 0,
"inputs": [
{
"name": "preview",
"shape": 7,
"type": "RESOLUTION_PREVIEW",
"link": null
}
],
"outputs": [
{
"name": "width",
"type": "INT",
"links": [
142
]
},
{
"name": "height",
"type": "INT",
"links": [
143
]
}
],
"properties": {
"Node name for S&R": "ResolutionSelector",
"cnr_id": "comfy-core",
"ver": "0.29.0"
},
"widgets_values": [
"16:9 (Widescreen)",
1,
32
],
"widgets_values_named": {
"aspect_ratio": "16:9 (Widescreen)",
"megapixels": 1,
"multiple": 32
}
},
{
"id": 76,
"type": "EmptyMiniMaxH3LatentAV",
"pos": [
566.8694727314751,
573.5061953357849
],
"size": [
263.13052726852493,
106
],
"flags": {},
"order": 12,
"mode": 0,
"inputs": [
{
"name": "width",
"type": "INT",
"widget": {
"name": "width"
},
"link": 142
},
{
"name": "height",
"type": "INT",
"widget": {
"name": "height"
},
"link": 143
},
{
"name": "length",
"type": "INT",
"widget": {
"name": "length"
},
"link": 162
}
],
"outputs": [
{
"name": "LATENT",
"type": "LATENT",
"links": [
144
]
}
],
"properties": {
"Node name for S&R": "EmptyMiniMaxH3LatentAV",
"cnr_id": "comfy-core",
"ver": "0.30.0"
},
"widgets_values": [
1344,
768,
124
],
"widgets_values_named": {
"width": 1344,
"height": 768,
"length": 124
}
},
{
"id": 92,
"type": "SaveVideo",
"pos": [
1855.5764904027374,
188.1918182373047
],
"size": [
979.5998338737108,
644.7533956504433
],
"flags": {},
"order": 18,
"mode": 0,
"inputs": [
{
"name": "video",
"type": "VIDEO",
"link": 158
}
],
"outputs": [
{
"name": "video",
"type": "VIDEO",
"links": null
}
],
"properties": {
"cnr_id": "comfy-core",
"ver": "0.33.0"
},
"widgets_values": [
"video/ComfyUI",
"auto",
"auto",
"auto"
],
"widgets_values_named": {
"filename_prefix": "video/ComfyUI",
"format": "auto",
"format.codec": "auto",
"codec": "auto"
}
},
{
"id": 3,
"type": "KSampler",
"pos": [
898.7548217773438,
188.1918182373047
],
"size": [
315,
262
],
"flags": {},
"order": 14,
"mode": 0,
"inputs": [
{
"name": "model",
"type": "MODEL",
"link": 164
},
{
"name": "positive",
"type": "CONDITIONING",
"link": 146
},
{
"name": "negative",
"type": "CONDITIONING",
"link": 130
},
{
"name": "latent_image",
"type": "LATENT",
"link": 144
}
],
"outputs": [
{
"name": "LATENT",
"type": "LATENT",
"slot_index": 0,
"links": [
35,
132
]
}
],
"properties": {
"Node name for S&R": "KSampler",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
1234,
"fixed",
20,
1,
"euler",
"simple",
1
],
"widgets_values_named": {
"seed": 1234,
"control_after_generate": "fixed",
"steps": 20,
"cfg": 1,
"sampler_name": "euler",
"scheduler": "simple",
"denoise": 1
}
}
],
"links": [
[
35,
3,
0,
8,
0,
"LATENT"
],
[
130,
75,
0,
3,
2,
"CONDITIONING"
],
[
132,
3,
0,
77,
0,
"LATENT"
],
[
139,
39,
0,
79,
0,
"VAE"
],
[
140,
79,
0,
8,
1,
"VAE"
],
[
142,
73,
0,
76,
0,
"INT"
],
[
143,
73,
1,
76,
1,
"INT"
],
[
144,
76,
0,
3,
3,
"LATENT"
],
[
145,
38,
0,
80,
0,
"CLIP"
],
[
146,
80,
0,
3,
1,
"CONDITIONING"
],
[
149,
81,
0,
82,
0,
"VAE"
],
[
150,
82,
0,
77,
1,
"VAE"
],
[
153,
80,
0,
75,
0,
"CONDITIONING"
],
[
158,
91,
0,
92,
0,
"VIDEO"
],
[
159,
8,
0,
91,
0,
"IMAGE"
],
[
160,
77,
0,
91,
1,
"AUDIO"
],
[
162,
87,
1,
76,
2,
"INT"
],
[
163,
37,
0,
86,
0,
"MODEL"
],
[
164,
86,
0,
3,
0,
"MODEL"
],
[
166,
94,
0,
87,
0,
"FLOAT"
]
],
"groups": [],
"config": {},
"extra": {
"ds": {
"scale": 0.4787841047760793,
"offset": [
777.1929444599673,
507.167778439244
]
},
"frontendVersion": "1.51.9",
"VHS_latentpreview": false,
"VHS_latentpreviewrate": 0,
"VHS_MetadataImage": true,
"VHS_KeepIntermediate": true
},
"version": 0.4
}
分辨率与视频长度设置
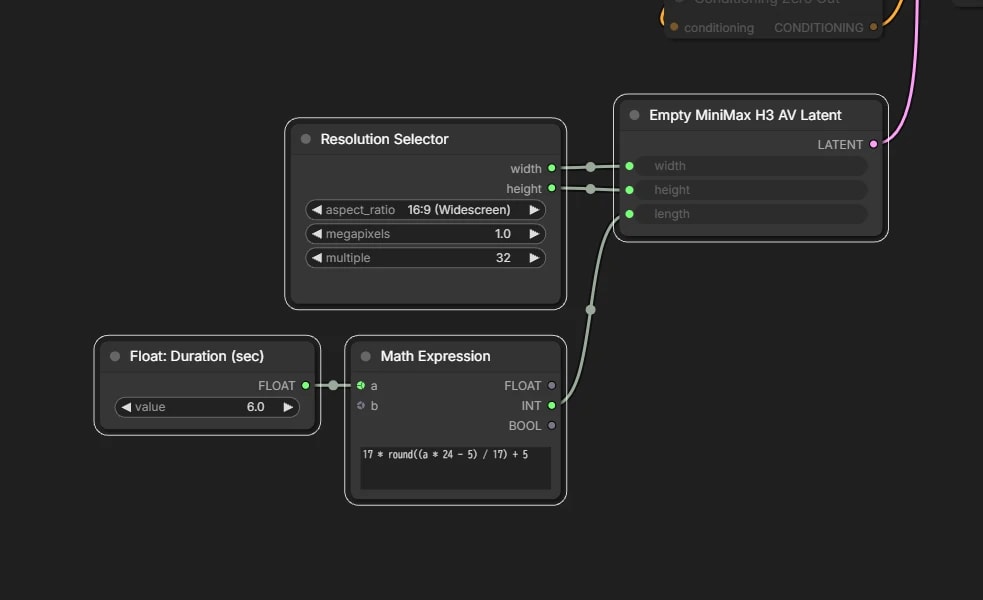
推荐分辨率约为 1 MP,但计算成本也相当高。刚开始时,也许可以先用 0.3 MP 等较小的尺寸尝试。
输入想要生成的视频长度(sec)后,帧数会自动取整为合适的 17n + 5。
CFG
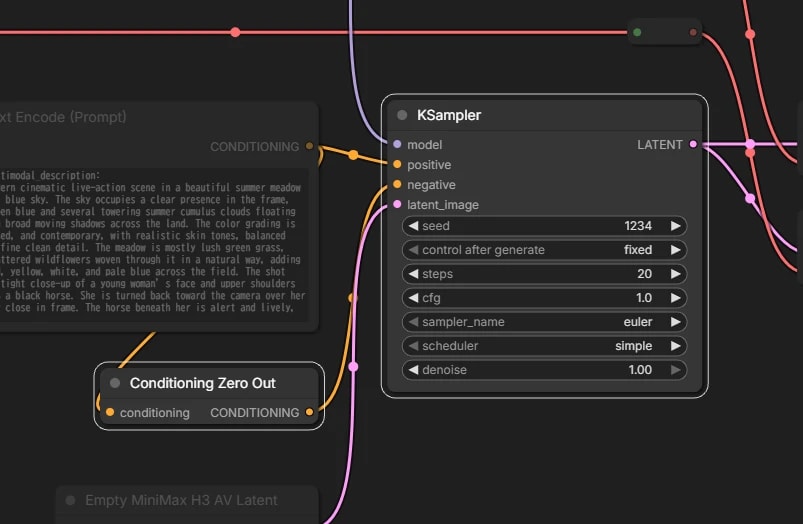
H3 已经是经过 CFG 蒸馏的模型。因此,CFG 设为 1.0。
输出示例
image2video / I2VA
使用模型:fl2va
{
"id": "ab470b3f-c850-4cc5-be9c-63a1bff0dc45",
"revision": 0,
"last_node_id": 103,
"last_link_id": 181,
"nodes": [
{
"id": 77,
"type": "VAEDecodeAudio",
"pos": [
1308.6980183050962,
296.9762089835968
],
"size": [
194.25299723441972,
46
],
"flags": {},
"order": 19,
"mode": 0,
"inputs": [
{
"name": "samples",
"type": "LATENT",
"link": 132
},
{
"name": "vae",
"type": "VAE",
"link": 150
}
],
"outputs": [
{
"name": "AUDIO",
"type": "AUDIO",
"links": [
160
]
}
],
"properties": {
"Node name for S&R": "VAEDecodeAudio",
"cnr_id": "comfy-core",
"ver": "0.30.0"
}
},
{
"id": 91,
"type": "CreateVideo",
"pos": [
1544.2637529711267,
188.1918182373047
],
"size": [
270,
126
],
"flags": {},
"order": 20,
"mode": 0,
"inputs": [
{
"name": "images",
"type": "IMAGE",
"link": 159
},
{
"name": "audio",
"shape": 7,
"type": "AUDIO",
"link": 160
}
],
"outputs": [
{
"name": "VIDEO",
"type": "VIDEO",
"links": [
158
]
}
],
"properties": {
"Node name for S&R": "CreateVideo",
"cnr_id": "comfy-core",
"ver": "0.33.0"
},
"widgets_values": [
24,
8,
"sRGB"
],
"widgets_values_named": {
"fps": 24,
"bit_depth": 8,
"color_space": "sRGB"
}
},
{
"id": 8,
"type": "VAEDecode",
"pos": [
1308.6980183050962,
188.1918182373047
],
"size": [
194.25299723441972,
46
],
"flags": {},
"order": 18,
"mode": 0,
"inputs": [
{
"name": "samples",
"type": "LATENT",
"link": 35
},
{
"name": "vae",
"type": "VAE",
"link": 140
}
],
"outputs": [
{
"name": "IMAGE",
"type": "IMAGE",
"slot_index": 0,
"links": [
159
]
}
],
"properties": {
"Node name for S&R": "VAEDecode",
"cnr_id": "comfy-core",
"ver": "0.3.33"
}
},
{
"id": 82,
"type": "Reroute",
"pos": [
1138.7548217773438,
64.14635395192796
],
"size": [
75,
26
],
"flags": {},
"order": 7,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 149
}
],
"outputs": [
{
"name": "",
"type": "VAE",
"links": [
150
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 79,
"type": "Reroute",
"pos": [
1138.7548217773438,
-59.89911033344882
],
"size": [
75,
26
],
"flags": {},
"order": 8,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 139
}
],
"outputs": [
{
"name": "",
"type": "VAE",
"links": [
140
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 81,
"type": "VAELoader",
"pos": [
52.62317611836556,
64.14635395192796
],
"size": [
301.3524169921875,
58
],
"flags": {},
"order": 0,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "VAE",
"type": "VAE",
"slot_index": 0,
"links": [
149
]
}
],
"properties": {
"Node name for S&R": "VAELoader",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
"minimax_h3_audio_vae_fp32.safetensors"
],
"widgets_values_named": {
"vae_name": "minimax_h3_audio_vae_fp32.safetensors"
},
"color": "#322",
"bgcolor": "#533"
},
{
"id": 75,
"type": "ConditioningZeroOut",
"pos": [
617.2715308676253,
587.3299521252133
],
"size": [
218.4346850585937,
26
],
"flags": {},
"order": 16,
"mode": 0,
"inputs": [
{
"name": "conditioning",
"type": "CONDITIONING",
"link": 179
}
],
"outputs": [
{
"name": "CONDITIONING",
"type": "CONDITIONING",
"links": [
130
]
}
],
"properties": {
"Node name for S&R": "ConditioningZeroOut",
"cnr_id": "comfy-core",
"ver": "0.30.0"
}
},
{
"id": 38,
"type": "CLIPLoader",
"pos": [
52.62317611836556,
188.19181823730474
],
"size": [
301.3524169921875,
106
],
"flags": {},
"order": 1,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "CLIP",
"type": "CLIP",
"slot_index": 0,
"links": [
174
]
}
],
"properties": {
"Node name for S&R": "CLIPLoader",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
"qwen3vl_32b_minimax_h3_int8_convrot.safetensors",
"minimax",
"default"
],
"widgets_values_named": {
"clip_name": "qwen3vl_32b_minimax_h3_int8_convrot.safetensors",
"type": "minimax",
"device": "default"
},
"color": "#432",
"bgcolor": "#653"
},
{
"id": 39,
"type": "VAELoader",
"pos": [
52.62317611836556,
-59.89911033344882
],
"size": [
301.3524169921875,
58
],
"flags": {},
"order": 2,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "VAE",
"type": "VAE",
"slot_index": 0,
"links": [
139,
175
]
}
],
"properties": {
"Node name for S&R": "VAELoader",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
"minimax_h3_video_vae_fp16.safetensors"
],
"widgets_values_named": {
"vae_name": "minimax_h3_video_vae_fp16.safetensors"
},
"color": "#322",
"bgcolor": "#533"
},
{
"id": 94,
"type": "PrimitiveFloat",
"pos": [
-107.86571165334878,
735.0927599465895
],
"size": [
214.65850806503283,
58
],
"flags": {},
"order": 3,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "FLOAT",
"type": "FLOAT",
"links": [
166
]
}
],
"title": "Float: Duration (sec)",
"properties": {
"Node name for S&R": "PrimitiveFloat"
},
"widgets_values": [
6
],
"widgets_values_named": {
"value": 6
}
},
{
"id": 99,
"type": "Reroute",
"pos": [
278.97559311055306,
364.79838929656063
],
"size": [
75,
26
],
"flags": {},
"order": 13,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 169
}
],
"outputs": [
{
"name": "",
"type": "IMAGE",
"links": [
171
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 101,
"type": "MiniMaxH3ImageToVideo",
"pos": [
434.27961405604844,
188.1918182373047
],
"size": [
401.42660187017054,
324.13877587380694
],
"flags": {},
"order": 15,
"mode": 0,
"inputs": [
{
"name": "clip",
"type": "CLIP",
"link": 174
},
{
"name": "vae",
"type": "VAE",
"link": 175
},
{
"name": "first_frame",
"shape": 7,
"type": "IMAGE",
"link": 171
},
{
"name": "last_frame",
"shape": 7,
"type": "IMAGE",
"link": null
},
{
"name": "width",
"type": "INT",
"widget": {
"name": "width"
},
"link": 172
},
{
"name": "height",
"type": "INT",
"widget": {
"name": "height"
},
"link": 173
},
{
"name": "length",
"type": "INT",
"widget": {
"name": "length"
},
"link": 178
}
],
"outputs": [
{
"name": "positive",
"type": "CONDITIONING",
"links": [
176,
179
]
},
{
"name": "LATENT",
"type": "LATENT",
"links": [
177
]
}
],
"properties": {
"Node name for S&R": "MiniMaxH3ImageToVideo"
},
"widgets_values": [
"For the target video, at 0.00 seconds into the target video, <Picture 1> (from [Shot 1]) is fully referenced.\n\nintegrated_multimodal_description:\n[Shot 1] A clean flat-color animated illustration scene begins from the exact composition of <Picture 1>. Two young women are sitting on simple concrete blocks in front of a pale concrete wall under a bright cyan-blue sky. A white cat is sitting on top of the wall at the upper left. The visual style remains consistent with the reference image: minimal modern 2D illustration, clean black outlines, pale gray and white surfaces, and bright cyan-blue accents. The left woman remains seated, holding her smartphone. The right woman remains seated facing the other woman. After a brief moment, the white cat begins walking smoothly along the top of the wall from left to right with light, nimble steps. The two women notice the cat moving.\n\n[Shot 2] At 00:02.300, the cat reaches a point above the right woman and jumps down lightly onto her lap. Both women react with surprise at the sudden movement. Their expressions brighten with a small startled response, and their bodies shift naturally. The right woman quickly welcomes the cat with a warm and happy expression. She looks down at it fondly and gently pets the cat on her lap with one hand. The left woman watches with a surprised but pleased expression while still holding her phone. The cat settles comfortably on the right woman’s lap as she strokes it.\n\noverall_soundscape:\nA light outdoor ambience with a calm open-air feeling. Soft movement sounds from the cat’s steps along the wall. A gentle landing sound as the cat jumps onto the right woman’s lap. Small natural reactions from the two women, expressing brief surprise and delight. Soft petting movement and a calm relaxed atmosphere afterward.\n\nnon_diegetic_music:\nN/A",
1344,
768,
124
],
"widgets_values_named": {
"prompt": "For the target video, at 0.00 seconds into the target video, <Picture 1> (from [Shot 1]) is fully referenced.\n\nintegrated_multimodal_description:\n[Shot 1] A clean flat-color animated illustration scene begins from the exact composition of <Picture 1>. Two young women are sitting on simple concrete blocks in front of a pale concrete wall under a bright cyan-blue sky. A white cat is sitting on top of the wall at the upper left. The visual style remains consistent with the reference image: minimal modern 2D illustration, clean black outlines, pale gray and white surfaces, and bright cyan-blue accents. The left woman remains seated, holding her smartphone. The right woman remains seated facing the other woman. After a brief moment, the white cat begins walking smoothly along the top of the wall from left to right with light, nimble steps. The two women notice the cat moving.\n\n[Shot 2] At 00:02.300, the cat reaches a point above the right woman and jumps down lightly onto her lap. Both women react with surprise at the sudden movement. Their expressions brighten with a small startled response, and their bodies shift naturally. The right woman quickly welcomes the cat with a warm and happy expression. She looks down at it fondly and gently pets the cat on her lap with one hand. The left woman watches with a surprised but pleased expression while still holding her phone. The cat settles comfortably on the right woman’s lap as she strokes it.\n\noverall_soundscape:\nA light outdoor ambience with a calm open-air feeling. Soft movement sounds from the cat’s steps along the wall. A gentle landing sound as the cat jumps onto the right woman’s lap. Small natural reactions from the two women, expressing brief surprise and delight. Soft petting movement and a calm relaxed atmosphere afterward.\n\nnon_diegetic_music:\nN/A",
"width": 1344,
"height": 768,
"length": 124
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 86,
"type": "ModelAttentionBackend",
"pos": [
553.2461981384733,
-207.9445746188256
],
"size": [
270,
58
],
"flags": {},
"order": 11,
"mode": 0,
"inputs": [
{
"name": "model",
"type": "MODEL",
"link": 163
}
],
"outputs": [
{
"name": "MODEL",
"type": "MODEL",
"links": [
164
]
}
],
"properties": {
"Node name for S&R": "ModelAttentionBackend"
},
"widgets_values": [
"comfy kitchen attention"
],
"widgets_values_named": {
"attention": "comfy kitchen attention"
}
},
{
"id": 100,
"type": "GetImageSize",
"pos": [
143.97559311055306,
526.4243293206648
],
"size": [
210,
136
],
"flags": {},
"order": 14,
"mode": 0,
"inputs": [
{
"name": "image",
"type": "IMAGE",
"link": 170
}
],
"outputs": [
{
"name": "width",
"type": "INT",
"links": [
172
]
},
{
"name": "height",
"type": "INT",
"links": [
173
]
},
{
"name": "batch_size",
"type": "INT",
"links": null
}
],
"properties": {
"Node name for S&R": "GetImageSize"
},
"widgets_values": [],
"widgets_values_named": {},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 87,
"type": "ComfyMathExpression",
"pos": [
143.97559311055306,
735.0927599465895
],
"size": [
210,
128
],
"flags": {},
"order": 9,
"mode": 0,
"inputs": [
{
"label": "a",
"name": "values.a",
"type": "FLOAT,INT,BOOLEAN",
"link": 166
},
{
"name": "values.b",
"shape": 7,
"type": "FLOAT,INT,BOOLEAN",
"link": null
}
],
"outputs": [
{
"name": "FLOAT",
"type": "FLOAT",
"links": null
},
{
"name": "INT",
"type": "INT",
"links": [
178
]
},
{
"name": "BOOL",
"type": "BOOLEAN",
"links": null
}
],
"properties": {
"Node name for S&R": "ComfyMathExpression",
"cnr_id": "comfy-core",
"ver": "0.33.0"
},
"widgets_values": [
"17 * round((a * 24 - 5) / 17) + 5"
],
"widgets_values_named": {
"expression": "17 * round((a * 24 - 5) / 17) + 5"
}
},
{
"id": 95,
"type": "MarkdownNote",
"pos": [
-482.3943342566212,
-207.9445746188256
],
"size": [
480.26512898835654,
314.3204118484383
],
"flags": {},
"order": 4,
"mode": 0,
"inputs": [],
"outputs": [],
"properties": {},
"widgets_values": [
"## models\n- diffusion_models\n - [minimax_h3_fl2va_pruned_int8_convrot.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/diffusion_models/minimax_h3_fl2va_pruned_int8_convrot.safetensors) (21 GB)\n- text_encoders\n - [qwen3vl_32b_minimax_h3_int8_convrot.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/text_encoders/qwen3vl_32b_minimax_h3_int8_convrot.safetensors) (27.1 GB)\n- vae\n - [minimax_h3_audio_vae_fp32.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/vae/minimax_h3_audio_vae_fp32.safetensors) (605 MB)\n - [minimax_h3_video_vae_fp16.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/vae/minimax_h3_video_vae_fp16.safetensors) (5.21 GB)\n\n```text\n📂ComfyUI/\n└── 📂models/\n ├── 📂diffusion_models/\n │ └── minimax_h3_fl2va_pruned_int8_convrot.safetensors\n ├── 📂text_encoders/\n │ └── qwen3vl_32b_minimax_h3_int8_convrot.safetensors\n └── 📂vae/\n ├── minimax_h3_audio_vae_fp32.safetensors\n └── minimax_h3_video_vae_fp16.safetensors\n```"
],
"widgets_values_named": {
"text": "## models\n- diffusion_models\n - [minimax_h3_fl2va_pruned_int8_convrot.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/diffusion_models/minimax_h3_fl2va_pruned_int8_convrot.safetensors) (21 GB)\n- text_encoders\n - [qwen3vl_32b_minimax_h3_int8_convrot.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/text_encoders/qwen3vl_32b_minimax_h3_int8_convrot.safetensors) (27.1 GB)\n- vae\n - [minimax_h3_audio_vae_fp32.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/vae/minimax_h3_audio_vae_fp32.safetensors) (605 MB)\n - [minimax_h3_video_vae_fp16.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/vae/minimax_h3_video_vae_fp16.safetensors) (5.21 GB)\n\n```text\n📂ComfyUI/\n└── 📂models/\n ├── 📂diffusion_models/\n │ └── minimax_h3_fl2va_pruned_int8_convrot.safetensors\n ├── 📂text_encoders/\n │ └── qwen3vl_32b_minimax_h3_int8_convrot.safetensors\n └── 📂vae/\n ├── minimax_h3_audio_vae_fp32.safetensors\n └── minimax_h3_video_vae_fp16.safetensors\n```"
},
"color": "#323",
"bgcolor": "#535"
},
{
"id": 96,
"type": "LoadImage",
"pos": [
-1007.6200390580731,
364.79838929656063
],
"size": [
398.54459728491383,
436.23402150223933
],
"flags": {},
"order": 5,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "IMAGE",
"type": "IMAGE",
"links": [
167
]
},
{
"name": "MASK",
"type": "MASK",
"links": null
}
],
"properties": {
"Node name for S&R": "LoadImage"
},
"widgets_values": [
"viewfilename=ComfyUI_temp_hfkfv_00002_.png",
"image"
],
"widgets_values_named": {
"image": "viewfilename=ComfyUI_temp_hfkfv_00002_.png",
"upload": "image"
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 97,
"type": "ResizeImageMaskNode",
"pos": [
-573.2971690475886,
364.79838929656063
],
"size": [
270,
106
],
"flags": {},
"order": 10,
"mode": 0,
"inputs": [
{
"name": "input",
"type": "IMAGE,MASK",
"link": 167
}
],
"outputs": [
{
"name": "resized",
"type": "IMAGE",
"links": [
168
]
}
],
"properties": {
"Node name for S&R": "ResizeImageMaskNode"
},
"widgets_values": [
"scale total pixels",
1,
"bicubic"
],
"widgets_values_named": {
"resize_type": "scale total pixels",
"resize_type.megapixels": 1,
"scale_method": "bicubic"
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 98,
"type": "ResizeImageMaskNode",
"pos": [
-267.5188963220179,
364.79838929656063
],
"size": [
270,
106
],
"flags": {},
"order": 12,
"mode": 0,
"inputs": [
{
"name": "input",
"type": "IMAGE,MASK",
"link": 168
}
],
"outputs": [
{
"name": "resized",
"type": "IMAGE",
"links": [
169,
170
]
}
],
"properties": {
"Node name for S&R": "ResizeImageMaskNode"
},
"widgets_values": [
"scale to multiple",
32,
"bicubic"
],
"widgets_values_named": {
"resize_type": "scale to multiple",
"resize_type.multiple": 32,
"scale_method": "bicubic"
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 3,
"type": "KSampler",
"pos": [
898.7548217773438,
188.1918182373047
],
"size": [
315,
262
],
"flags": {},
"order": 17,
"mode": 0,
"inputs": [
{
"name": "model",
"type": "MODEL",
"link": 164
},
{
"name": "positive",
"type": "CONDITIONING",
"link": 176
},
{
"name": "negative",
"type": "CONDITIONING",
"link": 130
},
{
"name": "latent_image",
"type": "LATENT",
"link": 177
}
],
"outputs": [
{
"name": "LATENT",
"type": "LATENT",
"slot_index": 0,
"links": [
35,
132
]
}
],
"properties": {
"Node name for S&R": "KSampler",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
1234,
"fixed",
20,
1,
"euler",
"simple",
1
],
"widgets_values_named": {
"seed": 1234,
"control_after_generate": "fixed",
"steps": 20,
"cfg": 1,
"sampler_name": "euler",
"scheduler": "simple",
"denoise": 1
}
},
{
"id": 37,
"type": "UNETLoader",
"pos": [
209.5978600183359,
-207.9445746188256
],
"size": [
305.3782043457031,
82
],
"flags": {},
"order": 6,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "MODEL",
"type": "MODEL",
"slot_index": 0,
"links": [
163
]
}
],
"properties": {
"Node name for S&R": "UNETLoader",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
"minimax_h3_fl2va_pruned_int8_convrot.safetensors",
"default"
],
"widgets_values_named": {
"unet_name": "minimax_h3_fl2va_pruned_int8_convrot.safetensors",
"weight_dtype": "default"
},
"color": "#323",
"bgcolor": "#535"
},
{
"id": 92,
"type": "SaveVideo",
"pos": [
1855.5764904027374,
188.1918182373047
],
"size": [
598.8856025525538,
547.1642019144153
],
"flags": {},
"order": 21,
"mode": 0,
"inputs": [
{
"name": "video",
"type": "VIDEO",
"link": 158
}
],
"outputs": [
{
"name": "video",
"type": "VIDEO",
"links": null
}
],
"properties": {
"cnr_id": "comfy-core",
"ver": "0.33.0"
},
"widgets_values": [
"video/ComfyUI",
"auto",
"auto",
"auto"
],
"widgets_values_named": {
"filename_prefix": "video/ComfyUI",
"format": "auto",
"format.codec": "auto",
"codec": "auto"
}
}
],
"links": [
[
35,
3,
0,
8,
0,
"LATENT"
],
[
130,
75,
0,
3,
2,
"CONDITIONING"
],
[
132,
3,
0,
77,
0,
"LATENT"
],
[
139,
39,
0,
79,
0,
"VAE"
],
[
140,
79,
0,
8,
1,
"VAE"
],
[
149,
81,
0,
82,
0,
"VAE"
],
[
150,
82,
0,
77,
1,
"VAE"
],
[
158,
91,
0,
92,
0,
"VIDEO"
],
[
159,
8,
0,
91,
0,
"IMAGE"
],
[
160,
77,
0,
91,
1,
"AUDIO"
],
[
163,
37,
0,
86,
0,
"MODEL"
],
[
164,
86,
0,
3,
0,
"MODEL"
],
[
166,
94,
0,
87,
0,
"FLOAT"
],
[
167,
96,
0,
97,
0,
"IMAGE"
],
[
168,
97,
0,
98,
0,
"IMAGE"
],
[
169,
98,
0,
99,
0,
"IMAGE"
],
[
170,
98,
0,
100,
0,
"IMAGE"
],
[
171,
99,
0,
101,
2,
"IMAGE"
],
[
172,
100,
0,
101,
4,
"INT"
],
[
173,
100,
1,
101,
5,
"INT"
],
[
174,
38,
0,
101,
0,
"CLIP"
],
[
175,
39,
0,
101,
1,
"VAE"
],
[
176,
101,
0,
3,
1,
"CONDITIONING"
],
[
177,
101,
1,
3,
3,
"LATENT"
],
[
178,
87,
1,
101,
6,
"INT"
],
[
179,
101,
0,
75,
0,
"CONDITIONING"
]
],
"groups": [],
"config": {},
"extra": {
"ds": {
"scale": 0.473624407447671,
"offset": [
620.0566093729506,
528.8632447792029
]
},
"frontendVersion": "1.51.9",
"VHS_latentpreview": false,
"VHS_latentpreviewrate": 0,
"VHS_MetadataImage": true,
"VHS_KeepIntermediate": true
},
"version": 0.4
}
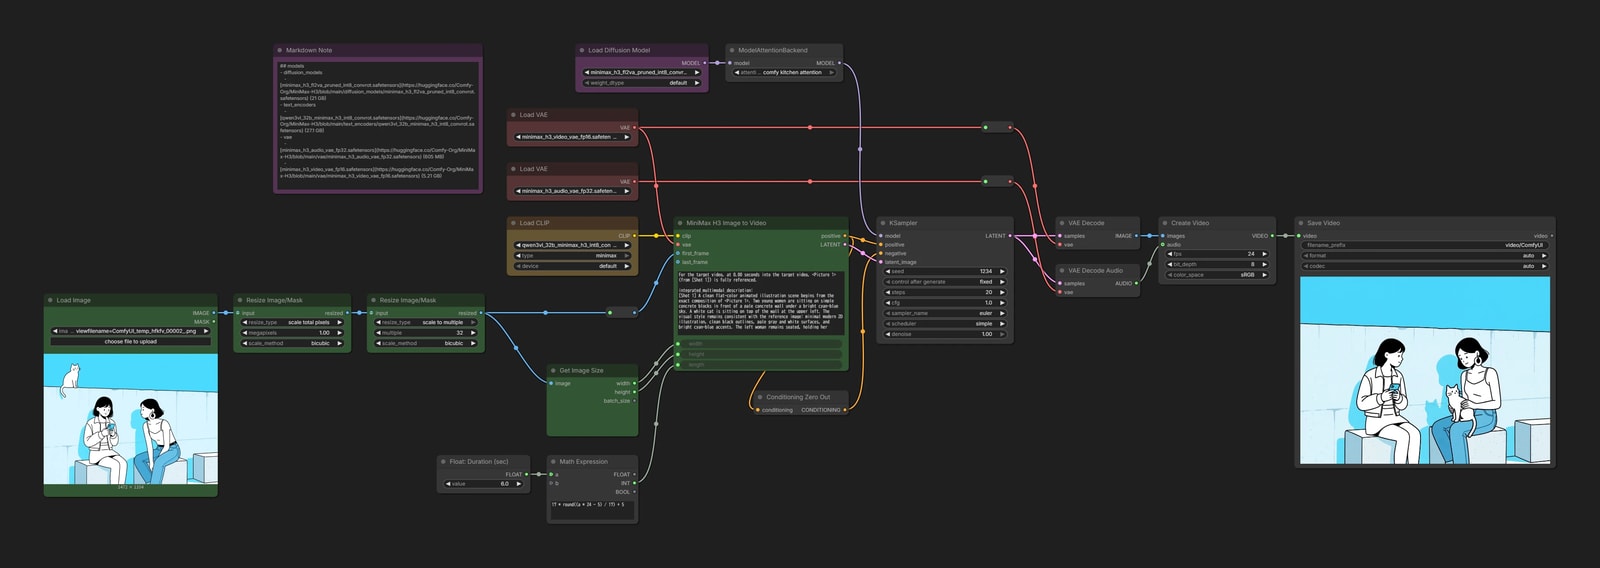
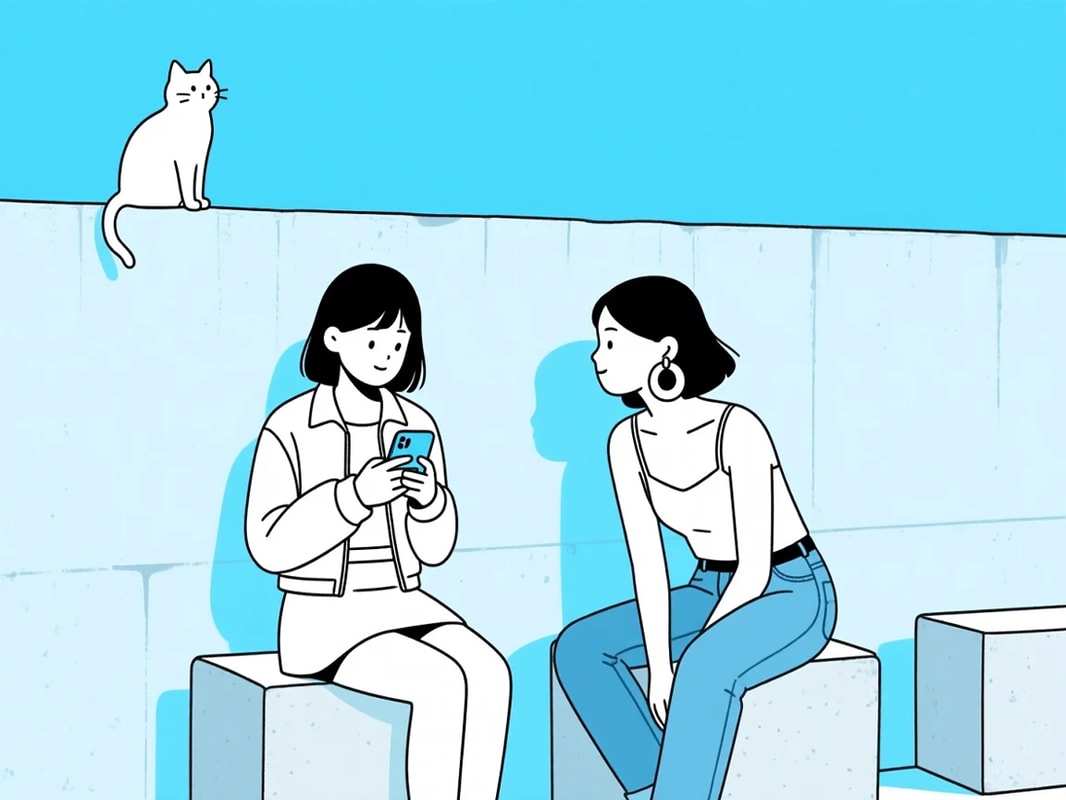
在 MiniMax H3 Image to Video 中输入提示词和第一张图像。
输出示例
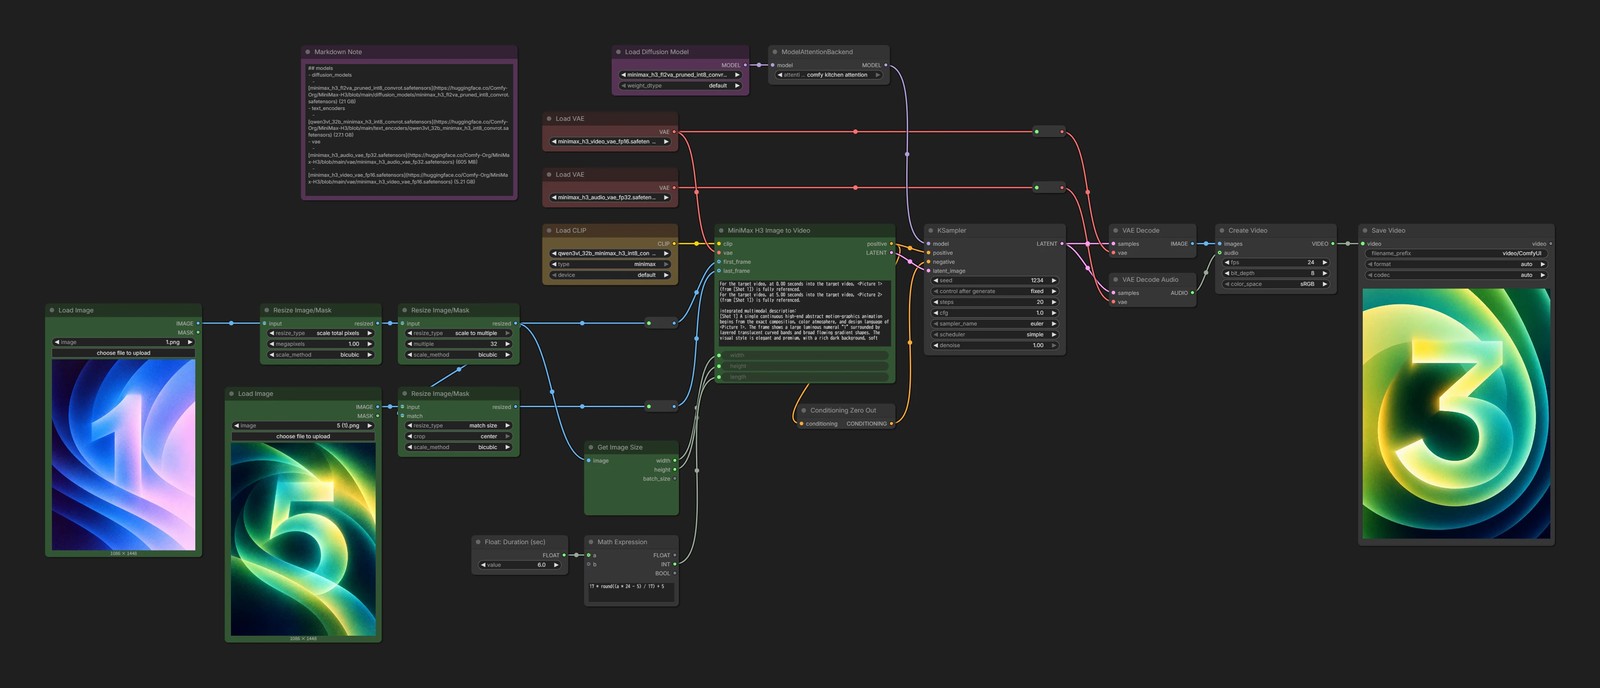
First / Last Frame to Video
使用模型:fl2va
{
"id": "6bfbac2d-3c68-4483-85ea-d512d058324d",
"revision": 0,
"last_node_id": 109,
"last_link_id": 188,
"nodes": [
{
"id": 77,
"type": "VAEDecodeAudio",
"pos": [
1308.6980183050962,
296.9762089835968
],
"size": [
194.25299723441972,
46
],
"flags": {},
"order": 22,
"mode": 0,
"inputs": [
{
"name": "samples",
"type": "LATENT",
"link": 132
},
{
"name": "vae",
"type": "VAE",
"link": 150
}
],
"outputs": [
{
"name": "AUDIO",
"type": "AUDIO",
"links": [
160
]
}
],
"properties": {
"Node name for S&R": "VAEDecodeAudio",
"cnr_id": "comfy-core",
"ver": "0.30.0"
}
},
{
"id": 8,
"type": "VAEDecode",
"pos": [
1308.6980183050962,
188.1918182373047
],
"size": [
194.25299723441972,
46
],
"flags": {},
"order": 21,
"mode": 0,
"inputs": [
{
"name": "samples",
"type": "LATENT",
"link": 35
},
{
"name": "vae",
"type": "VAE",
"link": 140
}
],
"outputs": [
{
"name": "IMAGE",
"type": "IMAGE",
"slot_index": 0,
"links": [
159
]
}
],
"properties": {
"Node name for S&R": "VAEDecode",
"cnr_id": "comfy-core",
"ver": "0.3.33"
}
},
{
"id": 82,
"type": "Reroute",
"pos": [
1138.7548217773438,
64.14635395192796
],
"size": [
75,
26
],
"flags": {},
"order": 8,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 149
}
],
"outputs": [
{
"name": "",
"type": "VAE",
"links": [
150
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 79,
"type": "Reroute",
"pos": [
1138.7548217773438,
-59.89911033344882
],
"size": [
75,
26
],
"flags": {},
"order": 9,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 139
}
],
"outputs": [
{
"name": "",
"type": "VAE",
"links": [
140
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 81,
"type": "VAELoader",
"pos": [
52.62317611836556,
64.14635395192796
],
"size": [
301.3524169921875,
58
],
"flags": {},
"order": 0,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "VAE",
"type": "VAE",
"slot_index": 0,
"links": [
149
]
}
],
"properties": {
"Node name for S&R": "VAELoader",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
"minimax_h3_audio_vae_fp32.safetensors"
],
"widgets_values_named": {
"vae_name": "minimax_h3_audio_vae_fp32.safetensors"
},
"color": "#322",
"bgcolor": "#533"
},
{
"id": 75,
"type": "ConditioningZeroOut",
"pos": [
617.2715308676253,
587.3299521252133
],
"size": [
218.4346850585937,
26
],
"flags": {},
"order": 19,
"mode": 0,
"inputs": [
{
"name": "conditioning",
"type": "CONDITIONING",
"link": 179
}
],
"outputs": [
{
"name": "CONDITIONING",
"type": "CONDITIONING",
"links": [
130
]
}
],
"properties": {
"Node name for S&R": "ConditioningZeroOut",
"cnr_id": "comfy-core",
"ver": "0.30.0"
}
},
{
"id": 38,
"type": "CLIPLoader",
"pos": [
52.62317611836556,
188.19181823730474
],
"size": [
301.3524169921875,
106
],
"flags": {},
"order": 1,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "CLIP",
"type": "CLIP",
"slot_index": 0,
"links": [
174
]
}
],
"properties": {
"Node name for S&R": "CLIPLoader",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
"qwen3vl_32b_minimax_h3_int8_convrot.safetensors",
"minimax",
"default"
],
"widgets_values_named": {
"clip_name": "qwen3vl_32b_minimax_h3_int8_convrot.safetensors",
"type": "minimax",
"device": "default"
},
"color": "#432",
"bgcolor": "#653"
},
{
"id": 39,
"type": "VAELoader",
"pos": [
52.62317611836556,
-59.89911033344882
],
"size": [
301.3524169921875,
58
],
"flags": {},
"order": 2,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "VAE",
"type": "VAE",
"slot_index": 0,
"links": [
139,
175
]
}
],
"properties": {
"Node name for S&R": "VAELoader",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
"minimax_h3_video_vae_fp16.safetensors"
],
"widgets_values_named": {
"vae_name": "minimax_h3_video_vae_fp16.safetensors"
},
"color": "#322",
"bgcolor": "#533"
},
{
"id": 94,
"type": "PrimitiveFloat",
"pos": [
-104.58269993214344,
879.0768919855448
],
"size": [
214.65850806503283,
58
],
"flags": {},
"order": 3,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "FLOAT",
"type": "FLOAT",
"links": [
166
]
}
],
"title": "Float: Duration (sec)",
"properties": {
"Node name for S&R": "PrimitiveFloat"
},
"widgets_values": [
6
],
"widgets_values_named": {
"value": 6
}
},
{
"id": 86,
"type": "ModelAttentionBackend",
"pos": [
553.2461981384733,
-207.9445746188256
],
"size": [
270,
58
],
"flags": {},
"order": 12,
"mode": 0,
"inputs": [
{
"name": "model",
"type": "MODEL",
"link": 163
}
],
"outputs": [
{
"name": "MODEL",
"type": "MODEL",
"links": [
164
]
}
],
"properties": {
"Node name for S&R": "ModelAttentionBackend"
},
"widgets_values": [
"comfy kitchen attention"
],
"widgets_values_named": {
"attention": "comfy kitchen attention"
}
},
{
"id": 87,
"type": "ComfyMathExpression",
"pos": [
145.4173000678566,
879.0768919855448
],
"size": [
210,
128
],
"flags": {},
"order": 10,
"mode": 0,
"inputs": [
{
"label": "a",
"name": "values.a",
"type": "FLOAT,INT,BOOLEAN",
"link": 166
},
{
"name": "values.b",
"shape": 7,
"type": "FLOAT,INT,BOOLEAN",
"link": null
}
],
"outputs": [
{
"name": "FLOAT",
"type": "FLOAT",
"links": null
},
{
"name": "INT",
"type": "INT",
"links": [
178
]
},
{
"name": "BOOL",
"type": "BOOLEAN",
"links": null
}
],
"properties": {
"Node name for S&R": "ComfyMathExpression",
"cnr_id": "comfy-core",
"ver": "0.33.0"
},
"widgets_values": [
"17 * round((a * 24 - 5) / 17) + 5"
],
"widgets_values_named": {
"expression": "17 * round((a * 24 - 5) / 17) + 5"
}
},
{
"id": 95,
"type": "MarkdownNote",
"pos": [
-482.3943342566212,
-207.9445746188256
],
"size": [
480.26512898835654,
314.3204118484383
],
"flags": {},
"order": 4,
"mode": 0,
"inputs": [],
"outputs": [],
"properties": {},
"widgets_values": [
"## models\n- diffusion_models\n - [minimax_h3_fl2va_pruned_int8_convrot.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/diffusion_models/minimax_h3_fl2va_pruned_int8_convrot.safetensors) (21 GB)\n- text_encoders\n - [qwen3vl_32b_minimax_h3_int8_convrot.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/text_encoders/qwen3vl_32b_minimax_h3_int8_convrot.safetensors) (27.1 GB)\n- vae\n - [minimax_h3_audio_vae_fp32.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/vae/minimax_h3_audio_vae_fp32.safetensors) (605 MB)\n - [minimax_h3_video_vae_fp16.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/vae/minimax_h3_video_vae_fp16.safetensors) (5.21 GB)\n\n```text\n📂ComfyUI/\n└── 📂models/\n ├── 📂diffusion_models/\n │ └── minimax_h3_fl2va_pruned_int8_convrot.safetensors\n ├── 📂text_encoders/\n │ └── qwen3vl_32b_minimax_h3_int8_convrot.safetensors\n └── 📂vae/\n ├── minimax_h3_audio_vae_fp32.safetensors\n └── minimax_h3_video_vae_fp16.safetensors\n```"
],
"widgets_values_named": {
"text": "## models\n- diffusion_models\n - [minimax_h3_fl2va_pruned_int8_convrot.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/diffusion_models/minimax_h3_fl2va_pruned_int8_convrot.safetensors) (21 GB)\n- text_encoders\n - [qwen3vl_32b_minimax_h3_int8_convrot.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/text_encoders/qwen3vl_32b_minimax_h3_int8_convrot.safetensors) (27.1 GB)\n- vae\n - [minimax_h3_audio_vae_fp32.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/vae/minimax_h3_audio_vae_fp32.safetensors) (605 MB)\n - [minimax_h3_video_vae_fp16.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/vae/minimax_h3_video_vae_fp16.safetensors) (5.21 GB)\n\n```text\n📂ComfyUI/\n└── 📂models/\n ├── 📂diffusion_models/\n │ └── minimax_h3_fl2va_pruned_int8_convrot.safetensors\n ├── 📂text_encoders/\n │ └── qwen3vl_32b_minimax_h3_int8_convrot.safetensors\n └── 📂vae/\n ├── minimax_h3_audio_vae_fp32.safetensors\n └── minimax_h3_video_vae_fp16.safetensors\n```"
},
"color": "#323",
"bgcolor": "#535"
},
{
"id": 97,
"type": "ResizeImageMaskNode",
"pos": [
-573.2971690475886,
364.79838929656063
],
"size": [
270,
106
],
"flags": {},
"order": 11,
"mode": 0,
"inputs": [
{
"name": "input",
"type": "IMAGE,MASK",
"link": 167
}
],
"outputs": [
{
"name": "resized",
"type": "IMAGE",
"links": [
168
]
}
],
"properties": {
"Node name for S&R": "ResizeImageMaskNode"
},
"widgets_values": [
"scale total pixels",
1,
"bicubic"
],
"widgets_values_named": {
"resize_type": "scale total pixels",
"resize_type.megapixels": 1,
"scale_method": "bicubic"
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 98,
"type": "ResizeImageMaskNode",
"pos": [
-267.5188963220179,
364.79838929656063
],
"size": [
270,
106
],
"flags": {},
"order": 13,
"mode": 0,
"inputs": [
{
"name": "input",
"type": "IMAGE,MASK",
"link": 168
}
],
"outputs": [
{
"name": "resized",
"type": "IMAGE",
"links": [
169,
170,
184
]
}
],
"properties": {
"Node name for S&R": "ResizeImageMaskNode"
},
"widgets_values": [
"scale to multiple",
32,
"bicubic"
],
"widgets_values_named": {
"resize_type": "scale to multiple",
"resize_type.multiple": 32,
"scale_method": "bicubic"
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 99,
"type": "Reroute",
"pos": [
278.97559311055306,
364.79838929656063
],
"size": [
75,
26
],
"flags": {},
"order": 14,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 169
}
],
"outputs": [
{
"name": "",
"type": "IMAGE",
"links": [
171
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 104,
"type": "LoadImage",
"pos": [
-651.3682490867859,
550.1538889682714
],
"size": [
348.07108003919734,
537.1808623524007
],
"flags": {},
"order": 5,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "IMAGE",
"type": "IMAGE",
"links": [
185
]
},
{
"name": "MASK",
"type": "MASK",
"links": null
}
],
"properties": {
"Node name for S&R": "LoadImage"
},
"widgets_values": [
"5 (1).png",
"image"
],
"widgets_values_named": {
"image": "5 (1).png",
"upload": "image"
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 96,
"type": "LoadImage",
"pos": [
-1049.571980462346,
364.79838929656063
],
"size": [
348.07108003919734,
532.8546258823376
],
"flags": {},
"order": 6,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "IMAGE",
"type": "IMAGE",
"links": [
167
]
},
{
"name": "MASK",
"type": "MASK",
"links": null
}
],
"properties": {
"Node name for S&R": "LoadImage"
},
"widgets_values": [
"1.png",
"image"
],
"widgets_values_named": {
"image": "1.png",
"upload": "image"
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 106,
"type": "Reroute",
"pos": [
278.97559311055306,
549.6075368986789
],
"size": [
75,
26
],
"flags": {},
"order": 17,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 187
}
],
"outputs": [
{
"name": "",
"type": "IMAGE",
"links": [
186
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 105,
"type": "ResizeImageMaskNode",
"pos": [
-267.5188963220179,
549.6075368986789
],
"size": [
270,
126
],
"flags": {},
"order": 16,
"mode": 0,
"inputs": [
{
"name": "input",
"type": "IMAGE,MASK",
"link": 185
},
{
"name": "resize_type.match",
"type": "IMAGE,MASK",
"link": 184
}
],
"outputs": [
{
"name": "resized",
"type": "IMAGE",
"links": [
187
]
}
],
"properties": {
"Node name for S&R": "ResizeImageMaskNode"
},
"widgets_values": [
"match size",
"center",
"bicubic"
],
"widgets_values_named": {
"resize_type": "match size",
"resize_type.crop": "center",
"scale_method": "bicubic"
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 100,
"type": "GetImageSize",
"pos": [
145.4173000678566,
669.0768919855448
],
"size": [
210,
136
],
"flags": {},
"order": 15,
"mode": 0,
"inputs": [
{
"name": "image",
"type": "IMAGE",
"link": 170
}
],
"outputs": [
{
"name": "width",
"type": "INT",
"links": [
172
]
},
{
"name": "height",
"type": "INT",
"links": [
173
]
},
{
"name": "batch_size",
"type": "INT",
"links": null
}
],
"properties": {
"Node name for S&R": "GetImageSize"
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 91,
"type": "CreateVideo",
"pos": [
1544.2637529711267,
188.1918182373047
],
"size": [
270,
126
],
"flags": {},
"order": 23,
"mode": 0,
"inputs": [
{
"name": "images",
"type": "IMAGE",
"link": 159
},
{
"name": "audio",
"shape": 7,
"type": "AUDIO",
"link": 160
}
],
"outputs": [
{
"name": "VIDEO",
"type": "VIDEO",
"links": [
188
]
}
],
"properties": {
"Node name for S&R": "CreateVideo",
"cnr_id": "comfy-core",
"ver": "0.33.0"
},
"widgets_values": [
24,
8,
"sRGB"
],
"widgets_values_named": {
"fps": 24,
"bit_depth": 8,
"color_space": "sRGB"
}
},
{
"id": 101,
"type": "MiniMaxH3ImageToVideo",
"pos": [
434.27961405604844,
188.1918182373047
],
"size": [
401.42660187017054,
324.13877587380694
],
"flags": {},
"order": 18,
"mode": 0,
"inputs": [
{
"name": "clip",
"type": "CLIP",
"link": 174
},
{
"name": "vae",
"type": "VAE",
"link": 175
},
{
"name": "first_frame",
"shape": 7,
"type": "IMAGE",
"link": 171
},
{
"name": "last_frame",
"shape": 7,
"type": "IMAGE",
"link": 186
},
{
"name": "width",
"type": "INT",
"widget": {
"name": "width"
},
"link": 172
},
{
"name": "height",
"type": "INT",
"widget": {
"name": "height"
},
"link": 173
},
{
"name": "length",
"type": "INT",
"widget": {
"name": "length"
},
"link": 178
}
],
"outputs": [
{
"name": "positive",
"type": "CONDITIONING",
"links": [
176,
179
]
},
{
"name": "LATENT",
"type": "LATENT",
"links": [
177
]
}
],
"properties": {
"Node name for S&R": "MiniMaxH3ImageToVideo"
},
"widgets_values": [
"For the target video, at 0.00 seconds into the target video, <Picture 1> (from [Shot 1]) is fully referenced.\nFor the target video, at 5.00 seconds into the target video, <Picture 2> (from [Shot 1]) is fully referenced.\n\nintegrated_multimodal_description:\n[Shot 1] A single continuous high-end abstract motion-graphics animation begins from the exact composition, color atmosphere, and design language of <Picture 1>. The frame shows a large luminous numeral \"1\" surrounded by layered translucent curved bands and broad flowing gradient shapes. The visual style is elegant and premium, with a rich dark background, soft glow, subtle fine-grain texture, smooth gradients, and overlapping semi-transparent ribbon-like forms. The entire animation is one uninterrupted visual flow with no cuts and no abrupt switching.\n\nFrom 00:00.000 onward, the curved translucent bands and gradient surfaces are always in motion, flowing smoothly like luminous ribbons and soft graphic waves. The motion feels intentional, clean, and beautifully eased, like sophisticated title-sequence motion design. The shapes continuously bend, stretch, overlap, and sweep across the frame, and the current numeral is always formed by these same moving gradient elements.\n\nFrom 00:00.000 to 00:01.000, the numeral \"1\" is clearly readable as the initial form. During this interval, the surrounding bands and arcs flow gently and begin to pull the shape of the \"1\" into motion.\n\nAround 00:01.000, the \"1\" does not disappear or switch. Instead, its edges soften and elongate, and the same luminous bands that define it curve and wrap into a new structure. The moving gradient ribbons naturally reshape the composition, and the numeral \"2\" emerges directly out of the flowing forms.\n\nFrom 00:01.000 to 00:02.000, the numeral \"2\" becomes clearly readable while still remaining part of the same living system of translucent moving shapes. The arcs continue to circulate around it and through it, carrying the motion forward.\n\nAround 00:02.000, the same bands and gradient layers continue flowing without interruption. The body of the \"2\" opens, curls, and reconnects as the graphic motion pulls the figure into a new configuration. The numeral \"3\" is created organically from this transformation, as though the moving gradients themselves are sculpting it in real time.\n\nFrom 00:02.000 to 00:03.000, the numeral \"3\" is clearly readable, large and central, while the surrounding luminous curves continue their graceful motion.\n\nAround 00:03.000, the flowing bands sweep again across the composition. The upper and lower curves of the \"3\" straighten and re-balance as the translucent layers pivot and slide, and the numeral \"4\" forms naturally from the same continuous motion. The transformation remains fluid and connected, with no hard cut and no isolated replacement of the number.\n\nFrom 00:03.000 to 00:04.000, the numeral \"4\" is clearly readable at center, still made from the same evolving system of glowing arcs and gradient ribbons.\n\nAround 00:04.000, the motion carries forward into the final transformation. The linear and angular structure of the \"4\" gradually softens and rounds into a more circular, spiral-like composition. The luminous gradient bands continue sweeping and folding, and the numeral \"5\" emerges as the final resolved figure from the same uninterrupted flow.\n\nFrom 00:04.000 to 00:05.000, the numeral \"5\" becomes clearly readable and increasingly stable. At the same time, the palette shifts naturally and continuously into the green, cyan, and yellow luminous color world of <Picture 2>. The surrounding arcs and layered gradient shapes settle into the exact visual identity and final composition of <Picture 2> by the last frame. The entire sequence feels like one coherent continuous morphing animation in which moving gradients generate each new number in turn.\n\noverall_soundscape:\nN/A\n\nnon_diegetic_music:\nN/A",
1344,
768,
124
],
"widgets_values_named": {
"prompt": "For the target video, at 0.00 seconds into the target video, <Picture 1> (from [Shot 1]) is fully referenced.\nFor the target video, at 5.00 seconds into the target video, <Picture 2> (from [Shot 1]) is fully referenced.\n\nintegrated_multimodal_description:\n[Shot 1] A single continuous high-end abstract motion-graphics animation begins from the exact composition, color atmosphere, and design language of <Picture 1>. The frame shows a large luminous numeral \"1\" surrounded by layered translucent curved bands and broad flowing gradient shapes. The visual style is elegant and premium, with a rich dark background, soft glow, subtle fine-grain texture, smooth gradients, and overlapping semi-transparent ribbon-like forms. The entire animation is one uninterrupted visual flow with no cuts and no abrupt switching.\n\nFrom 00:00.000 onward, the curved translucent bands and gradient surfaces are always in motion, flowing smoothly like luminous ribbons and soft graphic waves. The motion feels intentional, clean, and beautifully eased, like sophisticated title-sequence motion design. The shapes continuously bend, stretch, overlap, and sweep across the frame, and the current numeral is always formed by these same moving gradient elements.\n\nFrom 00:00.000 to 00:01.000, the numeral \"1\" is clearly readable as the initial form. During this interval, the surrounding bands and arcs flow gently and begin to pull the shape of the \"1\" into motion.\n\nAround 00:01.000, the \"1\" does not disappear or switch. Instead, its edges soften and elongate, and the same luminous bands that define it curve and wrap into a new structure. The moving gradient ribbons naturally reshape the composition, and the numeral \"2\" emerges directly out of the flowing forms.\n\nFrom 00:01.000 to 00:02.000, the numeral \"2\" becomes clearly readable while still remaining part of the same living system of translucent moving shapes. The arcs continue to circulate around it and through it, carrying the motion forward.\n\nAround 00:02.000, the same bands and gradient layers continue flowing without interruption. The body of the \"2\" opens, curls, and reconnects as the graphic motion pulls the figure into a new configuration. The numeral \"3\" is created organically from this transformation, as though the moving gradients themselves are sculpting it in real time.\n\nFrom 00:02.000 to 00:03.000, the numeral \"3\" is clearly readable, large and central, while the surrounding luminous curves continue their graceful motion.\n\nAround 00:03.000, the flowing bands sweep again across the composition. The upper and lower curves of the \"3\" straighten and re-balance as the translucent layers pivot and slide, and the numeral \"4\" forms naturally from the same continuous motion. The transformation remains fluid and connected, with no hard cut and no isolated replacement of the number.\n\nFrom 00:03.000 to 00:04.000, the numeral \"4\" is clearly readable at center, still made from the same evolving system of glowing arcs and gradient ribbons.\n\nAround 00:04.000, the motion carries forward into the final transformation. The linear and angular structure of the \"4\" gradually softens and rounds into a more circular, spiral-like composition. The luminous gradient bands continue sweeping and folding, and the numeral \"5\" emerges as the final resolved figure from the same uninterrupted flow.\n\nFrom 00:04.000 to 00:05.000, the numeral \"5\" becomes clearly readable and increasingly stable. At the same time, the palette shifts naturally and continuously into the green, cyan, and yellow luminous color world of <Picture 2>. The surrounding arcs and layered gradient shapes settle into the exact visual identity and final composition of <Picture 2> by the last frame. The entire sequence feels like one coherent continuous morphing animation in which moving gradients generate each new number in turn.\n\noverall_soundscape:\nN/A\n\nnon_diegetic_music:\nN/A",
"width": 1344,
"height": 768,
"length": 124
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 3,
"type": "KSampler",
"pos": [
898.7548217773438,
188.1918182373047
],
"size": [
315,
262
],
"flags": {},
"order": 20,
"mode": 0,
"inputs": [
{
"name": "model",
"type": "MODEL",
"link": 164
},
{
"name": "positive",
"type": "CONDITIONING",
"link": 176
},
{
"name": "negative",
"type": "CONDITIONING",
"link": 130
},
{
"name": "latent_image",
"type": "LATENT",
"link": 177
}
],
"outputs": [
{
"name": "LATENT",
"type": "LATENT",
"slot_index": 0,
"links": [
35,
132
]
}
],
"properties": {
"Node name for S&R": "KSampler",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
1234,
"fixed",
20,
1,
"euler",
"simple",
1
],
"widgets_values_named": {
"seed": 1234,
"control_after_generate": "fixed",
"steps": 20,
"cfg": 1,
"sampler_name": "euler",
"scheduler": "simple",
"denoise": 1
}
},
{
"id": 37,
"type": "UNETLoader",
"pos": [
206.3645345899397,
-207.9445746188256
],
"size": [
305.3782043457031,
82
],
"flags": {},
"order": 7,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "MODEL",
"type": "MODEL",
"slot_index": 0,
"links": [
163
]
}
],
"properties": {
"Node name for S&R": "UNETLoader",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
"minimax_h3_fl2va_pruned_int8_convrot.safetensors",
"default"
],
"widgets_values_named": {
"unet_name": "minimax_h3_fl2va_pruned_int8_convrot.safetensors",
"weight_dtype": "default"
},
"color": "#323",
"bgcolor": "#535"
},
{
"id": 107,
"type": "SaveVideo",
"pos": [
1861.4809437304043,
188.1918182373047
],
"size": [
435.86592704079794,
684.6314335785584
],
"flags": {},
"order": 24,
"mode": 0,
"inputs": [
{
"name": "video",
"type": "VIDEO",
"link": 188
}
],
"outputs": [
{
"name": "video",
"type": "VIDEO",
"links": null
}
],
"properties": {},
"widgets_values": [
"video/ComfyUI",
"auto",
"auto",
"auto"
],
"widgets_values_named": {
"filename_prefix": "video/ComfyUI",
"format": "auto",
"format.codec": "auto",
"codec": "auto"
}
}
],
"links": [
[
35,
3,
0,
8,
0,
"LATENT"
],
[
130,
75,
0,
3,
2,
"CONDITIONING"
],
[
132,
3,
0,
77,
0,
"LATENT"
],
[
139,
39,
0,
79,
0,
"VAE"
],
[
140,
79,
0,
8,
1,
"VAE"
],
[
149,
81,
0,
82,
0,
"VAE"
],
[
150,
82,
0,
77,
1,
"VAE"
],
[
159,
8,
0,
91,
0,
"IMAGE"
],
[
160,
77,
0,
91,
1,
"AUDIO"
],
[
163,
37,
0,
86,
0,
"MODEL"
],
[
164,
86,
0,
3,
0,
"MODEL"
],
[
166,
94,
0,
87,
0,
"FLOAT"
],
[
167,
96,
0,
97,
0,
"IMAGE"
],
[
168,
97,
0,
98,
0,
"IMAGE"
],
[
169,
98,
0,
99,
0,
"IMAGE"
],
[
170,
98,
0,
100,
0,
"IMAGE"
],
[
171,
99,
0,
101,
2,
"IMAGE"
],
[
172,
100,
0,
101,
4,
"INT"
],
[
173,
100,
1,
101,
5,
"INT"
],
[
174,
38,
0,
101,
0,
"CLIP"
],
[
175,
39,
0,
101,
1,
"VAE"
],
[
176,
101,
0,
3,
1,
"CONDITIONING"
],
[
177,
101,
1,
3,
3,
"LATENT"
],
[
178,
87,
1,
101,
6,
"INT"
],
[
179,
101,
0,
75,
0,
"CONDITIONING"
],
[
184,
98,
0,
105,
1,
"IMAGE"
],
[
185,
104,
0,
105,
0,
"IMAGE"
],
[
186,
106,
0,
101,
3,
"IMAGE"
],
[
187,
105,
0,
106,
0,
"IMAGE"
],
[
188,
91,
0,
107,
0,
"VIDEO"
]
],
"groups": [],
"config": {},
"extra": {
"ds": {
"scale": 0.43056764313424634,
"offset": [
1350.2177879468782,
606.0070626236592
]
},
"frontendVersion": "1.51.9",
"VHS_latentpreview": false,
"VHS_latentpreviewrate": 0,
"VHS_MetadataImage": true,
"VHS_KeepIntermediate": true
},
"version": 0.4
}
基本上与 I2VA 完全相同,只需在 last_frame 中也输入一张图像。
输出示例
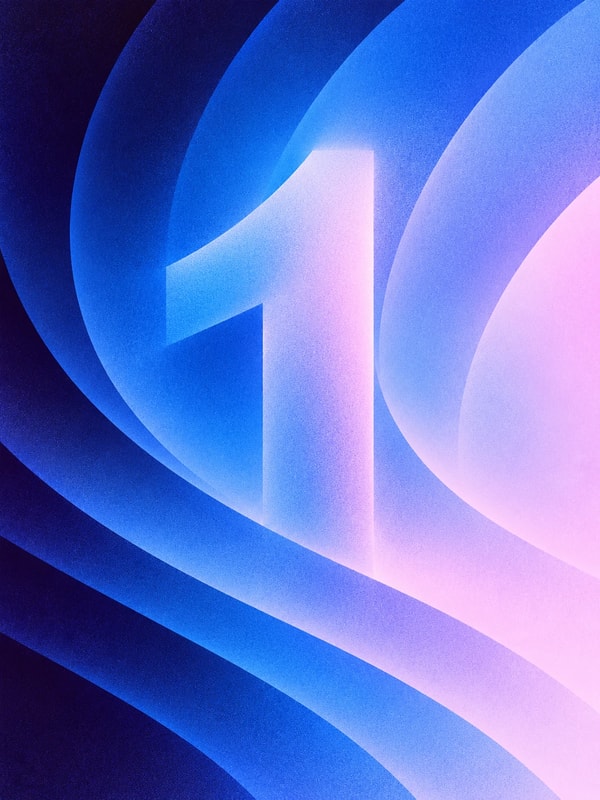
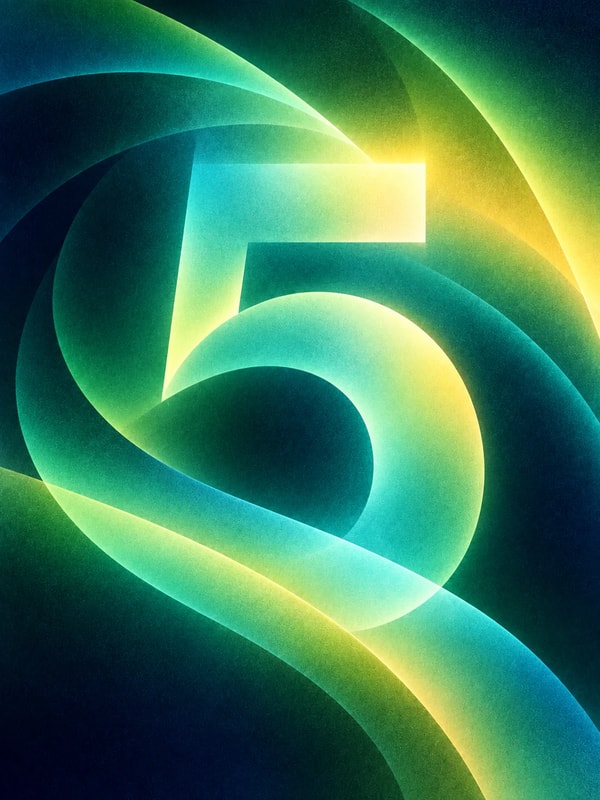
Generative Interpolation
使用模型:fl2va
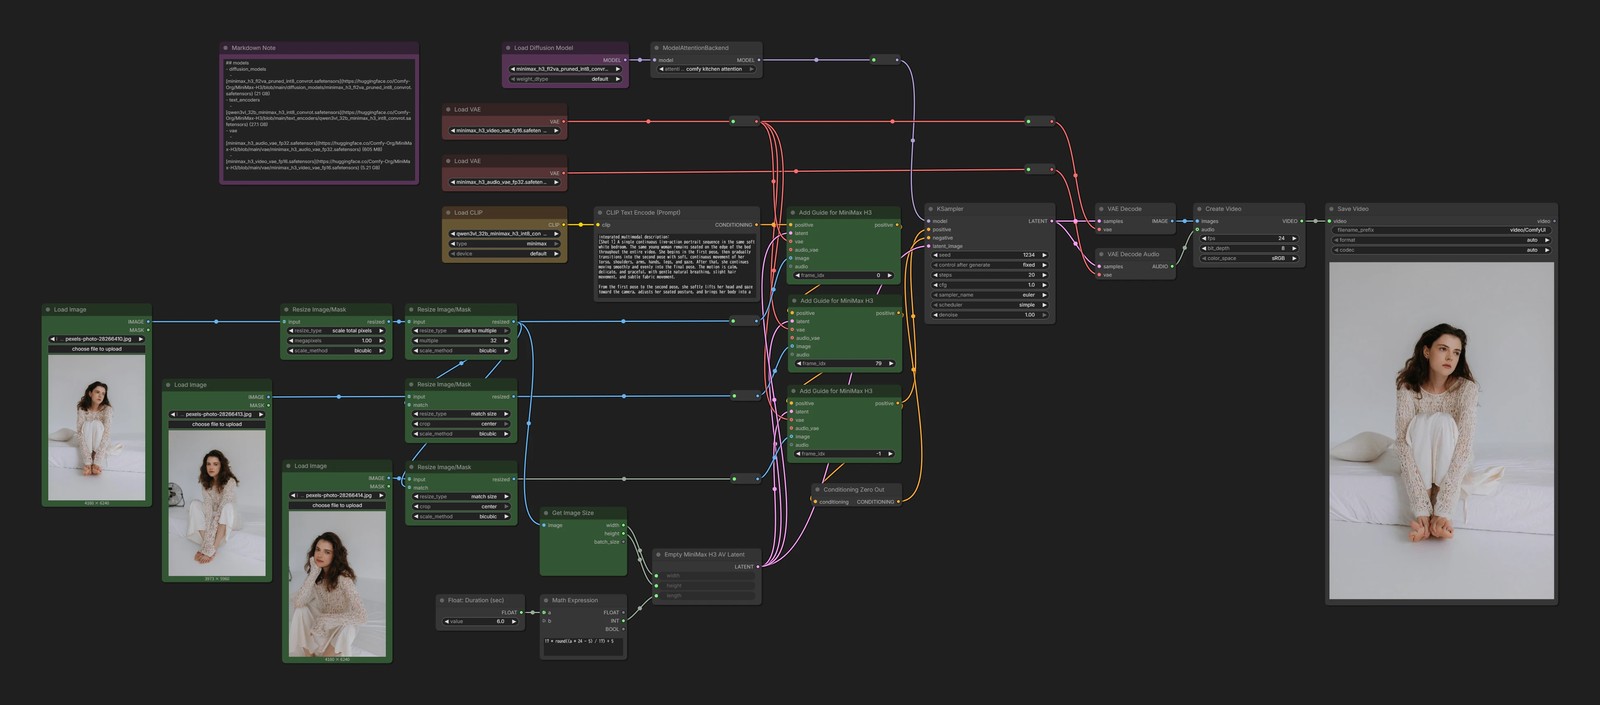
{
"id": "ad9e3afe-c265-4645-9d89-ddc501d6508e",
"revision": 0,
"last_node_id": 123,
"last_link_id": 230,
"nodes": [
{
"id": 77,
"type": "VAEDecodeAudio",
"pos": [
1621.6991877195373,
288.24730987442047
],
"size": [
194.25299723441972,
46
],
"flags": {},
"order": 31,
"mode": 0,
"inputs": [
{
"name": "samples",
"type": "LATENT",
"link": 132
},
{
"name": "vae",
"type": "VAE",
"link": 150
}
],
"outputs": [
{
"name": "AUDIO",
"type": "AUDIO",
"links": [
160
]
}
],
"properties": {
"Node name for S&R": "VAEDecodeAudio",
"cnr_id": "comfy-core",
"ver": "0.30.0"
}
},
{
"id": 8,
"type": "VAEDecode",
"pos": [
1621.6991877195373,
179.46291912812848
],
"size": [
194.25299723441972,
46
],
"flags": {},
"order": 30,
"mode": 0,
"inputs": [
{
"name": "samples",
"type": "LATENT",
"link": 35
},
{
"name": "vae",
"type": "VAE",
"link": 140
}
],
"outputs": [
{
"name": "IMAGE",
"type": "IMAGE",
"slot_index": 0,
"links": [
159
]
}
],
"properties": {
"Node name for S&R": "VAEDecode",
"cnr_id": "comfy-core",
"ver": "0.3.33"
}
},
{
"id": 82,
"type": "Reroute",
"pos": [
1451.755991191785,
55.417454842751695
],
"size": [
75,
26
],
"flags": {},
"order": 10,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 149
}
],
"outputs": [
{
"name": "",
"type": "VAE",
"links": [
150
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 37,
"type": "UNETLoader",
"pos": [
196.5961798213713,
-207.9445746188256
],
"size": [
305.3782043457031,
82
],
"flags": {},
"order": 0,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "MODEL",
"type": "MODEL",
"slot_index": 0,
"links": [
163
]
}
],
"properties": {
"Node name for S&R": "UNETLoader",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
"minimax_h3_fl2va_pruned_int8_convrot.safetensors",
"default"
],
"widgets_values_named": {
"unet_name": "minimax_h3_fl2va_pruned_int8_convrot.safetensors",
"weight_dtype": "default"
},
"color": "#323",
"bgcolor": "#535"
},
{
"id": 81,
"type": "VAELoader",
"pos": [
52.62317611836556,
64.14635395192796
],
"size": [
301.3524169921875,
58
],
"flags": {},
"order": 1,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "VAE",
"type": "VAE",
"slot_index": 0,
"links": [
149
]
}
],
"properties": {
"Node name for S&R": "VAELoader",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
"minimax_h3_audio_vae_fp32.safetensors"
],
"widgets_values_named": {
"vae_name": "minimax_h3_audio_vae_fp32.safetensors"
},
"color": "#322",
"bgcolor": "#533"
},
{
"id": 94,
"type": "PrimitiveFloat",
"pos": [
37.59351579454515,
1120.507610025386
],
"size": [
214.65850806503283,
58
],
"flags": {},
"order": 2,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "FLOAT",
"type": "FLOAT",
"links": [
166
]
}
],
"title": "Float: Duration (sec)",
"properties": {
"Node name for S&R": "PrimitiveFloat"
},
"widgets_values": [
6
],
"widgets_values_named": {
"value": 6
}
},
{
"id": 95,
"type": "MarkdownNote",
"pos": [
-482.3943342566212,
-207.9445746188256
],
"size": [
480.26512898835654,
314.3204118484383
],
"flags": {},
"order": 3,
"mode": 0,
"inputs": [],
"outputs": [],
"properties": {},
"widgets_values": [
"## models\n- diffusion_models\n - [minimax_h3_fl2va_pruned_int8_convrot.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/diffusion_models/minimax_h3_fl2va_pruned_int8_convrot.safetensors) (21 GB)\n- text_encoders\n - [qwen3vl_32b_minimax_h3_int8_convrot.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/text_encoders/qwen3vl_32b_minimax_h3_int8_convrot.safetensors) (27.1 GB)\n- vae\n - [minimax_h3_audio_vae_fp32.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/vae/minimax_h3_audio_vae_fp32.safetensors) (605 MB)\n - [minimax_h3_video_vae_fp16.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/vae/minimax_h3_video_vae_fp16.safetensors) (5.21 GB)\n\n```text\n📂ComfyUI/\n└── 📂models/\n ├── 📂diffusion_models/\n │ └── minimax_h3_fl2va_pruned_int8_convrot.safetensors\n ├── 📂text_encoders/\n │ └── qwen3vl_32b_minimax_h3_int8_convrot.safetensors\n └── 📂vae/\n ├── minimax_h3_audio_vae_fp32.safetensors\n └── minimax_h3_video_vae_fp16.safetensors\n```"
],
"widgets_values_named": {
"text": "## models\n- diffusion_models\n - [minimax_h3_fl2va_pruned_int8_convrot.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/diffusion_models/minimax_h3_fl2va_pruned_int8_convrot.safetensors) (21 GB)\n- text_encoders\n - [qwen3vl_32b_minimax_h3_int8_convrot.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/text_encoders/qwen3vl_32b_minimax_h3_int8_convrot.safetensors) (27.1 GB)\n- vae\n - [minimax_h3_audio_vae_fp32.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/vae/minimax_h3_audio_vae_fp32.safetensors) (605 MB)\n - [minimax_h3_video_vae_fp16.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/vae/minimax_h3_video_vae_fp16.safetensors) (5.21 GB)\n\n```text\n📂ComfyUI/\n└── 📂models/\n ├── 📂diffusion_models/\n │ └── minimax_h3_fl2va_pruned_int8_convrot.safetensors\n ├── 📂text_encoders/\n │ └── qwen3vl_32b_minimax_h3_int8_convrot.safetensors\n └── 📂vae/\n ├── minimax_h3_audio_vae_fp32.safetensors\n └── minimax_h3_video_vae_fp16.safetensors\n```"
},
"color": "#323",
"bgcolor": "#535"
},
{
"id": 91,
"type": "CreateVideo",
"pos": [
1857.2649223855678,
179.46291912812848
],
"size": [
270,
126
],
"flags": {},
"order": 32,
"mode": 0,
"inputs": [
{
"name": "images",
"type": "IMAGE",
"link": 159
},
{
"name": "audio",
"shape": 7,
"type": "AUDIO",
"link": 160
}
],
"outputs": [
{
"name": "VIDEO",
"type": "VIDEO",
"links": [
188
]
}
],
"properties": {
"Node name for S&R": "CreateVideo",
"cnr_id": "comfy-core",
"ver": "0.33.0"
},
"widgets_values": [
24,
8,
"sRGB"
],
"widgets_values_named": {
"fps": 24,
"bit_depth": 8,
"color_space": "sRGB"
}
},
{
"id": 87,
"type": "ComfyMathExpression",
"pos": [
287.5935157945451,
1120.507610025386
],
"size": [
210,
128
],
"flags": {},
"order": 11,
"mode": 0,
"inputs": [
{
"label": "a",
"name": "values.a",
"type": "FLOAT,INT,BOOLEAN",
"link": 166
},
{
"name": "values.b",
"shape": 7,
"type": "FLOAT,INT,BOOLEAN",
"link": null
}
],
"outputs": [
{
"name": "FLOAT",
"type": "FLOAT",
"links": null
},
{
"name": "INT",
"type": "INT",
"links": [
207
]
},
{
"name": "BOOL",
"type": "BOOLEAN",
"links": null
}
],
"properties": {
"Node name for S&R": "ComfyMathExpression",
"cnr_id": "comfy-core",
"ver": "0.33.0"
},
"widgets_values": [
"17 * round((a * 24 - 5) / 17) + 5"
],
"widgets_values_named": {
"expression": "17 * round((a * 24 - 5) / 17) + 5"
}
},
{
"id": 38,
"type": "CLIPLoader",
"pos": [
52.62317611836556,
188.16650543074402
],
"size": [
301.3524169921875,
106
],
"flags": {},
"order": 4,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "CLIP",
"type": "CLIP",
"slot_index": 0,
"links": [
208
]
}
],
"properties": {
"Node name for S&R": "CLIPLoader",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
"qwen3vl_32b_minimax_h3_int8_convrot.safetensors",
"minimax",
"default"
],
"widgets_values_named": {
"clip_name": "qwen3vl_32b_minimax_h3_int8_convrot.safetensors",
"type": "minimax",
"device": "default"
},
"color": "#432",
"bgcolor": "#653"
},
{
"id": 99,
"type": "Reroute",
"pos": [
742.2112975166501,
419.90526705842126
],
"size": [
75,
26
],
"flags": {},
"order": 18,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 169
}
],
"outputs": [
{
"name": "",
"type": "IMAGE",
"links": [
189
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 106,
"type": "Reroute",
"pos": [
745.0499786858808,
599.9052670584215
],
"size": [
75,
26
],
"flags": {},
"order": 23,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 187
}
],
"outputs": [
{
"name": "",
"type": "IMAGE",
"links": [
214
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 97,
"type": "ResizeImageMaskNode",
"pos": [
-336.26559350887214,
421.2162624767185
],
"size": [
270,
106
],
"flags": {},
"order": 13,
"mode": 0,
"inputs": [
{
"name": "input",
"type": "IMAGE,MASK",
"link": 167
}
],
"outputs": [
{
"name": "resized",
"type": "IMAGE",
"links": [
168
]
}
],
"properties": {
"Node name for S&R": "ResizeImageMaskNode"
},
"widgets_values": [
"scale total pixels",
1,
"bicubic"
],
"widgets_values_named": {
"resize_type": "scale total pixels",
"resize_type.megapixels": 1,
"scale_method": "bicubic"
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 114,
"type": "Reroute",
"pos": [
745.0499786858808,
799.580049440479
],
"size": [
75,
26
],
"flags": {},
"order": 24,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 212
}
],
"outputs": [
{
"name": "",
"type": "IMAGE",
"links": [
213
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 100,
"type": "GetImageSize",
"pos": [
287.5935157945451,
910.5076100253906
],
"size": [
210,
136
],
"flags": {},
"order": 19,
"mode": 0,
"inputs": [
{
"name": "image",
"type": "IMAGE",
"link": 170
}
],
"outputs": [
{
"name": "width",
"type": "INT",
"links": [
196
]
},
{
"name": "height",
"type": "INT",
"links": [
197
]
},
{
"name": "batch_size",
"type": "INT",
"links": null
}
],
"properties": {
"Node name for S&R": "GetImageSize"
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 115,
"type": "LoadImage",
"pos": [
-331.43223000108765,
797.1508840998033
],
"size": [
265.1666364922155,
459.3276707035791
],
"flags": {},
"order": 5,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "IMAGE",
"type": "IMAGE",
"links": [
215
]
},
{
"name": "MASK",
"type": "MASK",
"links": null
}
],
"properties": {
"Node name for S&R": "LoadImage"
},
"widgets_values": [
"pexels-photo-28266414.jpg",
"image"
],
"widgets_values_named": {
"image": "pexels-photo-28266414.jpg",
"upload": "image"
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 104,
"type": "LoadImage",
"pos": [
-620.3297904318413,
602.527301904396
],
"size": [
265.1666364922155,
459.3276707035791
],
"flags": {},
"order": 6,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "IMAGE",
"type": "IMAGE",
"links": [
185
]
},
{
"name": "MASK",
"type": "MASK",
"links": null
}
],
"properties": {
"Node name for S&R": "LoadImage"
},
"widgets_values": [
"pexels-photo-28266413.jpg",
"image"
],
"widgets_values_named": {
"image": "pexels-photo-28266413.jpg",
"upload": "image"
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 96,
"type": "LoadImage",
"pos": [
-909.2273508625949,
421.2162624767185
],
"size": [
265.1666364922155,
459.3276707035791
],
"flags": {},
"order": 7,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "IMAGE",
"type": "IMAGE",
"links": [
167
]
},
{
"name": "MASK",
"type": "MASK",
"links": null
}
],
"properties": {
"Node name for S&R": "LoadImage"
},
"widgets_values": [
"pexels-photo-28266410.jpg",
"image"
],
"widgets_values_named": {
"image": "pexels-photo-28266410.jpg",
"upload": "image"
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 112,
"type": "MiniMaxH3AddGuide",
"pos": [
884.0051900462948,
399.89953187596336
],
"size": [
274.640234375,
158
],
"flags": {},
"order": 26,
"mode": 0,
"inputs": [
{
"name": "positive",
"type": "CONDITIONING",
"link": 204
},
{
"name": "latent",
"type": "LATENT",
"link": 201
},
{
"name": "vae",
"shape": 7,
"type": "VAE",
"link": 221
},
{
"name": "audio_vae",
"shape": 7,
"type": "VAE",
"link": null
},
{
"name": "image",
"shape": 7,
"type": "IMAGE",
"link": 214
},
{
"name": "audio",
"shape": 7,
"type": "AUDIO",
"link": null
}
],
"outputs": [
{
"name": "positive",
"type": "CONDITIONING",
"links": [
205
]
}
],
"properties": {
"Node name for S&R": "MiniMaxH3AddGuide"
},
"widgets_values": [
79
],
"widgets_values_named": {
"frame_idx": 79
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 109,
"type": "MiniMaxH3AddGuide",
"pos": [
882.0593802351941,
617.0337699585782
],
"size": [
274.640234375,
158
],
"flags": {},
"order": 27,
"mode": 0,
"inputs": [
{
"name": "positive",
"type": "CONDITIONING",
"link": 205
},
{
"name": "latent",
"type": "LATENT",
"link": 199
},
{
"name": "vae",
"shape": 7,
"type": "VAE",
"link": 222
},
{
"name": "audio_vae",
"shape": 7,
"type": "VAE",
"link": null
},
{
"name": "image",
"shape": 7,
"type": "IMAGE",
"link": 213
},
{
"name": "audio",
"shape": 7,
"type": "AUDIO",
"link": null
}
],
"outputs": [
{
"name": "positive",
"type": "CONDITIONING",
"links": [
206,
216
]
}
],
"properties": {
"Node name for S&R": "MiniMaxH3AddGuide"
},
"widgets_values": [
-1
],
"widgets_values_named": {
"frame_idx": -1
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 111,
"type": "EmptyMiniMaxH3LatentAV",
"pos": [
557.5935157945461,
1010.5076100253906
],
"size": [
263.13052726852493,
106
],
"flags": {},
"order": 22,
"mode": 0,
"inputs": [
{
"name": "width",
"type": "INT",
"widget": {
"name": "width"
},
"link": 196
},
{
"name": "height",
"type": "INT",
"widget": {
"name": "height"
},
"link": 197
},
{
"name": "length",
"type": "INT",
"widget": {
"name": "length"
},
"link": 207
}
],
"outputs": [
{
"name": "LATENT",
"type": "LATENT",
"links": [
198,
199,
201,
217
]
}
],
"properties": {
"Node name for S&R": "EmptyMiniMaxH3LatentAV",
"cnr_id": "comfy-core",
"ver": "0.30.0"
},
"widgets_values": [
1344,
768,
124
],
"widgets_values_named": {
"width": 1344,
"height": 768,
"length": 124
}
},
{
"id": 39,
"type": "VAELoader",
"pos": [
52.62317611836556,
-59.89911033344882
],
"size": [
301.3524169921875,
58
],
"flags": {},
"order": 8,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "VAE",
"type": "VAE",
"slot_index": 0,
"links": [
218
]
}
],
"properties": {
"Node name for S&R": "VAELoader",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
"minimax_h3_video_vae_fp16.safetensors"
],
"widgets_values_named": {
"vae_name": "minimax_h3_video_vae_fp16.safetensors"
},
"color": "#322",
"bgcolor": "#533"
},
{
"id": 116,
"type": "Reroute",
"pos": [
742.2112975166501,
-59.89911033344882
],
"size": [
75,
26
],
"flags": {},
"order": 14,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 218
}
],
"outputs": [
{
"name": "",
"type": "VAE",
"links": [
219,
220,
221,
222
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 75,
"type": "ConditioningZeroOut",
"pos": [
939.7164656265965,
853.7838346470958
],
"size": [
218.4346850585937,
26
],
"flags": {},
"order": 28,
"mode": 0,
"inputs": [
{
"name": "conditioning",
"type": "CONDITIONING",
"link": 206
}
],
"outputs": [
{
"name": "CONDITIONING",
"type": "CONDITIONING",
"links": [
130
]
}
],
"properties": {
"Node name for S&R": "ConditioningZeroOut",
"cnr_id": "comfy-core",
"ver": "0.30.0"
}
},
{
"id": 110,
"type": "CLIPTextEncode",
"pos": [
417.2112975166501,
188.16650543074402
],
"size": [
400,
200
],
"flags": {},
"order": 12,
"mode": 0,
"inputs": [
{
"name": "clip",
"type": "CLIP",
"link": 208
}
],
"outputs": [
{
"name": "CONDITIONING",
"type": "CONDITIONING",
"links": [
209
]
}
],
"properties": {
"Node name for S&R": "CLIPTextEncode"
},
"widgets_values": [
"integrated_multimodal_description:\n[Shot 1] A single continuous live-action portrait sequence in the same soft white bedroom. The same young woman remains seated on the edge of the bed throughout the entire video. She begins in the first pose, then gradually transitions into the second pose with soft, continuous movement of her torso, shoulders, arms, hands, legs, and gaze. After that, she continues moving smoothly and evenly into the final pose. The motion is calm, delicate, and graceful, with gentle natural breathing, slight hair movement, and subtle fabric movement.\n\nFrom the first pose to the second pose, she softly lifts her head and gaze toward the camera, adjusts her seated posture, and brings her body into a more open and attentive position while keeping a relaxed mood.\n\nFrom the second pose to the final pose, she leans forward gradually, brings one hand upward to rest against the side of her face, and settles into the final close, intimate portrait pose. The transition into the final pose is especially smooth and gradual, with soft even pacing and a gentle ease into the final position. The camera also slowly pushes in during the latter half, naturally changing the framing from the wider seated view into the closer final composition.\n\noverall_soundscape:\nN/A\n\nnon_diegetic_music:\nN/A"
],
"widgets_values_named": {
"text": "integrated_multimodal_description:\n[Shot 1] A single continuous live-action portrait sequence in the same soft white bedroom. The same young woman remains seated on the edge of the bed throughout the entire video. She begins in the first pose, then gradually transitions into the second pose with soft, continuous movement of her torso, shoulders, arms, hands, legs, and gaze. After that, she continues moving smoothly and evenly into the final pose. The motion is calm, delicate, and graceful, with gentle natural breathing, slight hair movement, and subtle fabric movement.\n\nFrom the first pose to the second pose, she softly lifts her head and gaze toward the camera, adjusts her seated posture, and brings her body into a more open and attentive position while keeping a relaxed mood.\n\nFrom the second pose to the final pose, she leans forward gradually, brings one hand upward to rest against the side of her face, and settles into the final close, intimate portrait pose. The transition into the final pose is especially smooth and gradual, with soft even pacing and a gentle ease into the final position. The camera also slowly pushes in during the latter half, naturally changing the framing from the wider seated view into the closer final composition.\n\noverall_soundscape:\nN/A\n\nnon_diegetic_music:\nN/A"
}
},
{
"id": 107,
"type": "SaveVideo",
"pos": [
2174.4821131448493,
179.46291912812848
],
"size": [
560.0743335803577,
938.1115003705365
],
"flags": {},
"order": 33,
"mode": 0,
"inputs": [
{
"name": "video",
"type": "VIDEO",
"link": 188
}
],
"outputs": [
{
"name": "video",
"type": "VIDEO",
"links": null
}
],
"properties": {},
"widgets_values": [
"video/ComfyUI",
"auto",
"auto",
"auto"
],
"widgets_values_named": {
"filename_prefix": "video/ComfyUI",
"format": "auto",
"format.codec": "auto",
"codec": "auto"
}
},
{
"id": 98,
"type": "ResizeImageMaskNode",
"pos": [
-36.26559350887219,
421.2162624767185
],
"size": [
270,
106
],
"flags": {},
"order": 16,
"mode": 0,
"inputs": [
{
"name": "input",
"type": "IMAGE,MASK",
"link": 168
}
],
"outputs": [
{
"name": "resized",
"type": "IMAGE",
"links": [
169,
170,
184,
211
]
}
],
"properties": {
"Node name for S&R": "ResizeImageMaskNode"
},
"widgets_values": [
"scale to multiple",
32,
"bicubic"
],
"widgets_values_named": {
"resize_type": "scale to multiple",
"resize_type.multiple": 32,
"scale_method": "bicubic"
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 105,
"type": "ResizeImageMaskNode",
"pos": [
-36.26559350887219,
601.2162624767188
],
"size": [
270,
126
],
"flags": {},
"order": 20,
"mode": 0,
"inputs": [
{
"name": "input",
"type": "IMAGE,MASK",
"link": 185
},
{
"name": "resize_type.match",
"type": "IMAGE,MASK",
"link": 184
}
],
"outputs": [
{
"name": "resized",
"type": "IMAGE",
"links": [
187
]
}
],
"properties": {
"Node name for S&R": "ResizeImageMaskNode"
},
"widgets_values": [
"match size",
"center",
"bicubic"
],
"widgets_values_named": {
"resize_type": "match size",
"resize_type.crop": "center",
"scale_method": "bicubic"
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 113,
"type": "ResizeImageMaskNode",
"pos": [
-35.67173735568689,
799.580049440479
],
"size": [
270,
126
],
"flags": {},
"order": 21,
"mode": 0,
"inputs": [
{
"name": "input",
"type": "IMAGE,MASK",
"link": 215
},
{
"name": "resize_type.match",
"type": "IMAGE,MASK",
"link": 211
}
],
"outputs": [
{
"name": "resized",
"type": "IMAGE",
"links": [
212
]
}
],
"properties": {
"Node name for S&R": "ResizeImageMaskNode"
},
"widgets_values": [
"match size",
"center",
"bicubic"
],
"widgets_values_named": {
"resize_type": "match size",
"resize_type.crop": "center",
"scale_method": "bicubic"
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 3,
"type": "KSampler",
"pos": [
1211.755991191783,
179.46291912812848
],
"size": [
315,
262
],
"flags": {},
"order": 29,
"mode": 0,
"inputs": [
{
"name": "model",
"type": "MODEL",
"link": 230
},
{
"name": "positive",
"type": "CONDITIONING",
"link": 216
},
{
"name": "negative",
"type": "CONDITIONING",
"link": 130
},
{
"name": "latent_image",
"type": "LATENT",
"link": 217
}
],
"outputs": [
{
"name": "LATENT",
"type": "LATENT",
"slot_index": 0,
"links": [
35,
132
]
}
],
"properties": {
"Node name for S&R": "KSampler",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
1234,
"fixed",
20,
1,
"euler",
"simple",
1
],
"widgets_values_named": {
"seed": 1234,
"control_after_generate": "fixed",
"steps": 20,
"cfg": 1,
"sampler_name": "euler",
"scheduler": "simple",
"denoise": 1
}
},
{
"id": 79,
"type": "Reroute",
"pos": [
1451.755991191785,
-59.89911033344882
],
"size": [
75,
26
],
"flags": {},
"order": 17,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 219
}
],
"outputs": [
{
"name": "",
"type": "VAE",
"links": [
140
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 86,
"type": "ModelAttentionBackend",
"pos": [
553.2461981384733,
-207.9445746188256
],
"size": [
270,
58
],
"flags": {},
"order": 9,
"mode": 0,
"inputs": [
{
"name": "model",
"type": "MODEL",
"link": 163
}
],
"outputs": [
{
"name": "MODEL",
"type": "MODEL",
"links": [
229
]
}
],
"properties": {
"Node name for S&R": "ModelAttentionBackend"
},
"widgets_values": [
"comfy kitchen attention"
],
"widgets_values_named": {
"attention": "comfy kitchen attention"
}
},
{
"id": 108,
"type": "MiniMaxH3AddGuide",
"pos": [
880.4470019227473,
188.16650543074402
],
"size": [
274.640234375,
158
],
"flags": {},
"order": 25,
"mode": 0,
"inputs": [
{
"name": "positive",
"type": "CONDITIONING",
"link": 209
},
{
"name": "latent",
"type": "LATENT",
"link": 198
},
{
"name": "vae",
"shape": 7,
"type": "VAE",
"link": 220
},
{
"name": "audio_vae",
"shape": 7,
"type": "VAE",
"link": null
},
{
"name": "image",
"shape": 7,
"type": "IMAGE",
"link": 189
},
{
"name": "audio",
"shape": 7,
"type": "AUDIO",
"link": null
}
],
"outputs": [
{
"name": "positive",
"type": "CONDITIONING",
"links": [
204
]
}
],
"properties": {
"Node name for S&R": "MiniMaxH3AddGuide"
},
"widgets_values": [
0
],
"widgets_values_named": {
"frame_idx": 0
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 123,
"type": "Reroute",
"pos": [
1080.0872362977473,
-207.9445746188256
],
"size": [
75,
26
],
"flags": {},
"order": 15,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 229
}
],
"outputs": [
{
"name": "",
"type": "MODEL",
"links": [
230
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
}
],
"links": [
[
35,
3,
0,
8,
0,
"LATENT"
],
[
130,
75,
0,
3,
2,
"CONDITIONING"
],
[
132,
3,
0,
77,
0,
"LATENT"
],
[
140,
79,
0,
8,
1,
"VAE"
],
[
149,
81,
0,
82,
0,
"VAE"
],
[
150,
82,
0,
77,
1,
"VAE"
],
[
159,
8,
0,
91,
0,
"IMAGE"
],
[
160,
77,
0,
91,
1,
"AUDIO"
],
[
163,
37,
0,
86,
0,
"MODEL"
],
[
166,
94,
0,
87,
0,
"FLOAT"
],
[
167,
96,
0,
97,
0,
"IMAGE"
],
[
168,
97,
0,
98,
0,
"IMAGE"
],
[
169,
98,
0,
99,
0,
"IMAGE"
],
[
170,
98,
0,
100,
0,
"IMAGE"
],
[
184,
98,
0,
105,
1,
"IMAGE"
],
[
185,
104,
0,
105,
0,
"IMAGE"
],
[
187,
105,
0,
106,
0,
"IMAGE"
],
[
188,
91,
0,
107,
0,
"VIDEO"
],
[
189,
99,
0,
108,
4,
"IMAGE"
],
[
196,
100,
0,
111,
0,
"INT"
],
[
197,
100,
1,
111,
1,
"INT"
],
[
198,
111,
0,
108,
1,
"LATENT"
],
[
199,
111,
0,
109,
1,
"LATENT"
],
[
201,
111,
0,
112,
1,
"LATENT"
],
[
204,
108,
0,
112,
0,
"CONDITIONING"
],
[
205,
112,
0,
109,
0,
"CONDITIONING"
],
[
206,
109,
0,
75,
0,
"CONDITIONING"
],
[
207,
87,
1,
111,
2,
"INT"
],
[
208,
38,
0,
110,
0,
"CLIP"
],
[
209,
110,
0,
108,
0,
"CONDITIONING"
],
[
211,
98,
0,
113,
1,
"IMAGE"
],
[
212,
113,
0,
114,
0,
"*"
],
[
213,
114,
0,
109,
4,
"IMAGE"
],
[
214,
106,
0,
112,
4,
"IMAGE"
],
[
215,
115,
0,
113,
0,
"IMAGE"
],
[
216,
109,
0,
3,
1,
"CONDITIONING"
],
[
217,
111,
0,
3,
3,
"LATENT"
],
[
218,
39,
0,
116,
0,
"VAE"
],
[
219,
116,
0,
79,
0,
"VAE"
],
[
220,
116,
0,
108,
2,
"VAE"
],
[
221,
116,
0,
112,
2,
"VAE"
],
[
222,
116,
0,
109,
2,
"VAE"
],
[
229,
86,
0,
123,
0,
"MODEL"
],
[
230,
123,
0,
3,
0,
"MODEL"
]
],
"groups": [],
"config": {},
"extra": {
"ds": {
"scale": 0.47362440744767415,
"offset": [
845.0906070509052,
762.161059708166
]
},
"frontendVersion": "1.51.9",
"VHS_latentpreview": false,
"VHS_latentpreviewrate": 0,
"VHS_MetadataImage": true,
"VHS_KeepIntermediate": true
},
"version": 0.4
}
在指定的帧中插入图像,让模型补全它们之间的内容。
使用 Add Guide for MiniMax H3 节点。
输出示例
Audio-driven Video Generation
使用模型:fl2va
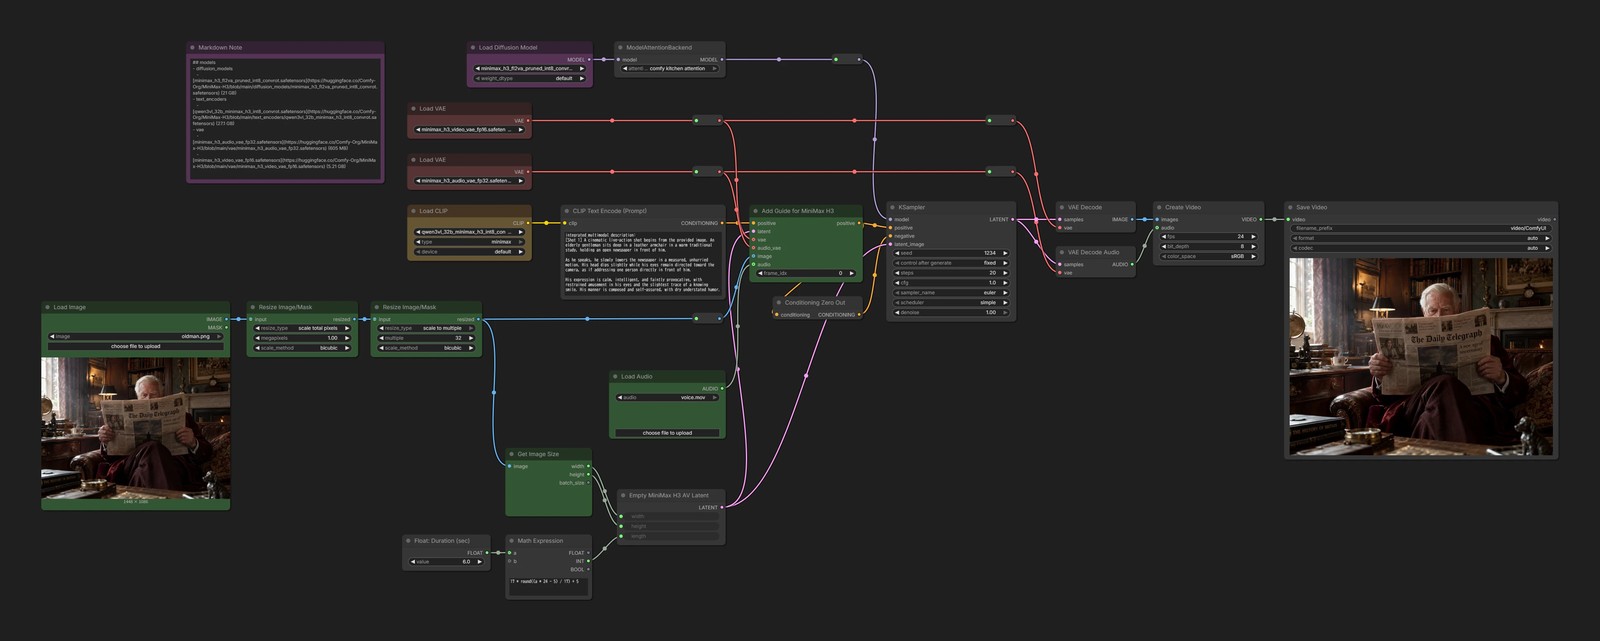
{
"id": "0ddd6ae2-9ecf-4f2d-a828-f66ecd6b7f0f",
"revision": 0,
"last_node_id": 125,
"last_link_id": 236,
"nodes": [
{
"id": 77,
"type": "VAEDecodeAudio",
"pos": [
1621.6991877195373,
288.24730987442047
],
"size": [
194.25299723441972,
46
],
"flags": {},
"order": 25,
"mode": 0,
"inputs": [
{
"name": "samples",
"type": "LATENT",
"link": 132
},
{
"name": "vae",
"type": "VAE",
"link": 150
}
],
"outputs": [
{
"name": "AUDIO",
"type": "AUDIO",
"links": [
160
]
}
],
"properties": {
"Node name for S&R": "VAEDecodeAudio",
"cnr_id": "comfy-core",
"ver": "0.30.0"
}
},
{
"id": 8,
"type": "VAEDecode",
"pos": [
1621.6991877195373,
179.46291912812848
],
"size": [
194.25299723441972,
46
],
"flags": {},
"order": 24,
"mode": 0,
"inputs": [
{
"name": "samples",
"type": "LATENT",
"link": 35
},
{
"name": "vae",
"type": "VAE",
"link": 140
}
],
"outputs": [
{
"name": "IMAGE",
"type": "IMAGE",
"slot_index": 0,
"links": [
159
]
}
],
"properties": {
"Node name for S&R": "VAEDecode",
"cnr_id": "comfy-core",
"ver": "0.3.33"
}
},
{
"id": 37,
"type": "UNETLoader",
"pos": [
196.5961798213713,
-207.9445746188256
],
"size": [
305.3782043457031,
82
],
"flags": {},
"order": 0,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "MODEL",
"type": "MODEL",
"slot_index": 0,
"links": [
163
]
}
],
"properties": {
"Node name for S&R": "UNETLoader",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
"minimax_h3_fl2va_pruned_int8_convrot.safetensors",
"default"
],
"widgets_values_named": {
"unet_name": "minimax_h3_fl2va_pruned_int8_convrot.safetensors",
"weight_dtype": "default"
},
"color": "#323",
"bgcolor": "#535"
},
{
"id": 94,
"type": "PrimitiveFloat",
"pos": [
39.9770638107585,
987.0240400771188
],
"size": [
214.65850806503283,
58
],
"flags": {},
"order": 1,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "FLOAT",
"type": "FLOAT",
"links": [
166
]
}
],
"title": "Float: Duration (sec)",
"properties": {
"Node name for S&R": "PrimitiveFloat"
},
"widgets_values": [
6
],
"widgets_values_named": {
"value": 6
}
},
{
"id": 86,
"type": "ModelAttentionBackend",
"pos": [
553.2461981384733,
-207.9445746188256
],
"size": [
270,
58
],
"flags": {},
"order": 8,
"mode": 0,
"inputs": [
{
"name": "model",
"type": "MODEL",
"link": 163
}
],
"outputs": [
{
"name": "MODEL",
"type": "MODEL",
"links": [
235
]
}
],
"properties": {
"Node name for S&R": "ModelAttentionBackend"
},
"widgets_values": [
"comfy kitchen attention"
],
"widgets_values_named": {
"attention": "comfy kitchen attention"
}
},
{
"id": 95,
"type": "MarkdownNote",
"pos": [
-482.3943342566212,
-207.9445746188256
],
"size": [
480.26512898835654,
314.3204118484383
],
"flags": {},
"order": 2,
"mode": 0,
"inputs": [],
"outputs": [],
"properties": {},
"widgets_values": [
"## models\n- diffusion_models\n - [minimax_h3_fl2va_pruned_int8_convrot.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/diffusion_models/minimax_h3_fl2va_pruned_int8_convrot.safetensors) (21 GB)\n- text_encoders\n - [qwen3vl_32b_minimax_h3_int8_convrot.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/text_encoders/qwen3vl_32b_minimax_h3_int8_convrot.safetensors) (27.1 GB)\n- vae\n - [minimax_h3_audio_vae_fp32.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/vae/minimax_h3_audio_vae_fp32.safetensors) (605 MB)\n - [minimax_h3_video_vae_fp16.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/vae/minimax_h3_video_vae_fp16.safetensors) (5.21 GB)\n\n```text\n📂ComfyUI/\n└── 📂models/\n ├── 📂diffusion_models/\n │ └── minimax_h3_fl2va_pruned_int8_convrot.safetensors\n ├── 📂text_encoders/\n │ └── qwen3vl_32b_minimax_h3_int8_convrot.safetensors\n └── 📂vae/\n ├── minimax_h3_audio_vae_fp32.safetensors\n └── minimax_h3_video_vae_fp16.safetensors\n```"
],
"widgets_values_named": {
"text": "## models\n- diffusion_models\n - [minimax_h3_fl2va_pruned_int8_convrot.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/diffusion_models/minimax_h3_fl2va_pruned_int8_convrot.safetensors) (21 GB)\n- text_encoders\n - [qwen3vl_32b_minimax_h3_int8_convrot.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/text_encoders/qwen3vl_32b_minimax_h3_int8_convrot.safetensors) (27.1 GB)\n- vae\n - [minimax_h3_audio_vae_fp32.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/vae/minimax_h3_audio_vae_fp32.safetensors) (605 MB)\n - [minimax_h3_video_vae_fp16.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/vae/minimax_h3_video_vae_fp16.safetensors) (5.21 GB)\n\n```text\n📂ComfyUI/\n└── 📂models/\n ├── 📂diffusion_models/\n │ └── minimax_h3_fl2va_pruned_int8_convrot.safetensors\n ├── 📂text_encoders/\n │ └── qwen3vl_32b_minimax_h3_int8_convrot.safetensors\n └── 📂vae/\n ├── minimax_h3_audio_vae_fp32.safetensors\n └── minimax_h3_video_vae_fp16.safetensors\n```"
},
"color": "#323",
"bgcolor": "#535"
},
{
"id": 91,
"type": "CreateVideo",
"pos": [
1857.2649223855678,
179.46291912812848
],
"size": [
270,
126
],
"flags": {},
"order": 26,
"mode": 0,
"inputs": [
{
"name": "images",
"type": "IMAGE",
"link": 159
},
{
"name": "audio",
"shape": 7,
"type": "AUDIO",
"link": 160
}
],
"outputs": [
{
"name": "VIDEO",
"type": "VIDEO",
"links": [
188
]
}
],
"properties": {
"Node name for S&R": "CreateVideo",
"cnr_id": "comfy-core",
"ver": "0.33.0"
},
"widgets_values": [
24,
8,
"sRGB"
],
"widgets_values_named": {
"fps": 24,
"bit_depth": 8,
"color_space": "sRGB"
}
},
{
"id": 87,
"type": "ComfyMathExpression",
"pos": [
289.97706381075847,
987.0240400771188
],
"size": [
210,
128
],
"flags": {},
"order": 9,
"mode": 0,
"inputs": [
{
"label": "a",
"name": "values.a",
"type": "FLOAT,INT,BOOLEAN",
"link": 166
},
{
"name": "values.b",
"shape": 7,
"type": "FLOAT,INT,BOOLEAN",
"link": null
}
],
"outputs": [
{
"name": "FLOAT",
"type": "FLOAT",
"links": null
},
{
"name": "INT",
"type": "INT",
"links": [
207
]
},
{
"name": "BOOL",
"type": "BOOLEAN",
"links": null
}
],
"properties": {
"Node name for S&R": "ComfyMathExpression",
"cnr_id": "comfy-core",
"ver": "0.33.0"
},
"widgets_values": [
"17 * round((a * 24 - 5) / 17) + 5"
],
"widgets_values_named": {
"expression": "17 * round((a * 24 - 5) / 17) + 5"
}
},
{
"id": 38,
"type": "CLIPLoader",
"pos": [
52.62317611836556,
188.16650543074402
],
"size": [
301.3524169921875,
106
],
"flags": {},
"order": 3,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "CLIP",
"type": "CLIP",
"slot_index": 0,
"links": [
208
]
}
],
"properties": {
"Node name for S&R": "CLIPLoader",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
"qwen3vl_32b_minimax_h3_int8_convrot.safetensors",
"minimax",
"default"
],
"widgets_values_named": {
"clip_name": "qwen3vl_32b_minimax_h3_int8_convrot.safetensors",
"type": "minimax",
"device": "default"
},
"color": "#432",
"bgcolor": "#653"
},
{
"id": 99,
"type": "Reroute",
"pos": [
742.2112975166501,
419.90526705842126
],
"size": [
75,
26
],
"flags": {},
"order": 18,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 169
}
],
"outputs": [
{
"name": "",
"type": "IMAGE",
"links": [
189
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 97,
"type": "ResizeImageMaskNode",
"pos": [
-336.26559350887214,
421.2162624767185
],
"size": [
270,
106
],
"flags": {},
"order": 13,
"mode": 0,
"inputs": [
{
"name": "input",
"type": "IMAGE,MASK",
"link": 167
}
],
"outputs": [
{
"name": "resized",
"type": "IMAGE",
"links": [
168
]
}
],
"properties": {
"Node name for S&R": "ResizeImageMaskNode"
},
"widgets_values": [
"scale total pixels",
1,
"bicubic"
],
"widgets_values_named": {
"resize_type": "scale total pixels",
"resize_type.megapixels": 1,
"scale_method": "bicubic"
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 100,
"type": "GetImageSize",
"pos": [
289.97706381075847,
777.0240400771237
],
"size": [
210,
136
],
"flags": {},
"order": 19,
"mode": 0,
"inputs": [
{
"name": "image",
"type": "IMAGE",
"link": 170
}
],
"outputs": [
{
"name": "width",
"type": "INT",
"links": [
196
]
},
{
"name": "height",
"type": "INT",
"links": [
197
]
},
{
"name": "batch_size",
"type": "INT",
"links": null
}
],
"properties": {
"Node name for S&R": "GetImageSize"
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 39,
"type": "VAELoader",
"pos": [
52.62317611836556,
-59.89911033344882
],
"size": [
301.3524169921875,
58
],
"flags": {},
"order": 4,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "VAE",
"type": "VAE",
"slot_index": 0,
"links": [
218
]
}
],
"properties": {
"Node name for S&R": "VAELoader",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
"minimax_h3_video_vae_fp16.safetensors"
],
"widgets_values_named": {
"vae_name": "minimax_h3_video_vae_fp16.safetensors"
},
"color": "#322",
"bgcolor": "#533"
},
{
"id": 116,
"type": "Reroute",
"pos": [
742.2112975166501,
-59.89911033344882
],
"size": [
75,
26
],
"flags": {},
"order": 11,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 218
}
],
"outputs": [
{
"name": "",
"type": "VAE",
"links": [
219,
220
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 98,
"type": "ResizeImageMaskNode",
"pos": [
-36.26559350887219,
421.2162624767185
],
"size": [
270,
106
],
"flags": {},
"order": 17,
"mode": 0,
"inputs": [
{
"name": "input",
"type": "IMAGE,MASK",
"link": 168
}
],
"outputs": [
{
"name": "resized",
"type": "IMAGE",
"links": [
169,
170
]
}
],
"properties": {
"Node name for S&R": "ResizeImageMaskNode"
},
"widgets_values": [
"scale to multiple",
32,
"bicubic"
],
"widgets_values_named": {
"resize_type": "scale to multiple",
"resize_type.multiple": 32,
"scale_method": "bicubic"
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 3,
"type": "KSampler",
"pos": [
1211.755991191785,
179.46291912812848
],
"size": [
315,
262
],
"flags": {},
"order": 23,
"mode": 0,
"inputs": [
{
"name": "model",
"type": "MODEL",
"link": 236
},
{
"name": "positive",
"type": "CONDITIONING",
"link": 230
},
{
"name": "negative",
"type": "CONDITIONING",
"link": 130
},
{
"name": "latent_image",
"type": "LATENT",
"link": 217
}
],
"outputs": [
{
"name": "LATENT",
"type": "LATENT",
"slot_index": 0,
"links": [
35,
132
]
}
],
"properties": {
"Node name for S&R": "KSampler",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
1234,
"fixed",
20,
1,
"euler",
"simple",
1
],
"widgets_values_named": {
"seed": 1234,
"control_after_generate": "fixed",
"steps": 20,
"cfg": 1,
"sampler_name": "euler",
"scheduler": "simple",
"denoise": 1
}
},
{
"id": 124,
"type": "Reroute",
"pos": [
742.2112975166501,
64.14635395192796
],
"size": [
75,
26
],
"flags": {},
"order": 12,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 232
}
],
"outputs": [
{
"name": "",
"type": "VAE",
"links": [
233,
234
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 81,
"type": "VAELoader",
"pos": [
52.62317611836556,
64.14635395192796
],
"size": [
301.3524169921875,
58
],
"flags": {},
"order": 5,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "VAE",
"type": "VAE",
"slot_index": 0,
"links": [
232
]
}
],
"properties": {
"Node name for S&R": "VAELoader",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
"minimax_h3_audio_vae_fp32.safetensors"
],
"widgets_values_named": {
"vae_name": "minimax_h3_audio_vae_fp32.safetensors"
},
"color": "#322",
"bgcolor": "#533"
},
{
"id": 96,
"type": "LoadImage",
"pos": [
-832.9510737596544,
421.2162624767185
],
"size": [
457.0492532896502,
477.20492096161456
],
"flags": {},
"order": 6,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "IMAGE",
"type": "IMAGE",
"links": [
167
]
},
{
"name": "MASK",
"type": "MASK",
"links": null
}
],
"properties": {
"Node name for S&R": "LoadImage"
},
"widgets_values": [
"oldman.png",
"image"
],
"widgets_values_named": {
"image": "oldman.png",
"upload": "image"
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 111,
"type": "EmptyMiniMaxH3LatentAV",
"pos": [
559.9770638107594,
877.0240400771237
],
"size": [
263.13052726852493,
106
],
"flags": {},
"order": 20,
"mode": 0,
"inputs": [
{
"name": "width",
"type": "INT",
"widget": {
"name": "width"
},
"link": 196
},
{
"name": "height",
"type": "INT",
"widget": {
"name": "height"
},
"link": 197
},
{
"name": "length",
"type": "INT",
"widget": {
"name": "length"
},
"link": 207
}
],
"outputs": [
{
"name": "LATENT",
"type": "LATENT",
"links": [
198,
217
]
}
],
"properties": {
"Node name for S&R": "EmptyMiniMaxH3LatentAV",
"cnr_id": "comfy-core",
"ver": "0.30.0"
},
"widgets_values": [
1344,
768,
124
],
"widgets_values_named": {
"width": 1344,
"height": 768,
"length": 124
}
},
{
"id": 123,
"type": "LoadAudio",
"pos": [
540.8200979765094,
589.0002514197205
],
"size": [
282.798828125,
136
],
"flags": {},
"order": 7,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "AUDIO",
"type": "AUDIO",
"links": [
231
]
}
],
"properties": {
"Node name for S&R": "LoadAudio"
},
"widgets_values": [
"voice.mov",
null,
null
],
"widgets_values_named": {
"audio": "voice.mov",
"upload": null
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 75,
"type": "ConditioningZeroOut",
"pos": [
936.7621950804078,
409.8032138246243
],
"size": [
218.4346850585937,
26
],
"flags": {},
"order": 22,
"mode": 0,
"inputs": [
{
"name": "conditioning",
"type": "CONDITIONING",
"link": 229
}
],
"outputs": [
{
"name": "CONDITIONING",
"type": "CONDITIONING",
"links": [
130
]
}
],
"properties": {
"Node name for S&R": "ConditioningZeroOut",
"cnr_id": "comfy-core",
"ver": "0.30.0"
}
},
{
"id": 107,
"type": "SaveVideo",
"pos": [
2174.4821131448493,
179.46291912812848
],
"size": [
664.0743335803577,
596.0557501852683
],
"flags": {},
"order": 27,
"mode": 0,
"inputs": [
{
"name": "video",
"type": "VIDEO",
"link": 188
}
],
"outputs": [
{
"name": "video",
"type": "VIDEO",
"links": null
}
],
"properties": {},
"widgets_values": [
"video/ComfyUI",
"auto",
"auto",
"auto"
],
"widgets_values_named": {
"filename_prefix": "video/ComfyUI",
"format": "auto",
"format.codec": "auto",
"codec": "auto"
}
},
{
"id": 110,
"type": "CLIPTextEncode",
"pos": [
423.6189261015094,
188.16650543074402
],
"size": [
400,
200
],
"flags": {},
"order": 10,
"mode": 0,
"inputs": [
{
"name": "clip",
"type": "CLIP",
"link": 208
}
],
"outputs": [
{
"name": "CONDITIONING",
"type": "CONDITIONING",
"links": [
209
]
}
],
"properties": {
"Node name for S&R": "CLIPTextEncode"
},
"widgets_values": [
"integrated_multimodal_description:\n[Shot 1] A cinematic live-action shot begins from the provided image. An elderly gentleman sits deep in a leather armchair in a warm traditional study, holding an open newspaper in front of him.\n\nAs he speaks, he slowly lowers the newspaper in a measured, unhurried motion. His head dips slightly while his eyes remain directed toward the camera, as if addressing one person directly in front of him.\n\nHis expression is calm, intelligent, and faintly provocative, with restrained amusement in his eyes and the slightest trace of a knowing smile. His manner is composed and self-assured, with dry understated humor. The performance remains subtle and controlled.\n\nThe newspaper lowers gradually throughout the speech, revealing more of his face and upper body. Small movements of his eyes, eyebrows, lips, and jaw follow the cadence of the spoken audio naturally. By the end, the newspaper rests lower in his hands while he maintains steady eye contact with the camera.\n\nThe camera keeps the same intimate frontal composition with subtle natural cinematic movement. The warm daylight, fireplace glow, and atmosphere of the study remain stable throughout the shot.\n\nnon_diegetic_music:\nN/A"
],
"widgets_values_named": {
"text": "integrated_multimodal_description:\n[Shot 1] A cinematic live-action shot begins from the provided image. An elderly gentleman sits deep in a leather armchair in a warm traditional study, holding an open newspaper in front of him.\n\nAs he speaks, he slowly lowers the newspaper in a measured, unhurried motion. His head dips slightly while his eyes remain directed toward the camera, as if addressing one person directly in front of him.\n\nHis expression is calm, intelligent, and faintly provocative, with restrained amusement in his eyes and the slightest trace of a knowing smile. His manner is composed and self-assured, with dry understated humor. The performance remains subtle and controlled.\n\nThe newspaper lowers gradually throughout the speech, revealing more of his face and upper body. Small movements of his eyes, eyebrows, lips, and jaw follow the cadence of the spoken audio naturally. By the end, the newspaper rests lower in his hands while he maintains steady eye contact with the camera.\n\nThe camera keeps the same intimate frontal composition with subtle natural cinematic movement. The warm daylight, fireplace glow, and atmosphere of the study remain stable throughout the shot.\n\nnon_diegetic_music:\nN/A"
}
},
{
"id": 79,
"type": "Reroute",
"pos": [
1451.755991191785,
-59.89911033344882
],
"size": [
75,
26
],
"flags": {},
"order": 15,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 219
}
],
"outputs": [
{
"name": "",
"type": "VAE",
"links": [
140
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 82,
"type": "Reroute",
"pos": [
1451.755991191785,
64.14635395192796
],
"size": [
75,
26
],
"flags": {},
"order": 16,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 234
}
],
"outputs": [
{
"name": "",
"type": "VAE",
"links": [
150
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 125,
"type": "Reroute",
"pos": [
1080.0872362977473,
-207.9445746188256
],
"size": [
75,
26
],
"flags": {},
"order": 14,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 235
}
],
"outputs": [
{
"name": "",
"type": "MODEL",
"links": [
236
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 108,
"type": "MiniMaxH3AddGuide",
"pos": [
880.4470019227473,
188.16650543074402
],
"size": [
274.640234375,
158
],
"flags": {},
"order": 21,
"mode": 0,
"inputs": [
{
"name": "positive",
"type": "CONDITIONING",
"link": 209
},
{
"name": "latent",
"type": "LATENT",
"link": 198
},
{
"name": "vae",
"shape": 7,
"type": "VAE",
"link": 220
},
{
"name": "audio_vae",
"shape": 7,
"type": "VAE",
"link": 233
},
{
"name": "image",
"shape": 7,
"type": "IMAGE",
"link": 189
},
{
"name": "audio",
"shape": 7,
"type": "AUDIO",
"link": 231
}
],
"outputs": [
{
"name": "positive",
"type": "CONDITIONING",
"links": [
229,
230
]
}
],
"properties": {
"Node name for S&R": "MiniMaxH3AddGuide"
},
"widgets_values": [
0
],
"widgets_values_named": {
"frame_idx": 0
},
"color": "#232",
"bgcolor": "#353"
}
],
"links": [
[
35,
3,
0,
8,
0,
"LATENT"
],
[
130,
75,
0,
3,
2,
"CONDITIONING"
],
[
132,
3,
0,
77,
0,
"LATENT"
],
[
140,
79,
0,
8,
1,
"VAE"
],
[
150,
82,
0,
77,
1,
"VAE"
],
[
159,
8,
0,
91,
0,
"IMAGE"
],
[
160,
77,
0,
91,
1,
"AUDIO"
],
[
163,
37,
0,
86,
0,
"MODEL"
],
[
166,
94,
0,
87,
0,
"FLOAT"
],
[
167,
96,
0,
97,
0,
"IMAGE"
],
[
168,
97,
0,
98,
0,
"IMAGE"
],
[
169,
98,
0,
99,
0,
"IMAGE"
],
[
170,
98,
0,
100,
0,
"IMAGE"
],
[
188,
91,
0,
107,
0,
"VIDEO"
],
[
189,
99,
0,
108,
4,
"IMAGE"
],
[
196,
100,
0,
111,
0,
"INT"
],
[
197,
100,
1,
111,
1,
"INT"
],
[
198,
111,
0,
108,
1,
"LATENT"
],
[
207,
87,
1,
111,
2,
"INT"
],
[
208,
38,
0,
110,
0,
"CLIP"
],
[
209,
110,
0,
108,
0,
"CONDITIONING"
],
[
217,
111,
0,
3,
3,
"LATENT"
],
[
218,
39,
0,
116,
0,
"VAE"
],
[
219,
116,
0,
79,
0,
"VAE"
],
[
220,
116,
0,
108,
2,
"VAE"
],
[
229,
108,
0,
75,
0,
"CONDITIONING"
],
[
230,
108,
0,
3,
1,
"CONDITIONING"
],
[
231,
123,
0,
108,
5,
"AUDIO"
],
[
232,
81,
0,
124,
0,
"VAE"
],
[
233,
124,
0,
108,
3,
"VAE"
],
[
234,
124,
0,
82,
0,
"VAE"
],
[
235,
86,
0,
125,
0,
"MODEL"
],
[
236,
125,
0,
3,
0,
"MODEL"
]
],
"groups": [],
"config": {},
"extra": {
"ds": {
"scale": 0.47362440744767537,
"offset": [
819.9539200996915,
520.184490623166
]
},
"frontendVersion": "1.51.9",
"VHS_latentpreview": false,
"VHS_latentpreviewrate": 0,
"VHS_MetadataImage": true,
"VHS_KeepIntermediate": true
},
"version": 0.4
}
Add Guide for MiniMax H3 也可以输入音频。
输入图像和音频,试着生成一段让图中人物配合音频动作的视频吧。
输出示例
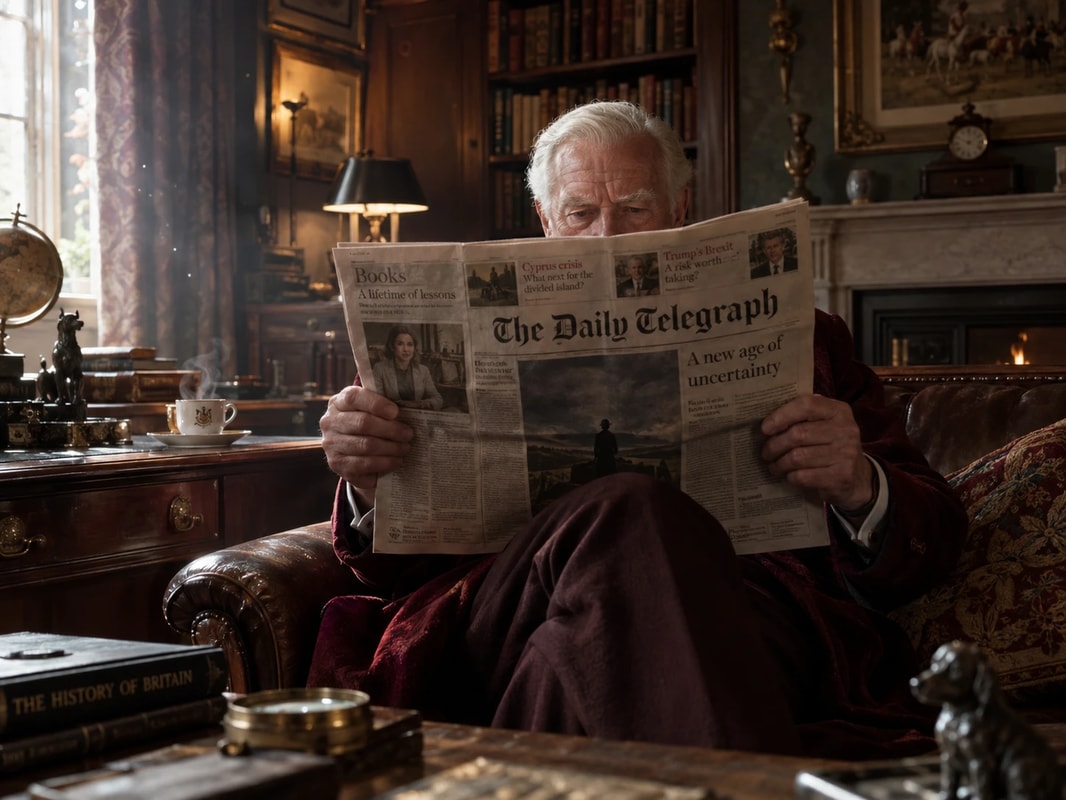
Reference Generation
使用模型:ref2va
从这里开始才是 MiniMax H3 真正有意思的地方。
H3 可以放入多个“图像”“视频”和“音频”,作为生成视频时的参考素材。
之后只需写出“让图像 1 使用音频 1 说话”这样的指示,就能控制生成的视频。很厉害。
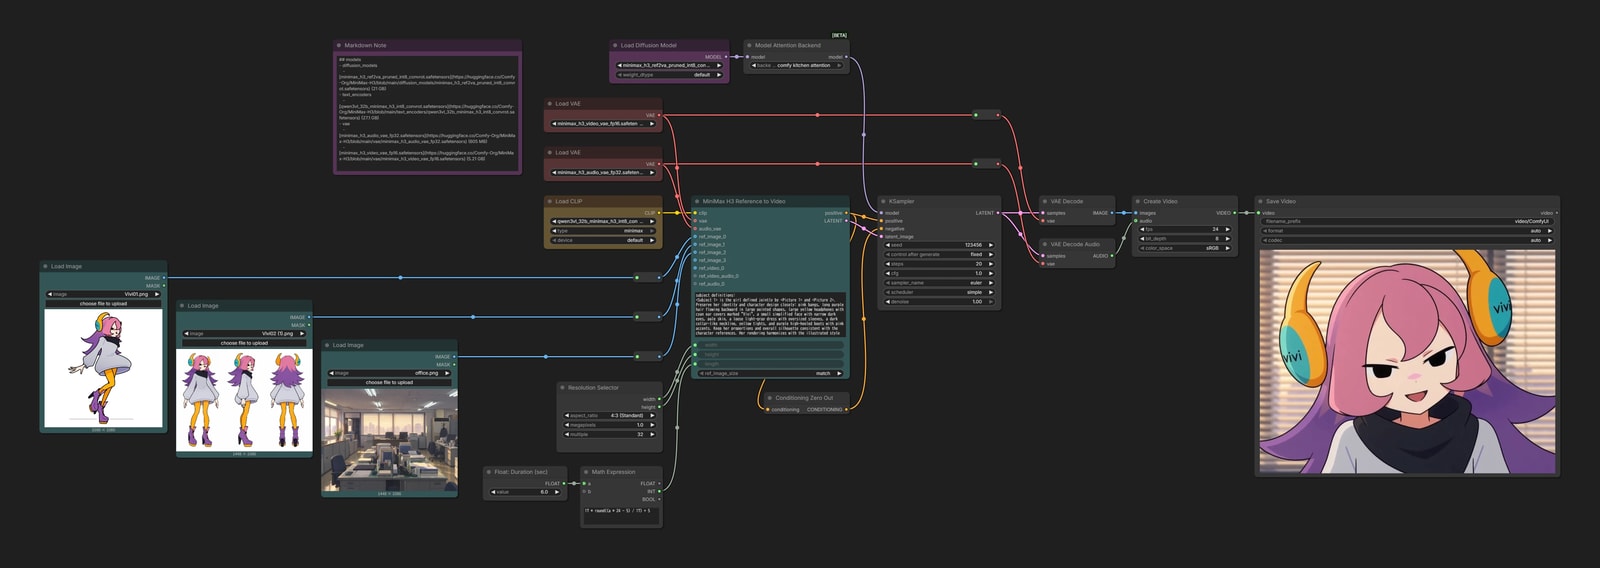
{
"id": "ab470b3f-c850-4cc5-be9c-63a1bff0dc45",
"revision": 0,
"last_node_id": 118,
"last_link_id": 206,
"nodes": [
{
"id": 77,
"type": "VAEDecodeAudio",
"pos": [
1308.6980183050962,
296.9762089835968
],
"size": [
194.25299723441972,
46
],
"flags": {},
"order": 21,
"mode": 0,
"inputs": [
{
"name": "samples",
"type": "LATENT",
"link": 132
},
{
"name": "vae",
"type": "VAE",
"link": 150
}
],
"outputs": [
{
"name": "AUDIO",
"type": "AUDIO",
"links": [
160
]
}
],
"properties": {
"Node name for S&R": "VAEDecodeAudio",
"cnr_id": "comfy-core",
"ver": "0.30.0"
}
},
{
"id": 91,
"type": "CreateVideo",
"pos": [
1544.2637529711267,
188.1918182373047
],
"size": [
270,
126
],
"flags": {},
"order": 22,
"mode": 0,
"inputs": [
{
"name": "images",
"type": "IMAGE",
"link": 159
},
{
"name": "audio",
"shape": 7,
"type": "AUDIO",
"link": 160
}
],
"outputs": [
{
"name": "VIDEO",
"type": "VIDEO",
"links": [
158
]
}
],
"properties": {
"Node name for S&R": "CreateVideo",
"cnr_id": "comfy-core",
"ver": "0.33.0"
},
"widgets_values": [
24,
8,
"sRGB"
],
"widgets_values_named": {
"fps": 24,
"bit_depth": 8,
"color_space": "sRGB"
}
},
{
"id": 8,
"type": "VAEDecode",
"pos": [
1308.6980183050962,
188.1918182373047
],
"size": [
194.25299723441972,
46
],
"flags": {},
"order": 20,
"mode": 0,
"inputs": [
{
"name": "samples",
"type": "LATENT",
"link": 35
},
{
"name": "vae",
"type": "VAE",
"link": 140
}
],
"outputs": [
{
"name": "IMAGE",
"type": "IMAGE",
"slot_index": 0,
"links": [
159
]
}
],
"properties": {
"Node name for S&R": "VAEDecode",
"cnr_id": "comfy-core",
"ver": "0.3.33"
}
},
{
"id": 82,
"type": "Reroute",
"pos": [
1138.7548217773438,
64.14635395192796
],
"size": [
75,
26
],
"flags": {},
"order": 12,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 149
}
],
"outputs": [
{
"name": "",
"type": "VAE",
"links": [
150
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 79,
"type": "Reroute",
"pos": [
1138.7548217773438,
-59.89911033344882
],
"size": [
75,
26
],
"flags": {},
"order": 11,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 139
}
],
"outputs": [
{
"name": "",
"type": "VAE",
"links": [
140
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 86,
"type": "ModelAttentionBackend",
"pos": [
559.0936845136185,
-207.9445746188256
],
"size": [
270,
58
],
"flags": {},
"order": 16,
"mode": 0,
"inputs": [
{
"name": "model",
"type": "MODEL",
"link": 163
}
],
"outputs": [
{
"name": "model",
"type": "MODEL",
"links": [
164
]
}
],
"properties": {
"Node name for S&R": "ModelAttentionBackend"
},
"widgets_values": [
"comfy kitchen attention"
],
"widgets_values_named": {
"attention": "comfy kitchen attention"
}
},
{
"id": 106,
"type": "PrimitiveFloat",
"pos": [
-101.89560076318938,
875.2722138081197
],
"size": [
214.65850806503283,
58
],
"flags": {},
"order": 0,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "FLOAT",
"type": "FLOAT",
"links": [
182
]
}
],
"title": "Float: Duration (sec)",
"properties": {
"Node name for S&R": "PrimitiveFloat"
},
"widgets_values": [
6
],
"widgets_values_named": {
"value": 6
}
},
{
"id": 104,
"type": "ComfyMathExpression",
"pos": [
144.7880224599936,
875.2722138081197
],
"size": [
210,
128
],
"flags": {},
"order": 10,
"mode": 0,
"inputs": [
{
"label": "a",
"name": "values.a",
"type": "FLOAT,INT,BOOLEAN",
"link": 182
},
{
"name": "values.b",
"shape": 7,
"type": "FLOAT,INT,BOOLEAN",
"link": null
}
],
"outputs": [
{
"name": "FLOAT",
"type": "FLOAT",
"links": null
},
{
"name": "INT",
"type": "INT",
"links": [
188
]
},
{
"name": "BOOL",
"type": "BOOLEAN",
"links": null
}
],
"properties": {
"Node name for S&R": "ComfyMathExpression",
"cnr_id": "comfy-core",
"ver": "0.33.0"
},
"widgets_values": [
"17 * round((a * 24 - 5) / 17) + 5"
],
"widgets_values_named": {
"expression": "17 * round((a * 24 - 5) / 17) + 5"
}
},
{
"id": 38,
"type": "CLIPLoader",
"pos": [
52.62317611836556,
188.1918182373047
],
"size": [
301.3524169921875,
106
],
"flags": {},
"order": 1,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "CLIP",
"type": "CLIP",
"slot_index": 0,
"links": [
192
]
}
],
"properties": {
"Node name for S&R": "CLIPLoader",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
"qwen3vl_32b_minimax_h3_int8_convrot.safetensors",
"minimax",
"default"
],
"widgets_values_named": {
"clip_name": "qwen3vl_32b_minimax_h3_int8_convrot.safetensors",
"type": "minimax",
"device": "default"
},
"color": "#432",
"bgcolor": "#653"
},
{
"id": 39,
"type": "VAELoader",
"pos": [
52.62317611836556,
-59.89911033344882
],
"size": [
301.3524169921875,
58
],
"flags": {},
"order": 2,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "VAE",
"type": "VAE",
"slot_index": 0,
"links": [
139,
193
]
}
],
"properties": {
"Node name for S&R": "VAELoader",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
"minimax_h3_video_vae_fp16.safetensors"
],
"widgets_values_named": {
"vae_name": "minimax_h3_video_vae_fp16.safetensors"
},
"color": "#322",
"bgcolor": "#533"
},
{
"id": 81,
"type": "VAELoader",
"pos": [
52.62317611836556,
64.14635395192796
],
"size": [
301.3524169921875,
58
],
"flags": {},
"order": 3,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "VAE",
"type": "VAE",
"slot_index": 0,
"links": [
149,
194
]
}
],
"properties": {
"Node name for S&R": "VAELoader",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
"minimax_h3_audio_vae_fp32.safetensors"
],
"widgets_values_named": {
"vae_name": "minimax_h3_audio_vae_fp32.safetensors"
},
"color": "#322",
"bgcolor": "#533"
},
{
"id": 99,
"type": "Reroute",
"pos": [
278.97559311055306,
352.8802091216946
],
"size": [
75,
26
],
"flags": {},
"order": 13,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 198
}
],
"outputs": [
{
"name": "",
"type": "IMAGE",
"links": [
195
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 96,
"type": "LoadImage",
"pos": [
-1226.968717261569,
352.8802091216946
],
"size": [
324.9975606771653,
408.8341688495086
],
"flags": {},
"order": 4,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "IMAGE",
"type": "IMAGE",
"links": [
198
]
},
{
"name": "MASK",
"type": "MASK",
"links": null
}
],
"properties": {
"Node name for S&R": "LoadImage"
},
"widgets_values": [
"Vivi01.png",
"image"
],
"widgets_values_named": {
"image": "Vivi01.png",
"upload": "image"
},
"color": "#233",
"bgcolor": "#355"
},
{
"id": 75,
"type": "ConditioningZeroOut",
"pos": [
610.6589994550249,
687.4058481340641
],
"size": [
218.4346850585937,
26
],
"flags": {},
"order": 18,
"mode": 0,
"inputs": [
{
"name": "conditioning",
"type": "CONDITIONING",
"link": 191
}
],
"outputs": [
{
"name": "CONDITIONING",
"type": "CONDITIONING",
"links": [
130
]
}
],
"properties": {
"Node name for S&R": "ConditioningZeroOut",
"cnr_id": "comfy-core",
"ver": "0.30.0"
}
},
{
"id": 109,
"type": "LoadImage",
"pos": [
-880.4441573026234,
452.783487490947
],
"size": [
346.6290818997061,
371.3395062449347
],
"flags": {},
"order": 5,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "IMAGE",
"type": "IMAGE",
"links": [
200
]
},
{
"name": "MASK",
"type": "MASK",
"links": null
}
],
"properties": {
"Node name for S&R": "LoadImage"
},
"widgets_values": [
"Vivi02 (1).png",
"image"
],
"widgets_values_named": {
"image": "Vivi02 (1).png",
"upload": "image"
},
"color": "#233",
"bgcolor": "#355"
},
{
"id": 110,
"type": "Reroute",
"pos": [
278.97559311055306,
452.783487490947
],
"size": [
75,
26
],
"flags": {},
"order": 14,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 200
}
],
"outputs": [
{
"name": "",
"type": "IMAGE",
"links": [
201
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 105,
"type": "ResolutionSelector",
"pos": [
84.78802245999361,
660.7474274848913
],
"size": [
270,
150
],
"flags": {},
"order": 6,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "width",
"type": "INT",
"links": [
186
]
},
{
"name": "height",
"type": "INT",
"links": [
187
]
}
],
"properties": {
"Node name for S&R": "ResolutionSelector",
"cnr_id": "comfy-core",
"ver": "0.29.0"
},
"widgets_values": [
"4:3 (Standard)",
1,
32
],
"widgets_values_named": {
"aspect_ratio": "4:3 (Standard)",
"megapixels": 1,
"multiple": 32
}
},
{
"id": 111,
"type": "LoadImage",
"pos": [
-512.288076121137,
553.5120750138675
],
"size": [
346.6290818997061,
371.3395062449347
],
"flags": {},
"order": 7,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "IMAGE",
"type": "IMAGE",
"links": [
205
]
},
{
"name": "MASK",
"type": "MASK",
"links": null
}
],
"properties": {
"Node name for S&R": "LoadImage"
},
"widgets_values": [
"office.png",
"image"
],
"widgets_values_named": {
"image": "office.png",
"upload": "image"
},
"color": "#233",
"bgcolor": "#355"
},
{
"id": 112,
"type": "Reroute",
"pos": [
279.7880224599936,
553.5120750138675
],
"size": [
75,
26
],
"flags": {},
"order": 15,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 205
}
],
"outputs": [
{
"name": "",
"type": "IMAGE",
"links": [
206
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 108,
"type": "MiniMaxH3ReferenceToVideo",
"pos": [
426.3652074439484,
188.1918182373047
],
"size": [
402.72847706967013,
435.87824423792404
],
"flags": {},
"order": 17,
"mode": 0,
"inputs": [
{
"name": "clip",
"type": "CLIP",
"link": 192
},
{
"name": "vae",
"shape": 7,
"type": "VAE",
"link": 193
},
{
"name": "audio_vae",
"shape": 7,
"type": "VAE",
"link": 194
},
{
"name": "ref_images.ref_image_0",
"shape": 7,
"type": "IMAGE",
"link": 195
},
{
"name": "ref_images.ref_image_1",
"shape": 7,
"type": "IMAGE",
"link": 201
},
{
"name": "ref_images.ref_image_2",
"shape": 7,
"type": "IMAGE",
"link": 206
},
{
"name": "ref_images.ref_image_3",
"shape": 7,
"type": "IMAGE",
"link": null
},
{
"name": "ref_videos.ref_video_0",
"shape": 7,
"type": "IMAGE",
"link": null
},
{
"name": "ref_video_audios.ref_video_audio_0",
"shape": 7,
"type": "AUDIO",
"link": null
},
{
"name": "ref_audios.ref_audio_0",
"shape": 7,
"type": "AUDIO",
"link": null
},
{
"name": "width",
"type": "INT",
"widget": {
"name": "width"
},
"link": 186
},
{
"name": "height",
"type": "INT",
"widget": {
"name": "height"
},
"link": 187
},
{
"name": "length",
"type": "INT",
"widget": {
"name": "length"
},
"link": 188
}
],
"outputs": [
{
"name": "positive",
"type": "CONDITIONING",
"links": [
190,
191
]
},
{
"name": "LATENT",
"type": "LATENT",
"links": [
189
]
}
],
"properties": {
"Node name for S&R": "MiniMaxH3ReferenceToVideo"
},
"widgets_values": [
"subject_definitions:\n<Subject 1> is the girl defined jointly by <Picture 1> and <Picture 2>. Preserve her identity and character design closely: pink bangs, long purple hair flowing backward in large pointed shapes, large yellow headphones with cyan ear covers marked \"Vivi\", a small simplified face with narrow dark eyes, pale skin, a loose light-gray dress with oversized sleeves, a dark collar-like neckline, yellow tights, and purple high-heeled boots with pink accents. Keep her proportions and overall silhouette consistent with the character references. Her rendering harmonizes with the illustrated style of <Picture 3> while remaining clearly the same character.\n<Subject 2> is the office environment in <Picture 3>, preserving the central back desk, the surrounding office layout, the desks in the foreground, the fluorescent ceiling lights, the large windows with blinds, and the warm late-afternoon office atmosphere.\n\nsummary:\n[reference generation] The target video shows <Subject 1> sitting on the central back desk in <Subject 2>, speaking in two parts. The first part is shown in a low-angle shot from near the floor, and then the video cuts to a close-up of her face for the second part.\n\nretention_analysis:\n<Subject 1> (appears in [Shot 1], [Shot 2]): fully_preserved - preserve her identity, exact character design, silhouette, hairstyle, headphones, clothing, tights, boots, and simplified facial design. Adapt the rendering slightly so she fits the illustrated background style.\n<Subject 2> (appears in [Shot 1], [Shot 2]): fully_preserved - preserve the office layout, the central back desk, window blinds, ceiling lights, and late-afternoon office atmosphere.\n\ndetailed_description:\nThe target video uses a clean illustrated anime-like style. <Subject 1> matches the design from <Picture 1> and <Picture 2> closely, while blending naturally into the illustrated office look of <Picture 3>. Slight handheld motion is present throughout the whole video.\n\n[Shot 1] <Subject 1> is sitting on top of the central back desk in <Subject 2>. Her hips rest fully on the desk surface. She leans backward in a relaxed pose, with both arms stretched behind her and both hands placed on the desk to support her weight. Her legs are crossed and dangling freely off the edge of the desk, swinging lightly above the floor. The camera is placed near floor level in front of the desk and looks up at her from a diagonal low angle. The camera slowly pans to the right while arcing around her in a gentle horizontal rotational move, keeping her as the focal point. She speaks the first half of the line in a calm, confident, slightly teasing tone (S1): <d>[Japanese] 睡眠は待ってくれても、</d>\n\n[Shot 2] At 00:03.000, the camera cuts to a close-up of <Subject 1>'s face. The shot is tighter and focuses on her expression. Slight handheld motion continues, and the framing stays comparatively stable. She lifts her chin slightly and looks directly toward the viewer with her eyes, giving a confident, superior, slightly smug expression. She then delivers the second half of the line (S1): <d>[Japanese] 進歩は待ってくれないわよ。</d>\n\noverall_soundscape:\nQuiet office room tone with a soft air-conditioner hum and subtle indoor ambience. <Subject 1>'s voice is clear and prominent.\n\nnon_diegetic_music:\nN/A",
1344,
768,
124,
"match"
],
"widgets_values_named": {
"prompt": "subject_definitions:\n<Subject 1> is the girl defined jointly by <Picture 1> and <Picture 2>. Preserve her identity and character design closely: pink bangs, long purple hair flowing backward in large pointed shapes, large yellow headphones with cyan ear covers marked \"Vivi\", a small simplified face with narrow dark eyes, pale skin, a loose light-gray dress with oversized sleeves, a dark collar-like neckline, yellow tights, and purple high-heeled boots with pink accents. Keep her proportions and overall silhouette consistent with the character references. Her rendering harmonizes with the illustrated style of <Picture 3> while remaining clearly the same character.\n<Subject 2> is the office environment in <Picture 3>, preserving the central back desk, the surrounding office layout, the desks in the foreground, the fluorescent ceiling lights, the large windows with blinds, and the warm late-afternoon office atmosphere.\n\nsummary:\n[reference generation] The target video shows <Subject 1> sitting on the central back desk in <Subject 2>, speaking in two parts. The first part is shown in a low-angle shot from near the floor, and then the video cuts to a close-up of her face for the second part.\n\nretention_analysis:\n<Subject 1> (appears in [Shot 1], [Shot 2]): fully_preserved - preserve her identity, exact character design, silhouette, hairstyle, headphones, clothing, tights, boots, and simplified facial design. Adapt the rendering slightly so she fits the illustrated background style.\n<Subject 2> (appears in [Shot 1], [Shot 2]): fully_preserved - preserve the office layout, the central back desk, window blinds, ceiling lights, and late-afternoon office atmosphere.\n\ndetailed_description:\nThe target video uses a clean illustrated anime-like style. <Subject 1> matches the design from <Picture 1> and <Picture 2> closely, while blending naturally into the illustrated office look of <Picture 3>. Slight handheld motion is present throughout the whole video.\n\n[Shot 1] <Subject 1> is sitting on top of the central back desk in <Subject 2>. Her hips rest fully on the desk surface. She leans backward in a relaxed pose, with both arms stretched behind her and both hands placed on the desk to support her weight. Her legs are crossed and dangling freely off the edge of the desk, swinging lightly above the floor. The camera is placed near floor level in front of the desk and looks up at her from a diagonal low angle. The camera slowly pans to the right while arcing around her in a gentle horizontal rotational move, keeping her as the focal point. She speaks the first half of the line in a calm, confident, slightly teasing tone (S1): <d>[Japanese] 睡眠は待ってくれても、</d>\n\n[Shot 2] At 00:03.000, the camera cuts to a close-up of <Subject 1>'s face. The shot is tighter and focuses on her expression. Slight handheld motion continues, and the framing stays comparatively stable. She lifts her chin slightly and looks directly toward the viewer with her eyes, giving a confident, superior, slightly smug expression. She then delivers the second half of the line (S1): <d>[Japanese] 進歩は待ってくれないわよ。</d>\n\noverall_soundscape:\nQuiet office room tone with a soft air-conditioner hum and subtle indoor ambience. <Subject 1>'s voice is clear and prominent.\n\nnon_diegetic_music:\nN/A",
"width": 1344,
"height": 768,
"length": 124,
"ref_image_size": "match"
},
"color": "#233",
"bgcolor": "#355"
},
{
"id": 3,
"type": "KSampler",
"pos": [
898.7548217773438,
188.1918182373047
],
"size": [
315,
262
],
"flags": {},
"order": 19,
"mode": 0,
"inputs": [
{
"name": "model",
"type": "MODEL",
"link": 164
},
{
"name": "positive",
"type": "CONDITIONING",
"link": 190
},
{
"name": "negative",
"type": "CONDITIONING",
"link": 130
},
{
"name": "latent_image",
"type": "LATENT",
"link": 189
}
],
"outputs": [
{
"name": "LATENT",
"type": "LATENT",
"slot_index": 0,
"links": [
35,
132
]
}
],
"properties": {
"Node name for S&R": "KSampler",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
123456,
"fixed",
20,
1,
"euler",
"simple",
1
],
"widgets_values_named": {
"seed": 123456,
"control_after_generate": "fixed",
"steps": 20,
"cfg": 1,
"sampler_name": "euler",
"scheduler": "simple",
"denoise": 1
}
},
{
"id": 92,
"type": "SaveVideo",
"pos": [
1855.5764904027374,
188.1918182373047
],
"size": [
776.1807907170905,
685.3800578399604
],
"flags": {},
"order": 23,
"mode": 0,
"inputs": [
{
"name": "video",
"type": "VIDEO",
"link": 158
}
],
"outputs": [
{
"name": "video",
"type": "VIDEO",
"links": null
}
],
"properties": {
"cnr_id": "comfy-core",
"ver": "0.33.0"
},
"widgets_values": [
"video/ComfyUI",
"auto",
"auto",
"auto"
],
"widgets_values_named": {
"filename_prefix": "video/ComfyUI",
"format": "auto",
"format.codec": "auto",
"codec": "auto"
}
},
{
"id": 37,
"type": "UNETLoader",
"pos": [
218.55216245088812,
-207.9445746188256
],
"size": [
305.3782043457031,
82
],
"flags": {},
"order": 8,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "MODEL",
"type": "MODEL",
"slot_index": 0,
"links": [
163
]
}
],
"properties": {
"Node name for S&R": "UNETLoader",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
"minimax_h3_ref2va_pruned_int8_convrot.safetensors",
"default"
],
"widgets_values_named": {
"unet_name": "minimax_h3_ref2va_pruned_int8_convrot.safetensors",
"weight_dtype": "default"
},
"color": "#323",
"bgcolor": "#535"
},
{
"id": 95,
"type": "MarkdownNote",
"pos": [
-482.3943342566212,
-207.9445746188256
],
"size": [
480.26512898835654,
314.3204118484383
],
"flags": {},
"order": 9,
"mode": 0,
"inputs": [],
"outputs": [],
"properties": {},
"widgets_values": [
"## models\n- diffusion_models\n - [minimax_h3_ref2va_pruned_int8_convrot.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/diffusion_models/minimax_h3_ref2va_pruned_int8_convrot.safetensors) (21 GB)\n- text_encoders\n - [qwen3vl_32b_minimax_h3_int8_convrot.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/text_encoders/qwen3vl_32b_minimax_h3_int8_convrot.safetensors) (27.1 GB)\n- vae\n - [minimax_h3_audio_vae_fp32.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/vae/minimax_h3_audio_vae_fp32.safetensors) (605 MB)\n - [minimax_h3_video_vae_fp16.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/vae/minimax_h3_video_vae_fp16.safetensors) (5.21 GB)\n\n```text\n📂ComfyUI/\n└── 📂models/\n ├── 📂diffusion_models/\n │ └── minimax_h3_ref2va_pruned_int8_convrot.safetensors\n ├── 📂text_encoders/\n │ └── qwen3vl_32b_minimax_h3_int8_convrot.safetensors\n └── 📂vae/\n ├── minimax_h3_audio_vae_fp32.safetensors\n └── minimax_h3_video_vae_fp16.safetensors\n```"
],
"widgets_values_named": {
"text": "## models\n- diffusion_models\n - [minimax_h3_ref2va_pruned_int8_convrot.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/diffusion_models/minimax_h3_ref2va_pruned_int8_convrot.safetensors) (21 GB)\n- text_encoders\n - [qwen3vl_32b_minimax_h3_int8_convrot.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/text_encoders/qwen3vl_32b_minimax_h3_int8_convrot.safetensors) (27.1 GB)\n- vae\n - [minimax_h3_audio_vae_fp32.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/vae/minimax_h3_audio_vae_fp32.safetensors) (605 MB)\n - [minimax_h3_video_vae_fp16.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/vae/minimax_h3_video_vae_fp16.safetensors) (5.21 GB)\n\n```text\n📂ComfyUI/\n└── 📂models/\n ├── 📂diffusion_models/\n │ └── minimax_h3_ref2va_pruned_int8_convrot.safetensors\n ├── 📂text_encoders/\n │ └── qwen3vl_32b_minimax_h3_int8_convrot.safetensors\n └── 📂vae/\n ├── minimax_h3_audio_vae_fp32.safetensors\n └── minimax_h3_video_vae_fp16.safetensors\n```"
},
"color": "#323",
"bgcolor": "#535"
}
],
"links": [
[
35,
3,
0,
8,
0,
"LATENT"
],
[
130,
75,
0,
3,
2,
"CONDITIONING"
],
[
132,
3,
0,
77,
0,
"LATENT"
],
[
139,
39,
0,
79,
0,
"VAE"
],
[
140,
79,
0,
8,
1,
"VAE"
],
[
149,
81,
0,
82,
0,
"VAE"
],
[
150,
82,
0,
77,
1,
"VAE"
],
[
158,
91,
0,
92,
0,
"VIDEO"
],
[
159,
8,
0,
91,
0,
"IMAGE"
],
[
160,
77,
0,
91,
1,
"AUDIO"
],
[
163,
37,
0,
86,
0,
"MODEL"
],
[
164,
86,
0,
3,
0,
"MODEL"
],
[
182,
106,
0,
104,
0,
"FLOAT"
],
[
186,
105,
0,
108,
10,
"INT"
],
[
187,
105,
1,
108,
11,
"INT"
],
[
188,
104,
1,
108,
12,
"INT"
],
[
189,
108,
1,
3,
3,
"LATENT"
],
[
190,
108,
0,
3,
1,
"CONDITIONING"
],
[
191,
108,
0,
75,
0,
"CONDITIONING"
],
[
192,
38,
0,
108,
0,
"CLIP"
],
[
193,
39,
0,
108,
1,
"VAE"
],
[
194,
81,
0,
108,
2,
"VAE"
],
[
195,
99,
0,
108,
3,
"IMAGE"
],
[
198,
96,
0,
99,
0,
"IMAGE"
],
[
200,
109,
0,
110,
0,
"IMAGE"
],
[
201,
110,
0,
108,
4,
"IMAGE"
],
[
205,
111,
0,
112,
0,
"IMAGE"
],
[
206,
112,
0,
108,
5,
"IMAGE"
]
],
"groups": [],
"config": {},
"extra": {
"ds": {
"scale": 0.6934334949441482,
"offset": [
689.1637035814191,
455.47628460067847
]
},
"frontendVersion": "1.51.10",
"VHS_latentpreview": false,
"VHS_latentpreviewrate": 0,
"VHS_MetadataImage": true,
"VHS_KeepIntermediate": true
},
"version": 0.4
}
这次会把所有图像都作为参考来生成视频。
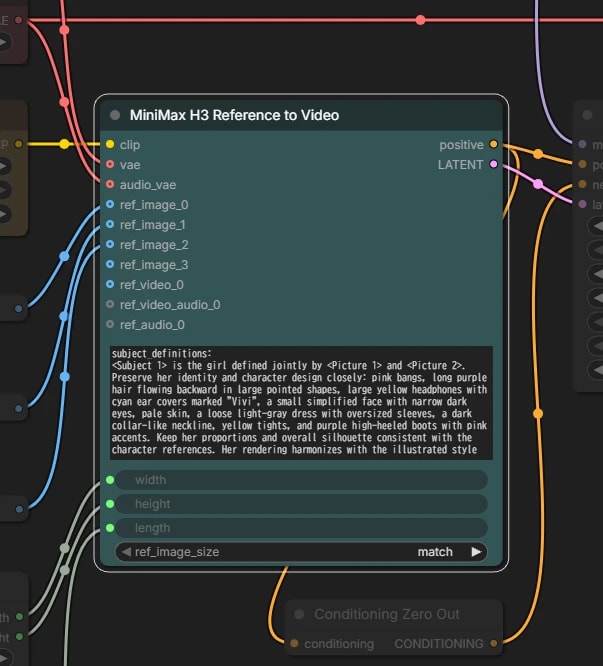
提示词
它的提示词写法与 fl2va 模型不同。
请参考上面的提示词 / Ref2VA 来编写。
比较麻烦的是,节点上从
ref_image_0这样的 0 开始编号,而 H3 的提示词则从<Picture 1>这样的 1 开始编号。
输出示例
🤔 Ref2VA 的直接输出质量低于 FL2VA
MiniMax 官方也承认这一点:与 FL2VA 模型相比,Ref2VA 模型的直接输出质量会更低。
最好还是等这个问题从根本上解决,不过现在也有一些取巧的办法。
实际上,这两个模型的架构几乎相同,因此 FL2VA 模型也能在一定程度上进行 Reference Generation。
画面变漂亮了。不过真要说灵活性,还是 Ref2VA 更好。
因此,也有人制作了将两个模型巧妙混合起来的 Hybrid model,这里也顺便介绍一下。如果实在无法接受 Ref2VA 的表现,可以试试看。
- Minimax-H3-fl2va-ref2va-hybrid-models
- 按照更偏向 Ref2VA 的程度,提供了多个模型
- 可以试试
b20-49或b25-49
Video Editing
使用模型:ref2va
ref2va 另一个具有代表性的用途,是基于指令的视频编辑。
可以理解为 FLUX.2 [klein] 或 Nano Banana 这类图像编辑的视频版本。
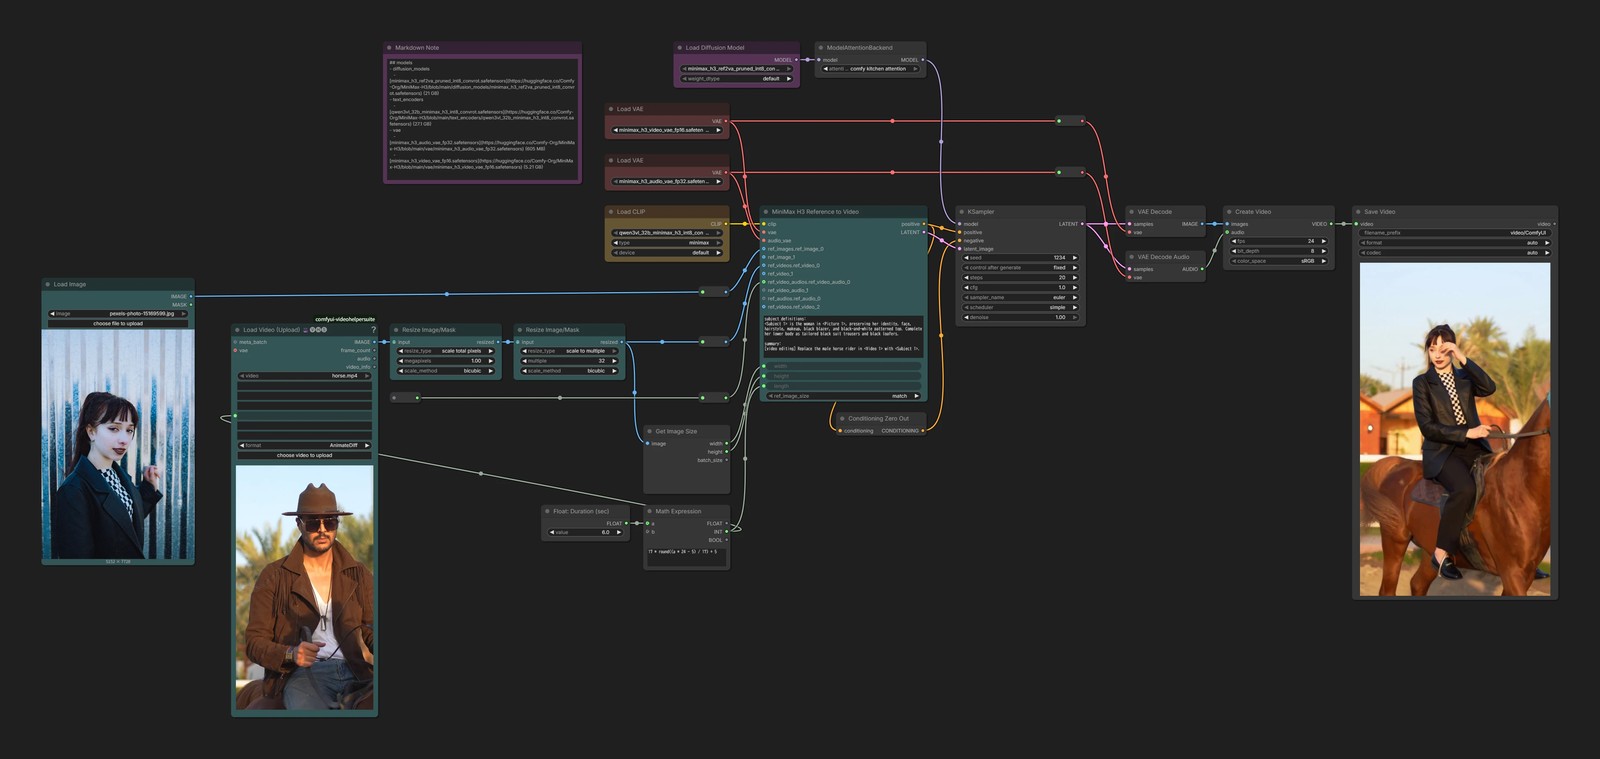
{
"id": "492d6f9b-8935-4aac-813c-0650d63c0596",
"revision": 0,
"last_node_id": 127,
"last_link_id": 227,
"nodes": [
{
"id": 77,
"type": "VAEDecodeAudio",
"pos": [
1308.6980183050962,
296.9762089835968
],
"size": [
194.25299723441972,
46
],
"flags": {},
"order": 23,
"mode": 0,
"inputs": [
{
"name": "samples",
"type": "LATENT",
"link": 132
},
{
"name": "vae",
"type": "VAE",
"link": 150
}
],
"outputs": [
{
"name": "AUDIO",
"type": "AUDIO",
"links": [
160
]
}
],
"properties": {
"cnr_id": "comfy-core",
"ver": "0.30.0",
"Node name for S&R": "VAEDecodeAudio"
}
},
{
"id": 91,
"type": "CreateVideo",
"pos": [
1544.2637529711267,
188.1918182373047
],
"size": [
270,
126
],
"flags": {},
"order": 24,
"mode": 0,
"inputs": [
{
"name": "images",
"type": "IMAGE",
"link": 159
},
{
"name": "audio",
"shape": 7,
"type": "AUDIO",
"link": 160
}
],
"outputs": [
{
"name": "VIDEO",
"type": "VIDEO",
"links": [
158
]
}
],
"properties": {
"cnr_id": "comfy-core",
"ver": "0.33.0",
"Node name for S&R": "CreateVideo"
},
"widgets_values": [
24,
8,
"sRGB"
],
"widgets_values_named": {
"fps": 24,
"bit_depth": 8,
"color_space": "sRGB"
}
},
{
"id": 8,
"type": "VAEDecode",
"pos": [
1308.6980183050962,
188.1918182373047
],
"size": [
194.25299723441972,
46
],
"flags": {},
"order": 22,
"mode": 0,
"inputs": [
{
"name": "samples",
"type": "LATENT",
"link": 35
},
{
"name": "vae",
"type": "VAE",
"link": 140
}
],
"outputs": [
{
"name": "IMAGE",
"type": "IMAGE",
"slot_index": 0,
"links": [
159
]
}
],
"properties": {
"cnr_id": "comfy-core",
"ver": "0.3.33",
"Node name for S&R": "VAEDecode"
}
},
{
"id": 82,
"type": "Reroute",
"pos": [
1138.7548217773438,
64.14635395192796
],
"size": [
75,
26
],
"flags": {},
"order": 9,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 149
}
],
"outputs": [
{
"name": "",
"type": "VAE",
"links": [
150
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 79,
"type": "Reroute",
"pos": [
1138.7548217773438,
-59.89911033344882
],
"size": [
75,
26
],
"flags": {},
"order": 8,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 139
}
],
"outputs": [
{
"name": "",
"type": "VAE",
"links": [
140
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 86,
"type": "ModelAttentionBackend",
"pos": [
559.0936845136185,
-207.9445746188256
],
"size": [
270,
58
],
"flags": {},
"order": 11,
"mode": 0,
"inputs": [
{
"name": "model",
"type": "MODEL",
"link": 163
}
],
"outputs": [
{
"name": "MODEL",
"type": "MODEL",
"links": [
164
]
}
],
"properties": {
"cnr_id": "comfy-core",
"ver": "0.34.0",
"Node name for S&R": "ModelAttentionBackend"
},
"widgets_values": [
"comfy kitchen attention"
],
"widgets_values_named": {
"attention": "comfy kitchen attention"
}
},
{
"id": 38,
"type": "CLIPLoader",
"pos": [
52.62317611836556,
188.1918182373047
],
"size": [
301.3524169921875,
106
],
"flags": {},
"order": 0,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "CLIP",
"type": "CLIP",
"slot_index": 0,
"links": [
192
]
}
],
"properties": {
"cnr_id": "comfy-core",
"ver": "0.3.33",
"Node name for S&R": "CLIPLoader"
},
"widgets_values": [
"qwen3vl_32b_minimax_h3_int8_convrot.safetensors",
"minimax",
"default"
],
"widgets_values_named": {
"clip_name": "qwen3vl_32b_minimax_h3_int8_convrot.safetensors",
"type": "minimax",
"device": "default"
},
"color": "#432",
"bgcolor": "#653"
},
{
"id": 39,
"type": "VAELoader",
"pos": [
52.62317611836556,
-59.89911033344882
],
"size": [
301.3524169921875,
58
],
"flags": {},
"order": 1,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "VAE",
"type": "VAE",
"slot_index": 0,
"links": [
139,
193
]
}
],
"properties": {
"cnr_id": "comfy-core",
"ver": "0.3.33",
"Node name for S&R": "VAELoader"
},
"widgets_values": [
"minimax_h3_video_vae_fp16.safetensors"
],
"widgets_values_named": {
"vae_name": "minimax_h3_video_vae_fp16.safetensors"
},
"color": "#322",
"bgcolor": "#533"
},
{
"id": 81,
"type": "VAELoader",
"pos": [
52.62317611836556,
64.14635395192796
],
"size": [
301.3524169921875,
58
],
"flags": {},
"order": 2,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "VAE",
"type": "VAE",
"slot_index": 0,
"links": [
149,
194
]
}
],
"properties": {
"cnr_id": "comfy-core",
"ver": "0.3.33",
"Node name for S&R": "VAELoader"
},
"widgets_values": [
"minimax_h3_audio_vae_fp32.safetensors"
],
"widgets_values_named": {
"vae_name": "minimax_h3_audio_vae_fp32.safetensors"
},
"color": "#322",
"bgcolor": "#533"
},
{
"id": 75,
"type": "ConditioningZeroOut",
"pos": [
610.6589994550249,
687.4058481340641
],
"size": [
218.4346850585937,
26
],
"flags": {},
"order": 20,
"mode": 0,
"inputs": [
{
"name": "conditioning",
"type": "CONDITIONING",
"link": 191
}
],
"outputs": [
{
"name": "CONDITIONING",
"type": "CONDITIONING",
"links": [
130
]
}
],
"properties": {
"cnr_id": "comfy-core",
"ver": "0.30.0",
"Node name for S&R": "ConditioningZeroOut"
}
},
{
"id": 99,
"type": "Reroute",
"pos": [
278.97559311055306,
352.8802091216946
],
"size": [
75,
26
],
"flags": {},
"order": 10,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 198
}
],
"outputs": [
{
"name": "",
"type": "IMAGE",
"links": [
195
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 123,
"type": "ResizeImageMaskNode",
"pos": [
-167.25870608263529,
473.4103556894062
],
"size": [
270,
106
],
"flags": {},
"order": 16,
"mode": 0,
"inputs": [
{
"name": "input",
"type": "IMAGE,MASK",
"link": 211
}
],
"outputs": [
{
"name": "resized",
"type": "IMAGE",
"links": [
215,
218,
221
]
}
],
"properties": {
"cnr_id": "comfy-core",
"ver": "0.34.0",
"Node name for S&R": "ResizeImageMaskNode"
},
"widgets_values": [
"scale to multiple",
32,
"bicubic"
],
"widgets_values_named": {
"resize_type": "scale to multiple",
"resize_type.multiple": 32,
"scale_method": "bicubic"
},
"color": "#233",
"bgcolor": "#355"
},
{
"id": 125,
"type": "Reroute",
"pos": [
278.97559311055306,
473.18847124312117
],
"size": [
75,
26
],
"flags": {},
"order": 18,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 221
}
],
"outputs": [
{
"name": "",
"type": "IMAGE",
"links": [
223
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 96,
"type": "LoadImage",
"pos": [
-1306.2488452286336,
363.3498185322165
],
"size": [
369.8098637230636,
662.9296573536006
],
"flags": {},
"order": 3,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "IMAGE",
"type": "IMAGE",
"links": [
198
]
},
{
"name": "MASK",
"type": "MASK",
"links": null
}
],
"properties": {
"cnr_id": "comfy-core",
"ver": "0.34.0",
"Node name for S&R": "LoadImage"
},
"widgets_values": [
"pexels-photo-15169599.jpg",
"image"
],
"widgets_values_named": {
"image": "pexels-photo-15169599.jpg",
"upload": "image"
},
"color": "#233",
"bgcolor": "#355"
},
{
"id": 3,
"type": "KSampler",
"pos": [
898.7548217773438,
188.1918182373047
],
"size": [
315,
262
],
"flags": {},
"order": 21,
"mode": 0,
"inputs": [
{
"name": "model",
"type": "MODEL",
"link": 164
},
{
"name": "positive",
"type": "CONDITIONING",
"link": 190
},
{
"name": "negative",
"type": "CONDITIONING",
"link": 130
},
{
"name": "latent_image",
"type": "LATENT",
"link": 189
}
],
"outputs": [
{
"name": "LATENT",
"type": "LATENT",
"slot_index": 0,
"links": [
35,
132
]
}
],
"properties": {
"cnr_id": "comfy-core",
"ver": "0.3.33",
"Node name for S&R": "KSampler"
},
"widgets_values": [
1234,
"fixed",
20,
1,
"euler",
"simple",
1
],
"widgets_values_named": {
"seed": 1234,
"control_after_generate": "fixed",
"steps": 20,
"cfg": 1,
"sampler_name": "euler",
"scheduler": "simple",
"denoise": 1
}
},
{
"id": 37,
"type": "UNETLoader",
"pos": [
218.55216245088812,
-207.9445746188256
],
"size": [
305.3782043457031,
82
],
"flags": {},
"order": 4,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "MODEL",
"type": "MODEL",
"slot_index": 0,
"links": [
163
]
}
],
"properties": {
"cnr_id": "comfy-core",
"ver": "0.3.33",
"Node name for S&R": "UNETLoader"
},
"widgets_values": [
"minimax_h3_ref2va_pruned_int8_convrot.safetensors",
"default"
],
"widgets_values_named": {
"unet_name": "minimax_h3_ref2va_pruned_int8_convrot.safetensors",
"weight_dtype": "default"
},
"color": "#323",
"bgcolor": "#535"
},
{
"id": 104,
"type": "ComfyMathExpression",
"pos": [
145.773025786573,
910.7312424233263
],
"size": [
210,
128
],
"flags": {},
"order": 13,
"mode": 0,
"inputs": [
{
"label": "a",
"name": "values.a",
"type": "FLOAT,INT,BOOLEAN",
"link": 182
},
{
"label": "b",
"name": "values.b",
"shape": 7,
"type": "FLOAT,INT,BOOLEAN",
"link": null
}
],
"outputs": [
{
"name": "FLOAT",
"type": "FLOAT",
"links": null
},
{
"name": "INT",
"type": "INT",
"links": [
188,
224
]
},
{
"name": "BOOL",
"type": "BOOLEAN",
"links": null
}
],
"properties": {
"cnr_id": "comfy-core",
"ver": "0.33.0",
"Node name for S&R": "ComfyMathExpression"
},
"widgets_values": [
"17 * round((a * 24 - 5) / 17) + 5"
],
"widgets_values_named": {
"expression": "17 * round((a * 24 - 5) / 17) + 5"
}
},
{
"id": 124,
"type": "GetImageSize",
"pos": [
145.773025786573,
717.8759071476413
],
"size": [
210,
136.58041135497615
],
"flags": {},
"order": 17,
"mode": 0,
"inputs": [
{
"name": "image",
"type": "IMAGE",
"link": 218
}
],
"outputs": [
{
"name": "width",
"type": "INT",
"links": [
219
]
},
{
"name": "height",
"type": "INT",
"links": [
220
]
},
{
"name": "batch_size",
"type": "INT",
"links": null
}
],
"properties": {
"cnr_id": "comfy-core",
"ver": "0.34.0",
"Node name for S&R": "GetImageSize"
}
},
{
"id": 127,
"type": "Reroute",
"pos": [
278.97559311055306,
608.3369912708454
],
"size": [
75,
26
],
"flags": {},
"order": 12,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 226
}
],
"outputs": [
{
"name": "",
"type": "*",
"links": [
227
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 120,
"type": "VHS_LoadVideo",
"pos": [
-848.8100218650059,
473.4103556894062
],
"size": [
354.8993996630419,
919.7104418520476
],
"flags": {},
"order": 14,
"mode": 0,
"inputs": [
{
"name": "meta_batch",
"shape": 7,
"type": "VHS_BatchManager",
"link": null
},
{
"name": "vae",
"shape": 7,
"type": "VAE",
"link": null
},
{
"name": "frame_load_cap",
"type": "INT",
"widget": {
"name": "frame_load_cap"
},
"link": 224
}
],
"outputs": [
{
"name": "IMAGE",
"type": "IMAGE",
"links": [
209
]
},
{
"name": "frame_count",
"type": "INT",
"links": null
},
{
"name": "audio",
"type": "AUDIO",
"links": []
},
{
"name": "video_info",
"type": "VHS_VIDEOINFO",
"links": null
}
],
"properties": {
"cnr_id": "comfyui-videohelpersuite",
"ver": "1.7.9",
"Node name for S&R": "VHS_LoadVideo"
},
"widgets_values": {
"video": "horse.mp4",
"force_rate": 24,
"custom_width": 0,
"custom_height": 0,
"frame_load_cap": 0,
"skip_first_frames": 0,
"select_every_nth": 1,
"format": "AnimateDiff",
"videopreview": {
"hidden": false,
"paused": false,
"params": {
"filename": "horse.mp4",
"type": "input",
"format": "video/mp4",
"force_rate": 24,
"custom_width": 0,
"custom_height": 0,
"frame_load_cap": 0,
"skip_first_frames": 0,
"select_every_nth": 1
}
}
},
"widgets_values_named": {
"video": "horse.mp4",
"force_rate": 24,
"custom_width": 0,
"custom_height": 0,
"frame_load_cap": 0,
"skip_first_frames": 0,
"select_every_nth": 1,
"format": "AnimateDiff",
"choose video to upload": null,
"videopreview": {
"hidden": false,
"paused": false,
"params": {
"filename": "horse.mp4",
"type": "input",
"format": "video/mp4",
"force_rate": 24,
"custom_width": 0,
"custom_height": 0,
"frame_load_cap": 0,
"skip_first_frames": 0,
"select_every_nth": 1
}
}
},
"color": "#233",
"bgcolor": "#355"
},
{
"id": 126,
"type": "Reroute",
"pos": [
-465.58466414229963,
608.3369912708454
],
"size": [
75,
26
],
"flags": {},
"order": 5,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": null
}
],
"outputs": [
{
"name": "",
"type": "*",
"links": [
226
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 108,
"type": "MiniMaxH3ReferenceToVideo",
"pos": [
426.3652074439484,
188.1918182373047
],
"size": [
405.4147896605257,
443.39272420969405
],
"flags": {},
"order": 19,
"mode": 0,
"inputs": [
{
"name": "clip",
"type": "CLIP",
"link": 192
},
{
"name": "vae",
"type": "VAE",
"link": 193
},
{
"name": "audio_vae",
"type": "VAE",
"link": 194
},
{
"name": "ref_images.ref_image_0",
"shape": 7,
"type": "IMAGE",
"link": 195
},
{
"label": "ref_image_1",
"name": "ref_images.ref_image_1",
"shape": 7,
"type": "IMAGE",
"link": null
},
{
"name": "ref_videos.ref_video_0",
"shape": 7,
"type": "IMAGE",
"link": 223
},
{
"label": "ref_video_1",
"name": "ref_videos.ref_video_1",
"shape": 7,
"type": "IMAGE",
"link": null
},
{
"name": "ref_video_audios.ref_video_audio_0",
"shape": 7,
"type": "AUDIO",
"link": 227
},
{
"label": "ref_video_audio_1",
"name": "ref_video_audios.ref_video_audio_1",
"shape": 7,
"type": "AUDIO",
"link": null
},
{
"name": "ref_audios.ref_audio_0",
"shape": 7,
"type": "AUDIO",
"link": null
},
{
"name": "width",
"type": "INT",
"widget": {
"name": "width"
},
"link": 219
},
{
"name": "height",
"type": "INT",
"widget": {
"name": "height"
},
"link": 220
},
{
"name": "length",
"type": "INT",
"widget": {
"name": "length"
},
"link": 188
},
{
"name": "ref_videos.ref_video_2",
"shape": 7,
"type": "IMAGE",
"link": null
}
],
"outputs": [
{
"name": "positive",
"type": "CONDITIONING",
"links": [
190,
191
]
},
{
"name": "LATENT",
"type": "LATENT",
"links": [
189
]
}
],
"properties": {
"cnr_id": "comfy-core",
"ver": "0.34.0",
"Node name for S&R": "MiniMaxH3ReferenceToVideo"
},
"widgets_values": [
"subject_definitions:\n<Subject 1> is the woman in <Picture 1>, preserving her identity, face, hairstyle, makeup, black blazer, and black-and-white patterned top. Complete her lower body as tailored black suit trousers and black loafers.\n\nsummary:\n[video editing] Replace the male horse rider in <Video 1> with <Subject 1>.\n\nretention_analysis:\n<Subject 1> (appears in [Shot 1]): fully_preserved - preserve her identity and outfit style from <Picture 1>.\n<Video 1> (appears in [Shot 1]): fully_preserved - preserve the horse, riding motion, camera work, lighting, environment, and overall scene continuity.\n\ndetailed_description:\n[Shot 1] Replace the original male rider in <Video 1> completely with <Subject 1>. She rides the same horse in the same position and follows the same riding motion and timing. Her appearance matches <Picture 1>, and her full outfit is a black blazer, black-and-white patterned top, tailored black suit trousers, and black loafers. Preserve the original horse, camera, framing, lighting, and background exactly.\n\noverall_soundscape:\nPreserve the original soundscape from <Video 1>.\n\nnon_diegetic_music:\nPreserve the original music from <Video 1>, or N/A if none.",
1344,
768,
124,
"match"
],
"widgets_values_named": {
"prompt": "subject_definitions:\n<Subject 1> is the woman in <Picture 1>, preserving her identity, face, hairstyle, makeup, black blazer, and black-and-white patterned top. Complete her lower body as tailored black suit trousers and black loafers.\n\nsummary:\n[video editing] Replace the male horse rider in <Video 1> with <Subject 1>.\n\nretention_analysis:\n<Subject 1> (appears in [Shot 1]): fully_preserved - preserve her identity and outfit style from <Picture 1>.\n<Video 1> (appears in [Shot 1]): fully_preserved - preserve the horse, riding motion, camera work, lighting, environment, and overall scene continuity.\n\ndetailed_description:\n[Shot 1] Replace the original male rider in <Video 1> completely with <Subject 1>. She rides the same horse in the same position and follows the same riding motion and timing. Her appearance matches <Picture 1>, and her full outfit is a black blazer, black-and-white patterned top, tailored black suit trousers, and black loafers. Preserve the original horse, camera, framing, lighting, and background exactly.\n\noverall_soundscape:\nPreserve the original soundscape from <Video 1>.\n\nnon_diegetic_music:\nPreserve the original music from <Video 1>, or N/A if none.",
"width": 1344,
"height": 768,
"length": 124,
"ref_image_size": "match"
},
"color": "#233",
"bgcolor": "#355"
},
{
"id": 106,
"type": "PrimitiveFloat",
"pos": [
-100.91059743661,
910.7312424233263
],
"size": [
214.65850806503283,
58
],
"flags": {},
"order": 6,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "FLOAT",
"type": "FLOAT",
"links": [
182
]
}
],
"title": "Float: Duration (sec)",
"properties": {
"cnr_id": "comfy-core",
"ver": "0.34.0",
"Node name for S&R": "PrimitiveFloat"
},
"widgets_values": [
6
],
"widgets_values_named": {
"value": 6
}
},
{
"id": 121,
"type": "ResizeImageMaskNode",
"pos": [
-465.58466414229963,
473.4103556894062
],
"size": [
270,
106
],
"flags": {},
"order": 15,
"mode": 0,
"inputs": [
{
"name": "input",
"type": "IMAGE,MASK",
"link": 209
}
],
"outputs": [
{
"name": "resized",
"type": "IMAGE",
"links": [
211
]
}
],
"properties": {
"cnr_id": "comfy-core",
"ver": "0.34.0",
"Node name for S&R": "ResizeImageMaskNode"
},
"widgets_values": [
"scale total pixels",
1,
"bicubic"
],
"widgets_values_named": {
"resize_type": "scale total pixels",
"resize_type.megapixels": 1,
"scale_method": "bicubic"
},
"color": "#233",
"bgcolor": "#355"
},
{
"id": 95,
"type": "MarkdownNote",
"pos": [
-482.3943342566212,
-207.9445746188256
],
"size": [
480.26512898835654,
314.3204118484383
],
"flags": {},
"order": 7,
"mode": 0,
"inputs": [],
"outputs": [],
"properties": {},
"widgets_values": [
"## models\n- diffusion_models\n - [minimax_h3_ref2va_pruned_int8_convrot.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/diffusion_models/minimax_h3_ref2va_pruned_int8_convrot.safetensors) (21 GB)\n- text_encoders\n - [qwen3vl_32b_minimax_h3_int8_convrot.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/text_encoders/qwen3vl_32b_minimax_h3_int8_convrot.safetensors) (27.1 GB)\n- vae\n - [minimax_h3_audio_vae_fp32.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/vae/minimax_h3_audio_vae_fp32.safetensors) (605 MB)\n - [minimax_h3_video_vae_fp16.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/vae/minimax_h3_video_vae_fp16.safetensors) (5.21 GB)\n\n```text\n📂ComfyUI/\n└── 📂models/\n ├── 📂diffusion_models/\n │ └── minimax_h3_ref2va_pruned_int8_convrot.safetensors\n ├── 📂text_encoders/\n │ └── qwen3vl_32b_minimax_h3_int8_convrot.safetensors\n └── 📂vae/\n ├── minimax_h3_audio_vae_fp32.safetensors\n └── minimax_h3_video_vae_fp16.safetensors\n```"
],
"widgets_values_named": {
"text": "## models\n- diffusion_models\n - [minimax_h3_ref2va_pruned_int8_convrot.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/diffusion_models/minimax_h3_ref2va_pruned_int8_convrot.safetensors) (21 GB)\n- text_encoders\n - [qwen3vl_32b_minimax_h3_int8_convrot.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/text_encoders/qwen3vl_32b_minimax_h3_int8_convrot.safetensors) (27.1 GB)\n- vae\n - [minimax_h3_audio_vae_fp32.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/vae/minimax_h3_audio_vae_fp32.safetensors) (605 MB)\n - [minimax_h3_video_vae_fp16.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/vae/minimax_h3_video_vae_fp16.safetensors) (5.21 GB)\n\n```text\n📂ComfyUI/\n└── 📂models/\n ├── 📂diffusion_models/\n │ └── minimax_h3_ref2va_pruned_int8_convrot.safetensors\n ├── 📂text_encoders/\n │ └── qwen3vl_32b_minimax_h3_int8_convrot.safetensors\n └── 📂vae/\n ├── minimax_h3_audio_vae_fp32.safetensors\n └── minimax_h3_video_vae_fp16.safetensors\n```"
},
"color": "#323",
"bgcolor": "#535"
},
{
"id": 92,
"type": "SaveVideo",
"pos": [
1855.5764904027374,
188.1918182373047
],
"size": [
497.7157105933684,
921.8941904090992
],
"flags": {},
"order": 25,
"mode": 0,
"inputs": [
{
"name": "video",
"type": "VIDEO",
"link": 158
}
],
"outputs": [
{
"name": "video",
"type": "VIDEO",
"links": null
}
],
"properties": {
"cnr_id": "comfy-core",
"ver": "0.33.0"
},
"widgets_values": [
"video/ComfyUI",
"auto",
"auto",
"auto"
],
"widgets_values_named": {
"filename_prefix": "video/ComfyUI",
"format": "auto",
"format.codec": "auto",
"codec": "auto"
}
}
],
"links": [
[
35,
3,
0,
8,
0,
"LATENT"
],
[
130,
75,
0,
3,
2,
"CONDITIONING"
],
[
132,
3,
0,
77,
0,
"LATENT"
],
[
139,
39,
0,
79,
0,
"VAE"
],
[
140,
79,
0,
8,
1,
"VAE"
],
[
149,
81,
0,
82,
0,
"VAE"
],
[
150,
82,
0,
77,
1,
"VAE"
],
[
158,
91,
0,
92,
0,
"VIDEO"
],
[
159,
8,
0,
91,
0,
"IMAGE"
],
[
160,
77,
0,
91,
1,
"AUDIO"
],
[
163,
37,
0,
86,
0,
"MODEL"
],
[
164,
86,
0,
3,
0,
"MODEL"
],
[
182,
106,
0,
104,
0,
"FLOAT"
],
[
188,
104,
1,
108,
12,
"INT"
],
[
189,
108,
1,
3,
3,
"LATENT"
],
[
190,
108,
0,
3,
1,
"CONDITIONING"
],
[
191,
108,
0,
75,
0,
"CONDITIONING"
],
[
192,
38,
0,
108,
0,
"CLIP"
],
[
193,
39,
0,
108,
1,
"VAE"
],
[
194,
81,
0,
108,
2,
"VAE"
],
[
195,
99,
0,
108,
3,
"IMAGE"
],
[
198,
96,
0,
99,
0,
"IMAGE"
],
[
209,
120,
0,
121,
0,
"IMAGE"
],
[
211,
121,
0,
123,
0,
"IMAGE"
],
[
215,
123,
0,
108,
6,
"IMAGE"
],
[
218,
123,
0,
124,
0,
"IMAGE"
],
[
219,
124,
0,
108,
10,
"INT"
],
[
220,
124,
1,
108,
11,
"INT"
],
[
221,
123,
0,
125,
0,
"IMAGE"
],
[
223,
125,
0,
108,
5,
"IMAGE"
],
[
224,
104,
1,
120,
2,
"INT"
],
[
226,
126,
0,
127,
0,
"AUDIO"
],
[
227,
127,
0,
108,
7,
"AUDIO"
]
],
"groups": [],
"config": {},
"extra": {
"ds": {
"scale": 0.43056764313425877,
"offset": [
1766.4214840264067,
863.4420263451012
]
},
"frontendVersion": "1.49.6",
"VHS_latentpreview": false,
"VHS_latentpreviewrate": 0,
"VHS_MetadataImage": true,
"VHS_KeepIntermediate": true
},
"version": 0.4
}
工作流基本上与 Reference Generation 相同。
只需把视频作为参考输入,再用提示词对它下达“删除人物”“改变画风”等指令。
输出示例
空间 Inpainting
使用模型:均可
H3 也可以使用传统的(?)遮罩,只重新绘制指定区域来进行 inpainting。
不过,即使不这样做,也可以直接在 Video Editing 中指示“把〇〇改成△△”,所以可能没有太多使用场景……
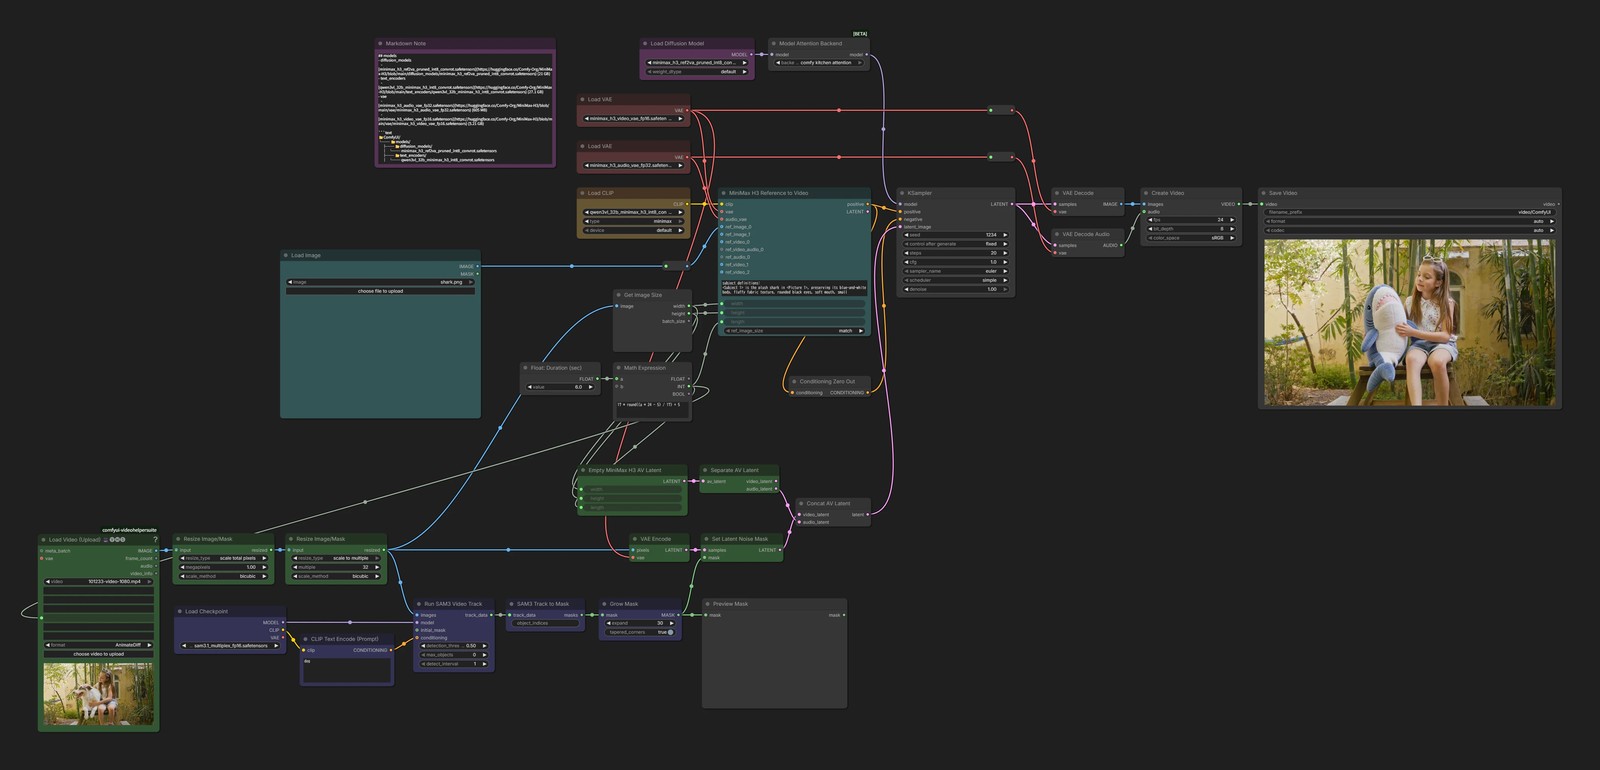
{
"id": "4a435654-65ee-4ef4-b100-eb2e567ae9f8",
"revision": 0,
"last_node_id": 152,
"last_link_id": 262,
"nodes": [
{
"id": 77,
"type": "VAEDecodeAudio",
"pos": [
1308.6980183050962,
296.9762089835968
],
"size": [
194.25299723441972,
46
],
"flags": {},
"order": 31,
"mode": 0,
"inputs": [
{
"name": "samples",
"type": "LATENT",
"link": 132
},
{
"name": "vae",
"type": "VAE",
"link": 150
}
],
"outputs": [
{
"name": "AUDIO",
"type": "AUDIO",
"links": [
160
]
}
],
"properties": {
"Node name for S&R": "VAEDecodeAudio",
"cnr_id": "comfy-core",
"ver": "0.30.0"
}
},
{
"id": 91,
"type": "CreateVideo",
"pos": [
1544.2637529711267,
188.1918182373047
],
"size": [
270,
126
],
"flags": {},
"order": 32,
"mode": 0,
"inputs": [
{
"name": "images",
"type": "IMAGE",
"link": 159
},
{
"name": "audio",
"shape": 7,
"type": "AUDIO",
"link": 160
}
],
"outputs": [
{
"name": "VIDEO",
"type": "VIDEO",
"links": [
158
]
}
],
"properties": {
"Node name for S&R": "CreateVideo",
"cnr_id": "comfy-core",
"ver": "0.33.0"
},
"widgets_values": [
24,
8,
"sRGB"
],
"widgets_values_named": {
"fps": 24,
"bit_depth": 8,
"color_space": "sRGB"
}
},
{
"id": 8,
"type": "VAEDecode",
"pos": [
1308.6980183050962,
188.1918182373047
],
"size": [
194.25299723441972,
46
],
"flags": {},
"order": 30,
"mode": 0,
"inputs": [
{
"name": "samples",
"type": "LATENT",
"link": 35
},
{
"name": "vae",
"type": "VAE",
"link": 140
}
],
"outputs": [
{
"name": "IMAGE",
"type": "IMAGE",
"slot_index": 0,
"links": [
159
]
}
],
"properties": {
"Node name for S&R": "VAEDecode",
"cnr_id": "comfy-core",
"ver": "0.3.33"
}
},
{
"id": 82,
"type": "Reroute",
"pos": [
1138.7548217773438,
64.14635395192796
],
"size": [
75,
26
],
"flags": {},
"order": 8,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 149
}
],
"outputs": [
{
"name": "",
"type": "VAE",
"links": [
150
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 86,
"type": "ModelAttentionBackend",
"pos": [
559.0936845136185,
-207.9445746188256
],
"size": [
270,
58
],
"flags": {},
"order": 9,
"mode": 0,
"inputs": [
{
"name": "model",
"type": "MODEL",
"link": 163
}
],
"outputs": [
{
"name": "model",
"type": "MODEL",
"links": [
164
]
}
],
"properties": {
"Node name for S&R": "ModelAttentionBackend"
},
"widgets_values": [
"comfy kitchen attention"
],
"widgets_values_named": {
"attention": "comfy kitchen attention"
}
},
{
"id": 38,
"type": "CLIPLoader",
"pos": [
52.62317611836556,
188.1918182373047
],
"size": [
301.3524169921875,
106
],
"flags": {},
"order": 0,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "CLIP",
"type": "CLIP",
"slot_index": 0,
"links": [
192
]
}
],
"properties": {
"Node name for S&R": "CLIPLoader",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
"qwen3vl_32b_minimax_h3_int8_convrot.safetensors",
"minimax",
"default"
],
"widgets_values_named": {
"clip_name": "qwen3vl_32b_minimax_h3_int8_convrot.safetensors",
"type": "minimax",
"device": "default"
},
"color": "#432",
"bgcolor": "#653"
},
{
"id": 81,
"type": "VAELoader",
"pos": [
52.62317611836556,
64.14635395192796
],
"size": [
301.3524169921875,
58
],
"flags": {},
"order": 1,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "VAE",
"type": "VAE",
"slot_index": 0,
"links": [
149,
194
]
}
],
"properties": {
"Node name for S&R": "VAELoader",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
"minimax_h3_audio_vae_fp32.safetensors"
],
"widgets_values_named": {
"vae_name": "minimax_h3_audio_vae_fp32.safetensors"
},
"color": "#322",
"bgcolor": "#533"
},
{
"id": 75,
"type": "ConditioningZeroOut",
"pos": [
613.3453120458804,
687.4058481340641
],
"size": [
218.4346850585937,
26
],
"flags": {},
"order": 23,
"mode": 0,
"inputs": [
{
"name": "conditioning",
"type": "CONDITIONING",
"link": 191
}
],
"outputs": [
{
"name": "CONDITIONING",
"type": "CONDITIONING",
"links": [
130
]
}
],
"properties": {
"Node name for S&R": "ConditioningZeroOut",
"cnr_id": "comfy-core",
"ver": "0.30.0"
}
},
{
"id": 3,
"type": "KSampler",
"pos": [
898.7548217773438,
188.1918182373047
],
"size": [
315,
262
],
"flags": {},
"order": 29,
"mode": 0,
"inputs": [
{
"name": "model",
"type": "MODEL",
"link": 164
},
{
"name": "positive",
"type": "CONDITIONING",
"link": 190
},
{
"name": "negative",
"type": "CONDITIONING",
"link": 130
},
{
"name": "latent_image",
"type": "LATENT",
"link": 250
}
],
"outputs": [
{
"name": "LATENT",
"type": "LATENT",
"slot_index": 0,
"links": [
35,
132
]
}
],
"properties": {
"Node name for S&R": "KSampler",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
1234,
"fixed",
20,
1,
"euler",
"simple",
1
],
"widgets_values_named": {
"seed": 1234,
"control_after_generate": "fixed",
"steps": 20,
"cfg": 1,
"sampler_name": "euler",
"scheduler": "simple",
"denoise": 1
}
},
{
"id": 37,
"type": "UNETLoader",
"pos": [
218.55216245088812,
-207.9445746188256
],
"size": [
305.3782043457031,
82
],
"flags": {},
"order": 2,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "MODEL",
"type": "MODEL",
"slot_index": 0,
"links": [
163
]
}
],
"properties": {
"Node name for S&R": "UNETLoader",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
"minimax_h3_ref2va_pruned_int8_convrot.safetensors",
"default"
],
"widgets_values_named": {
"unet_name": "minimax_h3_ref2va_pruned_int8_convrot.safetensors",
"weight_dtype": "default"
},
"color": "#323",
"bgcolor": "#535"
},
{
"id": 106,
"type": "PrimitiveFloat",
"pos": [
-98.28860660001553,
650.6703717621782
],
"size": [
214.65850806503283,
58
],
"flags": {},
"order": 3,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "FLOAT",
"type": "FLOAT",
"links": [
182
]
}
],
"title": "Float: Duration (sec)",
"properties": {
"Node name for S&R": "PrimitiveFloat"
},
"widgets_values": [
6
],
"widgets_values_named": {
"value": 6
}
},
{
"id": 95,
"type": "MarkdownNote",
"pos": [
-482.3943342566212,
-207.9445746188256
],
"size": [
480.26512898835654,
314.3204118484383
],
"flags": {},
"order": 4,
"mode": 0,
"inputs": [],
"outputs": [],
"properties": {},
"widgets_values": [
"## models\n- diffusion_models\n - [minimax_h3_ref2va_pruned_int8_convrot.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/diffusion_models/minimax_h3_ref2va_pruned_int8_convrot.safetensors) (21 GB)\n- text_encoders\n - [qwen3vl_32b_minimax_h3_int8_convrot.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/text_encoders/qwen3vl_32b_minimax_h3_int8_convrot.safetensors) (27.1 GB)\n- vae\n - [minimax_h3_audio_vae_fp32.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/vae/minimax_h3_audio_vae_fp32.safetensors) (605 MB)\n - [minimax_h3_video_vae_fp16.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/vae/minimax_h3_video_vae_fp16.safetensors) (5.21 GB)\n\n```text\n📂ComfyUI/\n└── 📂models/\n ├── 📂diffusion_models/\n │ └── minimax_h3_ref2va_pruned_int8_convrot.safetensors\n ├── 📂text_encoders/\n │ └── qwen3vl_32b_minimax_h3_int8_convrot.safetensors\n └── 📂vae/\n ├── minimax_h3_audio_vae_fp32.safetensors\n └── minimax_h3_video_vae_fp16.safetensors\n```"
],
"widgets_values_named": {
"text": "## models\n- diffusion_models\n - [minimax_h3_ref2va_pruned_int8_convrot.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/diffusion_models/minimax_h3_ref2va_pruned_int8_convrot.safetensors) (21 GB)\n- text_encoders\n - [qwen3vl_32b_minimax_h3_int8_convrot.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/text_encoders/qwen3vl_32b_minimax_h3_int8_convrot.safetensors) (27.1 GB)\n- vae\n - [minimax_h3_audio_vae_fp32.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/vae/minimax_h3_audio_vae_fp32.safetensors) (605 MB)\n - [minimax_h3_video_vae_fp16.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/vae/minimax_h3_video_vae_fp16.safetensors) (5.21 GB)\n\n```text\n📂ComfyUI/\n└── 📂models/\n ├── 📂diffusion_models/\n │ └── minimax_h3_ref2va_pruned_int8_convrot.safetensors\n ├── 📂text_encoders/\n │ └── qwen3vl_32b_minimax_h3_int8_convrot.safetensors\n └── 📂vae/\n ├── minimax_h3_audio_vae_fp32.safetensors\n └── minimax_h3_video_vae_fp16.safetensors\n```"
},
"color": "#323",
"bgcolor": "#535"
},
{
"id": 136,
"type": "CheckpointLoaderSimple",
"pos": [
-1013.0911505833631,
1295.7310016153485
],
"size": [
297.3094587159344,
98
],
"flags": {},
"order": 5,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "MODEL",
"type": "MODEL",
"links": [
235
]
},
{
"name": "CLIP",
"type": "CLIP",
"links": [
233
]
},
{
"name": "VAE",
"type": "VAE",
"links": null
}
],
"properties": {
"Node name for S&R": "CheckpointLoaderSimple",
"cnr_id": "comfy-core",
"ver": "0.19.3"
},
"widgets_values": [
"sam3.1_multiplex_fp16.safetensors"
],
"widgets_values_named": {
"ckpt_name": "sam3.1_multiplex_fp16.safetensors"
},
"color": "#223",
"bgcolor": "#335"
},
{
"id": 123,
"type": "ResizeImageMaskNode",
"pos": [
-718.9883075199052,
1104.06055049653
],
"size": [
270,
106
],
"flags": {},
"order": 16,
"mode": 0,
"inputs": [
{
"name": "input",
"type": "IMAGE,MASK",
"link": 211
}
],
"outputs": [
{
"name": "resized",
"type": "IMAGE",
"links": [
215,
218,
238,
242
]
}
],
"properties": {
"Node name for S&R": "ResizeImageMaskNode"
},
"widgets_values": [
"scale to multiple",
32,
"bicubic"
],
"widgets_values_named": {
"resize_type": "scale to multiple",
"resize_type.multiple": 32,
"scale_method": "bicubic"
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 39,
"type": "VAELoader",
"pos": [
52.62317611836556,
-59.89911033344882
],
"size": [
301.3524169921875,
58
],
"flags": {},
"order": 6,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "VAE",
"type": "VAE",
"slot_index": 0,
"links": [
139,
193,
243
]
}
],
"properties": {
"Node name for S&R": "VAELoader",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
"minimax_h3_video_vae_fp16.safetensors"
],
"widgets_values_named": {
"vae_name": "minimax_h3_video_vae_fp16.safetensors"
},
"color": "#322",
"bgcolor": "#533"
},
{
"id": 139,
"type": "VAEEncode",
"pos": [
191.3694919516222,
1104.06055049653
],
"size": [
160.189426262413,
46
],
"flags": {},
"order": 19,
"mode": 0,
"inputs": [
{
"name": "pixels",
"type": "IMAGE",
"link": 242
},
{
"name": "vae",
"type": "VAE",
"link": 243
}
],
"outputs": [
{
"name": "LATENT",
"type": "LATENT",
"links": [
244
]
}
],
"properties": {
"Node name for S&R": "VAEEncode"
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 134,
"type": "CLIPTextEncode",
"pos": [
-680.455921025271,
1369.423438818407
],
"size": [
250.42005327504967,
109.84222389181082
],
"flags": {},
"order": 11,
"mode": 0,
"inputs": [
{
"name": "clip",
"type": "CLIP",
"link": 233
}
],
"outputs": [
{
"name": "CONDITIONING",
"type": "CONDITIONING",
"links": [
236
]
}
],
"properties": {
"Node name for S&R": "CLIPTextEncode",
"cnr_id": "comfy-core",
"ver": "0.19.3"
},
"widgets_values": [
"dog"
],
"widgets_values_named": {
"text": "dog"
},
"color": "#223",
"bgcolor": "#335"
},
{
"id": 79,
"type": "Reroute",
"pos": [
1138.7548217773438,
-59.89911033344882
],
"size": [
75,
26
],
"flags": {},
"order": 12,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 139
}
],
"outputs": [
{
"name": "",
"type": "VAE",
"links": [
140
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 99,
"type": "Reroute",
"pos": [
278.97559311055306,
352.8802091216946
],
"size": [
75,
26
],
"flags": {},
"order": 13,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 198
}
],
"outputs": [
{
"name": "",
"type": "IMAGE",
"links": [
195
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 108,
"type": "MiniMaxH3ReferenceToVideo",
"pos": [
426.3652074439484,
188.1918182373047
],
"size": [
405.4147896605257,
364
],
"flags": {},
"order": 20,
"mode": 0,
"inputs": [
{
"name": "clip",
"type": "CLIP",
"link": 192
},
{
"name": "vae",
"shape": 7,
"type": "VAE",
"link": 193
},
{
"name": "audio_vae",
"shape": 7,
"type": "VAE",
"link": 194
},
{
"name": "ref_images.ref_image_0",
"shape": 7,
"type": "IMAGE",
"link": 195
},
{
"name": "ref_images.ref_image_1",
"shape": 7,
"type": "IMAGE",
"link": null
},
{
"name": "ref_videos.ref_video_0",
"shape": 7,
"type": "IMAGE",
"link": null
},
{
"name": "ref_video_audios.ref_video_audio_0",
"shape": 7,
"type": "AUDIO",
"link": null
},
{
"name": "ref_audios.ref_audio_0",
"shape": 7,
"type": "AUDIO",
"link": null
},
{
"name": "width",
"type": "INT",
"widget": {
"name": "width"
},
"link": 219
},
{
"name": "height",
"type": "INT",
"widget": {
"name": "height"
},
"link": 220
},
{
"name": "length",
"type": "INT",
"widget": {
"name": "length"
},
"link": 188
},
{
"name": "ref_videos.ref_video_1",
"shape": 7,
"type": "IMAGE",
"link": null
},
{
"name": "ref_videos.ref_video_2",
"shape": 7,
"type": "IMAGE",
"link": null
}
],
"outputs": [
{
"name": "positive",
"type": "CONDITIONING",
"links": [
190,
191
]
},
{
"name": "LATENT",
"type": "LATENT",
"links": []
}
],
"properties": {
"Node name for S&R": "MiniMaxH3ReferenceToVideo"
},
"widgets_values": [
"subject_definitions:\n<Subject 1> is the plush shark in <Picture 1>, preserving its blue-and-white body, fluffy fabric texture, rounded black eyes, soft mouth, small triangular teeth, fins, and oversized stuffed-toy proportions.\n\nsummary:\n[reference generation] The target video shows the girl holding and hugging <Subject 1>.\n\nretention_analysis:\n<Subject 1> (appears in [Shot 1]): fully_preserved - preserve the plush shark's appearance, proportions, colors, and soft stuffed-animal texture from <Picture 1>.\n\ndetailed_description:\n[Shot 1] <Subject 1> is held naturally in the girl's arms. She hugs the large plush shark closely and affectionately while sitting. The plush shark follows her arm and body movement naturally, with soft fabric deformation where she holds it, and fits naturally into the scene's lighting, scale, perspective, and motion.\n\noverall_soundscape:\nN/A\n\nnon_diegetic_music:\nN/A",
1344,
768,
124,
"match"
],
"widgets_values_named": {
"prompt": "subject_definitions:\n<Subject 1> is the plush shark in <Picture 1>, preserving its blue-and-white body, fluffy fabric texture, rounded black eyes, soft mouth, small triangular teeth, fins, and oversized stuffed-toy proportions.\n\nsummary:\n[reference generation] The target video shows the girl holding and hugging <Subject 1>.\n\nretention_analysis:\n<Subject 1> (appears in [Shot 1]): fully_preserved - preserve the plush shark's appearance, proportions, colors, and soft stuffed-animal texture from <Picture 1>.\n\ndetailed_description:\n[Shot 1] <Subject 1> is held naturally in the girl's arms. She hugs the large plush shark closely and affectionately while sitting. The plush shark follows her arm and body movement naturally, with soft fabric deformation where she holds it, and fits naturally into the scene's lighting, scale, perspective, and motion.\n\noverall_soundscape:\nN/A\n\nnon_diegetic_music:\nN/A",
"width": 1344,
"height": 768,
"length": 124,
"ref_image_size": "match"
},
"color": "#233",
"bgcolor": "#355"
},
{
"id": 137,
"type": "SAM3_TrackToMask",
"pos": [
-135.0334312374145,
1276.3710016153482
],
"size": [
210,
58
],
"flags": {},
"order": 22,
"mode": 0,
"inputs": [
{
"label": "track_data",
"name": "track_data",
"type": "SAM3_TRACK_DATA",
"link": 237
}
],
"outputs": [
{
"name": "masks",
"type": "MASK",
"links": [
246
]
}
],
"properties": {
"Node name for S&R": "SAM3_TrackToMask",
"cnr_id": "comfy-core",
"ver": "0.19.3"
},
"widgets_values": [
""
],
"widgets_values_named": {
"object_indices": ""
},
"color": "#223",
"bgcolor": "#335"
},
{
"id": 124,
"type": "GetImageSize",
"pos": [
148.39501662316744,
457.8150364864918
],
"size": [
210,
136.58041135497615
],
"flags": {},
"order": 17,
"mode": 0,
"inputs": [
{
"name": "image",
"type": "IMAGE",
"link": 218
}
],
"outputs": [
{
"name": "width",
"type": "INT",
"links": [
219,
257
]
},
{
"name": "height",
"type": "INT",
"links": [
220,
258
]
},
{
"name": "batch_size",
"type": "INT",
"links": null
}
],
"properties": {
"Node name for S&R": "GetImageSize"
},
"widgets_values": [],
"widgets_values_named": {}
},
{
"id": 104,
"type": "ComfyMathExpression",
"pos": [
148.39501662316744,
650.6703717621782
],
"size": [
210,
128
],
"flags": {},
"order": 10,
"mode": 0,
"inputs": [
{
"label": "a",
"name": "values.a",
"type": "FLOAT,INT,BOOLEAN",
"link": 182
},
{
"name": "values.b",
"shape": 7,
"type": "FLOAT,INT,BOOLEAN",
"link": null
}
],
"outputs": [
{
"name": "FLOAT",
"type": "FLOAT",
"links": null
},
{
"name": "INT",
"type": "INT",
"links": [
188,
224,
259
]
},
{
"name": "BOOL",
"type": "BOOLEAN",
"links": null
}
],
"properties": {
"Node name for S&R": "ComfyMathExpression",
"cnr_id": "comfy-core",
"ver": "0.33.0"
},
"widgets_values": [
"17 * round((a * 24 - 5) / 17) + 5"
],
"widgets_values_named": {
"expression": "17 * round((a * 24 - 5) / 17) + 5"
}
},
{
"id": 140,
"type": "GrowMask",
"pos": [
110.6365455323044,
1276.3710016153482
],
"size": [
220.2165167995529,
82
],
"flags": {},
"order": 25,
"mode": 0,
"inputs": [
{
"name": "mask",
"type": "MASK",
"link": 246
}
],
"outputs": [
{
"name": "MASK",
"type": "MASK",
"links": [
247,
248
]
}
],
"properties": {
"Node name for S&R": "GrowMask"
},
"widgets_values": [
30,
true
],
"widgets_values_named": {
"expand": 30,
"tapered_corners": true
},
"color": "#223",
"bgcolor": "#335"
},
{
"id": 92,
"type": "SaveVideo",
"pos": [
1855.5764904027374,
188.1918182373047
],
"size": [
805.3487345300787,
545.4159636278215
],
"flags": {},
"order": 33,
"mode": 0,
"inputs": [
{
"name": "video",
"type": "VIDEO",
"link": 158
}
],
"outputs": [
{
"name": "video",
"type": "VIDEO",
"links": null
}
],
"properties": {
"cnr_id": "comfy-core",
"ver": "0.33.0"
},
"widgets_values": [
"video/ComfyUI",
"auto",
"auto",
"auto"
],
"widgets_values_named": {
"filename_prefix": "video/ComfyUI",
"format": "auto",
"format.codec": "auto",
"codec": "auto"
}
},
{
"id": 151,
"type": "LTXVSeparateAVLatent",
"pos": [
377.2686192554718,
921.7087401578723
],
"size": [
211.85817501477655,
46
],
"flags": {},
"order": 24,
"mode": 0,
"inputs": [
{
"name": "av_latent",
"type": "LATENT",
"link": 261
}
],
"outputs": [
{
"name": "video_latent",
"type": "LATENT",
"links": null
},
{
"name": "audio_latent",
"type": "LATENT",
"links": [
262
]
}
],
"properties": {
"Node name for S&R": "LTXVSeparateAVLatent"
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 150,
"type": "EmptyMiniMaxH3LatentAV",
"pos": [
54.25366564220329,
921.7087401578723
],
"size": [
292.1197265625,
106
],
"flags": {},
"order": 21,
"mode": 0,
"inputs": [
{
"name": "width",
"type": "INT",
"widget": {
"name": "width"
},
"link": 257
},
{
"name": "height",
"type": "INT",
"widget": {
"name": "height"
},
"link": 258
},
{
"name": "length",
"type": "INT",
"widget": {
"name": "length"
},
"link": 259
}
],
"outputs": [
{
"name": "LATENT",
"type": "LATENT",
"links": [
261
]
}
],
"properties": {
"Node name for S&R": "EmptyMiniMaxH3LatentAV"
},
"widgets_values": [
1344,
768,
124
],
"widgets_values_named": {
"width": 1344,
"height": 768,
"length": 124
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 135,
"type": "SAM3_VideoTrack",
"pos": [
-380.2041163401462,
1276.3710016153482
],
"size": [
215.80859375,
166
],
"flags": {},
"order": 18,
"mode": 0,
"inputs": [
{
"label": "images",
"name": "images",
"type": "IMAGE",
"link": 238
},
{
"label": "model",
"name": "model",
"type": "MODEL",
"link": 235
},
{
"label": "initial_mask",
"name": "initial_mask",
"shape": 7,
"type": "MASK",
"link": null
},
{
"label": "conditioning",
"name": "conditioning",
"shape": 7,
"type": "CONDITIONING",
"link": 236
}
],
"outputs": [
{
"name": "track_data",
"type": "SAM3_TRACK_DATA",
"links": [
237
]
}
],
"properties": {
"Node name for S&R": "SAM3_VideoTrack",
"cnr_id": "comfy-core",
"ver": "0.19.3"
},
"widgets_values": [
0.5,
0,
1
],
"widgets_values_named": {
"detection_threshold": 0.5,
"max_objects": 0,
"detect_interval": 1
},
"color": "#223",
"bgcolor": "#335"
},
{
"id": 121,
"type": "ResizeImageMaskNode",
"pos": [
-1017.3142655795682,
1104.06055049653
],
"size": [
270,
106
],
"flags": {},
"order": 15,
"mode": 0,
"inputs": [
{
"name": "input",
"type": "IMAGE,MASK",
"link": 209
}
],
"outputs": [
{
"name": "resized",
"type": "IMAGE",
"links": [
211
]
}
],
"properties": {
"Node name for S&R": "ResizeImageMaskNode"
},
"widgets_values": [
"scale total pixels",
1,
"bicubic"
],
"widgets_values_named": {
"resize_type": "scale total pixels",
"resize_type.megapixels": 1,
"scale_method": "bicubic"
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 145,
"type": "LTXVConcatAVLatent",
"pos": [
631.7002512545694,
1010.2183226908568
],
"size": [
200.07974584990475,
46
],
"flags": {},
"order": 28,
"mode": 0,
"inputs": [
{
"name": "video_latent",
"type": "LATENT",
"link": 249
},
{
"name": "audio_latent",
"type": "LATENT",
"link": 262
}
],
"outputs": [
{
"name": "latent",
"type": "LATENT",
"links": [
250
]
}
],
"properties": {
"Node name for S&R": "LTXVConcatAVLatent"
}
},
{
"id": 138,
"type": "SetLatentNoiseMask",
"pos": [
380.90726563588817,
1104.06055049653
],
"size": [
218.62211345563665,
46
],
"flags": {},
"order": 26,
"mode": 0,
"inputs": [
{
"name": "samples",
"type": "LATENT",
"link": 244
},
{
"name": "mask",
"type": "MASK",
"link": 247
}
],
"outputs": [
{
"name": "LATENT",
"type": "LATENT",
"links": [
249
]
}
],
"properties": {
"Node name for S&R": "SetLatentNoiseMask"
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 96,
"type": "LoadImage",
"pos": [
-732.6073681556331,
352.8802091216946
],
"size": [
531.7558574586499,
417.24609450217815
],
"flags": {},
"order": 7,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "IMAGE",
"type": "IMAGE",
"links": [
198
]
},
{
"name": "MASK",
"type": "MASK",
"links": null
}
],
"properties": {
"Node name for S&R": "LoadImage"
},
"widgets_values": [
"shark.png",
"image"
],
"widgets_values_named": {
"image": "shark.png",
"upload": "image"
},
"color": "#233",
"bgcolor": "#355"
},
{
"id": 120,
"type": "VHS_LoadVideo",
"pos": [
-1373.8987302780815,
1106.2806187046765
],
"size": [
322.3382999083077,
493.95898334743094
],
"flags": {},
"order": 14,
"mode": 0,
"inputs": [
{
"name": "meta_batch",
"shape": 7,
"type": "VHS_BatchManager",
"link": null
},
{
"name": "vae",
"shape": 7,
"type": "VAE",
"link": null
},
{
"name": "frame_load_cap",
"type": "INT",
"widget": {
"name": "frame_load_cap"
},
"link": 224
}
],
"outputs": [
{
"name": "IMAGE",
"type": "IMAGE",
"links": [
209
]
},
{
"name": "frame_count",
"type": "INT",
"links": null
},
{
"name": "audio",
"type": "AUDIO",
"links": []
},
{
"name": "video_info",
"type": "VHS_VIDEOINFO",
"links": null
}
],
"properties": {
"Node name for S&R": "VHS_LoadVideo"
},
"widgets_values": {
"video": "101233-video-1080.mp4",
"force_rate": 24,
"custom_width": 0,
"custom_height": 0,
"frame_load_cap": 0,
"skip_first_frames": 0,
"select_every_nth": 1,
"format": "AnimateDiff",
"videopreview": {
"hidden": false,
"paused": false,
"params": {
"filename": "101233-video-1080.mp4",
"type": "input",
"format": "video/mp4",
"force_rate": 24,
"custom_width": 0,
"custom_height": 0,
"frame_load_cap": 0,
"skip_first_frames": 0,
"select_every_nth": 1
}
}
},
"widgets_values_named": {
"video": "101233-video-1080.mp4",
"force_rate": 24,
"custom_width": 0,
"custom_height": 0,
"frame_load_cap": 0,
"skip_first_frames": 0,
"select_every_nth": 1,
"format": "AnimateDiff",
"choose video to upload": null,
"videopreview": {
"hidden": false,
"paused": false,
"params": {
"filename": "101233-video-1080.mp4",
"type": "input",
"format": "video/mp4",
"force_rate": 24,
"custom_width": 0,
"custom_height": 0,
"frame_load_cap": 0,
"skip_first_frames": 0,
"select_every_nth": 1
}
}
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 142,
"type": "MaskPreview",
"pos": [
384.0319153017594,
1276.3710016153482
],
"size": [
385.15689138103824,
261.73203303832656
],
"flags": {},
"order": 27,
"mode": 0,
"inputs": [
{
"name": "mask",
"type": "MASK",
"link": 248
}
],
"outputs": [
{
"name": "mask",
"type": "MASK",
"links": null
}
],
"properties": {
"Node name for S&R": "MaskPreview"
},
"widgets_values": [],
"widgets_values_named": {}
}
],
"links": [
[
35,
3,
0,
8,
0,
"LATENT"
],
[
130,
75,
0,
3,
2,
"CONDITIONING"
],
[
132,
3,
0,
77,
0,
"LATENT"
],
[
139,
39,
0,
79,
0,
"VAE"
],
[
140,
79,
0,
8,
1,
"VAE"
],
[
149,
81,
0,
82,
0,
"VAE"
],
[
150,
82,
0,
77,
1,
"VAE"
],
[
158,
91,
0,
92,
0,
"VIDEO"
],
[
159,
8,
0,
91,
0,
"IMAGE"
],
[
160,
77,
0,
91,
1,
"AUDIO"
],
[
163,
37,
0,
86,
0,
"MODEL"
],
[
164,
86,
0,
3,
0,
"MODEL"
],
[
182,
106,
0,
104,
0,
"FLOAT"
],
[
188,
104,
1,
108,
10,
"INT"
],
[
190,
108,
0,
3,
1,
"CONDITIONING"
],
[
191,
108,
0,
75,
0,
"CONDITIONING"
],
[
192,
38,
0,
108,
0,
"CLIP"
],
[
193,
39,
0,
108,
1,
"VAE"
],
[
194,
81,
0,
108,
2,
"VAE"
],
[
195,
99,
0,
108,
3,
"IMAGE"
],
[
198,
96,
0,
99,
0,
"IMAGE"
],
[
209,
120,
0,
121,
0,
"IMAGE"
],
[
211,
121,
0,
123,
0,
"IMAGE"
],
[
215,
123,
0,
108,
6,
"IMAGE"
],
[
218,
123,
0,
124,
0,
"IMAGE"
],
[
219,
124,
0,
108,
8,
"INT"
],
[
220,
124,
1,
108,
9,
"INT"
],
[
224,
104,
1,
120,
2,
"INT"
],
[
233,
136,
1,
134,
0,
"CLIP"
],
[
235,
136,
0,
135,
1,
"MODEL"
],
[
236,
134,
0,
135,
3,
"CONDITIONING"
],
[
237,
135,
0,
137,
0,
"SAM3_TRACK_DATA"
],
[
238,
123,
0,
135,
0,
"IMAGE"
],
[
242,
123,
0,
139,
0,
"IMAGE"
],
[
243,
39,
0,
139,
1,
"VAE"
],
[
244,
139,
0,
138,
0,
"LATENT"
],
[
246,
137,
0,
140,
0,
"MASK"
],
[
247,
140,
0,
138,
1,
"MASK"
],
[
248,
140,
0,
142,
0,
"MASK"
],
[
249,
138,
0,
145,
0,
"LATENT"
],
[
250,
145,
0,
3,
3,
"LATENT"
],
[
257,
124,
0,
150,
0,
"INT"
],
[
258,
124,
1,
150,
1,
"INT"
],
[
259,
104,
1,
150,
2,
"INT"
],
[
261,
150,
0,
151,
0,
"LATENT"
],
[
262,
151,
1,
145,
1,
"LATENT"
]
],
"groups": [],
"config": {},
"extra": {
"ds": {
"scale": 0.32349184307608736,
"offset": [
1513.77364992828,
528.1188372619786
]
},
"frontendVersion": "1.51.10",
"VHS_latentpreview": false,
"VHS_latentpreviewrate": 0,
"VHS_MetadataImage": true,
"VHS_KeepIntermediate": true
},
"version": 0.4
}
这次使用 ref2va 模型,把视频里的狗替换成参考图像中的玩偶。
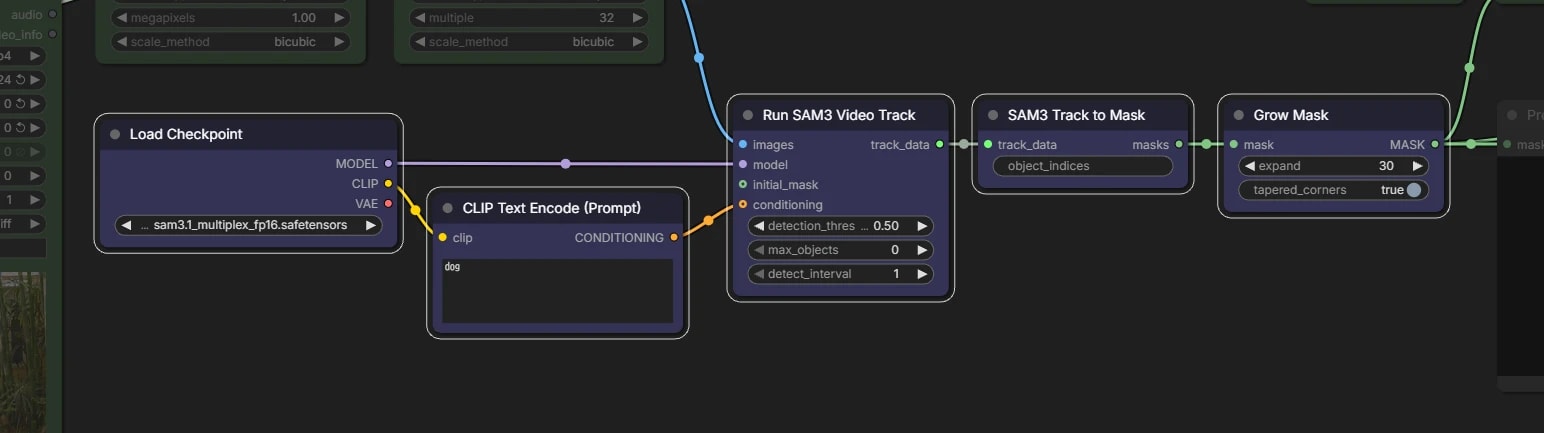
输出示例
Hires.fix
前面的工作流都从一开始就以 1.0 MP 生成。质量很好,但每次生成都要花相当长的时间。
因此,也可以先在第 1 阶段以 0.25 MP 生成,结果不错的话再放大 2 倍完成最终输出。这就是所谓的 Hires.fix。
即使提示词相同,以 0.25 MP 生成和以 1.0 MP 生成时,模型能够表现的内容也会有所不同。
如果时间充裕,还是建议从一开始就使用推荐的 1.0 MP 生成。
所需自定义节点与模型
- xmarre/Comfyui_Minimax_h3_latent_Upscaler-Plus
- 原始仓库没有收录在 ComfyUI Manager 中,因此这里使用可通过 Manager 安装的这个版本
- latent_upscale_models
📂ComfyUI/
└── 📂models/
    └── 📂latent_upscale_models/
        └── minimax_h3_latent_upscaler_3d_bf16.safetensors
text2video / T2VA
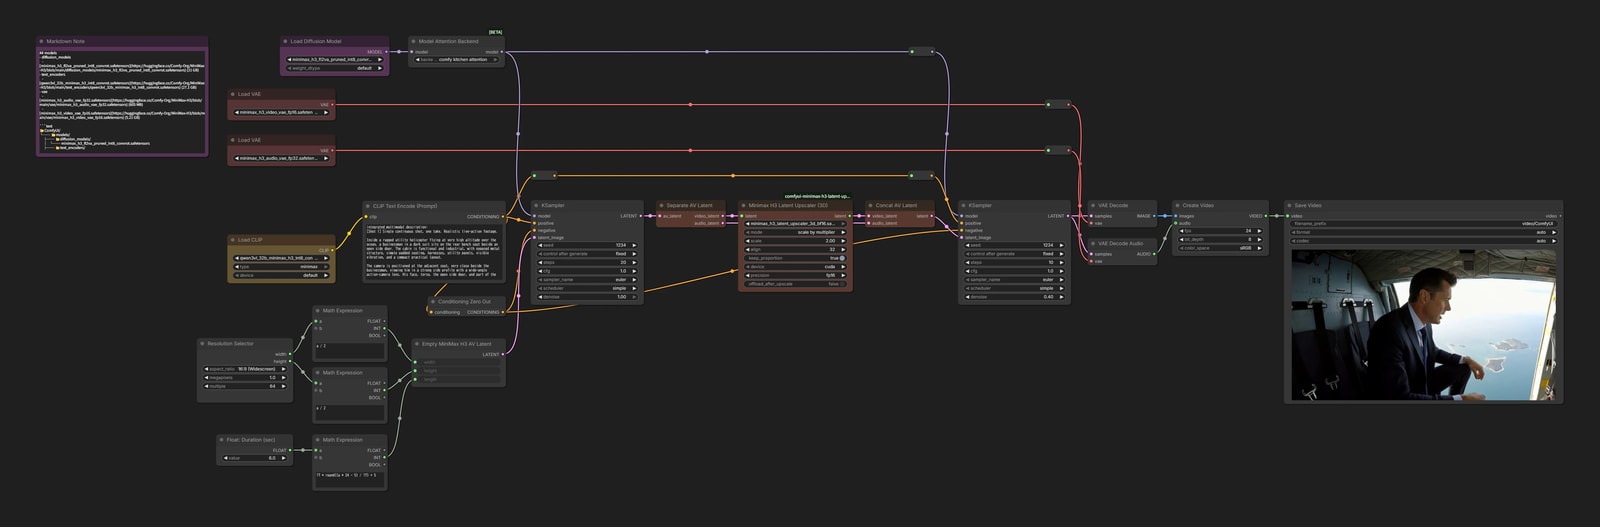
{
"id": "0e41d131-d23d-4699-9dc2-7bb198629652",
"revision": 0,
"last_node_id": 115,
"last_link_id": 197,
"nodes": [
{
"id": 75,
"type": "ConditioningZeroOut",
"pos": [
609.9961582391737,
526.7012355101198
],
"size": [
218.4346850585937,
26
],
"flags": {},
"order": 15,
"mode": 0,
"inputs": [
{
"name": "conditioning",
"type": "CONDITIONING",
"link": 153
}
],
"outputs": [
{
"name": "CONDITIONING",
"type": "CONDITIONING",
"links": [
130,
176
]
}
],
"properties": {
"Node name for S&R": "ConditioningZeroOut",
"cnr_id": "comfy-core",
"ver": "0.30.0"
}
},
{
"id": 95,
"type": "MarkdownNote",
"pos": [
-480.03631463650436,
-198.51277317993834
],
"size": [
480.26512898835654,
306.99991194075415
],
"flags": {},
"order": 0,
"mode": 0,
"inputs": [],
"outputs": [],
"properties": {},
"widgets_values": [
"## models\n- diffusion_models\n - [minimax_h3_fl2va_pruned_int8_convrot.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/diffusion_models/minimax_h3_fl2va_pruned_int8_convrot.safetensors) (21 GB)\n- text_encoders\n - [qwen3vl_32b_minimax_h3_int8_convrot.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/text_encoders/qwen3vl_32b_minimax_h3_int8_convrot.safetensors) (27.1 GB)\n- vae\n - [minimax_h3_audio_vae_fp32.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/vae/minimax_h3_audio_vae_fp32.safetensors) (605 MB)\n - [minimax_h3_video_vae_fp16.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/vae/minimax_h3_video_vae_fp16.safetensors) (5.21 GB)\n\n```text\n📂ComfyUI/\n└── 📂models/\n ├── 📂diffusion_models/\n │ └── minimax_h3_fl2va_pruned_int8_convrot.safetensors\n ├── 📂text_encoders/\n │ └── qwen3vl_32b_minimax_h3_int8_convrot.safetensors\n └── 📂vae/\n ├── minimax_h3_audio_vae_fp32.safetensors\n └── minimax_h3_video_vae_fp16.safetensors\n```"
],
"widgets_values_named": {
"text": "## models\n- diffusion_models\n - [minimax_h3_fl2va_pruned_int8_convrot.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/diffusion_models/minimax_h3_fl2va_pruned_int8_convrot.safetensors) (21 GB)\n- text_encoders\n - [qwen3vl_32b_minimax_h3_int8_convrot.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/text_encoders/qwen3vl_32b_minimax_h3_int8_convrot.safetensors) (27.1 GB)\n- vae\n - [minimax_h3_audio_vae_fp32.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/vae/minimax_h3_audio_vae_fp32.safetensors) (605 MB)\n - [minimax_h3_video_vae_fp16.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/vae/minimax_h3_video_vae_fp16.safetensors) (5.21 GB)\n\n```text\n📂ComfyUI/\n└── 📂models/\n ├── 📂diffusion_models/\n │ └── minimax_h3_fl2va_pruned_int8_convrot.safetensors\n ├── 📂text_encoders/\n │ └── qwen3vl_32b_minimax_h3_int8_convrot.safetensors\n └── 📂vae/\n ├── minimax_h3_audio_vae_fp32.safetensors\n └── minimax_h3_video_vae_fp16.safetensors\n```"
},
"color": "#323",
"bgcolor": "#535"
},
{
"id": 37,
"type": "UNETLoader",
"pos": [
198.95419944148816,
-198.51277317993834
],
"size": [
305.3782043457031,
82
],
"flags": {},
"order": 1,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "MODEL",
"type": "MODEL",
"slot_index": 0,
"links": [
163
]
}
],
"properties": {
"Node name for S&R": "UNETLoader",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
"minimax_h3_fl2va_pruned_int8_convrot.safetensors",
"default"
],
"widgets_values_named": {
"unet_name": "minimax_h3_fl2va_pruned_int8_convrot.safetensors",
"weight_dtype": "default"
},
"color": "#323",
"bgcolor": "#535"
},
{
"id": 81,
"type": "VAELoader",
"pos": [
52.62317611836556,
76.42865257257024
],
"size": [
301.3524169921875,
58
],
"flags": {},
"order": 2,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "VAE",
"type": "VAE",
"slot_index": 0,
"links": [
149
]
}
],
"properties": {
"Node name for S&R": "VAELoader",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
"minimax_h3_audio_vae_fp32.safetensors"
],
"widgets_values_named": {
"vae_name": "minimax_h3_audio_vae_fp32.safetensors"
},
"color": "#322",
"bgcolor": "#533"
},
{
"id": 38,
"type": "CLIPLoader",
"pos": [
52.62317611836556,
354.61463279686797
],
"size": [
301.3524169921875,
106
],
"flags": {},
"order": 3,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "CLIP",
"type": "CLIP",
"slot_index": 0,
"links": [
145
]
}
],
"properties": {
"Node name for S&R": "CLIPLoader",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
"qwen3vl_32b_minimax_h3_int8_convrot.safetensors",
"minimax",
"default"
],
"widgets_values_named": {
"clip_name": "qwen3vl_32b_minimax_h3_int8_convrot.safetensors",
"type": "minimax",
"device": "default"
},
"color": "#432",
"bgcolor": "#653"
},
{
"id": 76,
"type": "EmptyMiniMaxH3LatentAV",
"pos": [
565.3003160292425,
644.120828132653
],
"size": [
263.13052726852493,
106
],
"flags": {},
"order": 17,
"mode": 0,
"inputs": [
{
"name": "width",
"type": "INT",
"widget": {
"name": "width"
},
"link": 195
},
{
"name": "height",
"type": "INT",
"widget": {
"name": "height"
},
"link": 197
},
{
"name": "length",
"type": "INT",
"widget": {
"name": "length"
},
"link": 162
}
],
"outputs": [
{
"name": "LATENT",
"type": "LATENT",
"links": [
144
]
}
],
"properties": {
"Node name for S&R": "EmptyMiniMaxH3LatentAV",
"cnr_id": "comfy-core",
"ver": "0.30.0"
},
"widgets_values": [
1344,
768,
124
],
"widgets_values_named": {
"width": 1344,
"height": 768,
"length": 124
}
},
{
"id": 8,
"type": "VAEDecode",
"pos": [
2447.012996871688,
258.7695300336093
],
"size": [
194.25299723441972,
46
],
"flags": {},
"order": 24,
"mode": 0,
"inputs": [
{
"name": "samples",
"type": "LATENT",
"link": 182
},
{
"name": "vae",
"type": "VAE",
"link": 140
}
],
"outputs": [
{
"name": "IMAGE",
"type": "IMAGE",
"slot_index": 0,
"links": [
159
]
}
],
"properties": {
"Node name for S&R": "VAEDecode",
"cnr_id": "comfy-core",
"ver": "0.3.33"
}
},
{
"id": 101,
"type": "LTXVSeparateAVLatent",
"pos": [
1246.0693713955927,
258.7695300336093
],
"size": [
194.25299723441972,
46
],
"flags": {},
"order": 20,
"mode": 0,
"inputs": [
{
"name": "av_latent",
"type": "LATENT",
"link": 169
}
],
"outputs": [
{
"name": "video_latent",
"type": "LATENT",
"links": [
171
]
},
{
"name": "audio_latent",
"type": "LATENT",
"links": [
173
]
}
],
"properties": {
"Node name for S&R": "LTXVSeparateAVLatent"
},
"color": "#332922",
"bgcolor": "#593930"
},
{
"id": 86,
"type": "ModelAttentionBackend",
"pos": [
555.6042177585902,
-198.51277317993834
],
"size": [
270,
58
],
"flags": {},
"order": 7,
"mode": 0,
"inputs": [
{
"name": "model",
"type": "MODEL",
"link": 163
}
],
"outputs": [
{
"name": "model",
"type": "MODEL",
"links": [
164,
180
]
}
],
"properties": {
"Node name for S&R": "ModelAttentionBackend"
},
"widgets_values": [
"comfy kitchen attention"
],
"widgets_values_named": {
"attention": "comfy kitchen attention"
}
},
{
"id": 105,
"type": "Reroute",
"pos": [
1948.4779508326274,
-198.51277317993834
],
"size": [
75,
26
],
"flags": {},
"order": 14,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 180
}
],
"outputs": [
{
"name": "",
"type": "MODEL",
"links": [
181
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 39,
"type": "VAELoader",
"pos": [
52.62317611836556,
-51.18135864304374
],
"size": [
301.3524169921875,
58
],
"flags": {},
"order": 4,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "VAE",
"type": "VAE",
"slot_index": 0,
"links": [
139
]
}
],
"properties": {
"Node name for S&R": "VAELoader",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
"minimax_h3_video_vae_fp16.safetensors"
],
"widgets_values_named": {
"vae_name": "minimax_h3_video_vae_fp16.safetensors"
},
"color": "#322",
"bgcolor": "#533"
},
{
"id": 91,
"type": "CreateVideo",
"pos": [
2682.0787498545697,
258.7695300336093
],
"size": [
270,
126
],
"flags": {},
"order": 26,
"mode": 0,
"inputs": [
{
"name": "images",
"type": "IMAGE",
"link": 159
},
{
"name": "audio",
"shape": 7,
"type": "AUDIO",
"link": 160
}
],
"outputs": [
{
"name": "VIDEO",
"type": "VIDEO",
"links": [
168
]
}
],
"properties": {
"Node name for S&R": "CreateVideo",
"cnr_id": "comfy-core",
"ver": "0.33.0"
},
"widgets_values": [
24,
8,
"sRGB"
],
"widgets_values_named": {
"fps": 24,
"bit_depth": 8,
"color_space": "sRGB"
}
},
{
"id": 77,
"type": "VAEDecodeAudio",
"pos": [
2447.012996871688,
364.8167547950162
],
"size": [
194.25299723441972,
46
],
"flags": {},
"order": 25,
"mode": 0,
"inputs": [
{
"name": "samples",
"type": "LATENT",
"link": 183
},
{
"name": "vae",
"type": "VAE",
"link": 150
}
],
"outputs": [
{
"name": "AUDIO",
"type": "AUDIO",
"links": [
160
]
}
],
"properties": {
"Node name for S&R": "VAEDecodeAudio",
"cnr_id": "comfy-core",
"ver": "0.30.0"
}
},
{
"id": 102,
"type": "MinimaxH3LatentUpscaler3D",
"pos": [
1474.2060749504938,
258.7695300336093
],
"size": [
319.566015625,
226
],
"flags": {},
"order": 21,
"mode": 0,
"inputs": [
{
"name": "latent",
"type": "*",
"link": 171
}
],
"outputs": [
{
"name": "latent",
"type": "*",
"links": [
172
]
}
],
"properties": {
"Node name for S&R": "MinimaxH3LatentUpscaler3D"
},
"widgets_values": [
"minimax_h3_latent_upscaler_3d_bf16.safetensors",
"scale by multiplier",
2,
32,
true,
"cuda",
"fp16",
false
],
"widgets_values_named": {
"model_name": "minimax_h3_latent_upscaler_3d_bf16.safetensors",
"mode": "scale by multiplier",
"mode.scale": 2,
"align": 32,
"keep_proportion": true,
"device": "cuda",
"precision": "fp16",
"offload_after_upscale": false
},
"color": "#332922",
"bgcolor": "#593930"
},
{
"id": 103,
"type": "LTXVConcatAVLatent",
"pos": [
1827.655796895975,
258.7695300336093
],
"size": [
194.25299723441972,
46
],
"flags": {},
"order": 22,
"mode": 0,
"inputs": [
{
"name": "video_latent",
"type": "LATENT",
"link": 172
},
{
"name": "audio_latent",
"type": "LATENT",
"link": 173
}
],
"outputs": [
{
"name": "latent",
"type": "LATENT",
"links": [
178
]
}
],
"properties": {
"Node name for S&R": "LTXVConcatAVLatent"
},
"color": "#332922",
"bgcolor": "#593930"
},
{
"id": 106,
"type": "Reroute",
"pos": [
897.1856650751112,
146.81478988524668
],
"size": [
75,
26
],
"flags": {},
"order": 16,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 184
}
],
"outputs": [
{
"name": "",
"type": "CONDITIONING",
"links": [
185
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 107,
"type": "Reroute",
"pos": [
1946.9087941303949,
146.81478988524668
],
"size": [
75,
26
],
"flags": {},
"order": 18,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 185
}
],
"outputs": [
{
"name": "",
"type": "CONDITIONING",
"links": [
186
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 79,
"type": "Reroute",
"pos": [
2327.8218798882226,
-51.18135864304374
],
"size": [
75,
26
],
"flags": {},
"order": 10,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 139
}
],
"outputs": [
{
"name": "",
"type": "VAE",
"links": [
140
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 82,
"type": "Reroute",
"pos": [
2327.8218798882226,
76.42865257257024
],
"size": [
75,
26
],
"flags": {},
"order": 8,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 149
}
],
"outputs": [
{
"name": "",
"type": "VAE",
"links": [
150
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 99,
"type": "SaveVideo",
"pos": [
2993.3914872861806,
258.7695300336093
],
"size": [
778.6372202009193,
538.0992983744327
],
"flags": {},
"order": 27,
"mode": 0,
"inputs": [
{
"name": "video",
"type": "VIDEO",
"link": 168
}
],
"outputs": [
{
"name": "video",
"type": "VIDEO",
"links": null
}
],
"properties": {
"cnr_id": "comfy-core",
"ver": "0.33.0"
},
"widgets_values": [
"video/ComfyUI",
"auto",
"auto",
"auto"
],
"widgets_values_named": {
"filename_prefix": "video/ComfyUI",
"format": "auto",
"format.codec": "auto",
"codec": "auto"
}
},
{
"id": 73,
"type": "ResolutionSelector",
"pos": [
-32.062042796118135,
643.2760232776312
],
"size": [
268.22844442871553,
150
],
"flags": {},
"order": 5,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "width",
"type": "INT",
"links": [
194
]
},
{
"name": "height",
"type": "INT",
"links": [
196
]
}
],
"properties": {
"Node name for S&R": "ResolutionSelector",
"cnr_id": "comfy-core",
"ver": "0.29.0"
},
"widgets_values": [
"16:9 (Widescreen)",
1,
64
],
"widgets_values_named": {
"aspect_ratio": "16:9 (Widescreen)",
"megapixels": 1,
"multiple": 64
}
},
{
"id": 114,
"type": "ComfyMathExpression",
"pos": [
288.94156702650986,
724.2217890896594
],
"size": [
210,
128
],
"flags": {},
"order": 12,
"mode": 0,
"inputs": [
{
"label": "a",
"name": "values.a",
"type": "FLOAT,INT,BOOLEAN",
"link": 196
},
{
"name": "values.b",
"shape": 7,
"type": "FLOAT,INT,BOOLEAN",
"link": null
}
],
"outputs": [
{
"name": "FLOAT",
"type": "FLOAT",
"links": null
},
{
"name": "INT",
"type": "INT",
"links": [
197
]
},
{
"name": "BOOL",
"type": "BOOLEAN",
"links": null
}
],
"properties": {
"Node name for S&R": "ComfyMathExpression",
"cnr_id": "comfy-core",
"ver": "0.33.0"
},
"widgets_values": [
"a / 2"
],
"widgets_values_named": {
"expression": "a / 2"
}
},
{
"id": 113,
"type": "ComfyMathExpression",
"pos": [
288.94156702650986,
551.9271988752192
],
"size": [
210,
128
],
"flags": {},
"order": 11,
"mode": 0,
"inputs": [
{
"label": "a",
"name": "values.a",
"type": "FLOAT,INT,BOOLEAN",
"link": 194
},
{
"name": "values.b",
"shape": 7,
"type": "FLOAT,INT,BOOLEAN",
"link": null
}
],
"outputs": [
{
"name": "FLOAT",
"type": "FLOAT",
"links": null
},
{
"name": "INT",
"type": "INT",
"links": [
195
]
},
{
"name": "BOOL",
"type": "BOOLEAN",
"links": null
}
],
"properties": {
"Node name for S&R": "ComfyMathExpression",
"cnr_id": "comfy-core",
"ver": "0.33.0"
},
"widgets_values": [
"a / 2"
],
"widgets_values_named": {
"expression": "a / 2"
}
},
{
"id": 87,
"type": "ComfyMathExpression",
"pos": [
288.94156702650986,
911.2522709601897
],
"size": [
210,
128
],
"flags": {},
"order": 13,
"mode": 0,
"inputs": [
{
"label": "a",
"name": "values.a",
"type": "FLOAT,INT,BOOLEAN",
"link": 166
},
{
"name": "values.b",
"shape": 7,
"type": "FLOAT,INT,BOOLEAN",
"link": null
}
],
"outputs": [
{
"name": "FLOAT",
"type": "FLOAT",
"links": null
},
{
"name": "INT",
"type": "INT",
"links": [
162
]
},
{
"name": "BOOL",
"type": "BOOLEAN",
"links": null
}
],
"properties": {
"Node name for S&R": "ComfyMathExpression",
"cnr_id": "comfy-core",
"ver": "0.33.0"
},
"widgets_values": [
"17 * round((a * 24 - 5) / 17) + 5"
],
"widgets_values_named": {
"expression": "17 * round((a * 24 - 5) / 17) + 5"
}
},
{
"id": 94,
"type": "PrimitiveFloat",
"pos": [
21.507893567564565,
911.2522709601897
],
"size": [
214.65850806503283,
58
],
"flags": {},
"order": 6,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "FLOAT",
"type": "FLOAT",
"links": [
166
]
}
],
"title": "Float: Duration (sec)",
"properties": {
"Node name for S&R": "PrimitiveFloat"
},
"widgets_values": [
6
],
"widgets_values_named": {
"value": 6
}
},
{
"id": 80,
"type": "CLIPTextEncode",
"pos": [
428.4308432977674,
260.6146327968679
],
"size": [
400,
200
],
"flags": {},
"order": 9,
"mode": 0,
"inputs": [
{
"name": "clip",
"type": "CLIP",
"link": 145
}
],
"outputs": [
{
"name": "CONDITIONING",
"type": "CONDITIONING",
"links": [
146,
153,
184
]
}
],
"properties": {
"Node name for S&R": "CLIPTextEncode",
"cnr_id": "comfy-core",
"ver": "0.30.0"
},
"widgets_values": [
"integrated_multimodal_description:\n[Shot 1] Single continuous shot, one take. Realistic live-action footage.\n\nInside a rugged utility helicopter flying at very high altitude over the ocean, a businessman in a dark suit sits on the rear bench seat beside an open side door. The cabin is functional and industrial, with exposed metal structure, simple padded seating, harnesses, utility panels, visible vibration, and a compact practical layout.\n\nThe camera is positioned at the adjacent seat, very close beside the businessman, viewing him in a strong side profile with a wide-angle action-camera lens. His face, torso, the open side door, and part of the harsh helicopter interior share the frame. He is the sole human subject visible in the shot.\n\nFar outside the open door is an enormous expanse of ocean. A few scattered uninhabited islands are visible extremely far below, appearing tiny because of the altitude.\n\nFrom 00:00.000 to 00:02.300, the camera stays beside him and films his profile. The helicopter vibrates heavily. He looks tense and focused, breathing deeply and staring toward the open doorway. He gathers himself, then rapidly counts down (S1): <d>[English] OK... three, two, one.</d>\n\nFrom 00:02.300 to 00:03.100, immediately after “one,” he lunges sideways from the rear seat and dives through the open helicopter door. The camera whips toward the doorway and follows his trajectory in the same continuous motion. The transition is abrupt and physical, with violent irregular shake, strong motion blur, and a sudden blast of exterior light and wind.\n\nFrom 00:03.100 to 00:06.000, the camera passes through the same open doorway and plunges into freefall directly after him. The suited man is already several meters below and continues falling over the vast ocean. The camera accelerates downward after him, struggling slightly to keep him framed through strong wind buffeting and chaotic action-camera shake. Far beneath him, the scattered islands remain tiny against the enormous blue sea. The extreme wide-angle perspective emphasizes the immense altitude, rapid descent, and dangerous scale of the open air.\n\noverall_soundscape:\nDeafening helicopter rotor thump, mechanical vibration, cabin rattling, harsh wind entering through the open side door, and the man's tense breathing. At the jump, the helicopter sound rapidly gives way to an explosive blast of wind and continuous roaring freefall air.\n\nnon_diegetic_music:\nN/A"
],
"widgets_values_named": {
"text": "integrated_multimodal_description:\n[Shot 1] Single continuous shot, one take. Realistic live-action footage.\n\nInside a rugged utility helicopter flying at very high altitude over the ocean, a businessman in a dark suit sits on the rear bench seat beside an open side door. The cabin is functional and industrial, with exposed metal structure, simple padded seating, harnesses, utility panels, visible vibration, and a compact practical layout.\n\nThe camera is positioned at the adjacent seat, very close beside the businessman, viewing him in a strong side profile with a wide-angle action-camera lens. His face, torso, the open side door, and part of the harsh helicopter interior share the frame. He is the sole human subject visible in the shot.\n\nFar outside the open door is an enormous expanse of ocean. A few scattered uninhabited islands are visible extremely far below, appearing tiny because of the altitude.\n\nFrom 00:00.000 to 00:02.300, the camera stays beside him and films his profile. The helicopter vibrates heavily. He looks tense and focused, breathing deeply and staring toward the open doorway. He gathers himself, then rapidly counts down (S1): <d>[English] OK... three, two, one.</d>\n\nFrom 00:02.300 to 00:03.100, immediately after “one,” he lunges sideways from the rear seat and dives through the open helicopter door. The camera whips toward the doorway and follows his trajectory in the same continuous motion. The transition is abrupt and physical, with violent irregular shake, strong motion blur, and a sudden blast of exterior light and wind.\n\nFrom 00:03.100 to 00:06.000, the camera passes through the same open doorway and plunges into freefall directly after him. The suited man is already several meters below and continues falling over the vast ocean. The camera accelerates downward after him, struggling slightly to keep him framed through strong wind buffeting and chaotic action-camera shake. Far beneath him, the scattered islands remain tiny against the enormous blue sea. The extreme wide-angle perspective emphasizes the immense altitude, rapid descent, and dangerous scale of the open air.\n\noverall_soundscape:\nDeafening helicopter rotor thump, mechanical vibration, cabin rattling, harsh wind entering through the open side door, and the man's tense breathing. At the jump, the helicopter sound rapidly gives way to an explosive blast of wind and continuous roaring freefall air.\n\nnon_diegetic_music:\nN/A"
}
},
{
"id": 3,
"type": "KSampler",
"pos": [
897.1856650751112,
258.7695300336093
],
"size": [
315,
262
],
"flags": {},
"order": 19,
"mode": 0,
"inputs": [
{
"name": "model",
"type": "MODEL",
"link": 164
},
{
"name": "positive",
"type": "CONDITIONING",
"link": 146
},
{
"name": "negative",
"type": "CONDITIONING",
"link": 130
},
{
"name": "latent_image",
"type": "LATENT",
"link": 144
}
],
"outputs": [
{
"name": "LATENT",
"type": "LATENT",
"slot_index": 0,
"links": [
169
]
}
],
"properties": {
"Node name for S&R": "KSampler",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
1234,
"fixed",
20,
1,
"euler",
"simple",
1
],
"widgets_values_named": {
"seed": 1234,
"control_after_generate": "fixed",
"steps": 20,
"cfg": 1,
"sampler_name": "euler",
"scheduler": "simple",
"denoise": 1
}
},
{
"id": 104,
"type": "KSampler",
"pos": [
2086.25272318599,
258.7695300336093
],
"size": [
315,
262
],
"flags": {},
"order": 23,
"mode": 0,
"inputs": [
{
"name": "model",
"type": "MODEL",
"link": 181
},
{
"name": "positive",
"type": "CONDITIONING",
"link": 186
},
{
"name": "negative",
"type": "CONDITIONING",
"link": 176
},
{
"name": "latent_image",
"type": "LATENT",
"link": 178
}
],
"outputs": [
{
"name": "LATENT",
"type": "LATENT",
"slot_index": 0,
"links": [
182,
183
]
}
],
"properties": {
"Node name for S&R": "KSampler",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
1234,
"fixed",
10,
1,
"euler",
"simple",
0.4
],
"widgets_values_named": {
"seed": 1234,
"control_after_generate": "fixed",
"steps": 10,
"cfg": 1,
"sampler_name": "euler",
"scheduler": "simple",
"denoise": 0.4
}
}
],
"links": [
[
130,
75,
0,
3,
2,
"CONDITIONING"
],
[
139,
39,
0,
79,
0,
"VAE"
],
[
140,
79,
0,
8,
1,
"VAE"
],
[
144,
76,
0,
3,
3,
"LATENT"
],
[
145,
38,
0,
80,
0,
"CLIP"
],
[
146,
80,
0,
3,
1,
"CONDITIONING"
],
[
149,
81,
0,
82,
0,
"VAE"
],
[
150,
82,
0,
77,
1,
"VAE"
],
[
153,
80,
0,
75,
0,
"CONDITIONING"
],
[
159,
8,
0,
91,
0,
"IMAGE"
],
[
160,
77,
0,
91,
1,
"AUDIO"
],
[
162,
87,
1,
76,
2,
"INT"
],
[
163,
37,
0,
86,
0,
"MODEL"
],
[
164,
86,
0,
3,
0,
"MODEL"
],
[
166,
94,
0,
87,
0,
"FLOAT"
],
[
168,
91,
0,
99,
0,
"VIDEO"
],
[
169,
3,
0,
101,
0,
"LATENT"
],
[
171,
101,
0,
102,
0,
"LATENT"
],
[
172,
102,
0,
103,
0,
"LATENT"
],
[
173,
101,
1,
103,
1,
"LATENT"
],
[
176,
75,
0,
104,
2,
"CONDITIONING"
],
[
178,
103,
0,
104,
3,
"LATENT"
],
[
180,
86,
0,
105,
0,
"MODEL"
],
[
181,
105,
0,
104,
0,
"MODEL"
],
[
182,
104,
0,
8,
0,
"LATENT"
],
[
183,
104,
0,
77,
0,
"LATENT"
],
[
184,
80,
0,
106,
0,
"CONDITIONING"
],
[
185,
106,
0,
107,
0,
"CONDITIONING"
],
[
186,
107,
0,
104,
1,
"CONDITIONING"
],
[
194,
73,
0,
113,
0,
"INT"
],
[
195,
113,
1,
76,
0,
"INT"
],
[
196,
73,
1,
114,
0,
"INT"
],
[
197,
114,
1,
76,
1,
"INT"
]
],
"groups": [],
"config": {},
"extra": {
"ds": {
"scale": 0.3956893427901571,
"offset": [
646.8517452827605,
610.7484360136835
]
},
"frontendVersion": "1.51.10",
"VHS_latentpreview": false,
"VHS_latentpreviewrate": 0,
"VHS_MetadataImage": true,
"VHS_KeepIntermediate": true
},
"version": 0.4
}
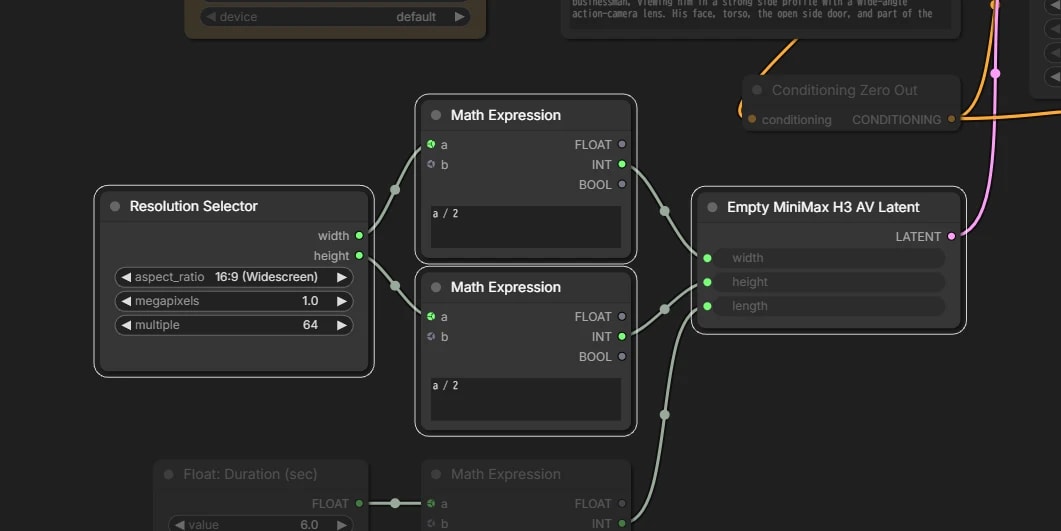
第 1 阶段的分辨率
在第一个 Empty Latent 中,输入最终视频宽度和高度各自一半的值。
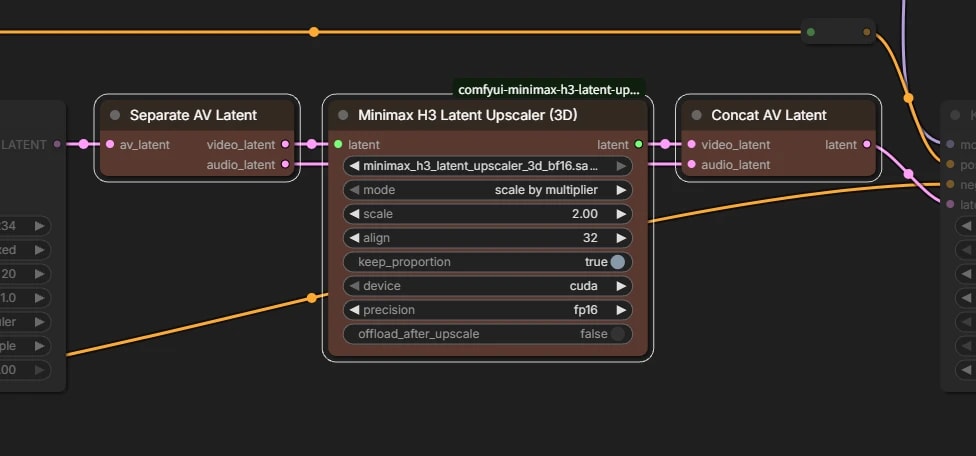
放大 latent
不解码为像素图像,直接将 latent 的宽度和高度放大 2 倍。
直接放大 latent 会导致明显劣化,因此这里使用专用模型。
此外,H3 的视频和音频 latent 合在一起。由于只需要放大视频,先将两者分离,放大视频后再重新合并。
输出示例
image2video / I2VA
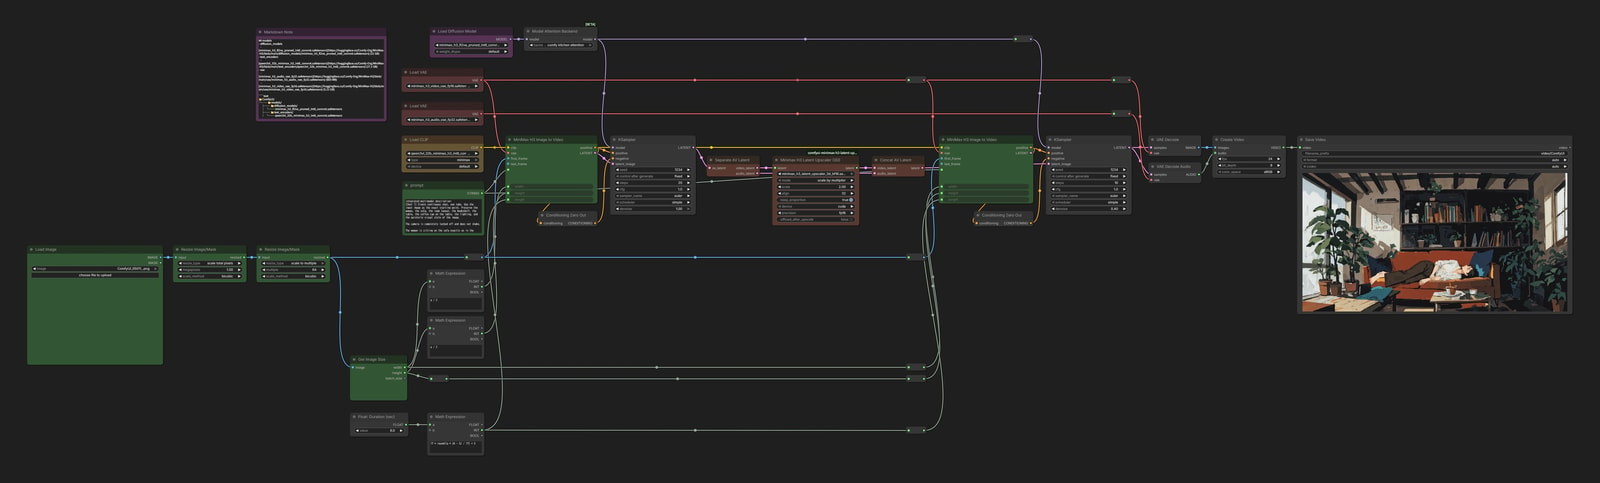
{
"id": "ab470b3f-c850-4cc5-be9c-63a1bff0dc45",
"revision": 0,
"last_node_id": 120,
"last_link_id": 215,
"nodes": [
{
"id": 8,
"type": "VAEDecode",
"pos": [
2796.1261686020252,
188.1918182373047
],
"size": [
194.25299723441972,
46
],
"flags": {},
"order": 34,
"mode": 0,
"inputs": [
{
"name": "samples",
"type": "LATENT",
"link": 209
},
{
"name": "vae",
"type": "VAE",
"link": 140
}
],
"outputs": [
{
"name": "IMAGE",
"type": "IMAGE",
"slot_index": 0,
"links": [
159
]
}
],
"properties": {
"Node name for S&R": "VAEDecode",
"cnr_id": "comfy-core",
"ver": "0.3.33"
}
},
{
"id": 82,
"type": "Reroute",
"pos": [
2659.843124784804,
64.14635395192796
],
"size": [
75,
26
],
"flags": {},
"order": 8,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 149
}
],
"outputs": [
{
"name": "",
"type": "VAE",
"links": [
150
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 79,
"type": "Reroute",
"pos": [
2659.843124784804,
-59.89911033344882
],
"size": [
75,
26
],
"flags": {},
"order": 10,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 139
}
],
"outputs": [
{
"name": "",
"type": "VAE",
"links": [
140
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 81,
"type": "VAELoader",
"pos": [
52.62317611836556,
64.14635395192796
],
"size": [
301.3524169921875,
58
],
"flags": {},
"order": 0,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "VAE",
"type": "VAE",
"slot_index": 0,
"links": [
149
]
}
],
"properties": {
"Node name for S&R": "VAELoader",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
"minimax_h3_audio_vae_fp32.safetensors"
],
"widgets_values_named": {
"vae_name": "minimax_h3_audio_vae_fp32.safetensors"
},
"color": "#322",
"bgcolor": "#533"
},
{
"id": 94,
"type": "PrimitiveFloat",
"pos": [
-136.5859971544101,
1208.6257749488502
],
"size": [
214.65850806503283,
58
],
"flags": {},
"order": 1,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "FLOAT",
"type": "FLOAT",
"links": [
166
]
}
],
"title": "Float: Duration (sec)",
"properties": {
"Node name for S&R": "PrimitiveFloat"
},
"widgets_values": [
6
],
"widgets_values_named": {
"value": 6
}
},
{
"id": 95,
"type": "MarkdownNote",
"pos": [
-482.3943342566212,
-207.9445746188256
],
"size": [
480.26512898835654,
314.3204118484383
],
"flags": {},
"order": 2,
"mode": 0,
"inputs": [],
"outputs": [],
"properties": {},
"widgets_values": [
"## models\n- diffusion_models\n - [minimax_h3_fl2va_pruned_int8_convrot.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/diffusion_models/minimax_h3_fl2va_pruned_int8_convrot.safetensors) (21 GB)\n- text_encoders\n - [qwen3vl_32b_minimax_h3_int8_convrot.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/text_encoders/qwen3vl_32b_minimax_h3_int8_convrot.safetensors) (27.1 GB)\n- vae\n - [minimax_h3_audio_vae_fp32.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/vae/minimax_h3_audio_vae_fp32.safetensors) (605 MB)\n - [minimax_h3_video_vae_fp16.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/vae/minimax_h3_video_vae_fp16.safetensors) (5.21 GB)\n\n```text\n📂ComfyUI/\n└── 📂models/\n ├── 📂diffusion_models/\n │ └── minimax_h3_fl2va_pruned_int8_convrot.safetensors\n ├── 📂text_encoders/\n │ └── qwen3vl_32b_minimax_h3_int8_convrot.safetensors\n └── 📂vae/\n ├── minimax_h3_audio_vae_fp32.safetensors\n └── minimax_h3_video_vae_fp16.safetensors\n```"
],
"widgets_values_named": {
"text": "## models\n- diffusion_models\n - [minimax_h3_fl2va_pruned_int8_convrot.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/diffusion_models/minimax_h3_fl2va_pruned_int8_convrot.safetensors) (21 GB)\n- text_encoders\n - [qwen3vl_32b_minimax_h3_int8_convrot.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/text_encoders/qwen3vl_32b_minimax_h3_int8_convrot.safetensors) (27.1 GB)\n- vae\n - [minimax_h3_audio_vae_fp32.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/vae/minimax_h3_audio_vae_fp32.safetensors) (605 MB)\n - [minimax_h3_video_vae_fp16.safetensors](https://huggingface.co/Comfy-Org/MiniMax-H3/blob/main/vae/minimax_h3_video_vae_fp16.safetensors) (5.21 GB)\n\n```text\n📂ComfyUI/\n└── 📂models/\n ├── 📂diffusion_models/\n │ └── minimax_h3_fl2va_pruned_int8_convrot.safetensors\n ├── 📂text_encoders/\n │ └── qwen3vl_32b_minimax_h3_int8_convrot.safetensors\n └── 📂vae/\n ├── minimax_h3_audio_vae_fp32.safetensors\n └── minimax_h3_video_vae_fp16.safetensors\n```"
},
"color": "#323",
"bgcolor": "#535"
},
{
"id": 97,
"type": "ResizeImageMaskNode",
"pos": [
-786.7951171475131,
592.6500707410756
],
"size": [
270,
106
],
"flags": {},
"order": 12,
"mode": 0,
"inputs": [
{
"name": "input",
"type": "IMAGE,MASK",
"link": 167
}
],
"outputs": [
{
"name": "resized",
"type": "IMAGE",
"links": [
168
]
}
],
"properties": {
"Node name for S&R": "ResizeImageMaskNode"
},
"widgets_values": [
"scale total pixels",
1,
"bicubic"
],
"widgets_values_named": {
"resize_type": "scale total pixels",
"resize_type.megapixels": 1,
"scale_method": "bicubic"
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 104,
"type": "ComfyMathExpression",
"pos": [
146.85987985144288,
853.1626745477416
],
"size": [
210,
128
],
"flags": {},
"order": 22,
"mode": 0,
"inputs": [
{
"label": "a",
"name": "values.a",
"type": "FLOAT,INT,BOOLEAN",
"link": 183
},
{
"name": "values.b",
"shape": 7,
"type": "FLOAT,INT,BOOLEAN",
"link": null
}
],
"outputs": [
{
"name": "FLOAT",
"type": "FLOAT",
"links": null
},
{
"name": "INT",
"type": "INT",
"links": [
185
]
},
{
"name": "BOOL",
"type": "BOOLEAN",
"links": null
}
],
"properties": {
"Node name for S&R": "ComfyMathExpression",
"cnr_id": "comfy-core",
"ver": "0.33.0"
},
"widgets_values": [
"a / 2"
],
"widgets_values_named": {
"expression": "a / 2"
}
},
{
"id": 87,
"type": "ComfyMathExpression",
"pos": [
146.85987985144288,
1208.6257749488502
],
"size": [
210,
128
],
"flags": {},
"order": 9,
"mode": 0,
"inputs": [
{
"label": "a",
"name": "values.a",
"type": "FLOAT,INT,BOOLEAN",
"link": 166
},
{
"name": "values.b",
"shape": 7,
"type": "FLOAT,INT,BOOLEAN",
"link": null
}
],
"outputs": [
{
"name": "FLOAT",
"type": "FLOAT",
"links": null
},
{
"name": "INT",
"type": "INT",
"links": [
178,
207
]
},
{
"name": "BOOL",
"type": "BOOLEAN",
"links": null
}
],
"properties": {
"Node name for S&R": "ComfyMathExpression",
"cnr_id": "comfy-core",
"ver": "0.33.0"
},
"widgets_values": [
"17 * round((a * 24 - 5) / 17) + 5"
],
"widgets_values_named": {
"expression": "17 * round((a * 24 - 5) / 17) + 5"
}
},
{
"id": 107,
"type": "LTXVSeparateAVLatent",
"pos": [
1174.115610086879,
263.27638134492935
],
"size": [
194.25299723441972,
46
],
"flags": {},
"order": 30,
"mode": 0,
"inputs": [
{
"name": "av_latent",
"type": "LATENT",
"link": 189
}
],
"outputs": [
{
"name": "video_latent",
"type": "LATENT",
"links": [
186
]
},
{
"name": "audio_latent",
"type": "LATENT",
"links": [
188
]
}
],
"properties": {
"Node name for S&R": "LTXVSeparateAVLatent"
},
"color": "#332922",
"bgcolor": "#593930"
},
{
"id": 38,
"type": "CLIPLoader",
"pos": [
52.62317611836556,
188.1918182373047
],
"size": [
301.3524169921875,
106
],
"flags": {},
"order": 3,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "CLIP",
"type": "CLIP",
"slot_index": 0,
"links": [
174,
191
]
}
],
"properties": {
"Node name for S&R": "CLIPLoader",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
"qwen3vl_32b_minimax_h3_int8_convrot.safetensors",
"minimax",
"default"
],
"widgets_values_named": {
"clip_name": "qwen3vl_32b_minimax_h3_int8_convrot.safetensors",
"type": "minimax",
"device": "default"
},
"color": "#432",
"bgcolor": "#653"
},
{
"id": 99,
"type": "Reroute",
"pos": [
281.8598798514429,
592.6500707410756
],
"size": [
75,
26
],
"flags": {},
"order": 17,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 169
}
],
"outputs": [
{
"name": "",
"type": "IMAGE",
"links": [
171,
198
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 3,
"type": "KSampler",
"pos": [
818.8072456703378,
188.1918182373047
],
"size": [
315,
262
],
"flags": {},
"order": 28,
"mode": 0,
"inputs": [
{
"name": "model",
"type": "MODEL",
"link": 164
},
{
"name": "positive",
"type": "CONDITIONING",
"link": 176
},
{
"name": "negative",
"type": "CONDITIONING",
"link": 130
},
{
"name": "latent_image",
"type": "LATENT",
"link": 177
}
],
"outputs": [
{
"name": "LATENT",
"type": "LATENT",
"slot_index": 0,
"links": [
189
]
}
],
"properties": {
"Node name for S&R": "KSampler",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
1234,
"fixed",
20,
1,
"euler",
"simple",
1
],
"widgets_values_named": {
"seed": 1234,
"control_after_generate": "fixed",
"steps": 20,
"cfg": 1,
"sampler_name": "euler",
"scheduler": "simple",
"denoise": 1
}
},
{
"id": 101,
"type": "MiniMaxH3ImageToVideo",
"pos": [
434.27961405604844,
188.1918182373047
],
"size": [
338.26023712310575,
220
],
"flags": {},
"order": 24,
"mode": 0,
"inputs": [
{
"name": "clip",
"type": "CLIP",
"link": 174
},
{
"name": "vae",
"type": "VAE",
"link": 175
},
{
"name": "first_frame",
"shape": 7,
"type": "IMAGE",
"link": 171
},
{
"name": "last_frame",
"shape": 7,
"type": "IMAGE",
"link": null
},
{
"name": "prompt",
"type": "STRING",
"widget": {
"name": "prompt"
},
"link": 192
},
{
"name": "width",
"type": "INT",
"widget": {
"name": "width"
},
"link": 184
},
{
"name": "height",
"type": "INT",
"widget": {
"name": "height"
},
"link": 185
},
{
"name": "length",
"type": "INT",
"widget": {
"name": "length"
},
"link": 178
}
],
"outputs": [
{
"name": "positive",
"type": "CONDITIONING",
"links": [
176,
179
]
},
{
"name": "LATENT",
"type": "LATENT",
"links": [
177
]
}
],
"properties": {
"Node name for S&R": "MiniMaxH3ImageToVideo"
},
"widgets_values": [
"integrated_multimodal_description:\n[Shot 1] Single continuous shot, one take. Use the input image as the exact starting point. Preserve the woman, the sofa, the room layout, the bookshelf, the table, the coffee cup on the table, the lighting, and the painterly visual style of the image.\n\nThe camera is completely locked off and does not shake.\n\nThe woman is sitting on the sofa exactly as in the input image, with empty hands. She is not holding a fork or any other object. After a short pause, she gently leans her upper body to the left. Then, using that small counter-motion, she lets her body tip and collapse toward the right side, falling onto the right cushion and ending in a reclined, sprawled position across the sofa. She does not fall off the sofa.\n\nHer movement should not look like smooth traced live-action motion. It should feel stylized, painterly, and slightly imperfect, with more animation-like timing and slightly simplified, uneven physical behavior. It is acceptable for the motion to feel a little physically incorrect in a natural stylized way. The action should read clearly, but it should not feel overly fluid or overly realistic.\n\nThe background remains mostly still. The plant leaves move only slightly, with irregular, subtle, painterly motion that matches the visual style of the image. Their movement should feel limited and uneven rather than smooth or repetitive.\n\noverall_soundscape:\nSoft indoor ambience, subtle room tone, light fabric rustling as she shifts and falls onto the cushion, and faint small tableware presence from the coffee on the table. No dramatic impact sound.\n\nnon_diegetic_music:\nN/A",
1344,
768,
124
],
"widgets_values_named": {
"prompt": "integrated_multimodal_description:\n[Shot 1] Single continuous shot, one take. Use the input image as the exact starting point. Preserve the woman, the sofa, the room layout, the bookshelf, the table, the coffee cup on the table, the lighting, and the painterly visual style of the image.\n\nThe camera is completely locked off and does not shake.\n\nThe woman is sitting on the sofa exactly as in the input image, with empty hands. She is not holding a fork or any other object. After a short pause, she gently leans her upper body to the left. Then, using that small counter-motion, she lets her body tip and collapse toward the right side, falling onto the right cushion and ending in a reclined, sprawled position across the sofa. She does not fall off the sofa.\n\nHer movement should not look like smooth traced live-action motion. It should feel stylized, painterly, and slightly imperfect, with more animation-like timing and slightly simplified, uneven physical behavior. It is acceptable for the motion to feel a little physically incorrect in a natural stylized way. The action should read clearly, but it should not feel overly fluid or overly realistic.\n\nThe background remains mostly still. The plant leaves move only slightly, with irregular, subtle, painterly motion that matches the visual style of the image. Their movement should feel limited and uneven rather than smooth or repetitive.\n\noverall_soundscape:\nSoft indoor ambience, subtle room tone, light fabric rustling as she shifts and falls onto the cushion, and faint small tableware presence from the coffee on the table. No dramatic impact sound.\n\nnon_diegetic_music:\nN/A",
"width": 1344,
"height": 768,
"length": 124
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 113,
"type": "Reroute",
"pos": [
1905.681439237728,
592.6500707410756
],
"size": [
75,
26
],
"flags": {},
"order": 19,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 198
}
],
"outputs": [
{
"name": "",
"type": "IMAGE",
"links": [
199
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 100,
"type": "GetImageSize",
"pos": [
-136.5859971544101,
997.5710151195559
],
"size": [
210,
136
],
"flags": {},
"order": 18,
"mode": 0,
"inputs": [
{
"name": "image",
"type": "IMAGE",
"link": 170
}
],
"outputs": [
{
"name": "width",
"type": "INT",
"links": [
182,
200
]
},
{
"name": "height",
"type": "INT",
"links": [
183,
203
]
},
{
"name": "batch_size",
"type": "INT",
"links": []
}
],
"properties": {
"Node name for S&R": "GetImageSize"
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 117,
"type": "Reroute",
"pos": [
151.7672387140089,
1039.9978681149084
],
"size": [
75,
26
],
"flags": {},
"order": 23,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"widget": {
"name": "value"
},
"link": 203
}
],
"outputs": [
{
"name": "",
"type": "INT",
"links": [
204
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 114,
"type": "Reroute",
"pos": [
1905.681439237728,
997.5710151195559
],
"size": [
75,
26
],
"flags": {},
"order": 21,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"widget": {
"name": "value"
},
"link": 200
}
],
"outputs": [
{
"name": "",
"type": "INT",
"links": [
205
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 116,
"type": "Reroute",
"pos": [
1905.681439237728,
1039.9978681149084
],
"size": [
75,
26
],
"flags": {},
"order": 25,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"widget": {
"name": "value"
},
"link": 204
}
],
"outputs": [
{
"name": "",
"type": "INT",
"links": [
206
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 118,
"type": "Reroute",
"pos": [
1905.681439237728,
1230
],
"size": [
75,
26
],
"flags": {},
"order": 14,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"widget": {
"name": "value"
},
"link": 207
}
],
"outputs": [
{
"name": "",
"type": "INT",
"links": [
208
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 91,
"type": "CreateVideo",
"pos": [
3031.6919032680566,
188.1918182373047
],
"size": [
270,
126
],
"flags": {},
"order": 36,
"mode": 0,
"inputs": [
{
"name": "images",
"type": "IMAGE",
"link": 159
},
{
"name": "audio",
"shape": 7,
"type": "AUDIO",
"link": 160
}
],
"outputs": [
{
"name": "VIDEO",
"type": "VIDEO",
"links": [
158
]
}
],
"properties": {
"Node name for S&R": "CreateVideo",
"cnr_id": "comfy-core",
"ver": "0.33.0"
},
"widgets_values": [
24,
8,
"sRGB"
],
"widgets_values_named": {
"fps": 24,
"bit_depth": 8,
"color_space": "sRGB"
}
},
{
"id": 112,
"type": "KSampler",
"pos": [
2419.843124784804,
188.1918182373047
],
"size": [
315,
262
],
"flags": {},
"order": 33,
"mode": 0,
"inputs": [
{
"name": "model",
"type": "MODEL",
"link": 212
},
{
"name": "positive",
"type": "CONDITIONING",
"link": 195
},
{
"name": "negative",
"type": "CONDITIONING",
"link": 196
},
{
"name": "latent_image",
"type": "LATENT",
"link": 215
}
],
"outputs": [
{
"name": "LATENT",
"type": "LATENT",
"slot_index": 0,
"links": [
209,
210
]
}
],
"properties": {
"Node name for S&R": "KSampler",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
1234,
"fixed",
10,
1,
"euler",
"simple",
0.4
],
"widgets_values_named": {
"seed": 1234,
"control_after_generate": "fixed",
"steps": 10,
"cfg": 1,
"sampler_name": "euler",
"scheduler": "simple",
"denoise": 0.4
}
},
{
"id": 77,
"type": "VAEDecodeAudio",
"pos": [
2796.8662161802217,
287.56047077038255
],
"size": [
194.25299723441972,
46
],
"flags": {},
"order": 35,
"mode": 0,
"inputs": [
{
"name": "samples",
"type": "LATENT",
"link": 210
},
{
"name": "vae",
"type": "VAE",
"link": 150
}
],
"outputs": [
{
"name": "AUDIO",
"type": "AUDIO",
"links": [
160
]
}
],
"properties": {
"Node name for S&R": "VAEDecodeAudio",
"cnr_id": "comfy-core",
"ver": "0.30.0"
}
},
{
"id": 98,
"type": "ResizeImageMaskNode",
"pos": [
-480.0318741602632,
592.6500707410756
],
"size": [
270,
106
],
"flags": {},
"order": 15,
"mode": 0,
"inputs": [
{
"name": "input",
"type": "IMAGE,MASK",
"link": 168
}
],
"outputs": [
{
"name": "resized",
"type": "IMAGE",
"links": [
169,
170
]
}
],
"properties": {
"Node name for S&R": "ResizeImageMaskNode"
},
"widgets_values": [
"scale to multiple",
64,
"bicubic"
],
"widgets_values_named": {
"resize_type": "scale to multiple",
"resize_type.multiple": 64,
"scale_method": "bicubic"
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 119,
"type": "Reroute",
"pos": [
2298.57573029362,
-210.56656545542015
],
"size": [
75,
26
],
"flags": {},
"order": 16,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 211
}
],
"outputs": [
{
"name": "",
"type": "MODEL",
"links": [
212
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 110,
"type": "MiniMaxH3ImageToVideo",
"pos": [
2026.9488337289113,
188.1918182373047
],
"size": [
346.62689656470866,
220
],
"flags": {},
"order": 27,
"mode": 0,
"inputs": [
{
"name": "clip",
"type": "CLIP",
"link": 191
},
{
"name": "vae",
"type": "VAE",
"link": 214
},
{
"name": "first_frame",
"shape": 7,
"type": "IMAGE",
"link": 199
},
{
"name": "last_frame",
"shape": 7,
"type": "IMAGE",
"link": null
},
{
"name": "prompt",
"type": "STRING",
"widget": {
"name": "prompt"
},
"link": 193
},
{
"name": "width",
"type": "INT",
"widget": {
"name": "width"
},
"link": 205
},
{
"name": "height",
"type": "INT",
"widget": {
"name": "height"
},
"link": 206
},
{
"name": "length",
"type": "INT",
"widget": {
"name": "length"
},
"link": 208
}
],
"outputs": [
{
"name": "positive",
"type": "CONDITIONING",
"links": [
190,
195
]
},
{
"name": "LATENT",
"type": "LATENT",
"links": []
}
],
"properties": {
"Node name for S&R": "MiniMaxH3ImageToVideo"
},
"widgets_values": [
"integrated_multimodal_description:\n[Shot 1] Single continuous shot, one take. Use the input image as the exact starting point. Preserve the woman, the sofa, the room layout, the bookshelf, the table, the coffee cup on the table, the lighting, and the painterly visual style of the image.\n\nThe camera is completely locked off and does not shake.\n\nThe woman is sitting on the sofa exactly as in the input image, with empty hands. She is not holding a fork or any other object. After a short pause, she gently leans her upper body to the left. Then, using that small counter-motion, she lets her body tip and collapse toward the right side, falling onto the right cushion and ending in a reclined, sprawled position across the sofa. She does not fall off the sofa.\n\nHer movement should not look like smooth traced live-action motion. It should feel stylized, painterly, and slightly imperfect, with more animation-like timing and slightly simplified, uneven physical behavior. It is acceptable for the motion to feel a little physically incorrect in a natural stylized way. The action should read clearly, but it should not feel overly fluid or overly realistic.\n\nThe background remains mostly still. The plant leaves move only slightly, with irregular, subtle, painterly motion that matches the visual style of the image. Their movement should feel limited and uneven rather than smooth or repetitive.\n\noverall_soundscape:\nSoft indoor ambience, subtle room tone, light fabric rustling as she shifts and falls onto the cushion, and faint small tableware presence from the coffee on the table. No dramatic impact sound.\n\nnon_diegetic_music:\nN/A",
1344,
768,
124
],
"widgets_values_named": {
"prompt": "integrated_multimodal_description:\n[Shot 1] Single continuous shot, one take. Use the input image as the exact starting point. Preserve the woman, the sofa, the room layout, the bookshelf, the table, the coffee cup on the table, the lighting, and the painterly visual style of the image.\n\nThe camera is completely locked off and does not shake.\n\nThe woman is sitting on the sofa exactly as in the input image, with empty hands. She is not holding a fork or any other object. After a short pause, she gently leans her upper body to the left. Then, using that small counter-motion, she lets her body tip and collapse toward the right side, falling onto the right cushion and ending in a reclined, sprawled position across the sofa. She does not fall off the sofa.\n\nHer movement should not look like smooth traced live-action motion. It should feel stylized, painterly, and slightly imperfect, with more animation-like timing and slightly simplified, uneven physical behavior. It is acceptable for the motion to feel a little physically incorrect in a natural stylized way. The action should read clearly, but it should not feel overly fluid or overly realistic.\n\nThe background remains mostly still. The plant leaves move only slightly, with irregular, subtle, painterly motion that matches the visual style of the image. Their movement should feel limited and uneven rather than smooth or repetitive.\n\noverall_soundscape:\nSoft indoor ambience, subtle room tone, light fabric rustling as she shifts and falls onto the cushion, and faint small tableware presence from the coffee on the table. No dramatic impact sound.\n\nnon_diegetic_music:\nN/A",
"width": 1344,
"height": 768,
"length": 124
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 39,
"type": "VAELoader",
"pos": [
52.62317611836556,
-59.89911033344882
],
"size": [
301.3524169921875,
58
],
"flags": {},
"order": 4,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "VAE",
"type": "VAE",
"slot_index": 0,
"links": [
139,
175,
213
]
}
],
"properties": {
"Node name for S&R": "VAELoader",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
"minimax_h3_video_vae_fp16.safetensors"
],
"widgets_values_named": {
"vae_name": "minimax_h3_video_vae_fp16.safetensors"
},
"color": "#322",
"bgcolor": "#533"
},
{
"id": 120,
"type": "Reroute",
"pos": [
1905.681439237728,
-59.89911033344882
],
"size": [
75,
26
],
"flags": {},
"order": 11,
"mode": 0,
"inputs": [
{
"name": "",
"type": "*",
"link": 213
}
],
"outputs": [
{
"name": "",
"type": "VAE",
"links": [
214
]
}
],
"properties": {
"showOutputText": false,
"horizontal": false
}
},
{
"id": 108,
"type": "LTXVConcatAVLatent",
"pos": [
1780.469411928666,
263.27638134492935
],
"size": [
194.25299723441972,
46
],
"flags": {},
"order": 32,
"mode": 0,
"inputs": [
{
"name": "video_latent",
"type": "LATENT",
"link": 187
},
{
"name": "audio_latent",
"type": "LATENT",
"link": 188
}
],
"outputs": [
{
"name": "latent",
"type": "LATENT",
"links": [
215
]
}
],
"properties": {
"Node name for S&R": "LTXVConcatAVLatent"
},
"color": "#332922",
"bgcolor": "#593930"
},
{
"id": 106,
"type": "MinimaxH3LatentUpscaler3D",
"pos": [
1414.6360018124824,
263.27638134492935
],
"size": [
319.566015625,
226
],
"flags": {},
"order": 31,
"mode": 0,
"inputs": [
{
"name": "latent",
"type": "*",
"link": 186
}
],
"outputs": [
{
"name": "latent",
"type": "*",
"links": [
187
]
}
],
"properties": {
"Node name for S&R": "MinimaxH3LatentUpscaler3D"
},
"widgets_values": [
"minimax_h3_latent_upscaler_3d_bf16.safetensors",
"scale by multiplier",
2,
32,
true,
"cuda",
"fp16",
false
],
"widgets_values_named": {
"model_name": "minimax_h3_latent_upscaler_3d_bf16.safetensors",
"mode": "scale by multiplier",
"mode.scale": 2,
"align": 32,
"keep_proportion": true,
"device": "cuda",
"precision": "fp16",
"offload_after_upscale": false
},
"color": "#332922",
"bgcolor": "#593930"
},
{
"id": 105,
"type": "ComfyMathExpression",
"pos": [
146.85987985144288,
680.8680843333011
],
"size": [
210,
128
],
"flags": {},
"order": 20,
"mode": 0,
"inputs": [
{
"label": "a",
"name": "values.a",
"type": "FLOAT,INT,BOOLEAN",
"link": 182
},
{
"name": "values.b",
"shape": 7,
"type": "FLOAT,INT,BOOLEAN",
"link": null
}
],
"outputs": [
{
"name": "FLOAT",
"type": "FLOAT",
"links": null
},
{
"name": "INT",
"type": "INT",
"links": [
184
]
},
{
"name": "BOOL",
"type": "BOOLEAN",
"links": null
}
],
"properties": {
"Node name for S&R": "ComfyMathExpression",
"cnr_id": "comfy-core",
"ver": "0.33.0"
},
"widgets_values": [
"a / 2"
],
"widgets_values_named": {
"expression": "a / 2"
}
},
{
"id": 96,
"type": "LoadImage",
"pos": [
-1322.5702547601131,
592.6500707410756
],
"size": [
499.0118946253501,
409.63972524215967
],
"flags": {},
"order": 5,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "IMAGE",
"type": "IMAGE",
"links": [
167
]
},
{
"name": "MASK",
"type": "MASK",
"links": null
}
],
"properties": {
"Node name for S&R": "LoadImage"
},
"widgets_values": [
"ComfyUI_05011_.png",
"image"
],
"widgets_values_named": {
"image": "ComfyUI_05011_.png",
"upload": "image"
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 86,
"type": "ModelAttentionBackend",
"pos": [
502.5398511791542,
-210.56656545542015
],
"size": [
270,
58
],
"flags": {},
"order": 13,
"mode": 0,
"inputs": [
{
"name": "model",
"type": "MODEL",
"link": 163
}
],
"outputs": [
{
"name": "model",
"type": "MODEL",
"links": [
164,
211
]
}
],
"properties": {
"Node name for S&R": "ModelAttentionBackend"
},
"widgets_values": [
"comfy kitchen attention"
],
"widgets_values_named": {
"attention": "comfy kitchen attention"
}
},
{
"id": 37,
"type": "UNETLoader",
"pos": [
156.5403130152688,
-210.56656545542015
],
"size": [
305.3782043457031,
82
],
"flags": {},
"order": 6,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "MODEL",
"type": "MODEL",
"slot_index": 0,
"links": [
163
]
}
],
"properties": {
"Node name for S&R": "UNETLoader",
"cnr_id": "comfy-core",
"ver": "0.3.33"
},
"widgets_values": [
"minimax_h3_fl2va_pruned_int8_convrot.safetensors",
"default"
],
"widgets_values_named": {
"unet_name": "minimax_h3_fl2va_pruned_int8_convrot.safetensors",
"weight_dtype": "default"
},
"color": "#323",
"bgcolor": "#535"
},
{
"id": 92,
"type": "SaveVideo",
"pos": [
3343.0046406996676,
188.1918182373047
],
"size": [
1011.5388371018557,
627.8536765771626
],
"flags": {},
"order": 37,
"mode": 0,
"inputs": [
{
"name": "video",
"type": "VIDEO",
"link": 158
}
],
"outputs": [
{
"name": "video",
"type": "VIDEO",
"links": null
}
],
"properties": {
"cnr_id": "comfy-core",
"ver": "0.33.0"
},
"widgets_values": [
"video/ComfyUI",
"auto",
"auto",
"auto"
],
"widgets_values_named": {
"filename_prefix": "video/ComfyUI",
"format": "auto",
"format.codec": "auto",
"codec": "auto"
}
},
{
"id": 111,
"type": "PrimitiveNode",
"pos": [
55.507462859255384,
356.57421966691356
],
"size": [
301.3524169921875,
170.19960636851056
],
"flags": {},
"order": 7,
"mode": 0,
"inputs": [],
"outputs": [
{
"name": "STRING",
"type": "STRING",
"widget": {
"name": "prompt"
},
"links": [
192,
193
]
}
],
"title": "prompt",
"properties": {
"Run widget replace on values": false
},
"widgets_values": [
"integrated_multimodal_description:\n[Shot 1] Single continuous shot, one take. Use the input image as the exact starting point. Preserve the woman, the sofa, the room layout, the bookshelf, the table, the coffee cup on the table, the lighting, and the painterly visual style of the image.\n\nThe camera is completely locked off and does not shake.\n\nThe woman is sitting on the sofa exactly as in the input image, with empty hands. She is not holding a fork or any other object. After a short pause, she gently leans her upper body to the left. Then, using that small counter-motion, she lets her body tip and collapse toward the right side, falling onto the right cushion and ending in a reclined, sprawled position across the sofa. She does not fall off the sofa.\n\nHer movement should not look like smooth traced live-action motion. It should feel stylized, painterly, and slightly imperfect, with more animation-like timing and slightly simplified, uneven physical behavior. It is acceptable for the motion to feel a little physically incorrect in a natural stylized way. The action should read clearly, but it should not feel overly fluid or overly realistic.\n\nThe background remains mostly still. The plant leaves move only slightly, with irregular, subtle, painterly motion that matches the visual style of the image. Their movement should feel limited and uneven rather than smooth or repetitive.\n\noverall_soundscape:\nSoft indoor ambience, subtle room tone, light fabric rustling as she shifts and falls onto the cushion, and faint small tableware presence from the coffee on the table. No dramatic impact sound.\n\nnon_diegetic_music:\nN/A"
],
"widgets_values_named": {
"value": "integrated_multimodal_description:\n[Shot 1] Single continuous shot, one take. Use the input image as the exact starting point. Preserve the woman, the sofa, the room layout, the bookshelf, the table, the coffee cup on the table, the lighting, and the painterly visual style of the image.\n\nThe camera is completely locked off and does not shake.\n\nThe woman is sitting on the sofa exactly as in the input image, with empty hands. She is not holding a fork or any other object. After a short pause, she gently leans her upper body to the left. Then, using that small counter-motion, she lets her body tip and collapse toward the right side, falling onto the right cushion and ending in a reclined, sprawled position across the sofa. She does not fall off the sofa.\n\nHer movement should not look like smooth traced live-action motion. It should feel stylized, painterly, and slightly imperfect, with more animation-like timing and slightly simplified, uneven physical behavior. It is acceptable for the motion to feel a little physically incorrect in a natural stylized way. The action should read clearly, but it should not feel overly fluid or overly realistic.\n\nThe background remains mostly still. The plant leaves move only slightly, with irregular, subtle, painterly motion that matches the visual style of the image. Their movement should feel limited and uneven rather than smooth or repetitive.\n\noverall_soundscape:\nSoft indoor ambience, subtle room tone, light fabric rustling as she shifts and falls onto the cushion, and faint small tableware presence from the coffee on the table. No dramatic impact sound.\n\nnon_diegetic_music:\nN/A"
},
"color": "#232",
"bgcolor": "#353"
},
{
"id": 109,
"type": "ConditioningZeroOut",
"pos": [
2155.1410452350265,
466.7764104457844
],
"size": [
218.4346850585937,
26
],
"flags": {},
"order": 29,
"mode": 0,
"inputs": [
{
"name": "conditioning",
"type": "CONDITIONING",
"link": 190
}
],
"outputs": [
{
"name": "CONDITIONING",
"type": "CONDITIONING",
"links": [
196
]
}
],
"properties": {
"Node name for S&R": "ConditioningZeroOut",
"cnr_id": "comfy-core",
"ver": "0.30.0"
}
},
{
"id": 75,
"type": "ConditioningZeroOut",
"pos": [
554.1051661205605,
466.7764104457844
],
"size": [
218.4346850585937,
26
],
"flags": {},
"order": 26,
"mode": 0,
"inputs": [
{
"name": "conditioning",
"type": "CONDITIONING",
"link": 179
}
],
"outputs": [
{
"name": "CONDITIONING",
"type": "CONDITIONING",
"links": [
130
]
}
],
"properties": {
"Node name for S&R": "ConditioningZeroOut",
"cnr_id": "comfy-core",
"ver": "0.30.0"
}
}
],
"links": [
[
130,
75,
0,
3,
2,
"CONDITIONING"
],
[
139,
39,
0,
79,
0,
"VAE"
],
[
140,
79,
0,
8,
1,
"VAE"
],
[
149,
81,
0,
82,
0,
"VAE"
],
[
150,
82,
0,
77,
1,
"VAE"
],
[
158,
91,
0,
92,
0,
"VIDEO"
],
[
159,
8,
0,
91,
0,
"IMAGE"
],
[
160,
77,
0,
91,
1,
"AUDIO"
],
[
163,
37,
0,
86,
0,
"MODEL"
],
[
164,
86,
0,
3,
0,
"MODEL"
],
[
166,
94,
0,
87,
0,
"FLOAT"
],
[
167,
96,
0,
97,
0,
"IMAGE"
],
[
168,
97,
0,
98,
0,
"IMAGE"
],
[
169,
98,
0,
99,
0,
"IMAGE"
],
[
170,
98,
0,
100,
0,
"IMAGE"
],
[
171,
99,
0,
101,
2,
"IMAGE"
],
[
174,
38,
0,
101,
0,
"CLIP"
],
[
175,
39,
0,
101,
1,
"VAE"
],
[
176,
101,
0,
3,
1,
"CONDITIONING"
],
[
177,
101,
1,
3,
3,
"LATENT"
],
[
178,
87,
1,
101,
7,
"INT"
],
[
179,
101,
0,
75,
0,
"CONDITIONING"
],
[
182,
100,
0,
105,
0,
"INT"
],
[
183,
100,
1,
104,
0,
"INT"
],
[
184,
105,
1,
101,
5,
"INT"
],
[
185,
104,
1,
101,
6,
"INT"
],
[
186,
107,
0,
106,
0,
"LATENT"
],
[
187,
106,
0,
108,
0,
"LATENT"
],
[
188,
107,
1,
108,
1,
"LATENT"
],
[
189,
3,
0,
107,
0,
"LATENT"
],
[
190,
110,
0,
109,
0,
"CONDITIONING"
],
[
191,
38,
0,
110,
0,
"CLIP"
],
[
192,
111,
0,
101,
4,
"STRING"
],
[
193,
111,
0,
110,
4,
"STRING"
],
[
195,
110,
0,
112,
1,
"CONDITIONING"
],
[
196,
109,
0,
112,
2,
"CONDITIONING"
],
[
198,
99,
0,
113,
0,
"IMAGE"
],
[
199,
113,
0,
110,
2,
"IMAGE"
],
[
200,
100,
0,
114,
0,
"INT"
],
[
203,
100,
1,
117,
0,
"INT"
],
[
204,
117,
0,
116,
0,
"INT"
],
[
205,
114,
0,
110,
5,
"INT"
],
[
206,
116,
0,
110,
6,
"INT"
],
[
207,
87,
1,
118,
0,
"INT"
],
[
208,
118,
0,
110,
7,
"INT"
],
[
209,
112,
0,
8,
0,
"LATENT"
],
[
210,
112,
0,
77,
0,
"LATENT"
],
[
211,
86,
0,
119,
0,
"MODEL"
],
[
212,
119,
0,
112,
0,
"MODEL"
],
[
213,
39,
0,
120,
0,
"VAE"
],
[
214,
120,
0,
110,
1,
"VAE"
],
[
215,
108,
0,
112,
3,
"LATENT"
]
],
"groups": [],
"config": {},
"extra": {
"ds": {
"scale": 0.2673486306413783,
"offset": [
2250.92434362,
864.199350594036
]
},
"frontendVersion": "1.51.10",
"VHS_latentpreview": false,
"VHS_latentpreviewrate": 0,
"VHS_MetadataImage": true,
"VHS_KeepIntermediate": true
},
"version": 0.4
}
在 I2VA 和 Ref2VA 中,Conditioning 侧也需要输入分辨率。
第 1 阶段需要设为 0.25 MP,第 2 阶段则要把宽度和高度分别放大 2 倍,设为 1.0 MP,因此工作流会稍微复杂一些……
输出示例