什么是 LTX 2.5?
LTX 2.5 是 Lightricks 视频生成模型继 LTX-2、LTX 2.3 之后的新版本。
基本机制与 LTX 2.3 相同,不过它不只是让输出变得更漂亮,还带来了几项较大的改进。
- Multi-shot
- 一次生成多个镜头
- Gemma 4 Text Encoder
- Text Encoder 从 Gemma 3 改为 Gemma 4
- Diffusion Decoder
- 不再使用 VAE Decode,而是用扩散模型从 latent 还原视频
- 思路和 PiD 比较接近
除此之外还有一些改进,不过如果是在 ComfyUI 中使用,暂时知道这些就够了。
推荐设置
- 分辨率
- 必须是 32 的倍数
- FPS
- 不限制为几个固定值
- 默认值是 24 FPS
- 帧数
- 必须是
8n + 1
- 必须是
- 视频最长长度
- 481 帧
- 24 FPS 时约为 20 秒
模型下载
LTX 2.5 的模型需要认证才能下载。请用 Hugging Face 账号登录,然后在 LTX-2.5 的页面 点击
Agree and Access。后面使用的 IC-LoRA,也需要在各自的页面上同样点击同意。
- diffusion_models
- latent_upscale_models
- text_encoders
- vae
- ltx-2.5-video-vae-bf16.safetensors (1.47 GB)
- ltx-2.5-audio-vae-bf16.safetensors (365 MB)
📂ComfyUI/
└── 📂models/
    ├── 📂diffusion_models/
    │   └── ltx-2.5-22b-distilled-transformer-comfy-int8-convrot.safetensors
    ├── 📂latent_upscale_models/
    │   └── ltx-2.5-latent-spatial-upscaler-x2-bf16-1.0.safetensors
    ├── 📂text_encoders/
    │   └── gemma4-12b-with-proj-ltx-2.5-comfy-int8-convrot.safetensors
    └── 📂vae/
        ├── ltx-2.5-video-vae-bf16.safetensors
        └── ltx-2.5-audio-vae-bf16.safetensors
text2video
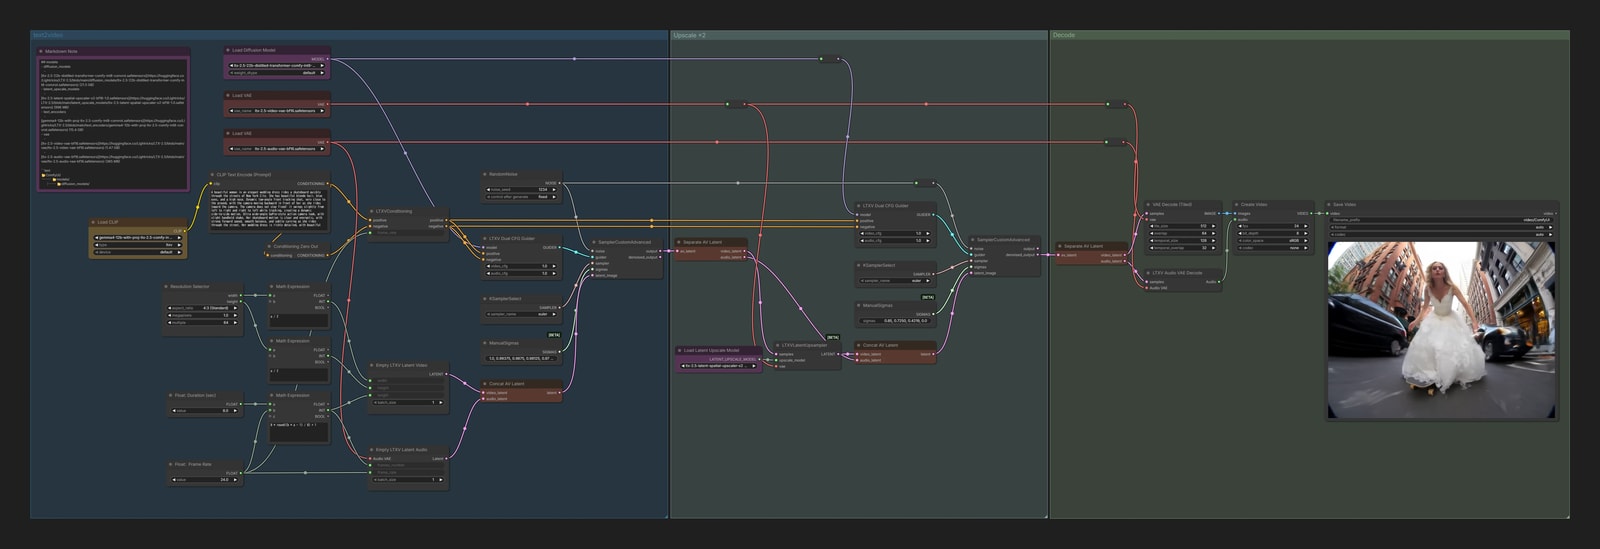
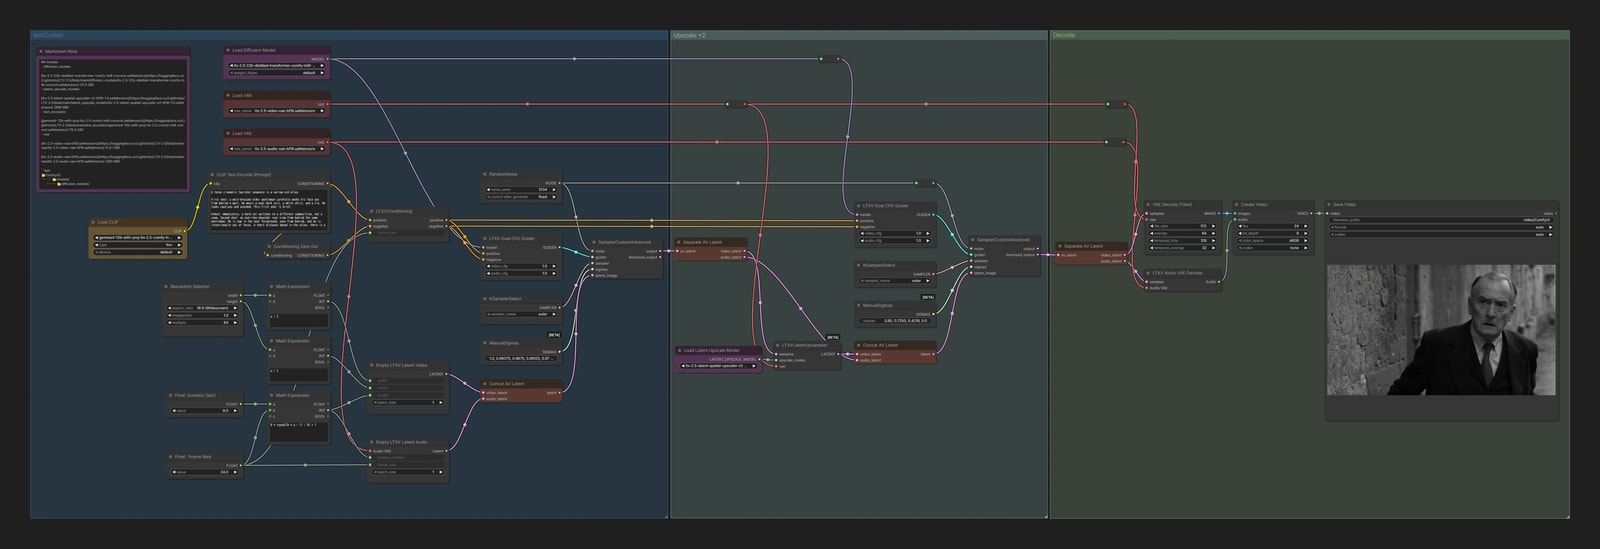
和 LTX-2 一样,这是一个 2 阶段工作流:先以目标分辨率的一半生成,再放大 2 倍。
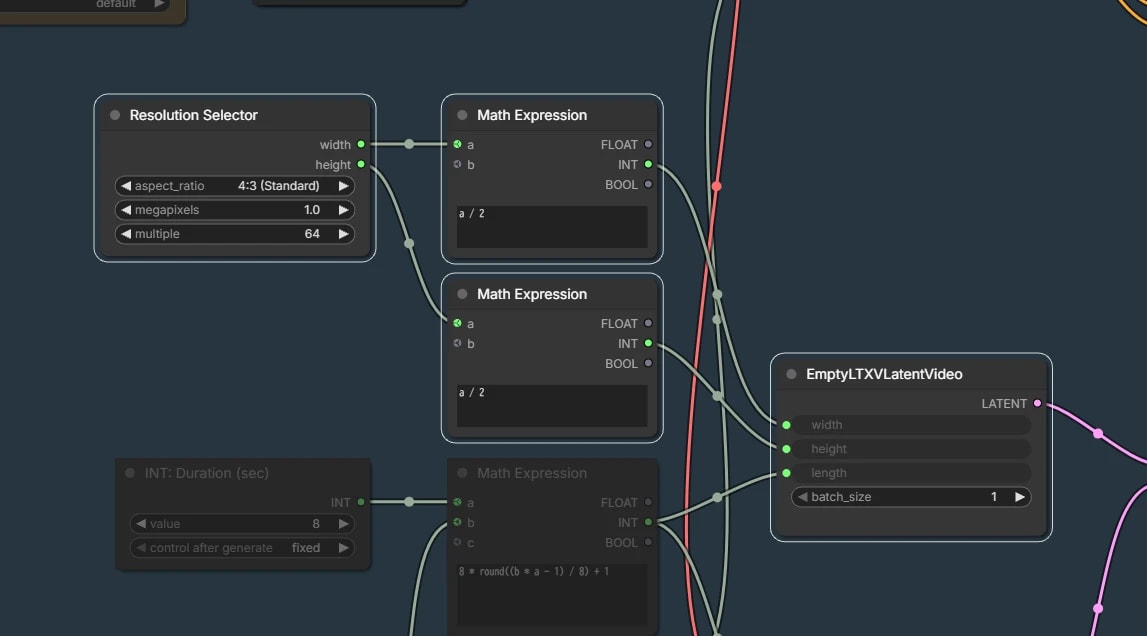
分辨率设置
之后会放大 2 倍,所以在 EmptyLTXVLatentVideo 中输入目标分辨率一半的值。
这个值也必须是 32 的倍数,因此目标宽度和高度请设为 64 的倍数。
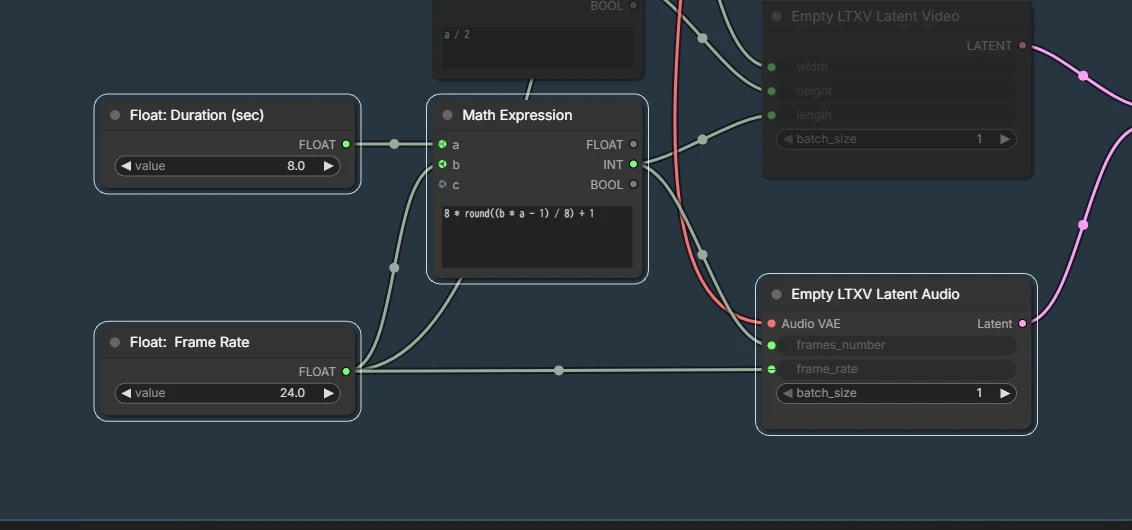
帧数设置
在这个工作流中,输入想要生成的视频秒数(sec)和 FPS 后,帧数会自动取整为合适的 8n + 1。
Multi-shot
从 Seedance 2 等模型开始,这种功能逐渐常见起来。现在一次生成就能制作多个镜头。
不需要特别的写法,只要用自然语言写出“这里切换镜头……”之类的内容,模型就会识别。
写起来很轻松,不过模型有时也不会将它识别为 Multi-shot。遇到这种情况,就耐心多试几次吧。
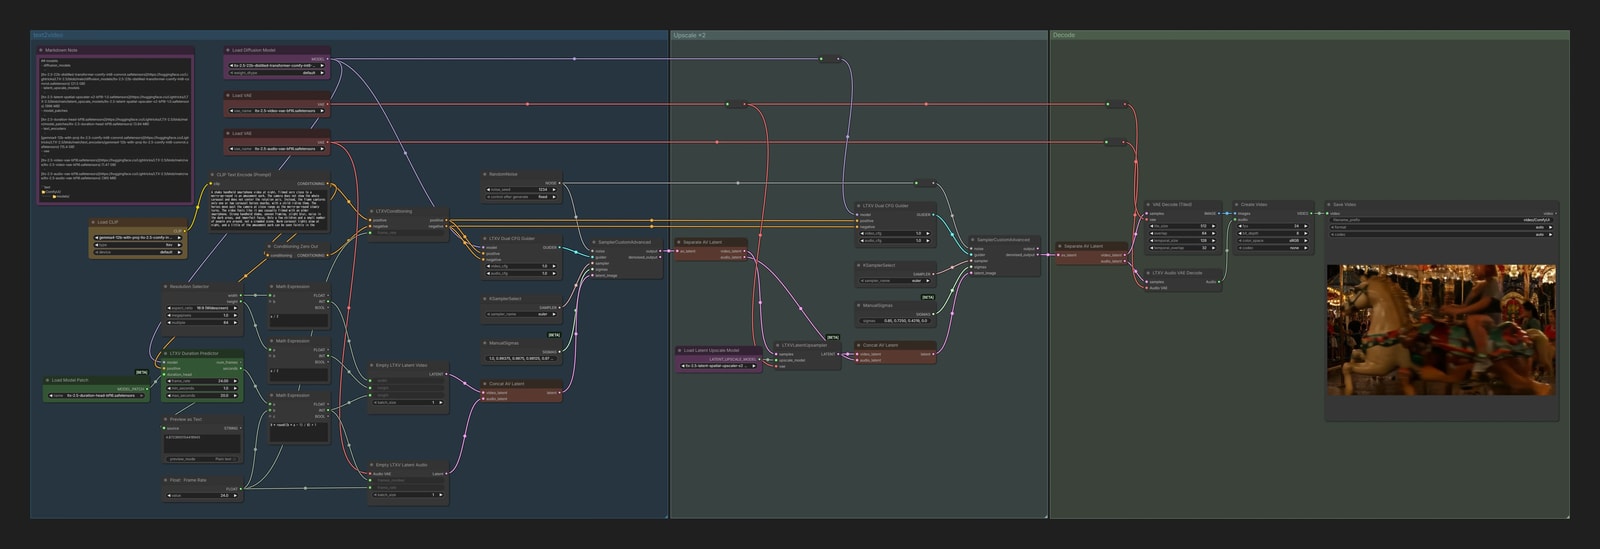
Duration Predictor
视频长度基本上需要手动设置,不过要判断这段提示词究竟适合几秒,其实也挺让人纠结的。
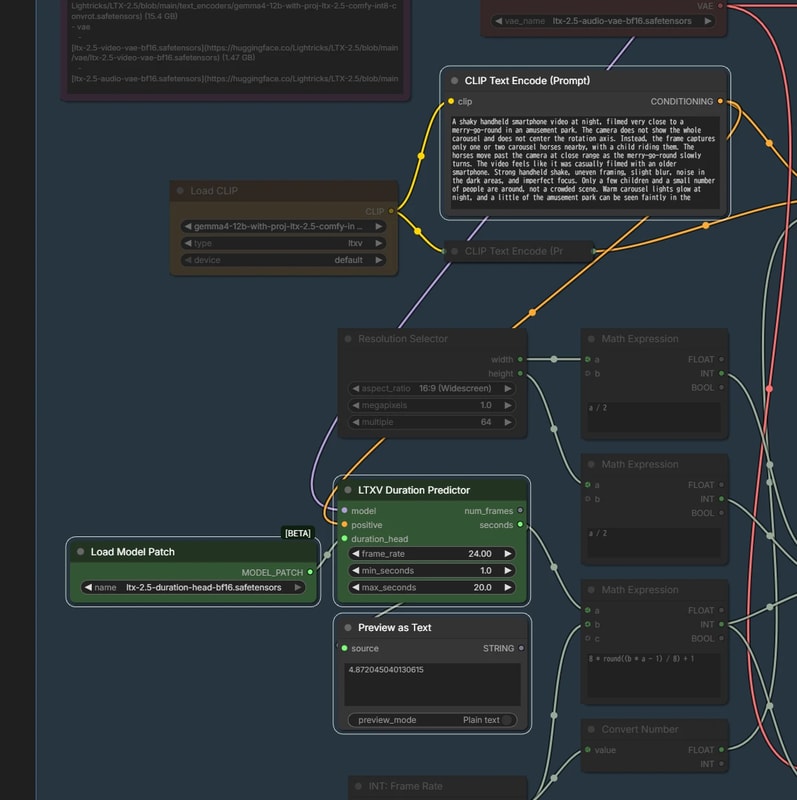
LTX 2.5 可以根据提示词内容,自动推测表现这些内容所需的视频长度。
模型下载
- model_patches
- ltx-2.5-duration-head-bf16.safetensors (3.84 MB)
📂ComfyUI/
└── 📂models/
    └── 📂model_patches/
        └── ltx-2.5-duration-head-bf16.safetensors
LTXV Duration Predictor
节点会输出根据提示词预测的帧数,再连接到普通 text2video 工作流的 length。
这毕竟只是预测,所以结果有时会比预期更短或更长。即便如此,能自动预测视频长度还是个挺有意思的功能。
image2video
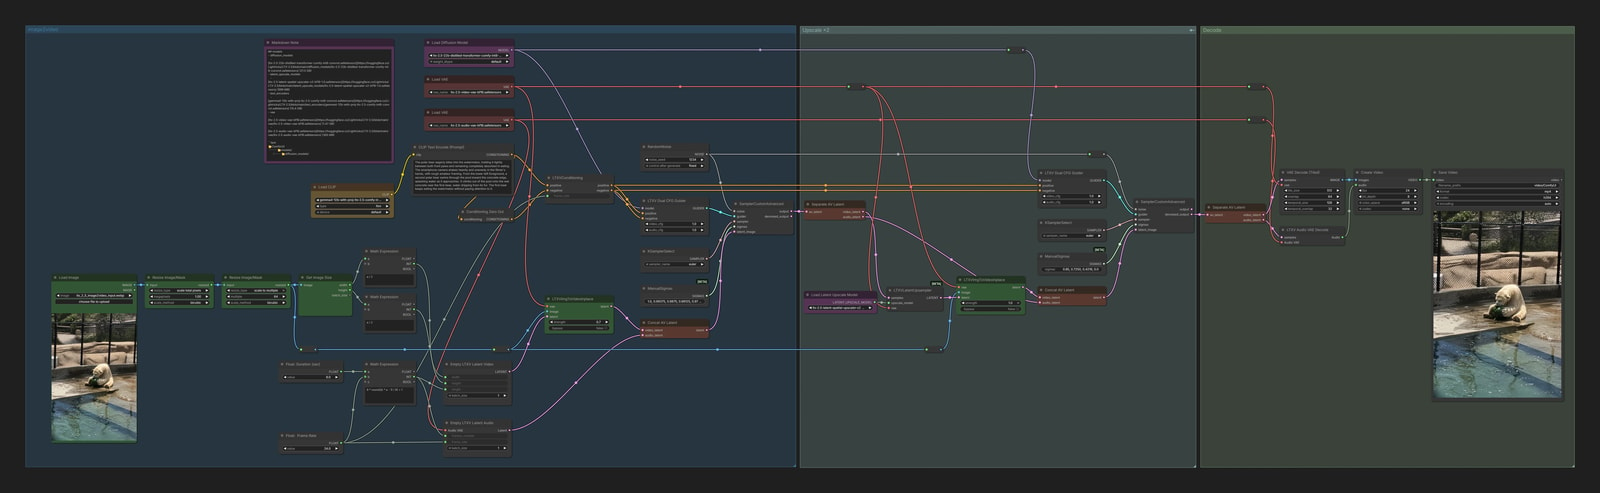
用法和 LTX 2 的 image2video 相同。使用 LTXVImgToVideoInplace 将输入图像插入为第 1 帧。
以前出于各种原因,会使用
LTXV Preprocess故意降低输入图像的质量。不过在 LTX 2.5 中,至少就我使用的情况来看似乎已经不再需要,所以这里将它去掉了。
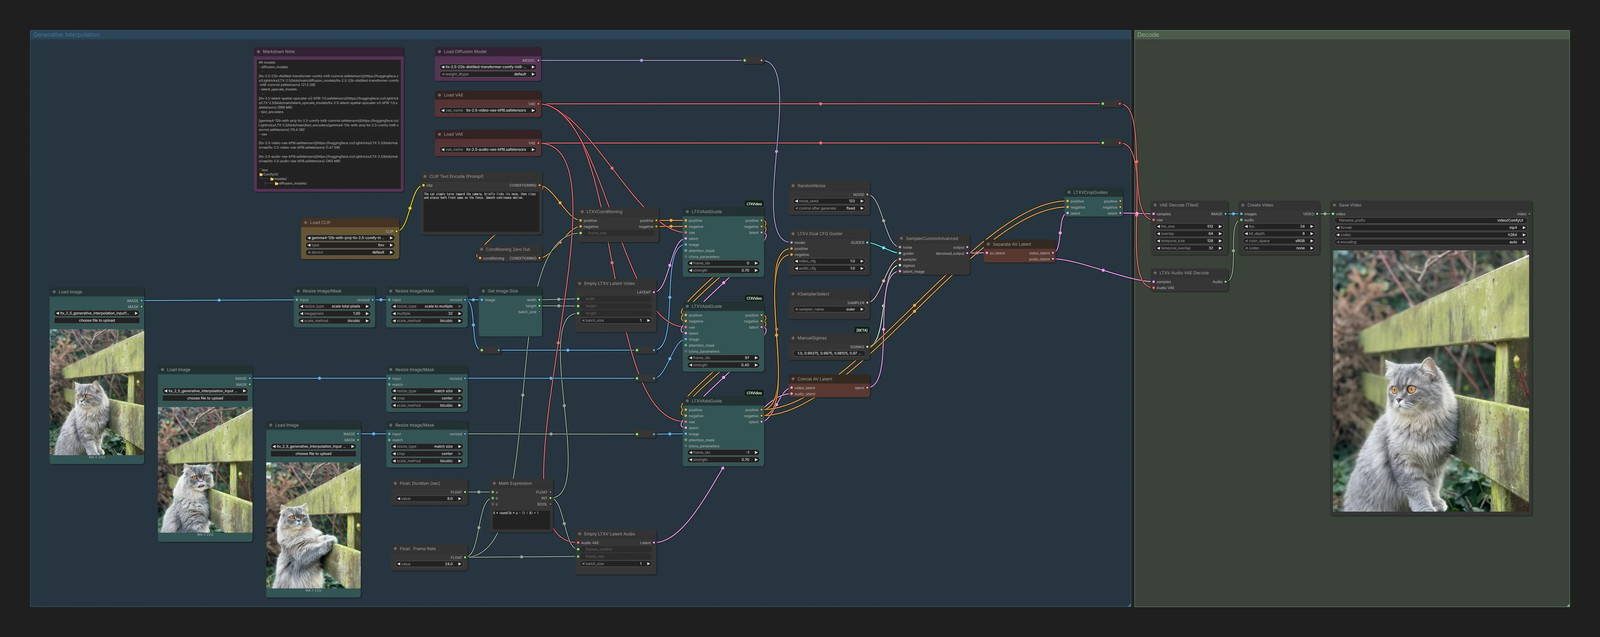
Generative Interpolation / FLF2V
将任意数量的图像交给模型,让它流畅地填补图像之间的内容。
如果只指定视频的第一张和最后一张图像,就是通常所说的 FLF2V。
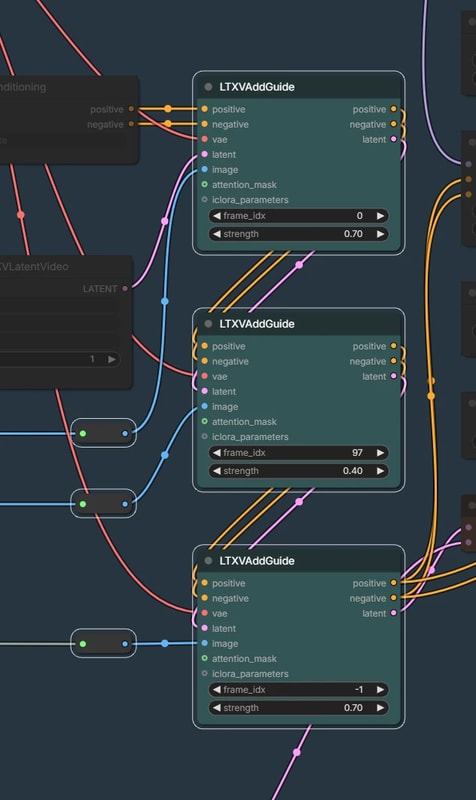
LTXV Add Guide
在 frame_idx 中指定插入图像的位置。
0:第一帧-1:最后一帧
增加节点并依次连接起来,就能进行 Generative Interpolation。
根据图像的不同,结果有时不像补帧,反而更像转场。
对于插在中间的LTXVAddGuide,可以尝试将strength降到 0.3~0.4 左右。
IC-LoRA
IC-LoRA 在 LTX 中的作用类似于 ControlNet 或视频编辑 LoRA。
LTX 2.5 与许多为 LTX 2.3 制作的 IC-LoRA 兼容,可以直接使用。
Union Control
和普通 ControlNet 一样,可以用线稿、深度图或姿势视频控制生成视频。
模型下载
- loras
📂ComfyUI/
└── 📂models/
    └── 📂loras/
        └── ltx-2.3-22b-ic-lora-union-control-ref0.5.safetensors
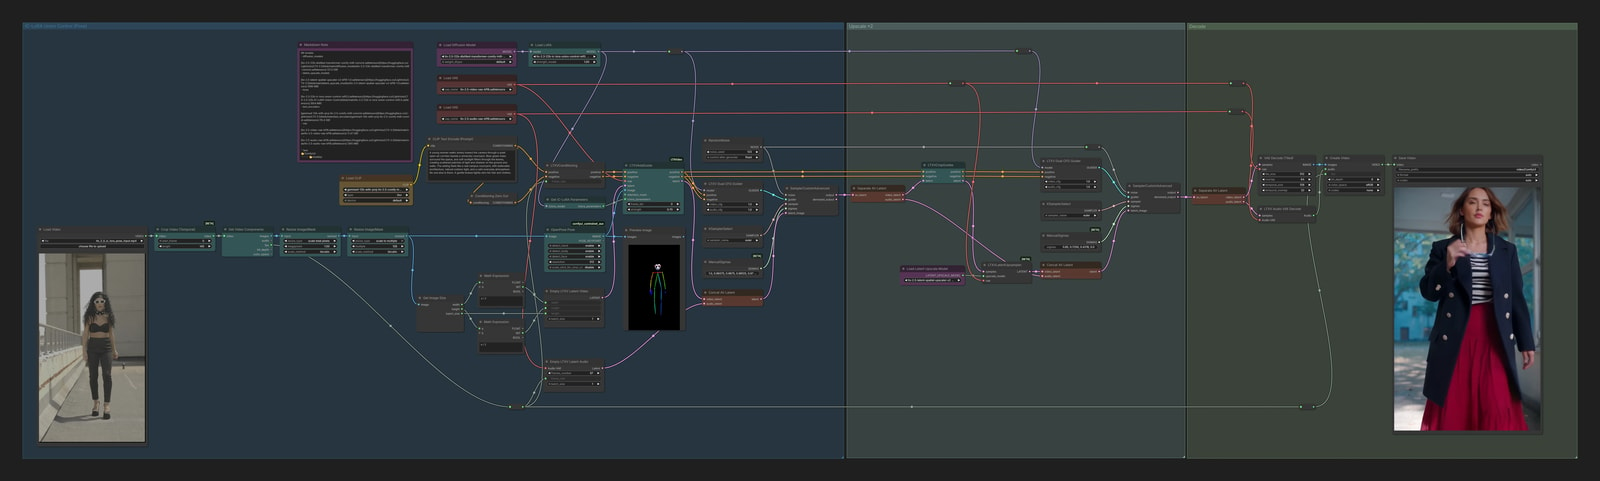
关于 IC-LoRA 的详细说明,请参阅 LTX 2 / IC-LoRA (Pose)。
Clean Plate
Lightricks 官方发布了许多可以用 LTX 2.5 做 VFX 处理的有趣 IC-LoRA。
有把白天变成夜晚的,也有让场景被水淹没的,种类很多。这次我们来试试能把视频中特定物体去掉的 Clean Plate。
模型下载
- loras
📂ComfyUI/
└── 📂models/
    └── 📂loras/
        └── ltx-2.5-22b-ic-lora-clean-plate-1.0.safetensors
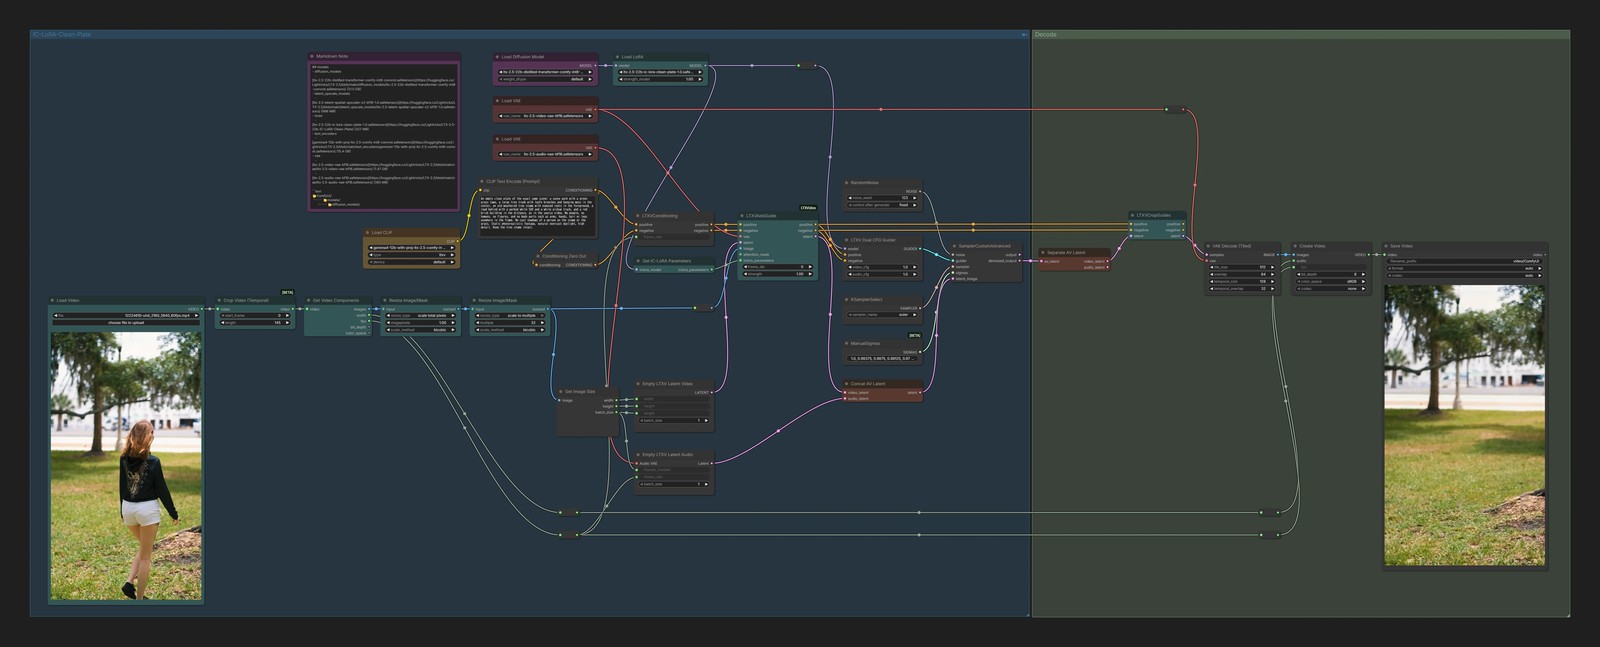
提示词的写法需要注意一下。
不要像图像编辑那样写“去掉〇〇”,而是用普通的句子描述〇〇消失之后的景象。如果要去掉的东西很明确,可以像 no bicycle anywhere in the frame 这样,再补充一句“没有它”,效果会更稳定。
位于画面边缘或部分被遮挡的物体似乎比较容易去干净,而占据画面中央大部分的物体似乎不太擅长。大概是因为去掉之后,视频中几乎没有留下可以参考的背景吧。
基本上,用这个工作流也能运行其他 IC-LoRA。不过也有几个需要专用工作流,下面来看看。
Alpha Gen
可以把视频中的前景抠出来。
不过它不会直接输出透明背景的视频,所以需要稍微做一些后期处理。
模型下载
- loras
📂ComfyUI/
└── 📂models/
    └── 📂loras/
        └── ltx-2.5-22b-ic-lora-alpha-gen-0.9.safetensors
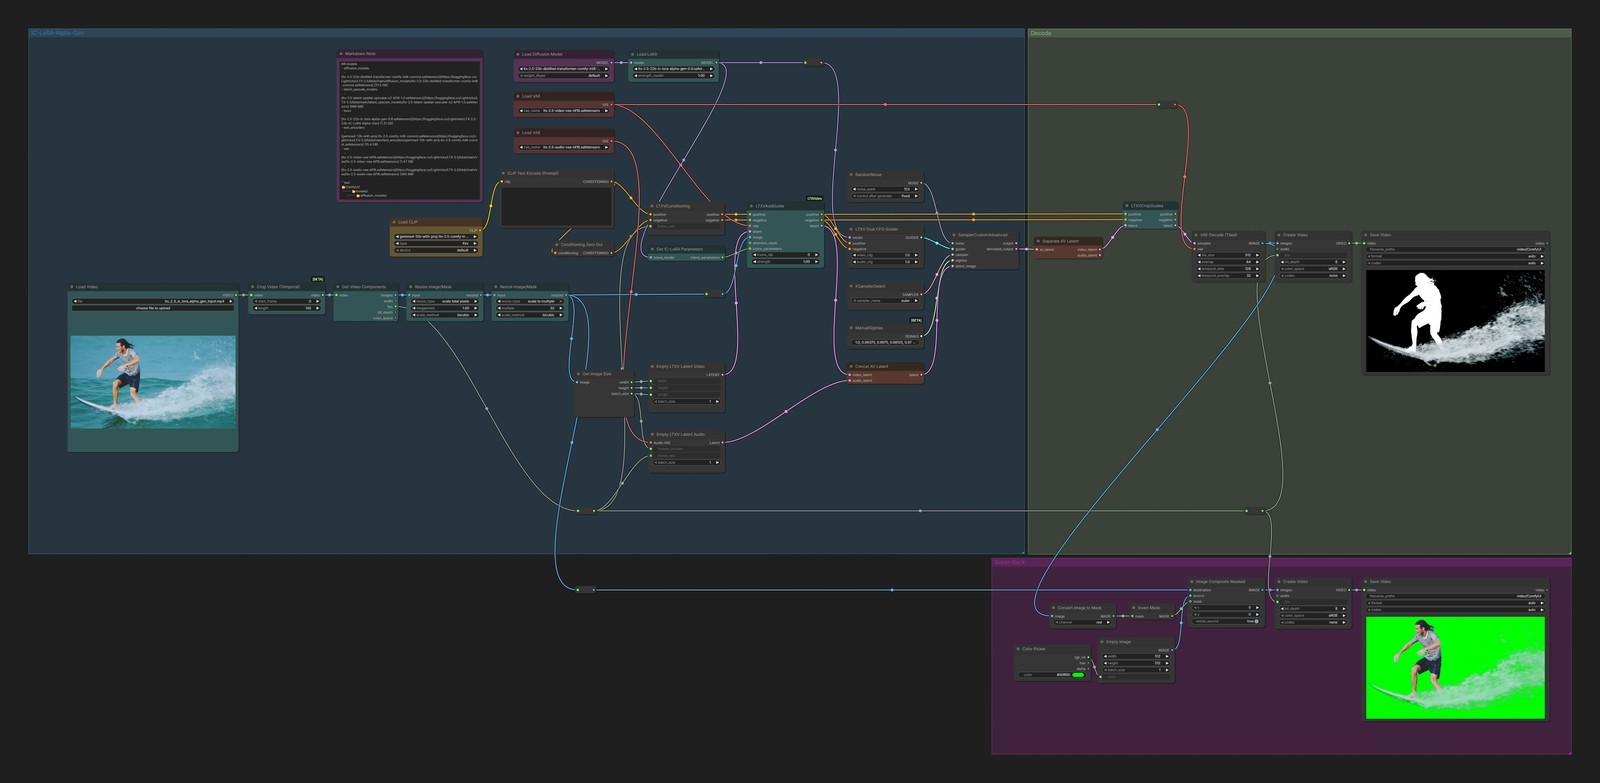
不使用提示词,保持空白即可。
输出的是黑白的遮罩视频。
ComfyUI 无法制作透明视频,所以这里把它做成绿幕视频。
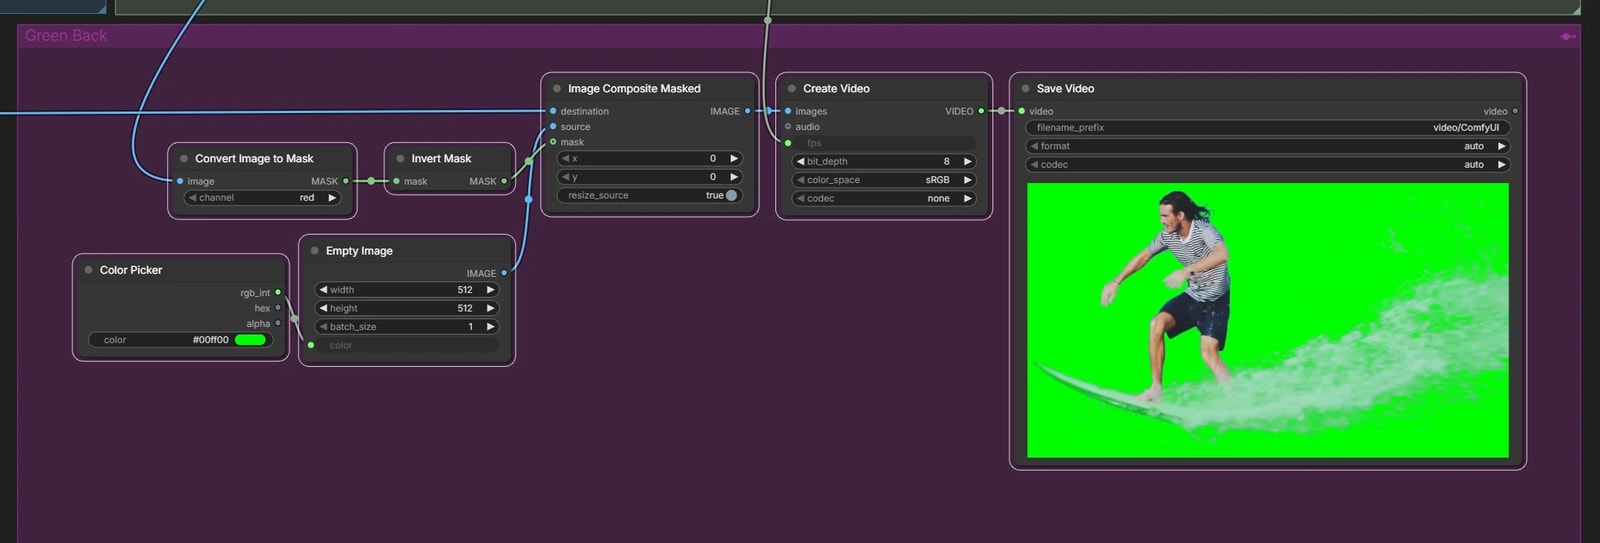
合成到绿幕上
- 用
ImageToMask把黑白视频转成遮罩 - 用
InvertMask反转 - 用
ImageCompositeMasked,把纯绿色的EmptyImage合成到背景部分
超过 145 帧的视频,原视频的内容似乎会开始混进遮罩。工作流中截取到 145 帧。
Refine Details
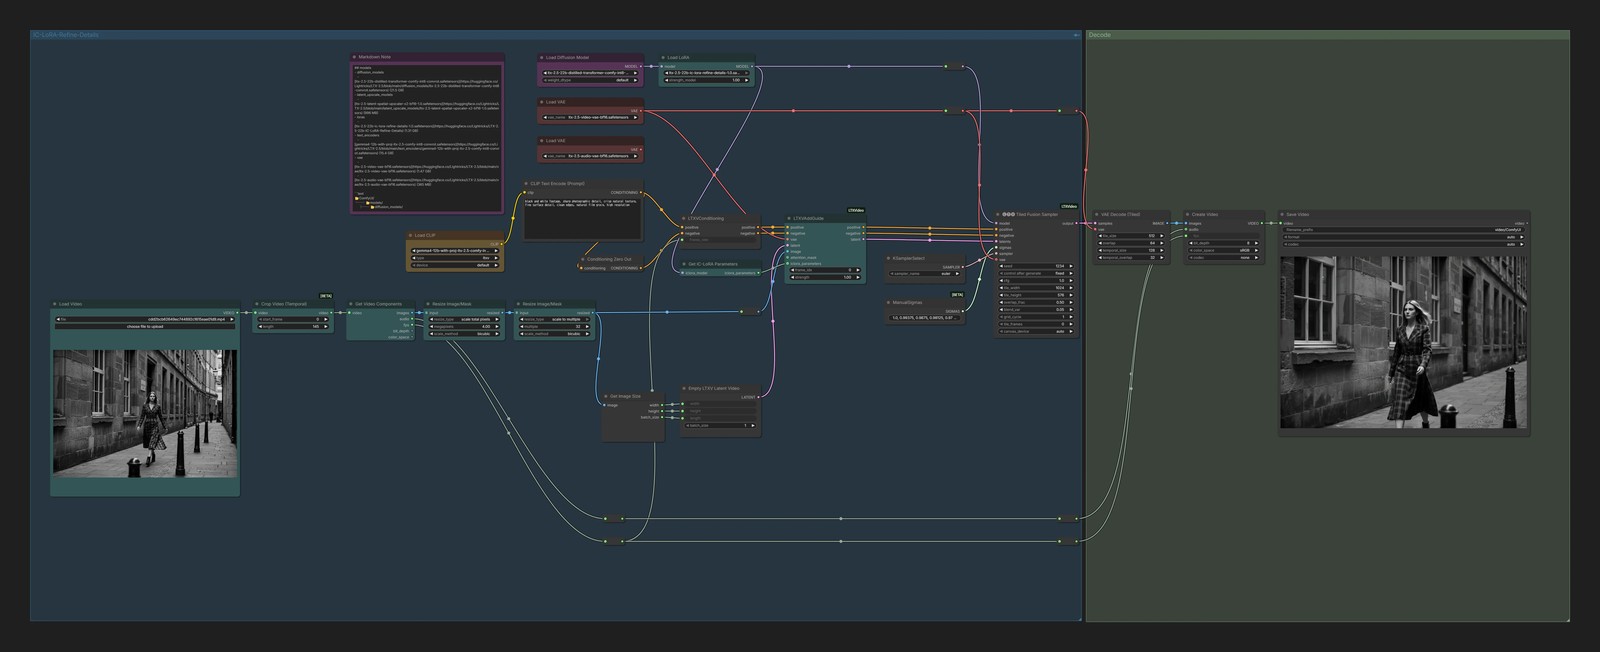
在补充细节的同时,把任意视频放大到 4K 这样的高分辨率。
为了降低计算量,它会把视频分成图块(tile)来处理,因此需要自定义节点。
自定义节点
模型下载
- loras
📂ComfyUI/
└── 📂models/
    └── 📂loras/
        └── ltx-2.5-22b-ic-lora-refine-details-1.0.safetensors
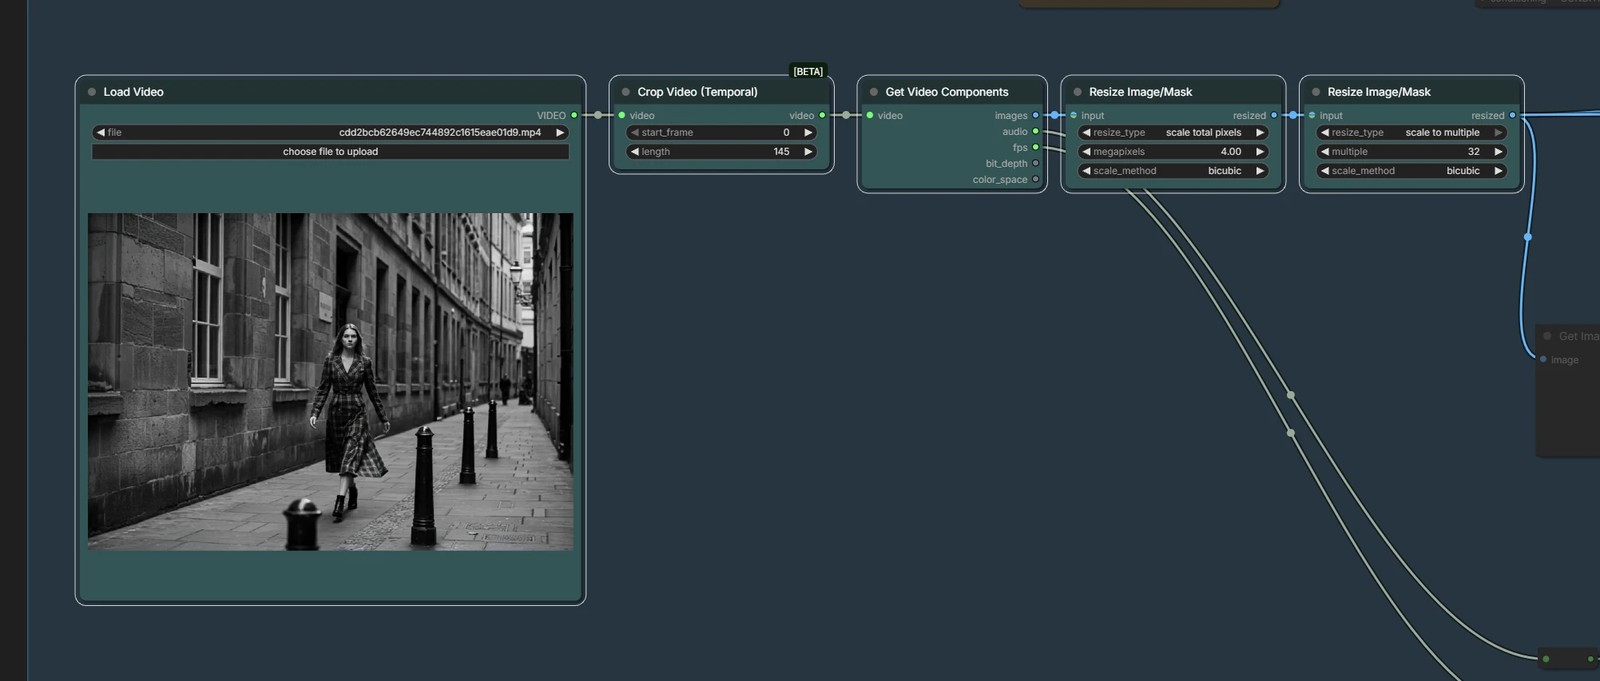
先调整视频尺寸
先把视频拉伸到较大的尺寸(这个工作流中约为 4 MP)。
Refine Details 做的事情,就是把这种被拉伸后变模糊的视频,重新清晰地描绘出来。
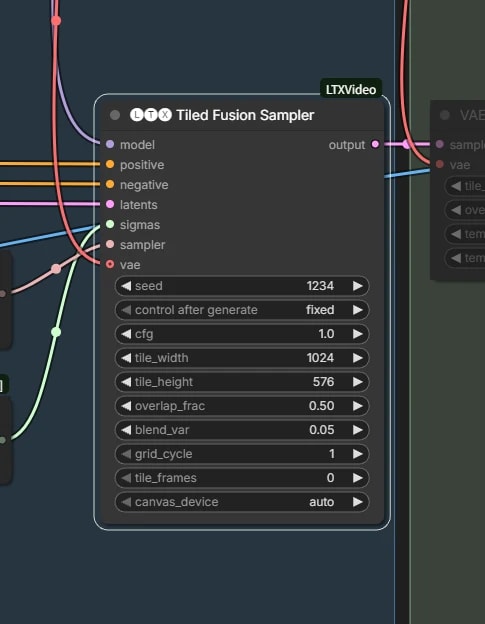
Tiled Fusion Sampler
LTXVTiledFusionSampler 会把视频分割成图块后进行采样。
设置不需要特别修改。
提示词里写的不是画面中的内容,而是 sharp photographic detail、natural film grain 这类关于画质的词。每个图块都会收到完整的提示词,所以如果写了人物等内容,它可能会被画进没有这个人的图块里。