什么是区域指定生成?
设计中,布局是重要的要素。
仅仅用“在街上靠在墙边的女性”这样的提示词生成图像,是无法创作出有魅力的作品的。
画面的右端有砖墙,那里靠着女性,在她正前方配置路灯,画面左侧减少物体以制造留白……
为了生成“在喜欢的地方放置喜欢的物体”的图像,这种技术就是“区域指定”。
用提示词指示位置
最简单的方法是,直接在提示词中写下位置关系。
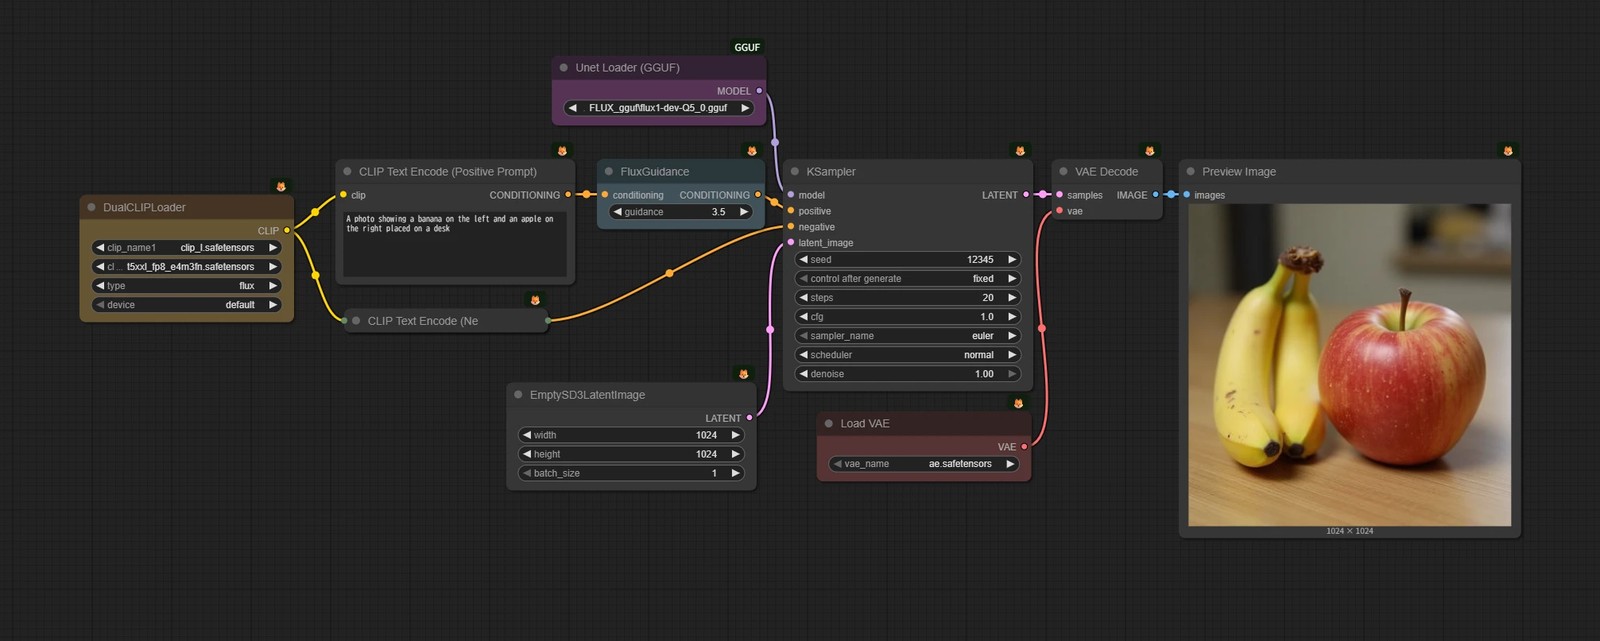
“左边是香蕉,右边是苹果”
Stable Diffusion 的文本编码器几乎无法理解位置关系,但 Flux 以后的模型,已经能够某种程度上反映位置关系了。
即便如此,一旦构图变得复杂就容易崩坏,与其说是严密的区域指定,不如说是传达宽松布局希望的手段。
重复 Inpainting
这是一旦生成图像后,多次重复 Inpainting 的方法。
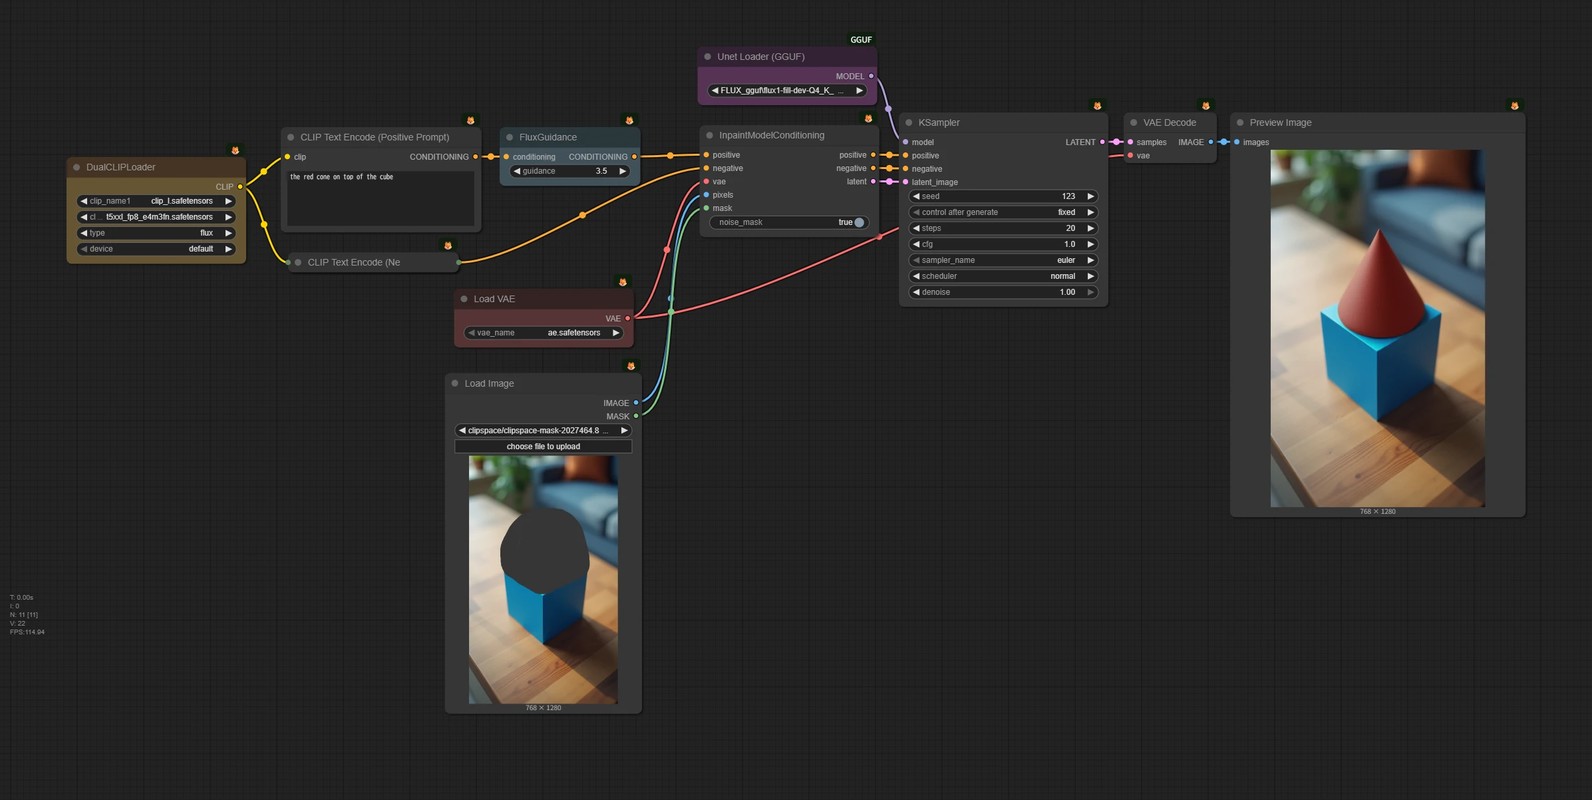
- 1. 生成作为基础的图像
- 2. 对想要编辑的区域进行遮罩并 Inpainting
- 3. 根据需要,改变遮罩对别的区域也进行 Inpainting
虽然你可能觉得这不太聪明,但这是 确切且安定的手法。提示词不会混杂,LoRA 基本上也不会影响遮罩以外的区域。可以将各区域视为完全独立的步骤进行处理。
弱点是,因为是分别生成的,所以对象之间无法相互纠缠。比如人物之间握手的图像等,容易出现视线不合或违和感。
Conditioning Set Area(Regional Prompting 系)
这是一种试图对图像的各位置应用不同文本条件的手法。利用 Cross-Attention 层,对每个区域使用不同的提示词。
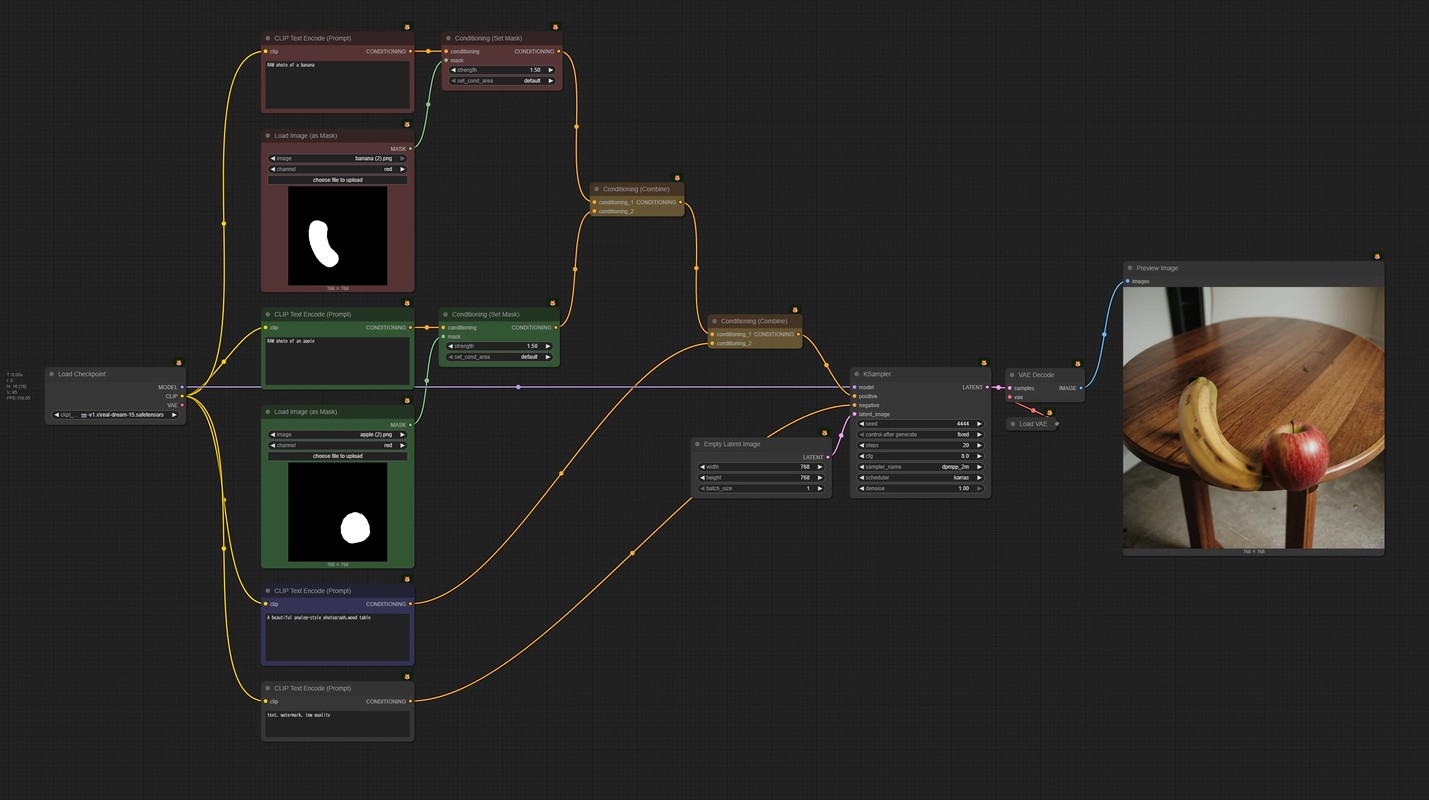
理论虽然很漂亮,但实际上边界经常模糊,或者无法彻底切换,实用性并不高。
此外,无法对 LoRA 进行区域指定。
Latent Composite(潜在空间中的合成)
这是在潜在空间的阶段合成图像的方法。
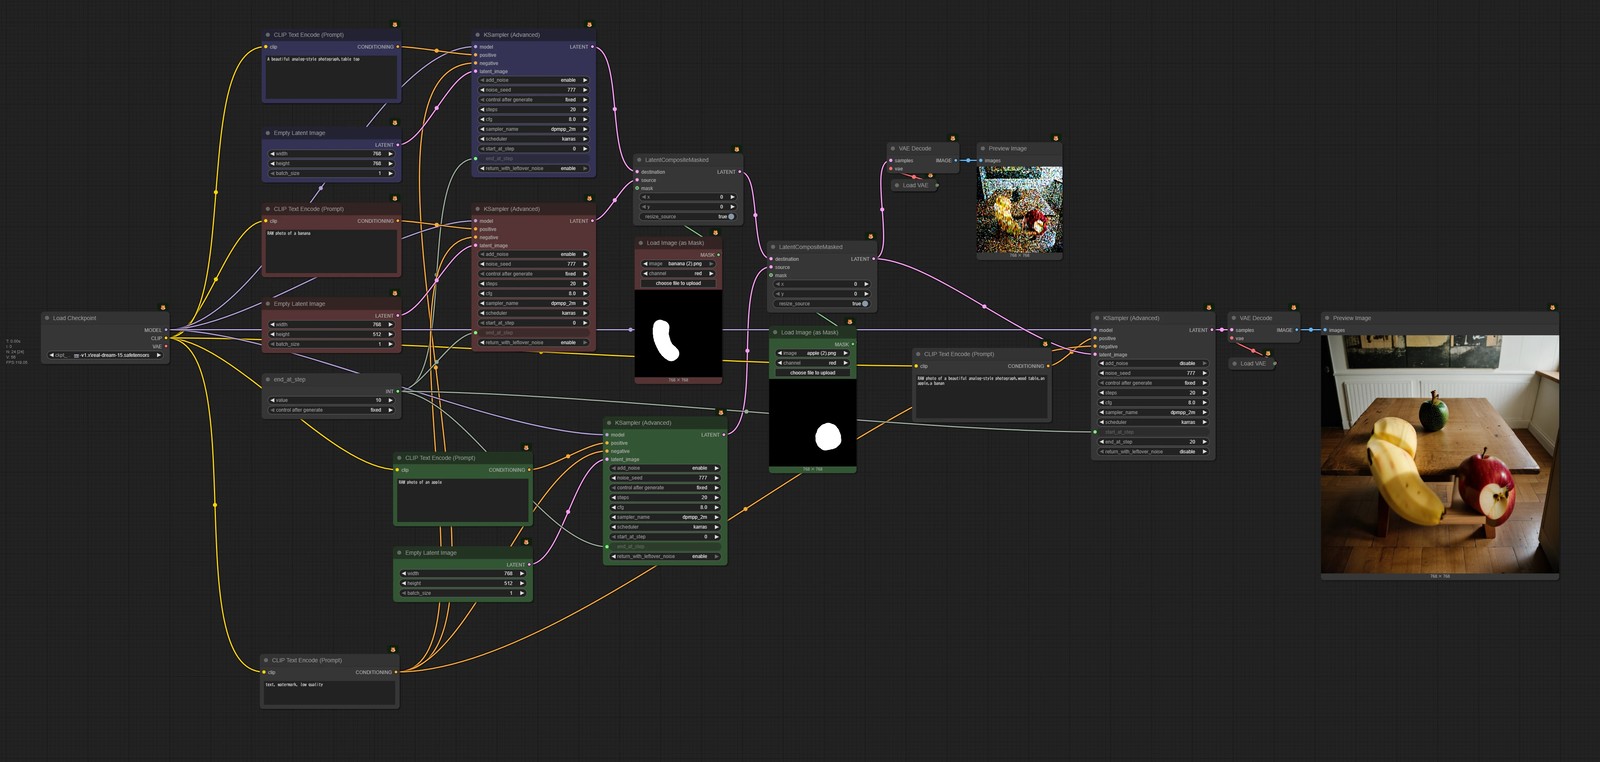
- 1. 首先生成多张图像(香蕉图像、苹果图像、背景图像等)
- 2. 使用遮罩将各个 latent 贴合成 1 张 latent
- 3. 对该合成的 latent 进行剩余的采样步骤
可以能在不同的条件下生成各对象,最后作为“一张图像”进行融合。
但是,与其使用这个,不如多次进行 Inpainting,最后对整体进行 image2image,在很多场合下反而更确切。
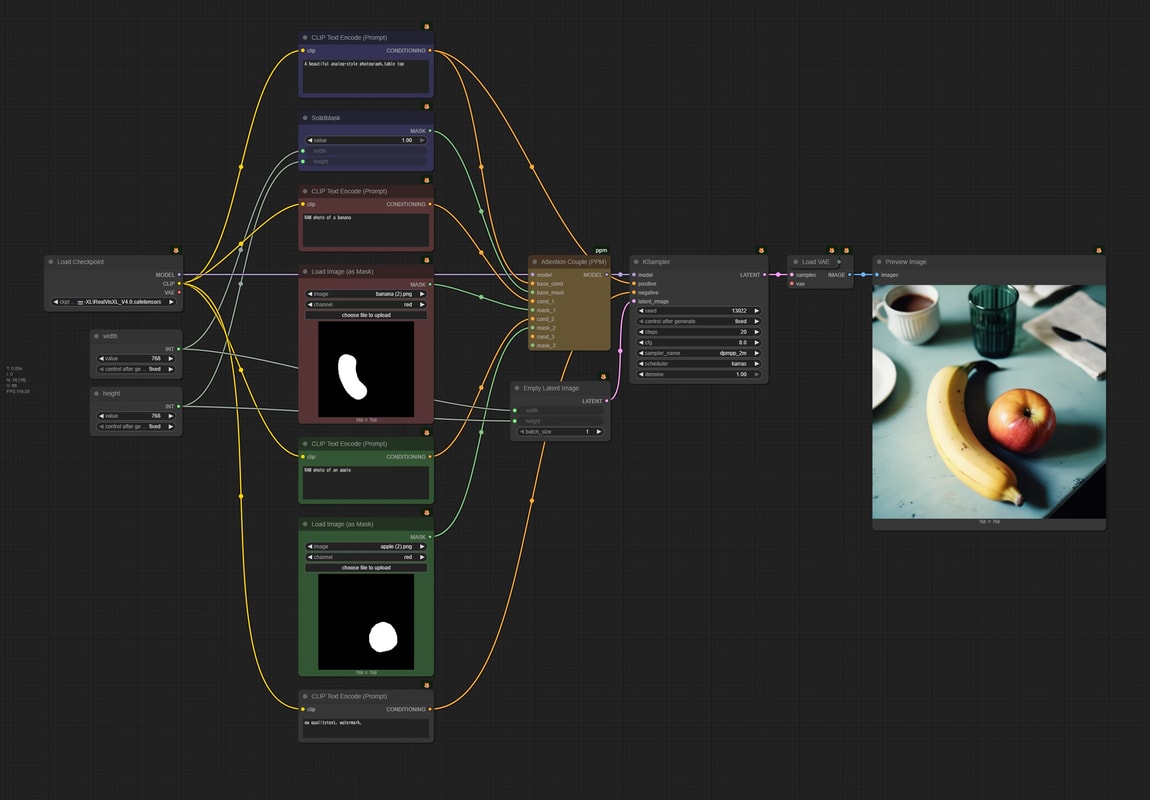
Latent Couple / Attention Couple
Latent Couple
这是将潜在空间按区域完全分割,分别用不同的设置(提示词、LoRA 等)生成后再结合的方法。
- 在可以对各区域使用完全不同的设置这一点上是理想的
- 因为相当于生成了与区域数量相同的图像,所以计算量很大
目前 ComfyUI 中没有直接的实现
Attention Couple
Latent Couple 是对整个 UNet 进行计算,而这里只计算 Cross-Attention 层
相应地计算量会少很多,但无法进行 LoRA 的区域指定
杂项拼贴的优化 (推荐)
这是制作粗略的拼贴图像,并以此为基础让其重做成自然画作的方法。
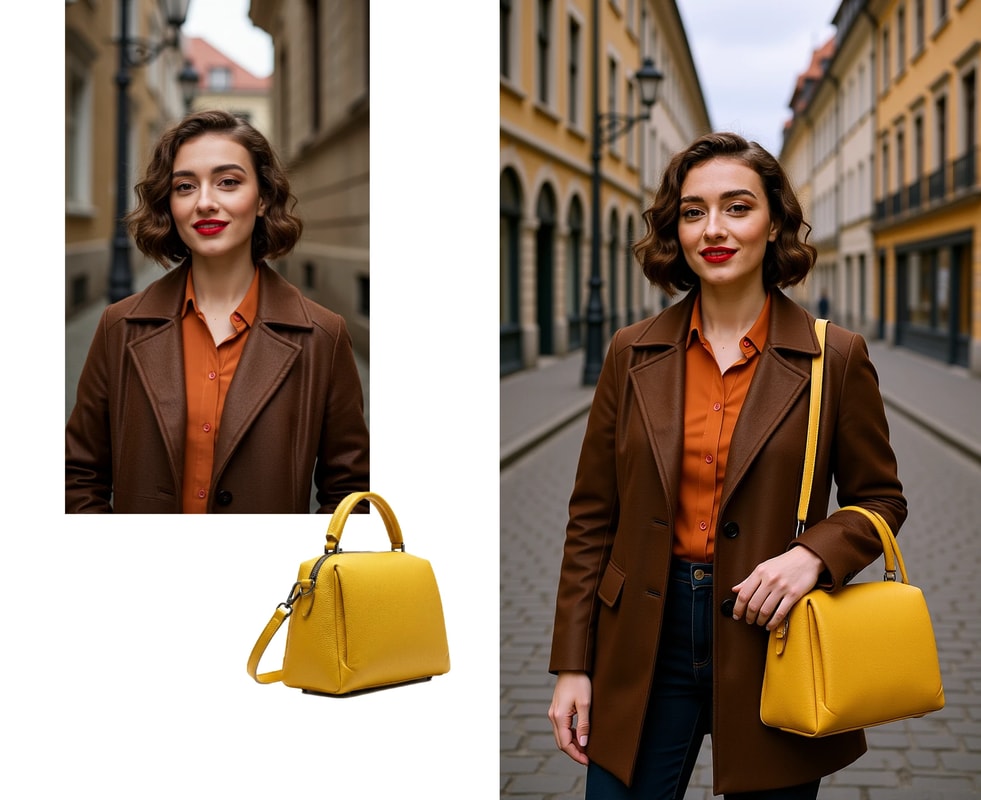
可以非常直观地指定位置,生成的东西也只要贴上适当的物体就行,实际上是相当推荐的方法。
详情 → 杂项拼贴的优化