什么是 Wan2.1 VACE?
Wan2.1 VACE 是 Wan2.1 的视频生成中的编辑用模型。
拥有将视频版的 ControlNet 和 inpainting / outpainting / reference2video 汇总在 1 个节点(WanVaceToVideo)那样的功能。
- 对既有视频,用姿势和深度图“只控制动作”
- 以 reference 图像为基础,替换角色或靠拢风格
- 只对特定的领域进行 inpainting / outpainting
- 生成视频的后续(Extension),或制作循环・中间画
可以以 Wan2.1 的生成品质处理这些事情。
推荐设定
- 推荐分辨率
- 720p 前后、且 16 的倍数
- 最大帧数
- 81 帧
模型的下载
Wan2.1 VACE 用,使用与通常的 T2V 模型不同的 VACE 专用 diffusion model。 这里只处理 14B。
- diffusion_models
- text encoder
- VAE
- gguf(任意)
📂ComfyUI/
└── 📂models/
    ├── 📂diffusion_models/
    │   └── wan2.1_vace_14B_fp16.safetensors
    ├── 📂text_encoders/
    │   └── umt5_xxl_fp8_e4m3fn_scaled.safetensors
    ├── 📂unet/
    │   └── Wan2.1_14B_VACE-XXXX.gguf   ← 仅在使用 gguf 时
    └── 📂vae/
        └── wan_2.1_vae.safetensors
基本构造
无论哪个模式,都是以 Wan2.1 text2video 为基础,添加 WanVaceToVideo 节点的形式为基本。
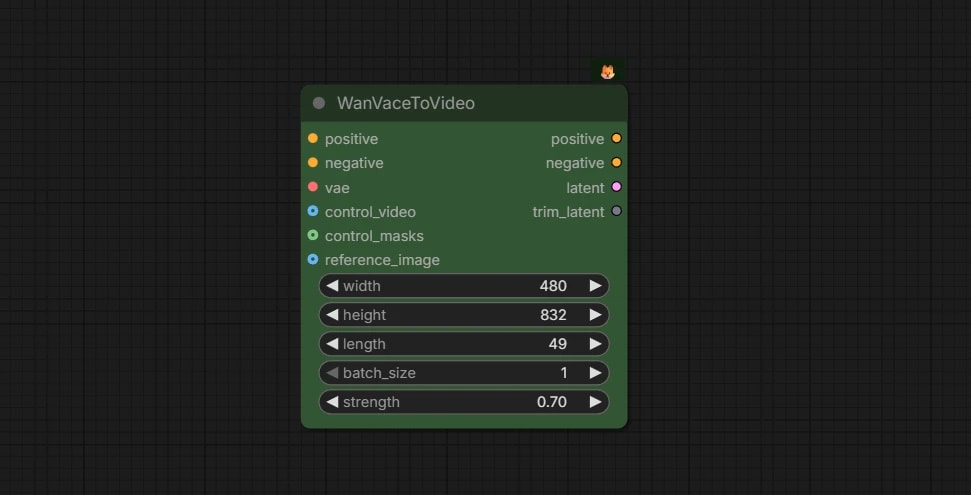
control_video- 姿势・深度图・scribble・optical_flow・layout 等的“引导视频”
control_masks- inpainting 用的掩膜
reference_image- 想传送角色或风格的参照图像
ControlNet 式的使用方法
使用姿势和深度图等,控制视频的动作。
Deep diveControlNet 式的使用方法
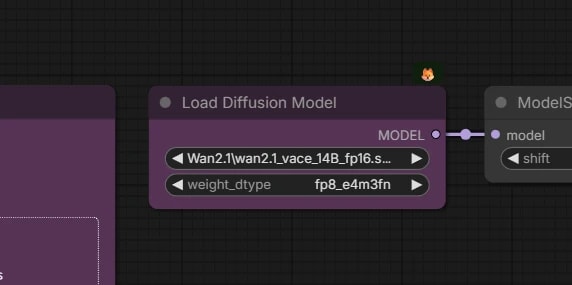
读取 Wan2.1 VACE 模型
- 在
Load Diffusion Model读取wan2.1_vace_14B_fp16.safetensors。 - 因为原样的话会相当使用 VRAM,所以将
dtype切换为fp8_e4m3fn,削减 VRAM 的使用量。
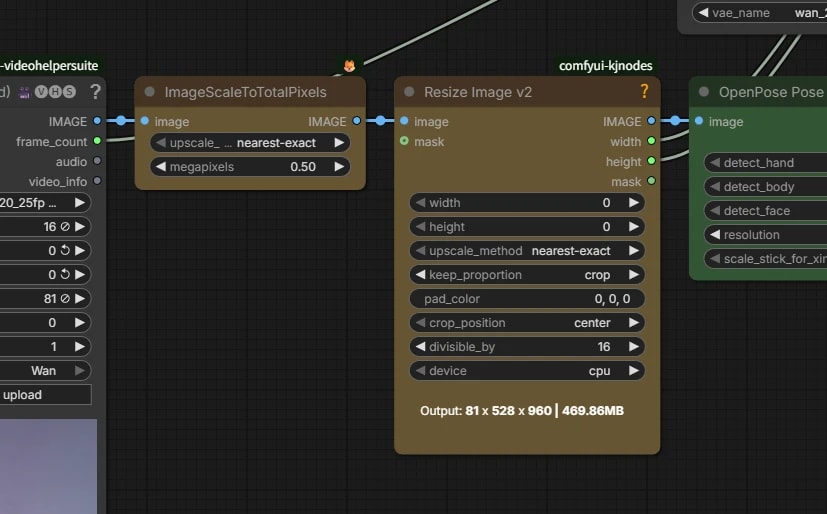
视频的调整尺寸
- 在
ImageScaleToTotalPixels缩小到适度的尺寸。- Wan 可以生成到 720p(1MP),但因为我的 PC VRAM 不足,所以设为 0.5MP。
- 在
Resize Image v2裁剪为 16 的倍数。- 虽然也可以仅用这个节点凑齐 0.5MP,但为了区分处理的意图,做成了二段构成。
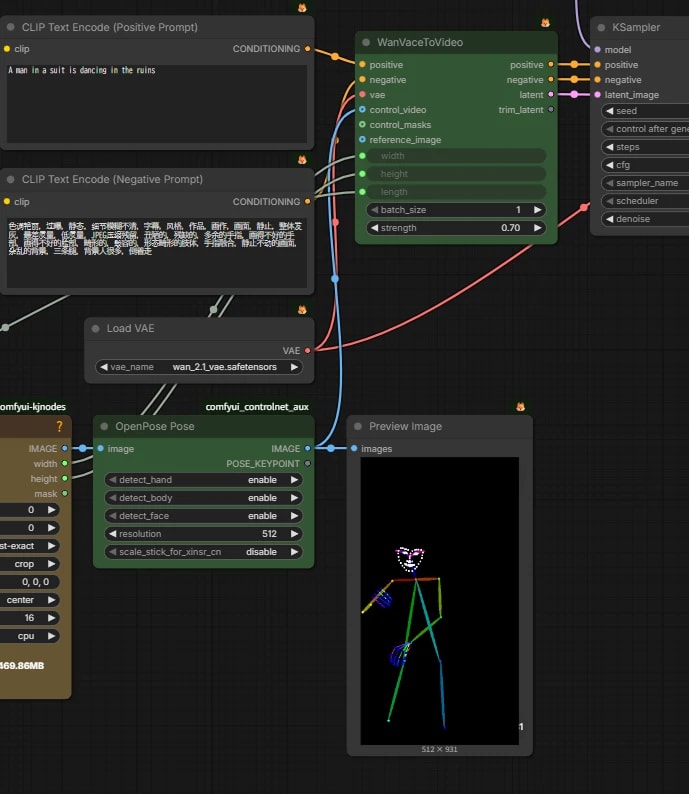
control_video 的制作和输入
- 在
OpenPose Pose从视频制作火柴人的姿势视频。 - 将其输入到
WanVaceToVideo的control_video。
reference2video
将 reference 图像的角色和风格,传送到视频。
Deep divereference2video
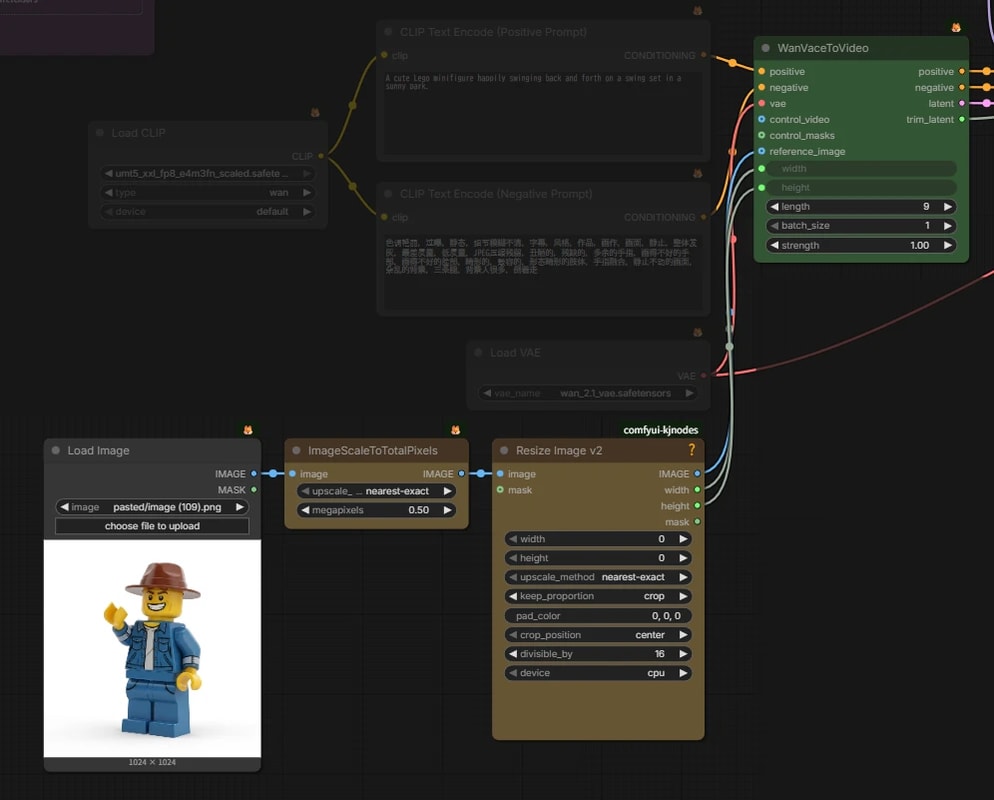
参照图像的预处理・输入
- 在
WanVaceToVideo的reference_image,输入角色图像或插图。- 使用剪切背景并用白色填充的图像更容易安定。
- 虽然说是 reference2video,但构造上,原样继承参照图像的位置关系。
- 因此,生成的视频尺寸和参照图像最好相同,角色的位置和大小,也接近最终想放置的位置等预处理变得很重要。
初期帧剪切
- 在 reference2video 中,最初的数帧会输出“参照图像+生成结果重叠的帧”。
- 虽然这就是 VACE 可以使用参照图像的机制本身,但这部分不需要。
- 🟥 在
TrimVideoLatent,在 latent 的阶段剪切初期帧之后再导出视频。
空间的 inpainting
只替换视频的一部分。
Deep dive空间的 inpainting
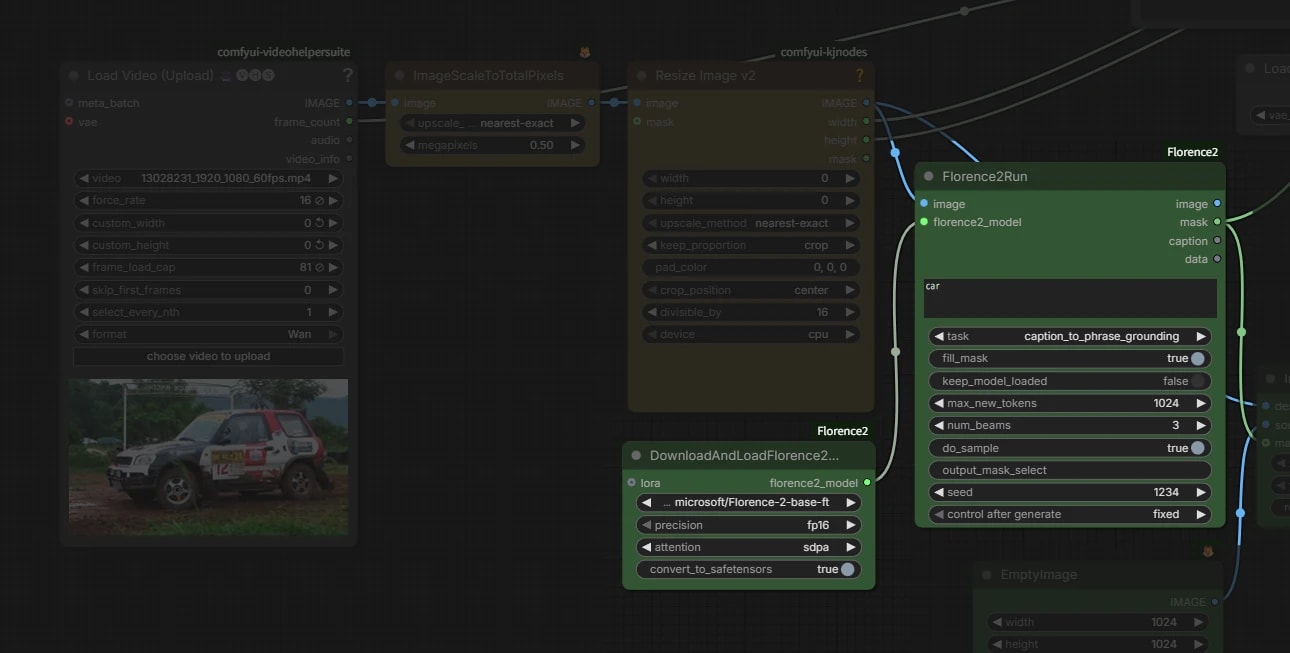
掩膜生成
- 请用喜欢的方法制作掩膜。
- 在这个工作流中用
Florence-2检测汽车/车厢,将那个 BBOX 原样作为掩膜使用。
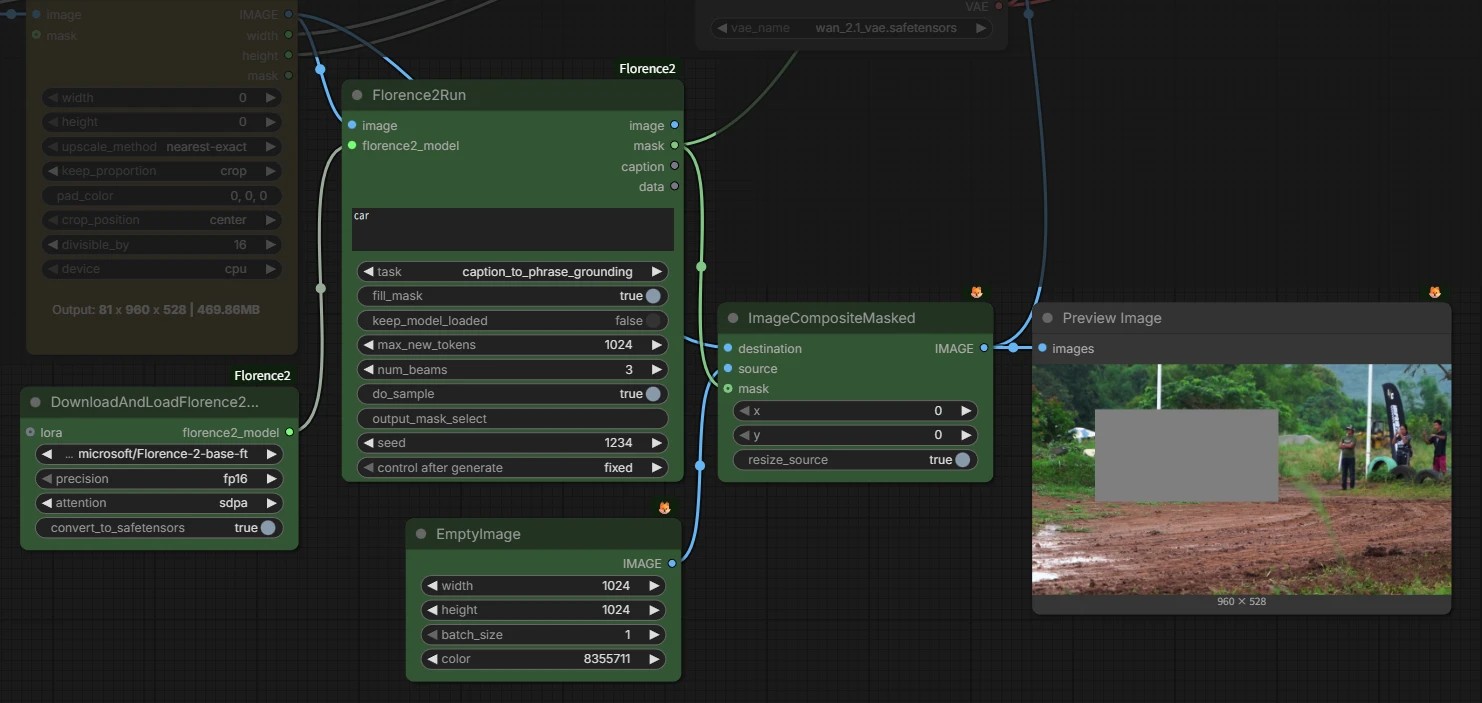
control_video 的制作
- 在
control_video,使用 将掩膜部分用灰色(RGB 127,127,127)填充的视频。 - 在
ImageCompositeMasked将掩膜部分涂满灰色。 - 向
WanVaceToVideo节点,输入制作的control_video和掩膜。
时间的 outpainting(Extension)
拉伸视频的“时间方向”的是 Extension。 只使用输入视频的一部分帧,让 VACE 补全前面。
- 在这个工作流中,以输入视频的最后 5 帧为基础,生成前面的 72 帧(81 - 5)。
Deep dive时间的 outpainting(Extension)
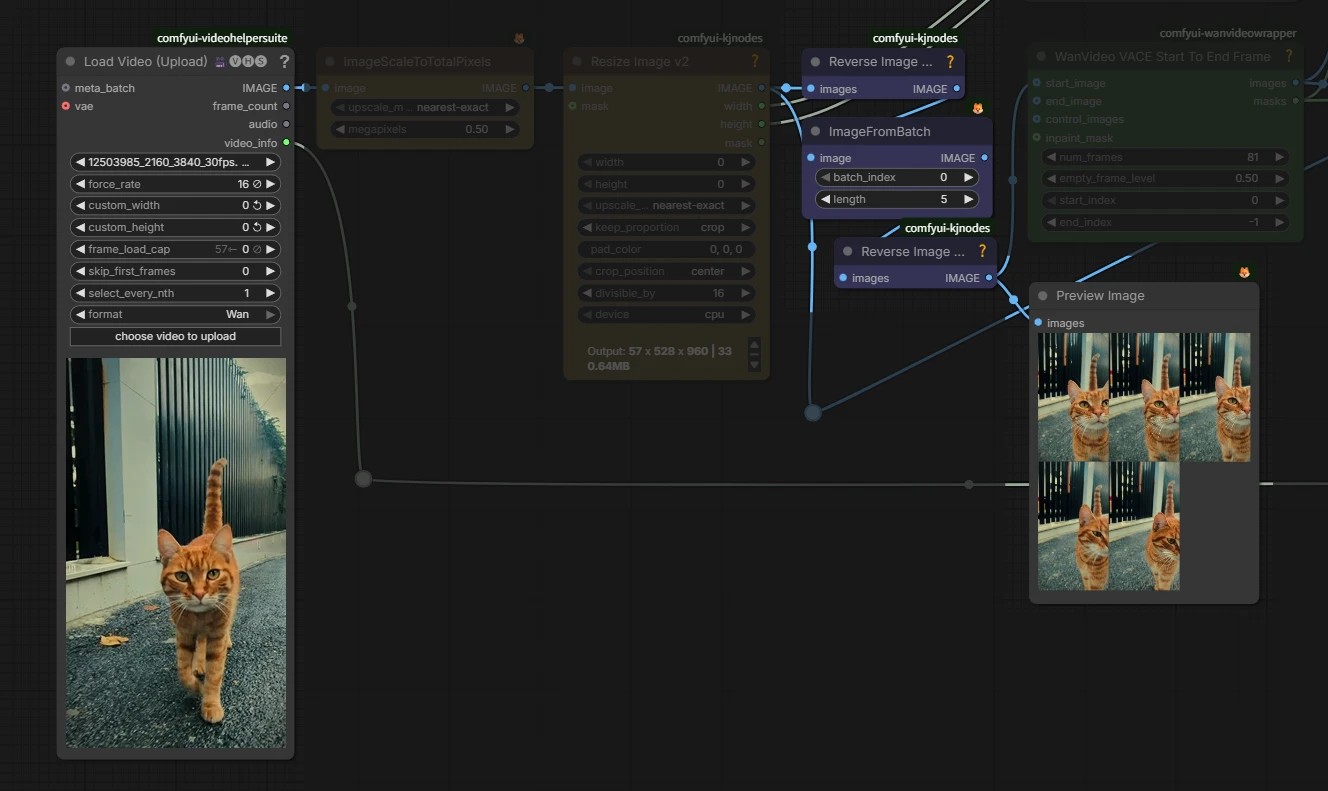
取得最后 5 帧
- 将输入视频一度倒转,只从开头抽出 5 帧。
- 将那只有 5 帧的批次,再次倒转作为“原视频的最后 5 帧”使用。
- 虽然想要稍微聪明一点的节点,但现状只有这个步骤。
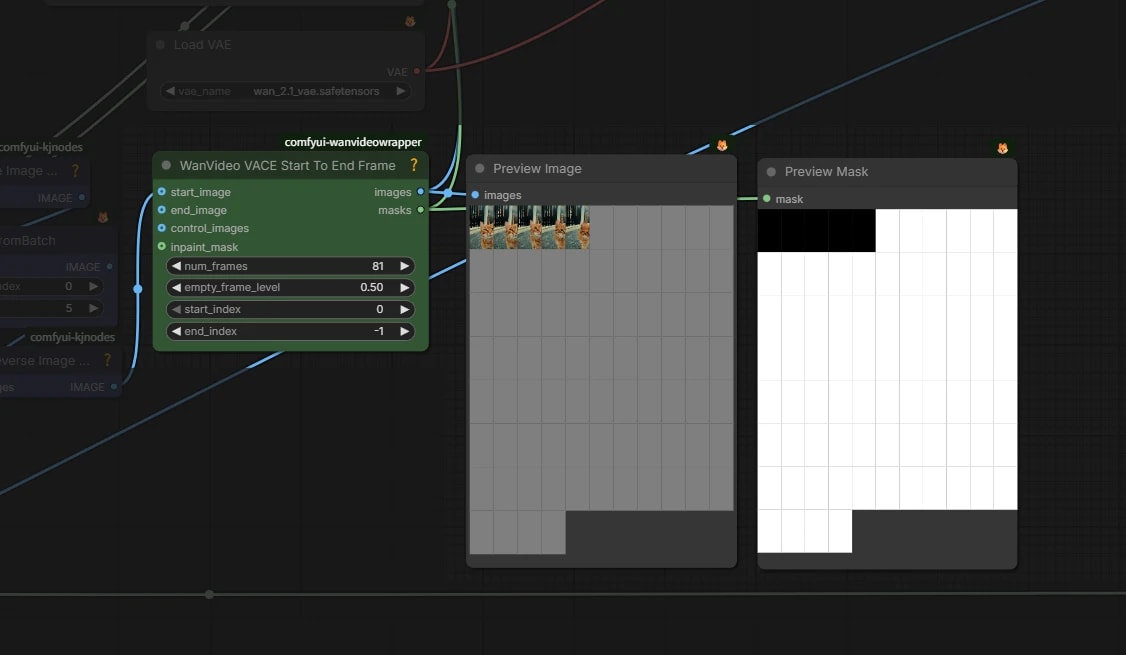
control_video 和掩膜的制作
- 虽然将 Extension 表现为 时间的 in/outpainting,但实际上,和刚才的空间的 inpainting 的工作流相似。
- 制作想生成的帧数(这里是 72 帧)份的灰色图像,和覆盖其全域的掩膜。
- 是将这个区间整个 inpainting 的印象。
- 在
WanVideo VACE Start To End Frame(kijai/ComfyUI-WanVideoWrapper) 制作这个,传递给 WanVaceToVideo。- 虽然只用核心节点也能构成,但节点数会激增,所以这里觉得老实依靠 Wrapper 节点比较好。
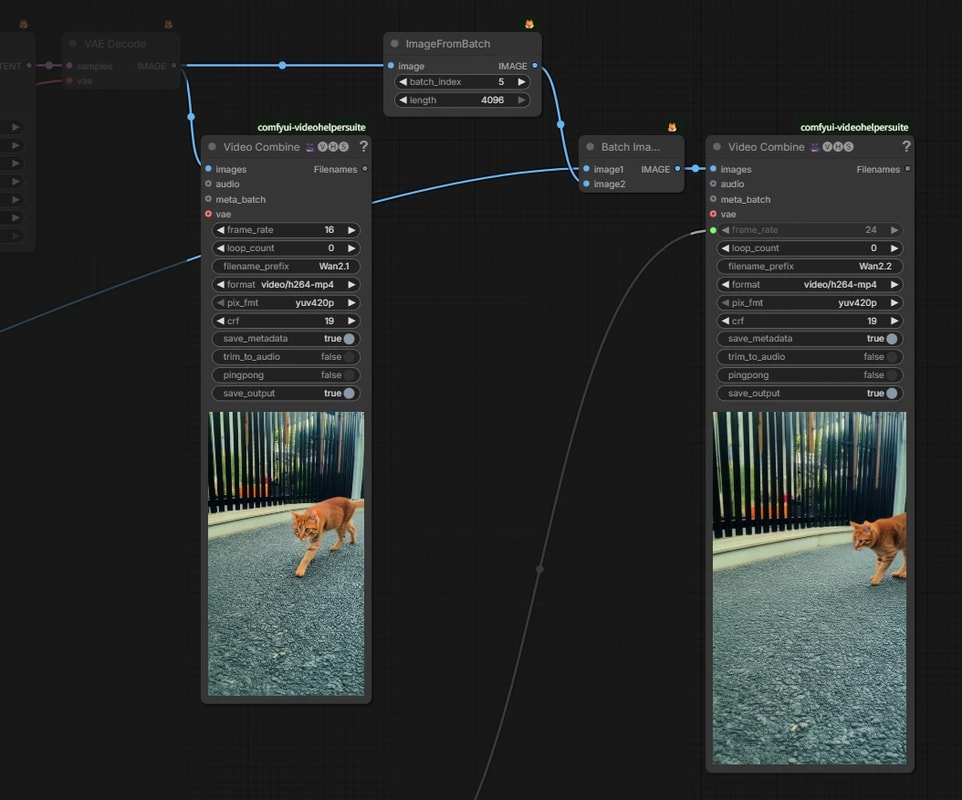
将生成视频和原视频连接
- 生成视频是“原视频 5 帧 + 生成的 72 帧”。
- 这样原样和原视频连接的话会重复 5 帧。
- 因此在
ImageFromBatch节点切掉最初的 5 帧,连接到原视频的后面。
视频的循环化
抽出视频的最后数帧和最初数帧,使之 最后 → 最初 连接的话就能制作循环视频。 至今为止如果用 FLF2V 也确实能制作,但在 VACE 因为可以使用多个帧作为输入,所以能做成像是继承了视频流动的举动这点很有趣。
- 加上上面的 Extension,也取得 最初的 5 帧。
- 将其输入到
WanVideo VACE Start To End Frame的end_image。 - 虽然是否有效果要看情况,但也抽出第 1 帧作为
reference_image使用。