TRELLIS.2 是什么?
TRELLIS.2 是 Microsoft 发布的模型,可以从一张图像生成 3D 模型。
输出的是带有颜色和质感的 3D 模型(带 PBR 纹理的网格)。
Pixal3D
Pixal3D 是清华大学、Tencent ARC Lab 等基于 TRELLIS.2 开发的改进版。
它先把图像特征逐像素投影到 3D 空间再进行生成,因此输入图像与 3D 模型在像素层面一一对应,生成的形状更忠实于输入图像。
下载模型
- background_removal
- birefnet.safetensors (444 MB)
- clip_vision
- dino_v3_L_naf_fp32.safetensors (1.22 GB)
- diffusion_models
- trellis_2_int8_convrot.safetensors (5.25 GB)
- 用于 TRELLIS.2
- pixal3d_int8_convrot.safetensors (5.58 GB)
- 用于 Pixal3D
- pixal3d_multiview_int8_convrot.safetensors (5.58 GB)
- 用于 Pixal3D 多视图
- trellis_2_int8_convrot.safetensors (5.25 GB)
- geometry_estimation
- moge_3_vitl_fp16.safetensors (741 MB)
- 用于 Pixal3D
- moge_3_vitl_fp16.safetensors (741 MB)
- vae
- trellis_2_shape_vae_bf16.safetensors (1.10 GB)
- trellis_2_texture_vae_bf16.safetensors (948 MB)
📂ComfyUI/
└── 📂models/
    ├── 📂background_removal/
    │   └── birefnet.safetensors
    ├── 📂clip_vision/
    │   └── dino_v3_L_naf_fp32.safetensors
    ├── 📂diffusion_models/
    │   ├── trellis_2_int8_convrot.safetensors
    │   ├── pixal3d_int8_convrot.safetensors
    │   └── pixal3d_multiview_int8_convrot.safetensors
    ├── 📂geometry_estimation/
    │   └── moge_3_vitl_fp16.safetensors
    └── 📂vae/
        ├── trellis_2_shape_vae_bf16.safetensors
        └── trellis_2_texture_vae_bf16.safetensors
TRELLIS.2
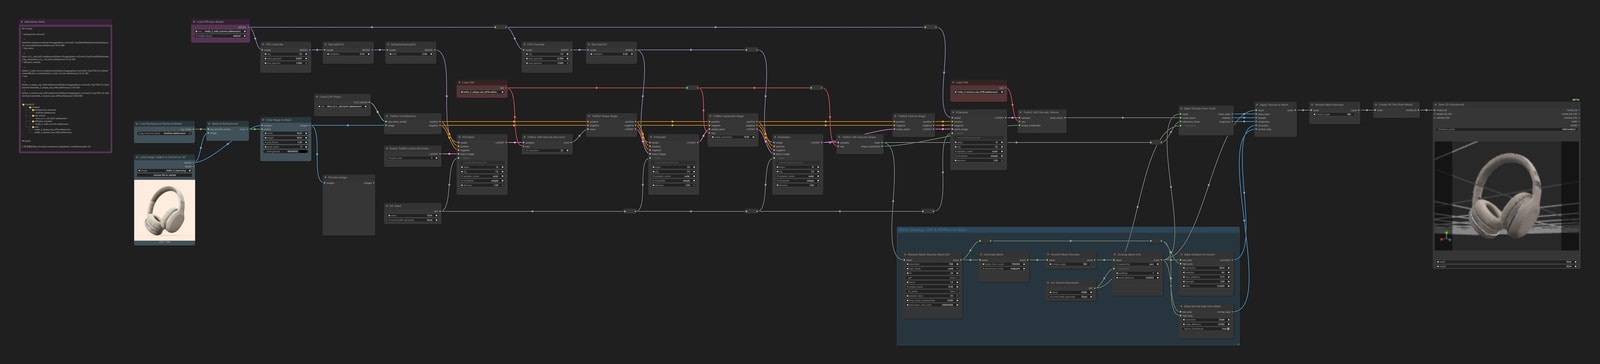
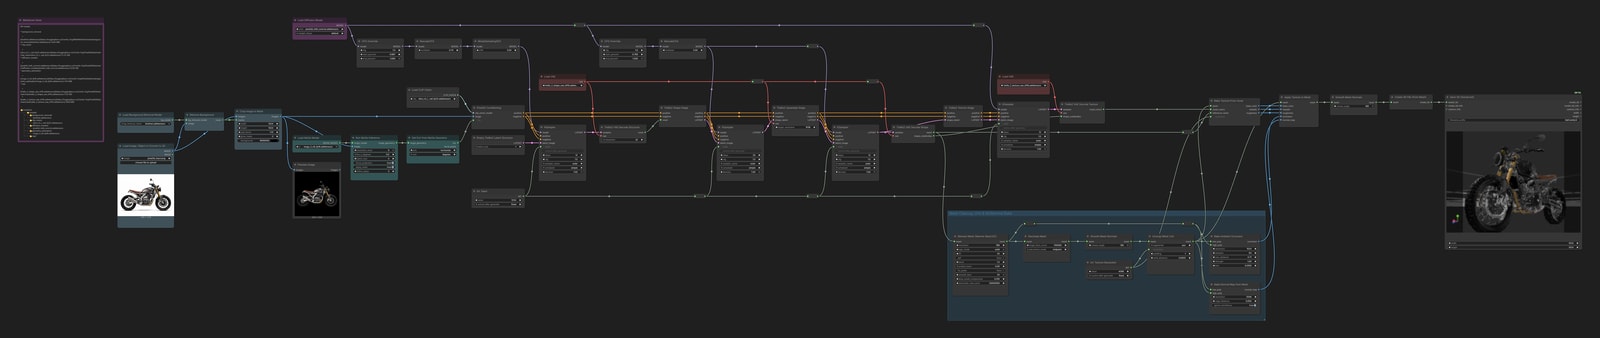
这个工作流非常庞大,看了可能会有点发怵,不过基本上只要换掉输入图像再运行就行。
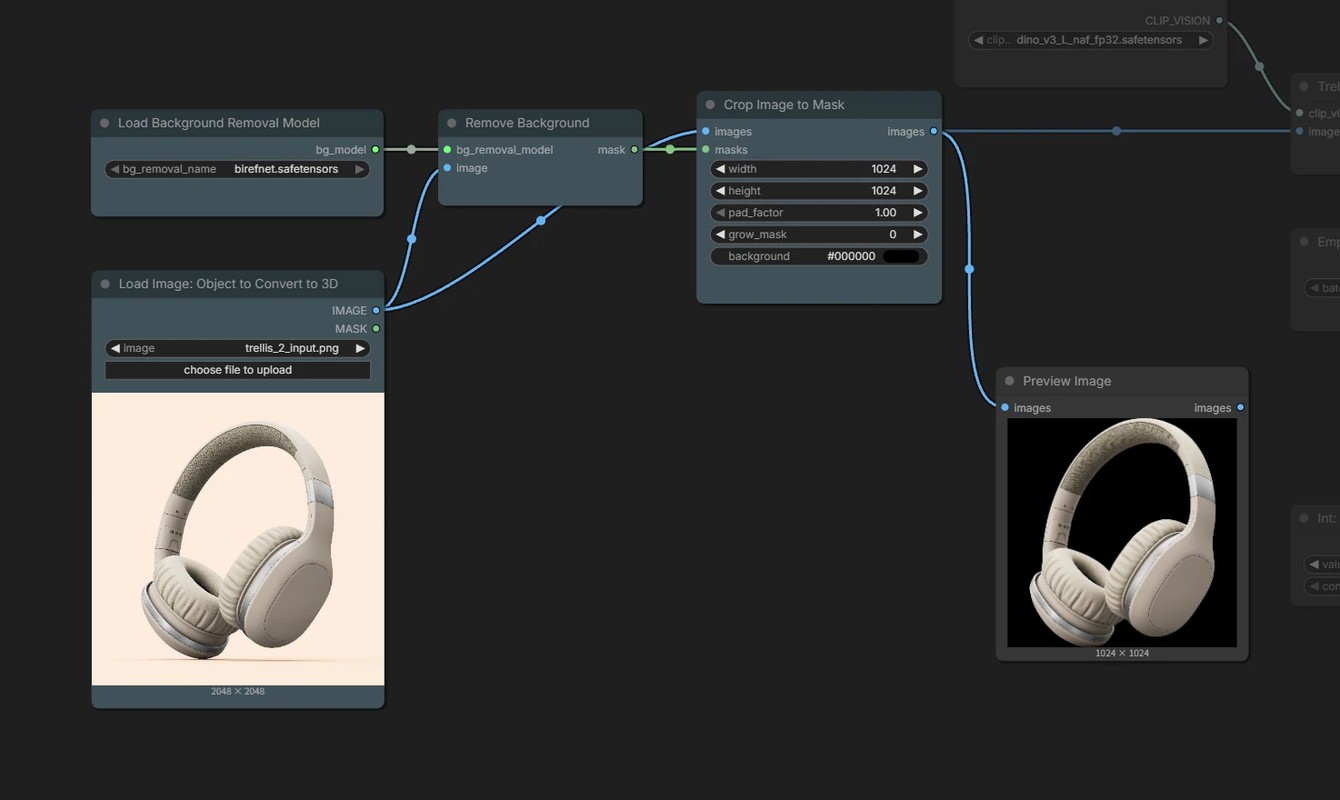
预处理
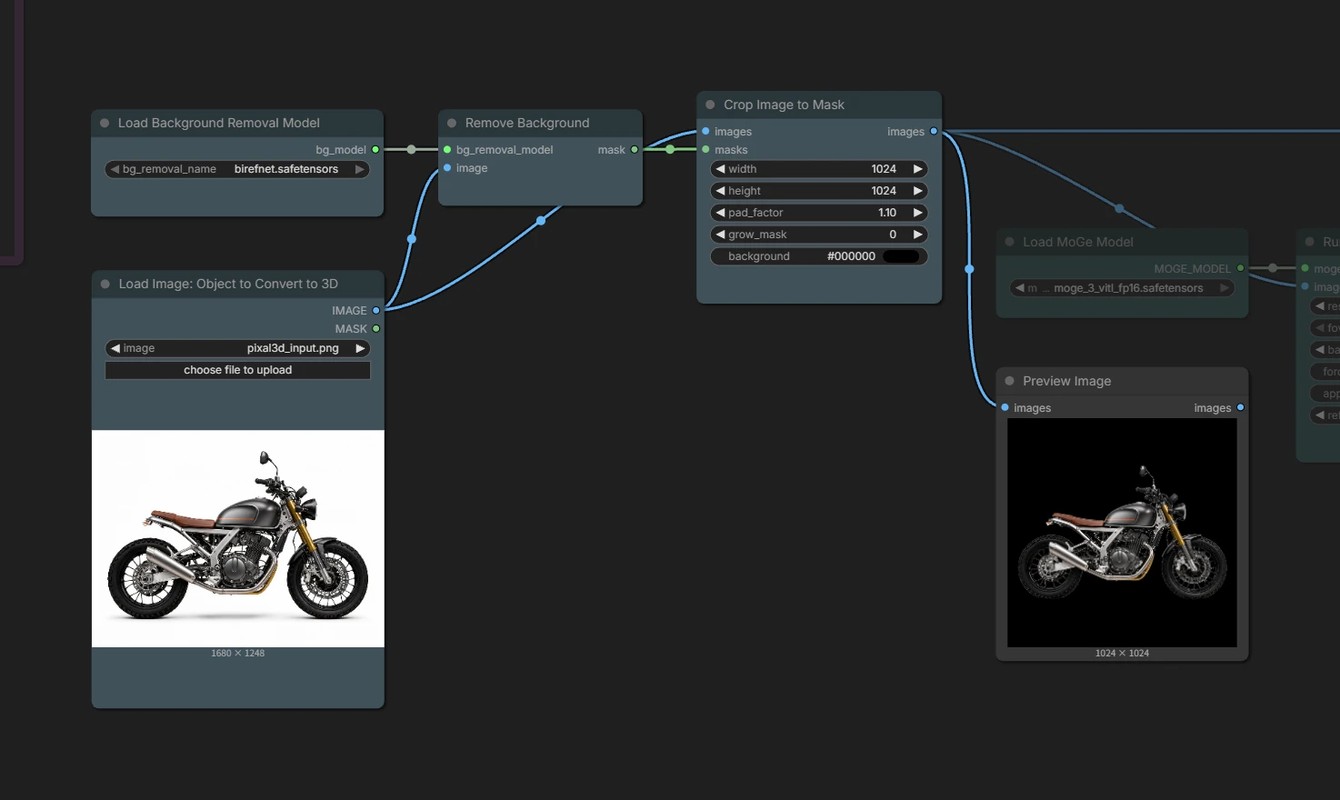
用 BiRefNet 去除背景,生成黑色背景的正方形图像。
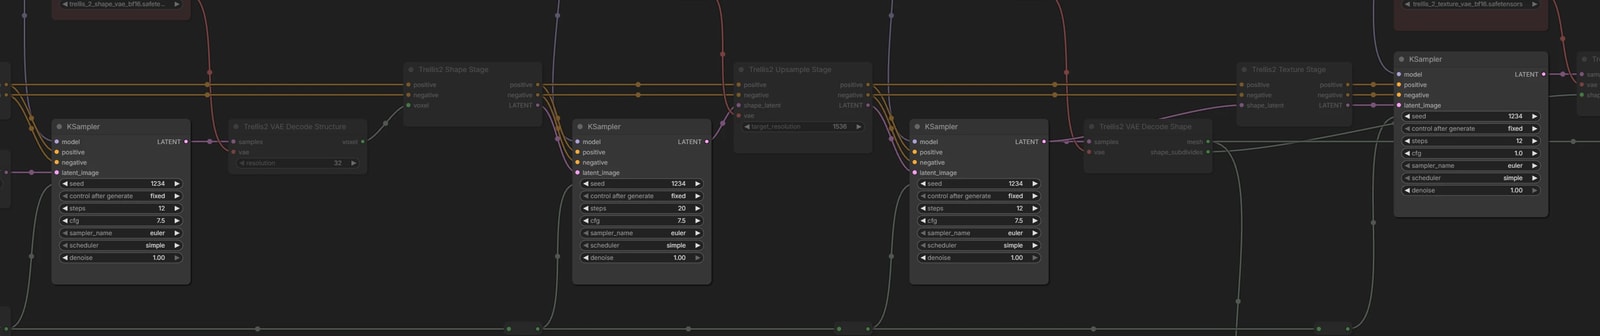
4 次采样
TRELLIS.2 从大致的形状开始,分 4 次依次生成。
- 第 1 次
- 用 32³ 的粗糙体素确定物体所在的位置
- 第 2 次
- 在这些体素中,以 512 的分辨率生成形状
- 第 3 次
- 把第 2 次的形状提升到 1536 的分辨率,重新生成形状
- 第 4 次
- 给生成好的形状加上颜色和材质
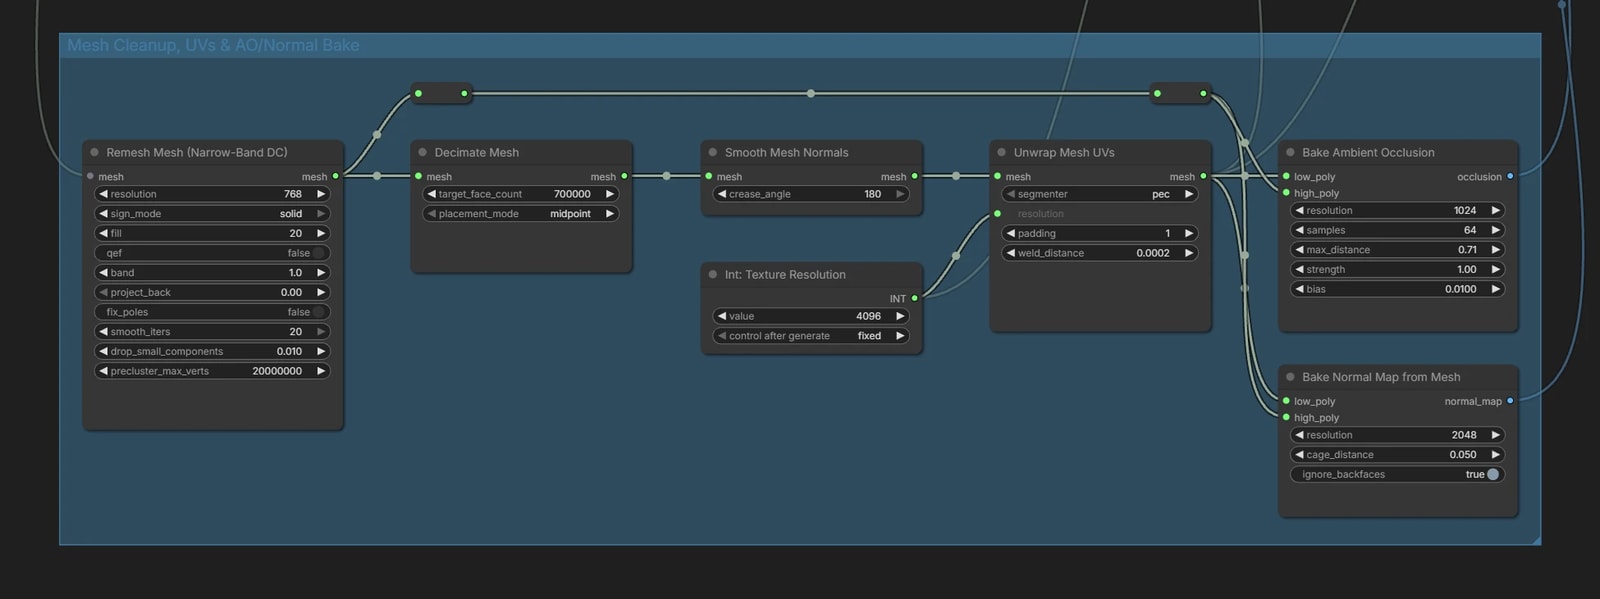
网格后处理
先整理生成的网格,再烘焙纹理。
- 用
Remesh Mesh均匀地重建面,再用Decimate Mesh减到 70 万个面 - 用
Unwrap Mesh UVs展开 UV,把体素的颜色烘焙到纹理上 - 法线贴图和 AO 也从减面前的网格烘焙
Pixal3D
与 TRELLIS.2 几乎相同,不过多了 FOV(视场角)输入,所以增加了从图像估计 FOV 的处理。
预处理
Crop Image to Mask 的 pad_factor 在 TRELLIS.2 中是 1.0,而在 Pixal3D 中设为 1.1。
模型
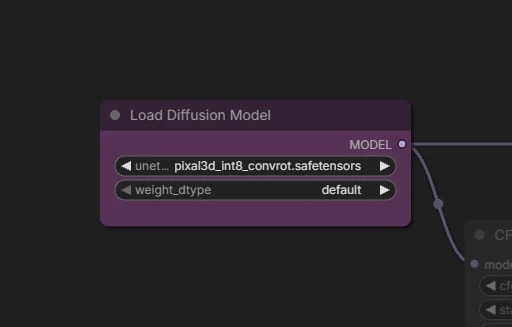
把扩散模型换成 pixal3d_int8_convrot.safetensors。VAE 和 DINOv3 与 TRELLIS.2 相同。
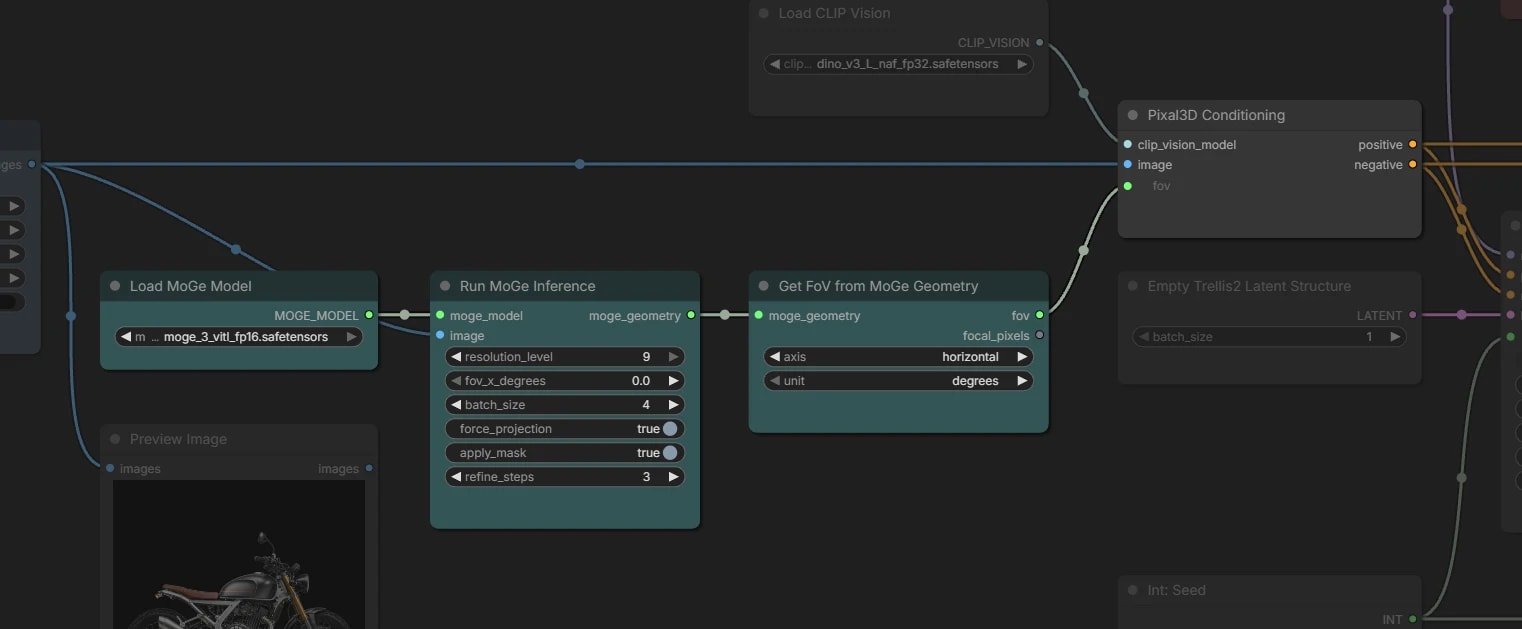
用 MoGe 估计视场角
Pixal3D 会利用拍摄图像的相机视场角(FOV),把图像投影到 3D 空间。
这个工作流使用 MoGe-3 来估计 FOV。
Pixal3D 多视图
从正面、左侧、背面、右侧 4 张图像生成 3D 模型。
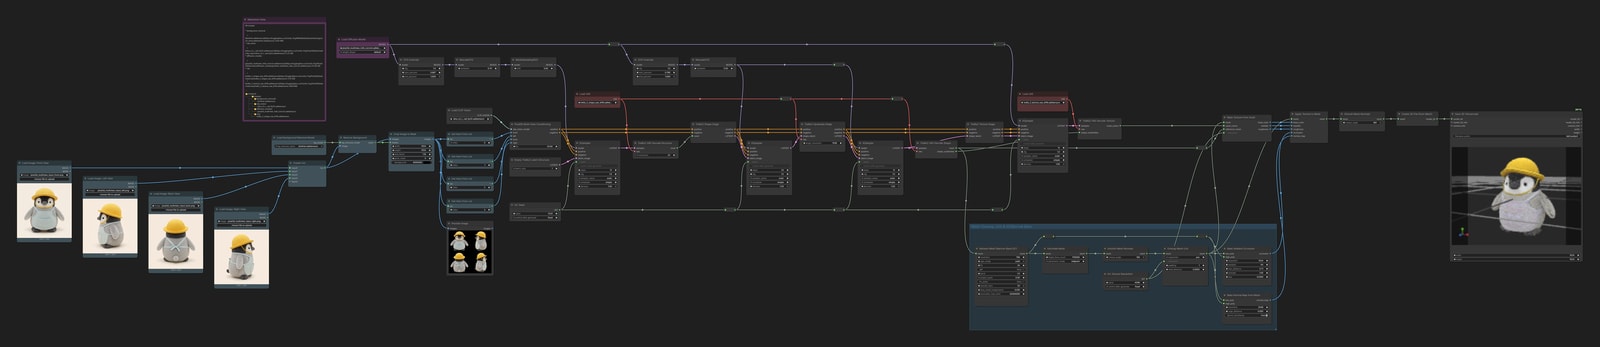
多视图图像是用 Qwen-Image-2.1 生成的。也可以用视频生成模型做一段旋转视频再抽帧,用你喜欢的方法准备就好。
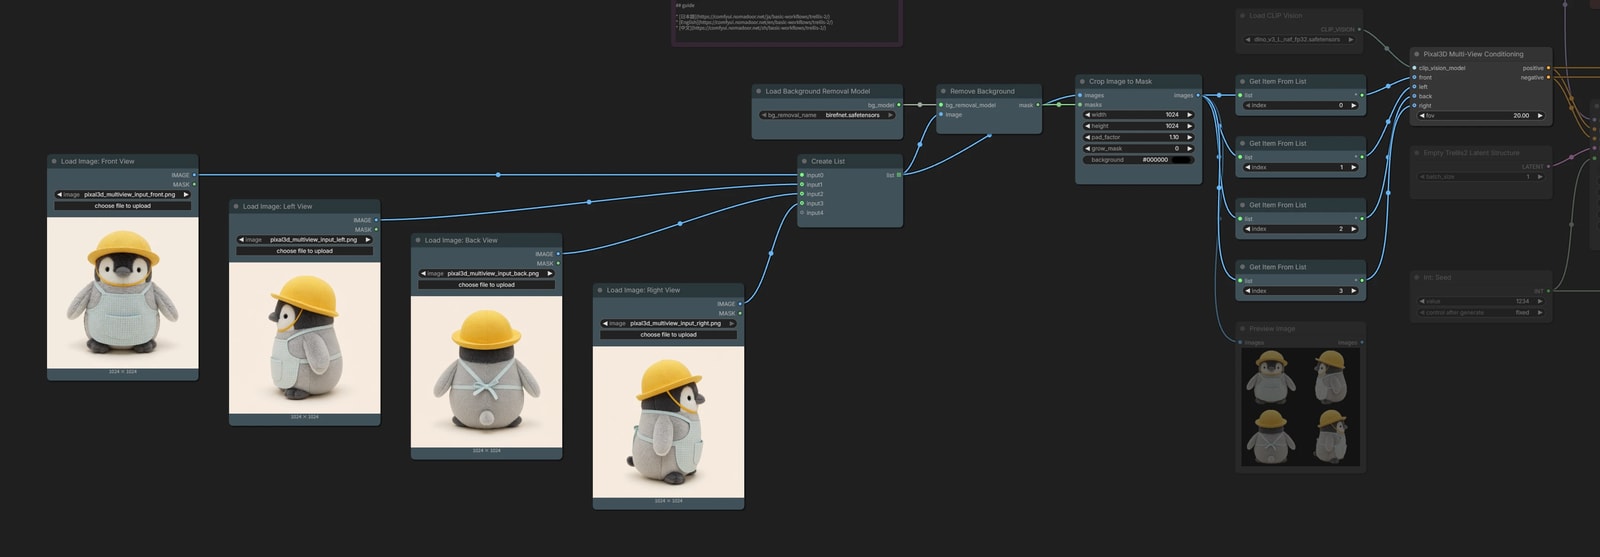
4 个视角的输入
对 4 张图像分别做和上面一样的处理,生成黑色背景的图像。
为了让工作流更紧凑,这里先把它们合成一个列表依次处理,再用 Get Item From List 逐张取出。
fov保持默认的 20- 使用照片时,用 MoGe 从其中一张估计出的值填进去也许更好。