为什么大家都用 512px 左右生成?
在 Stable Diffusion 1.5 中,基本都是以 512px × 512px 生成图像。
现在 YouTube 的分辨率是 1920×1080(1080p),平时画画的人也许会准备 3000px 左右的画布。 可是在图像生成里,大家却都用 512px 左右来生成。为什么分辨率这么低呢?
原因主要有 2 个。
- 模型是用 512px 左右的图像训练的
- 分辨率一提高,计算成本就会猛涨
1. 模型是用 512px 左右的图像训练的
Stable Diffusion 1.5 几乎都是用 512px × 512px 的正方形图像 训练的。
- 竖图和横图,也是裁剪成 512px 的正方形再拿去训练
- 结果就是,它擅长“画 512px 左右的正方形”,但“更大的画”或“极端的竖长、横长”根本没练习过
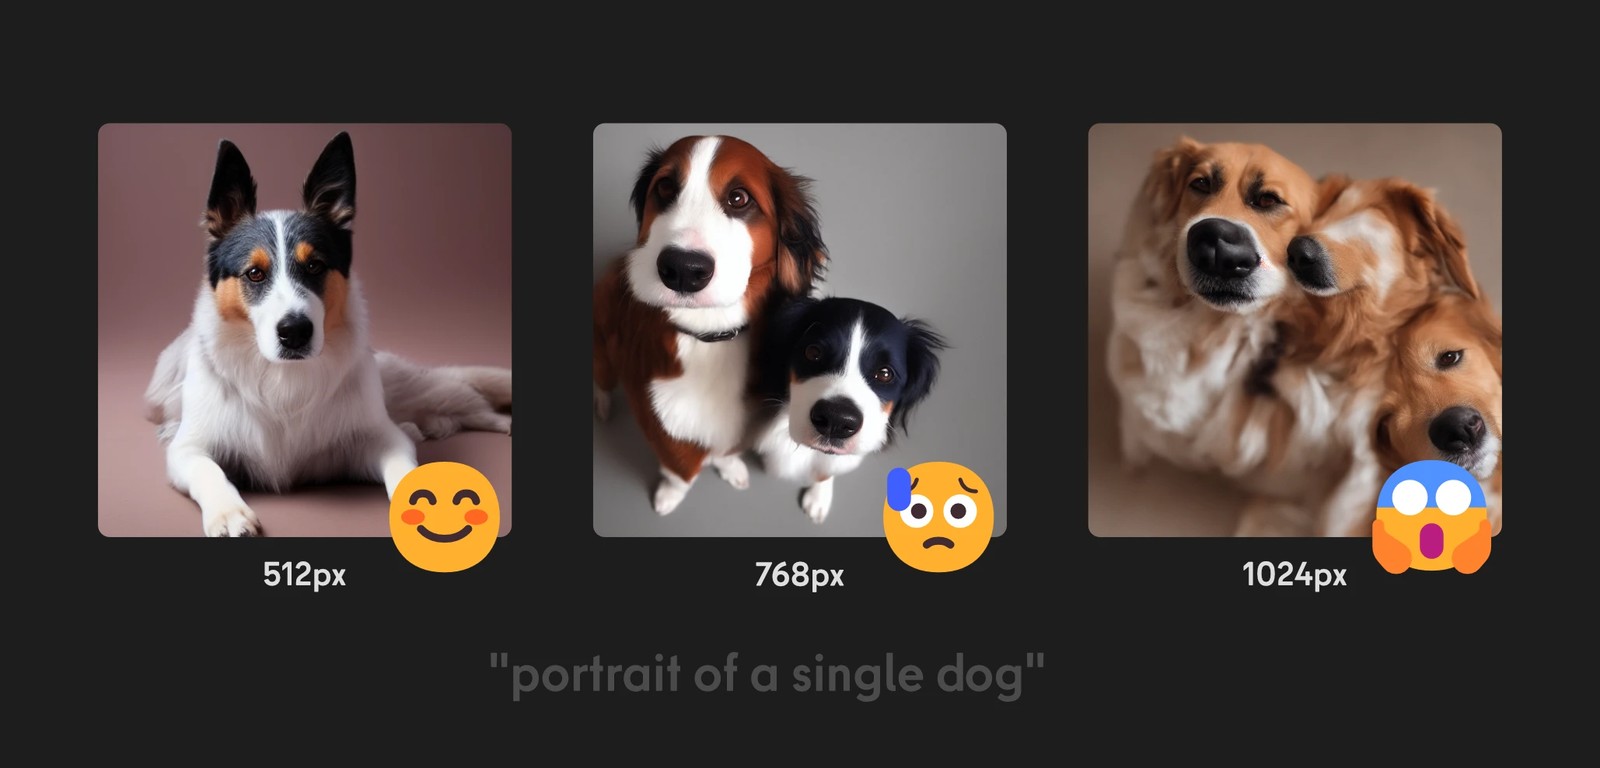
实际用 768px 或 1024px 生成试试,明明写的是 a single dog,狗却会分裂成好几只。
与其说是 “用 512px 生成”,更准确地说,“只有在 512px 左右才能生成得好”,这才是根本原因。
解决方案:Hires.fix
其中一个解决方案是 Hires.fix。
- 先在模型擅长的 512 × 512px 左右生成图像
- 把这张图放大,再以放大后的图为草稿重新画一遍(image2image)
不是一上来就让它画不擅长的尺寸,而是 “先经过一次擅长的尺寸,再变成大图”,就是这样的思路。
2. 分辨率一提高,计算量就猛增
另一个原因很简单,就是 计算量的问题。
- 宽、高变成 2 倍,像素数就变成 4 倍
- Diffusion 的步数和模型大小都不变,所以 VRAM 和计算时间基本上都接近“×4”
Stable Diffusion 1.5 的模型本身比较小巧,但即便如此,一上来就让它把 1024px、2000px 这样的大分辨率当作 1 张图来画,负担还是相当重。
解决方案:节省 VRAM 和分块方法
想提高分辨率时,有几种应对方法。
-
节省 VRAM
- 使用 高速化和轻量化 中的技巧,调整模型和精度来降低 VRAM 占用
-
使用分块方法
- 不一次生成整张图,而是用分块生成再拼合的 Ultimate SD upscale
- 把分块数增加到 4 块、8 块,理论上可以做出任意高的超高分辨率图像
SDXL 之后的情况
以上说的,终究是 SD1.5 那一代的前提。 之后的模型,在训练分辨率和宽高比的处理上都在逐渐变化。
-
NovelAI Diffusion 之后
- NovelAI 是早期专注于动漫风格的图像生成服务,它在数据集上下了功夫,把竖图和横图也用于训练。因此能更容易地以各种宽高比生成图像。
- 之后出现的许多模型,混合各种分辨率的图像进行训练已经成为常态。
-
SDXL
- 训练分辨率的基准提高到了 1024px × 1024px。
- 更新的模型中,也有越来越多能从低分辨率到更高分辨率(1~2 百万像素级)都比较稳定输出的模型。
- 由于架构的改进,像以前那样“分辨率一提高计算量就爆炸”的极端情况也减少了。
话虽如此,下面的思路到现在也没有变。
- 先用该模型最擅长的“推荐分辨率”生成试试
- 以此为基准,根据需要用 Hires.fix、放大或分块方法来扩展
首先 “在模型练习过的分辨率范围内出一张图”。 512px 只不过是 SD1.5 的这个起点而已。