什么是 FLUX.2 [klein]?
FLUX.2 [klein] 是可以用 1 个模型处理 图像生成 和 指令基础图像编辑 的,小型・高速的 Flux.2 系模型。
产品线
- 9B / 9B Base(FLUX Non-Commercial License。非商用)
- 4B / 4B Base(Apache 2.0)
虽然很难懂,无印的是蒸馏(Distilled)模型。 相当于 Base(20 steps),Distilled 可以用 4 steps 生成。
因为没有大的性能差,所以生成基本上使用 Distilled 模型。
推荐设定值
- 分辨率
- 最小 64×64
- 最大 4MP (2048×2048)
- 纵横均为 16 的倍数
- 参考图像张数
- 最大 4
Flux.2 [klein] 9B
模型的下载(9B)
-
diffusion_models
-
text_encoders
-
vae
📂ComfyUI/
└── 📂models/
    ├── 📂diffusion_models/
    │   ├── flux-2-klein-9b-fp8.safetensors
    │   └── flux-2-klein-base-9b-fp8.safetensors
    ├── 📂text_encoders/
    │   └── qwen_3_8b.safetensors
    └── 📂vae/
        └── flux2-vae.safetensors
text2image Base
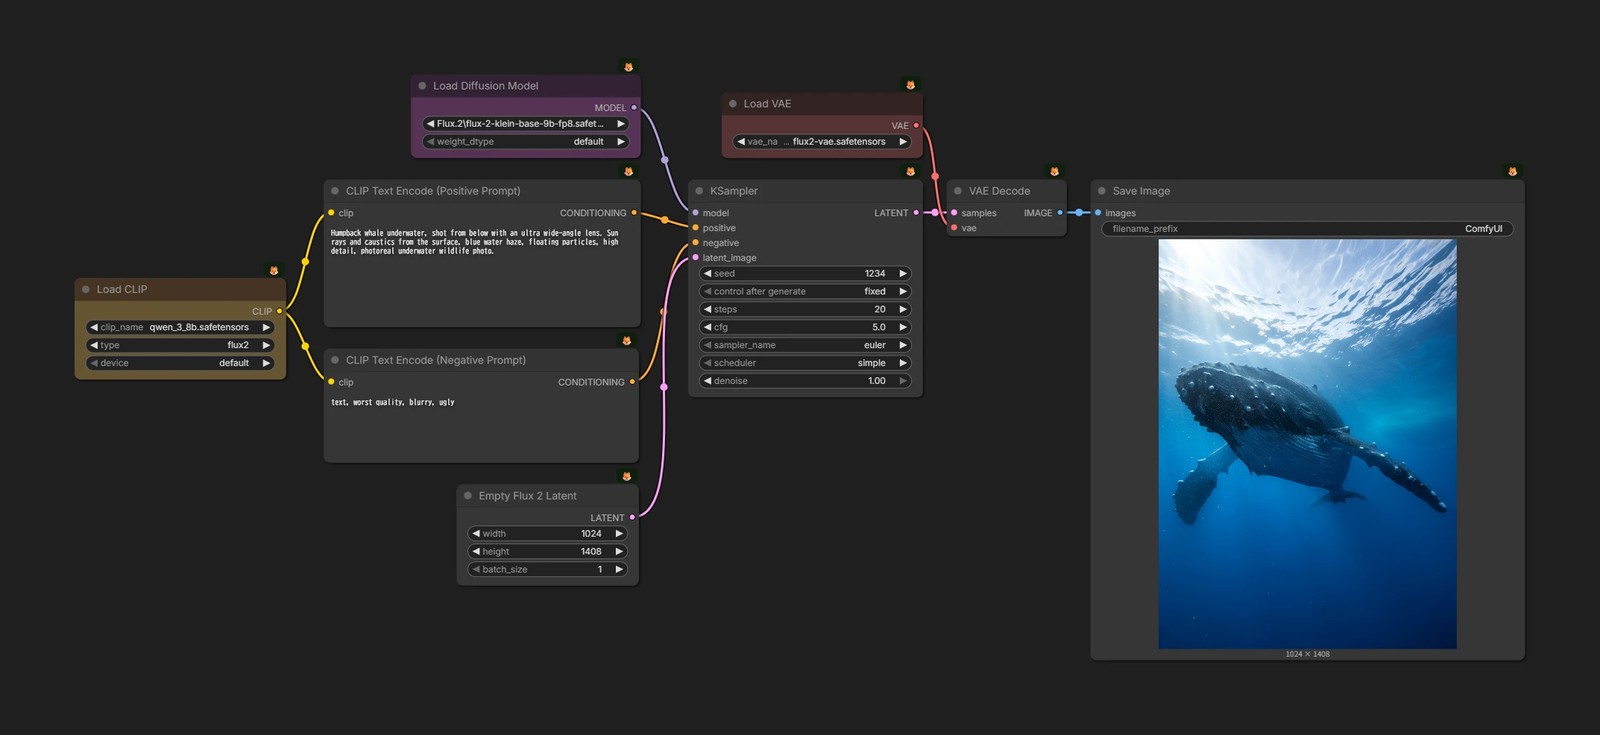
虽然在官方工作流中,使用叫
Flux2Scheduler的东西,但因为没有大区别,为了简化工作流使用了Simple。
text2image Distilled
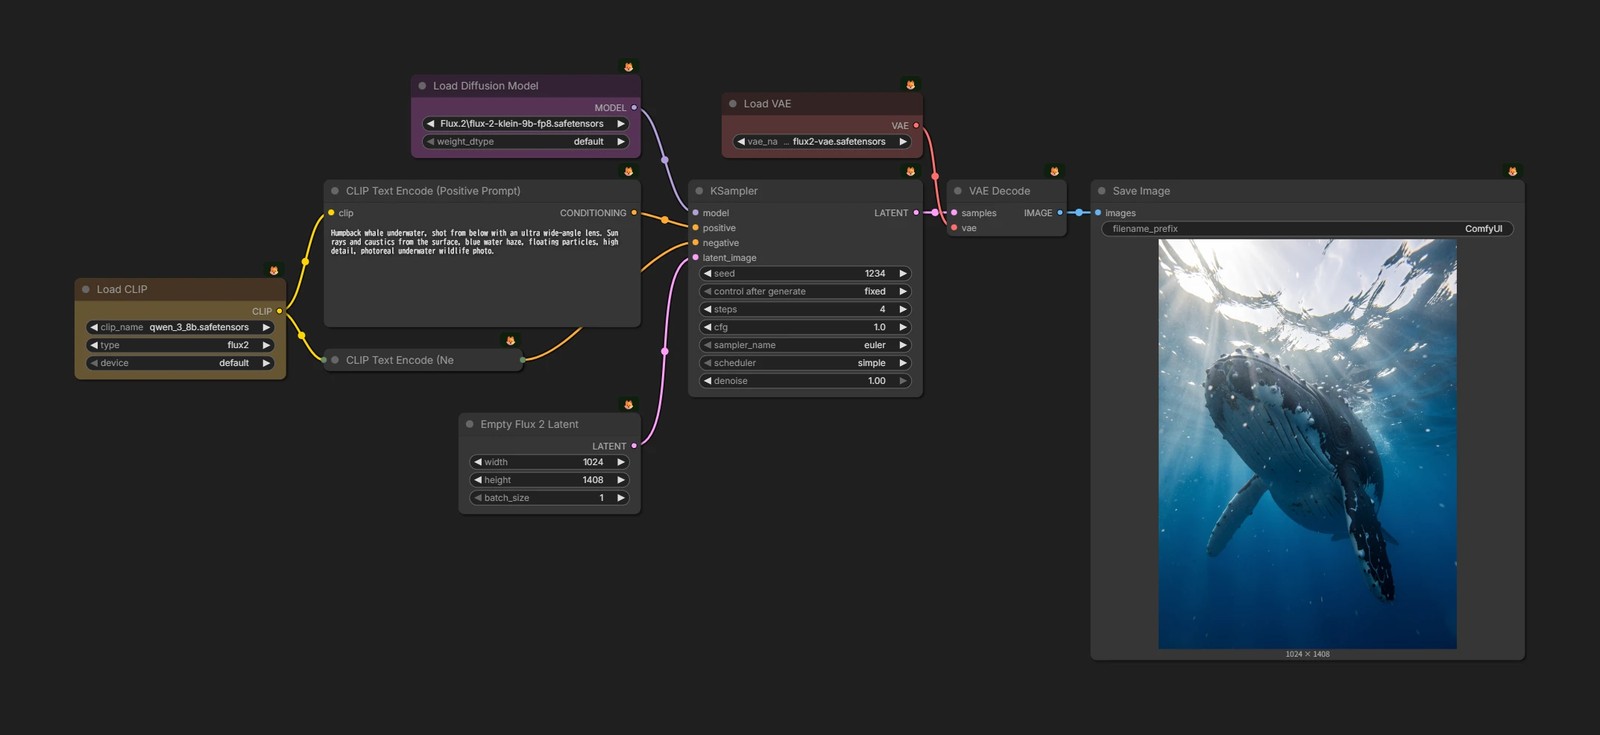
只变更以下的参数。
CFG: 1.0steps: 4
图像编辑 Base
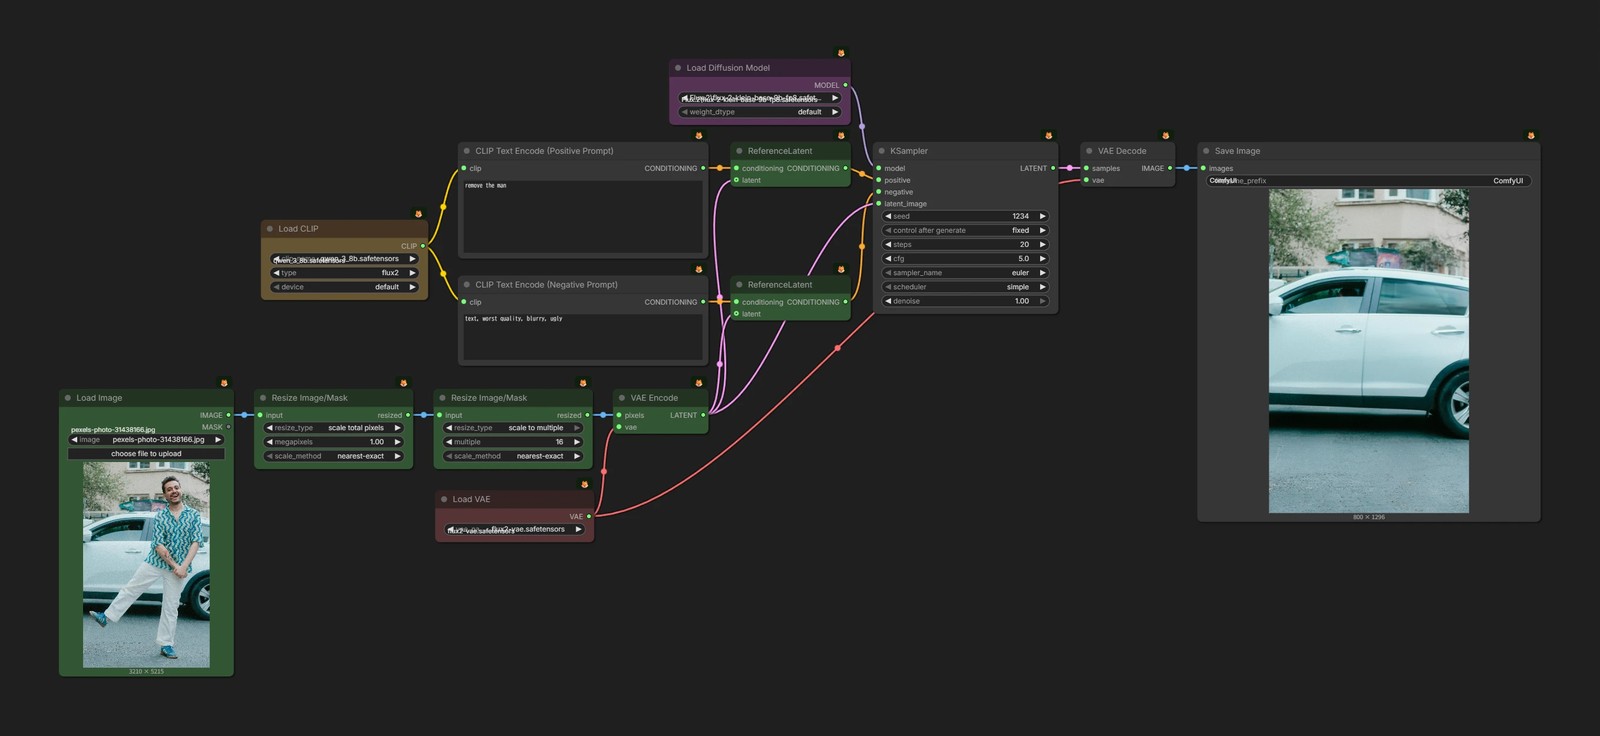
“输入图像 + 指令提示词” 是基本。
- VAE Encode 输入图像,传递给
ReferenceLatent。
图像编辑 Distilled
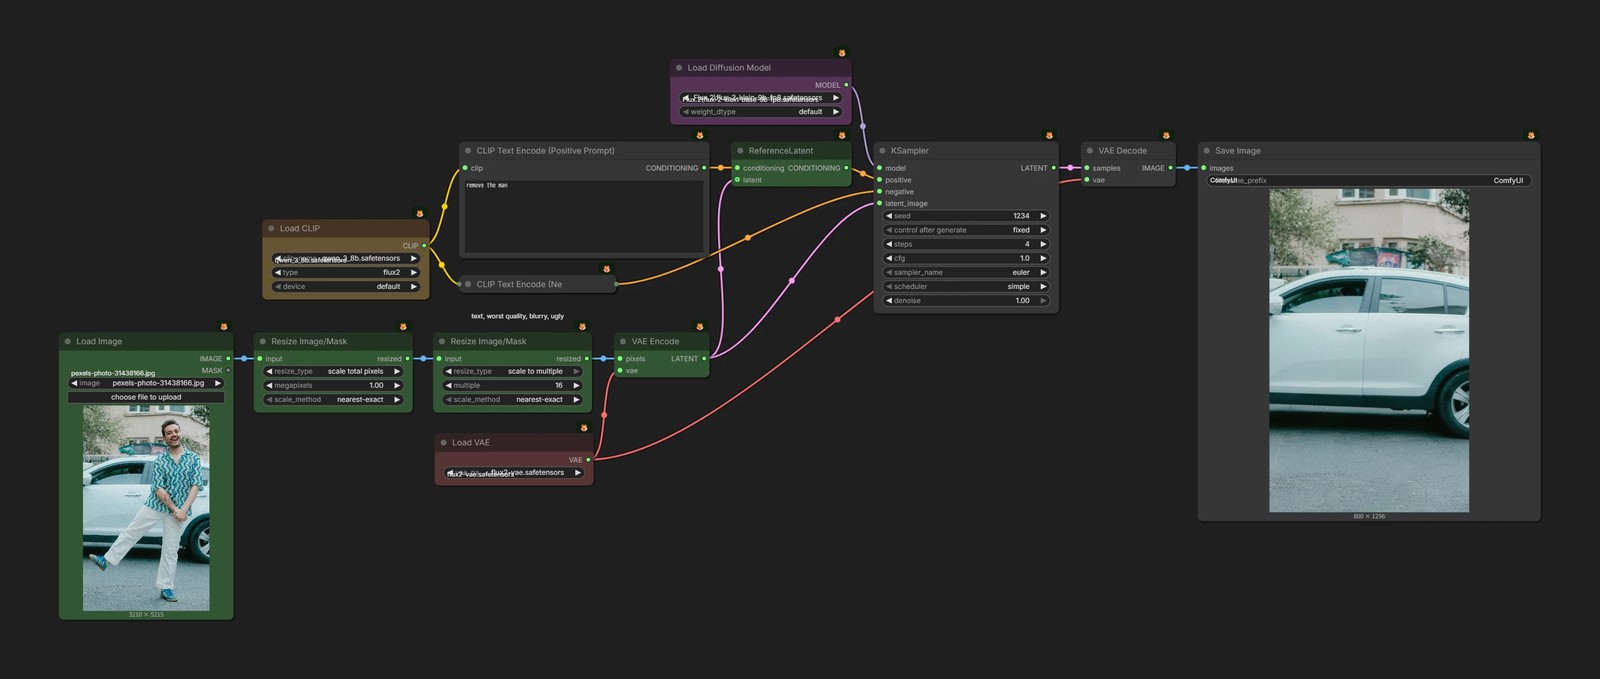
图像编辑(Multi-Reference)Base
也可以输入多张图像让其参考。
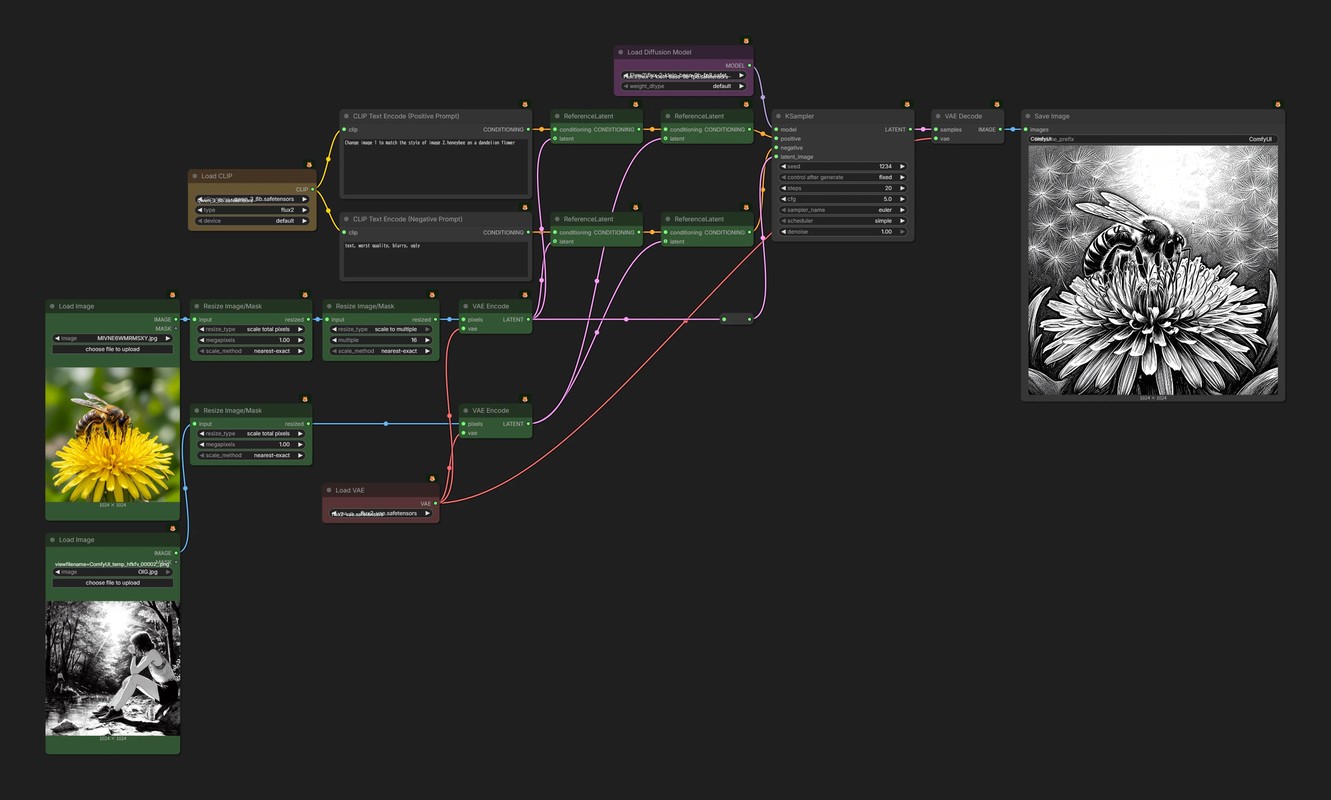
- 只要串联连接
参考图像 → VAE Encode → ReferenceLatent这个块就行。 - 2 张或 3 张都 OK。(但是上限是 4)
图像编辑(Multi-Reference)Distilled
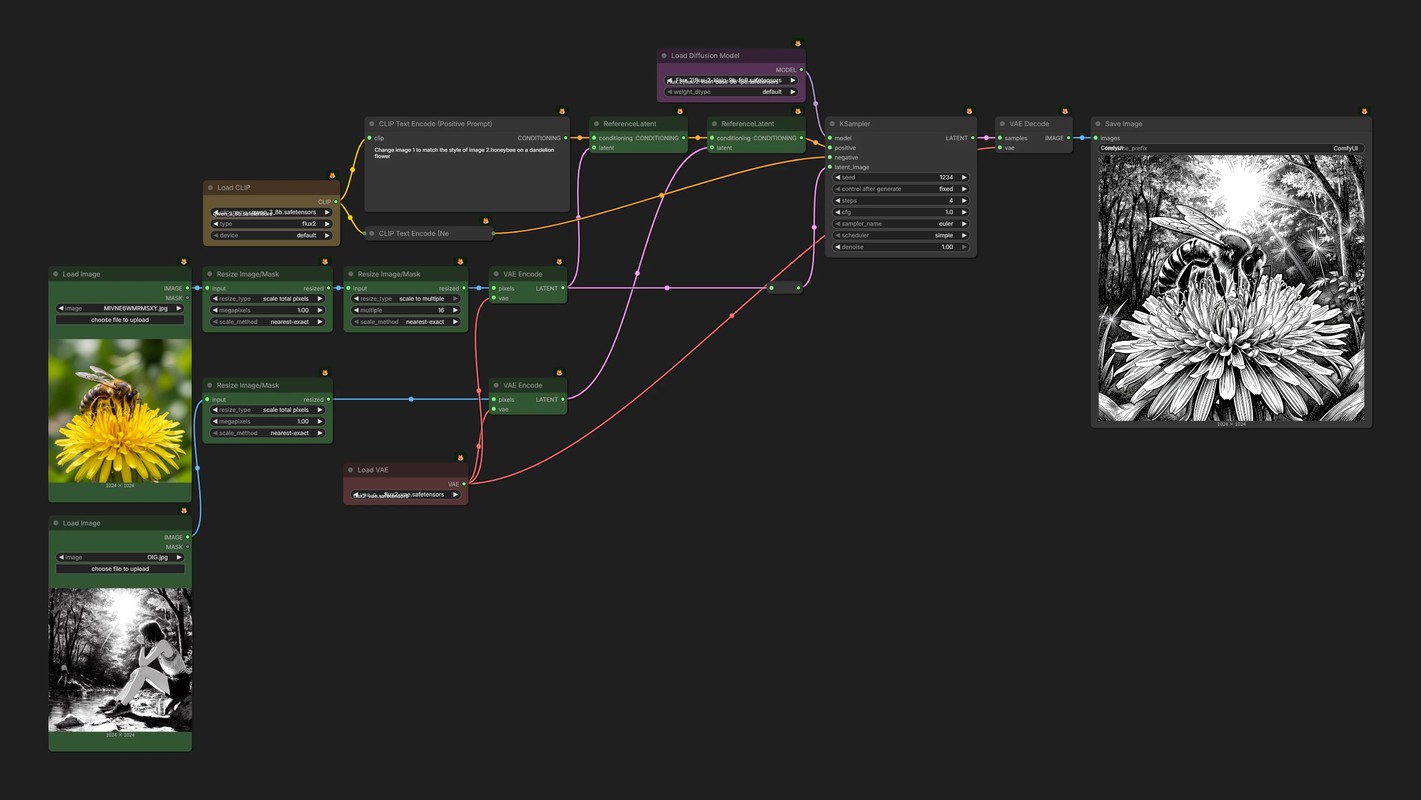
Flux.2 [klein] 4B
模型的下载(4B)
-
diffusion_models
-
text_encoders
-
vae
📂ComfyUI/
└── 📂models/
    ├── 📂diffusion_models/
    │   ├── flux-2-klein-4b.safetensors
    │   └── flux-2-klein-base-4b.safetensors
    ├── 📂text_encoders/
    │   └── qwen_3_4b.safetensors
    └── 📂vae/
        └── flux2-vae.safetensors
工作流
基本和 9B 完全一样。
只是根据将模型和文本编码器替换为 4B 的东西。
text2image
图像编辑
图像编辑(Multi-Reference)
能做的事
这儿的终究只是一个例子。
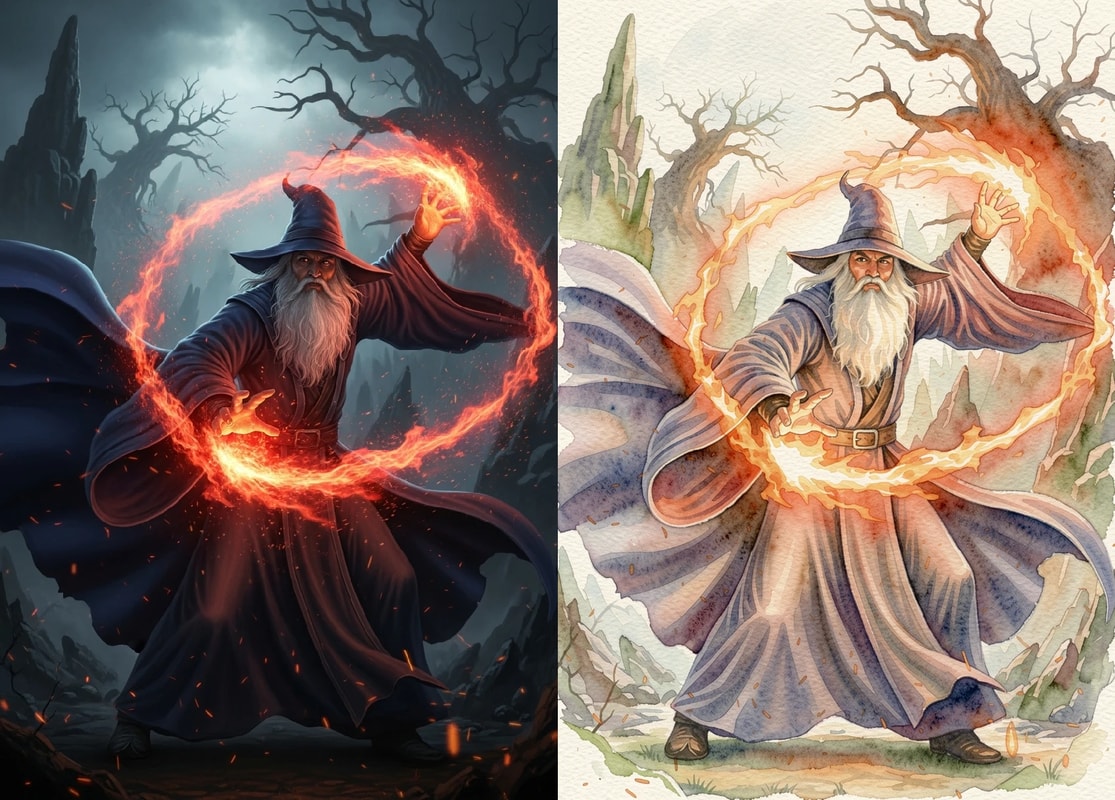
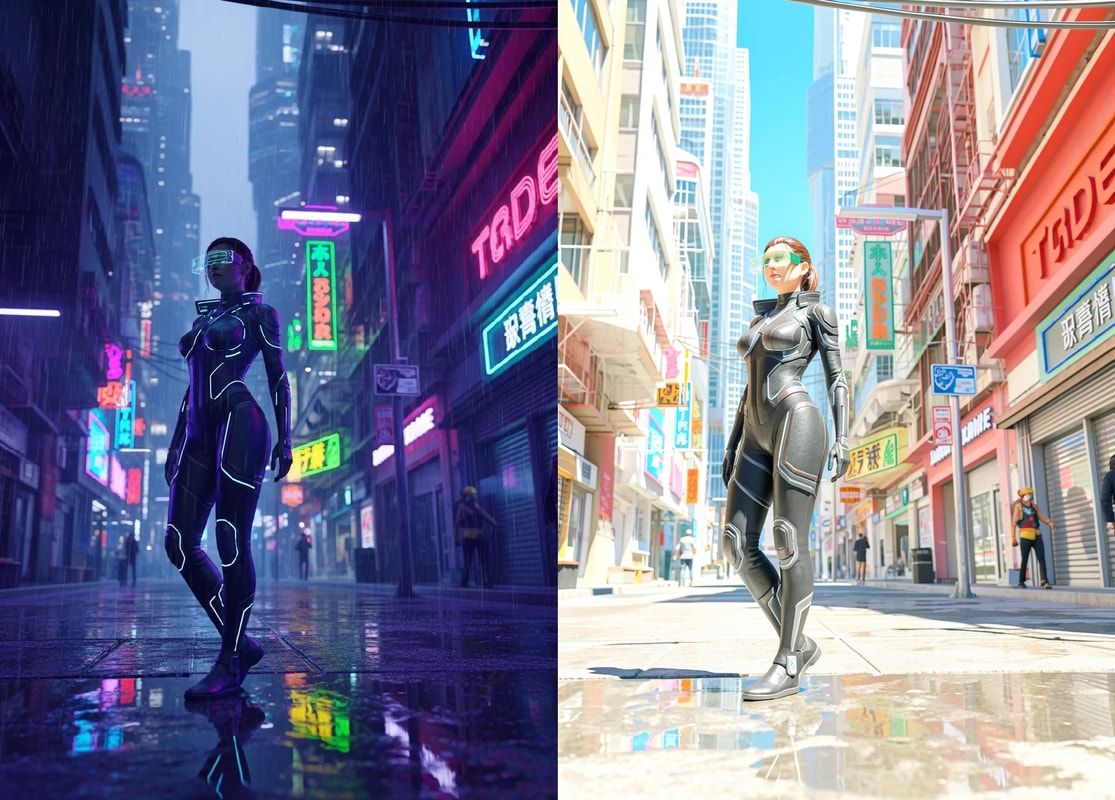
改变画风,消除对象不过是图像编辑的一小部分。将什么视为“图像编辑”?能做的事无限宽广。请开发各种各样的使用方法。
单一图像
Workflows单一图像
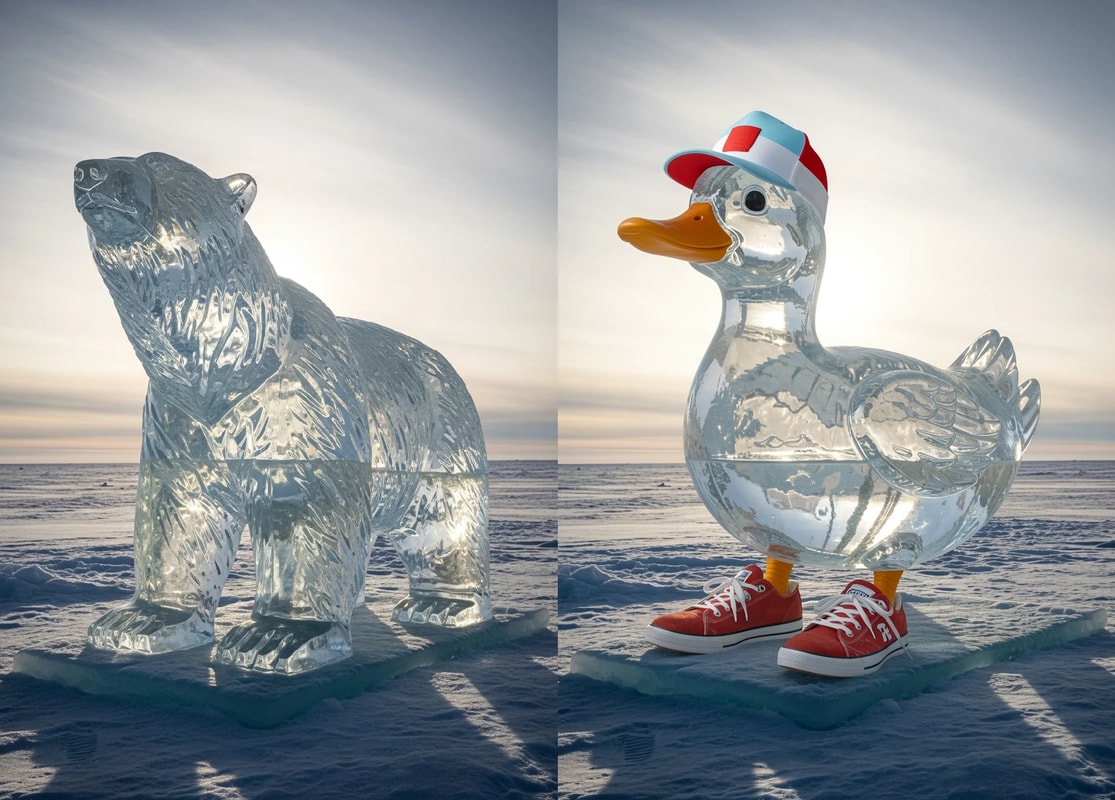
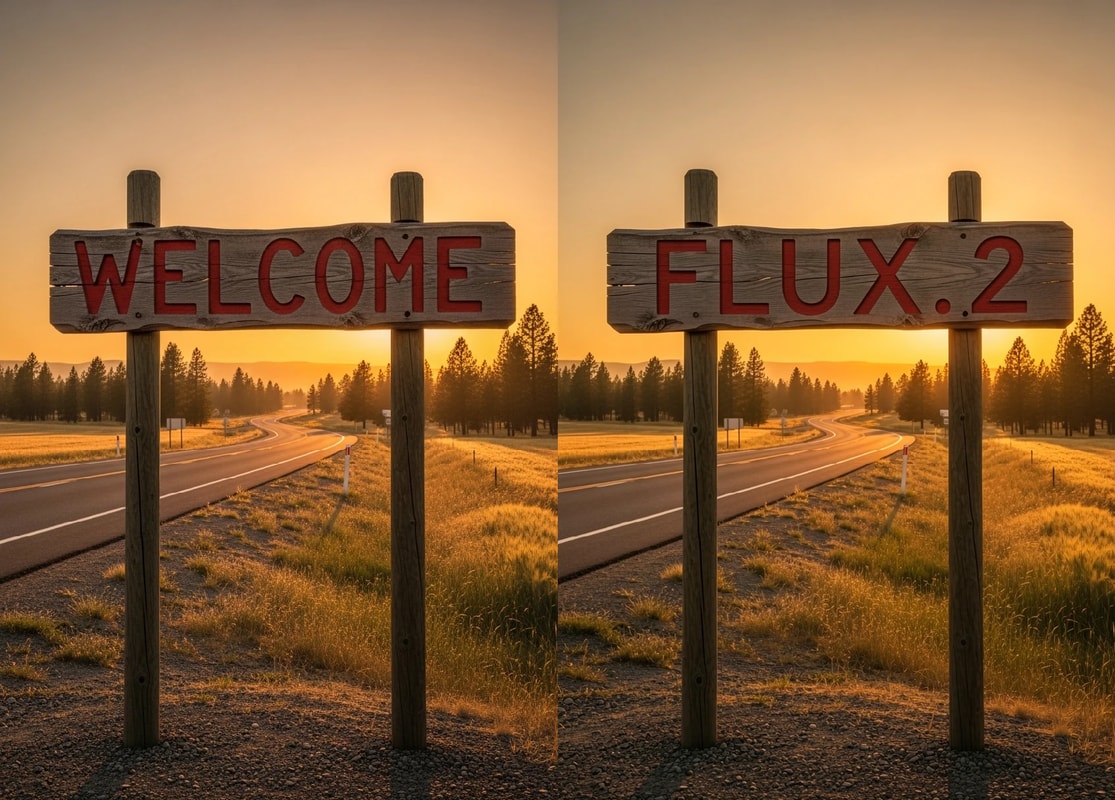
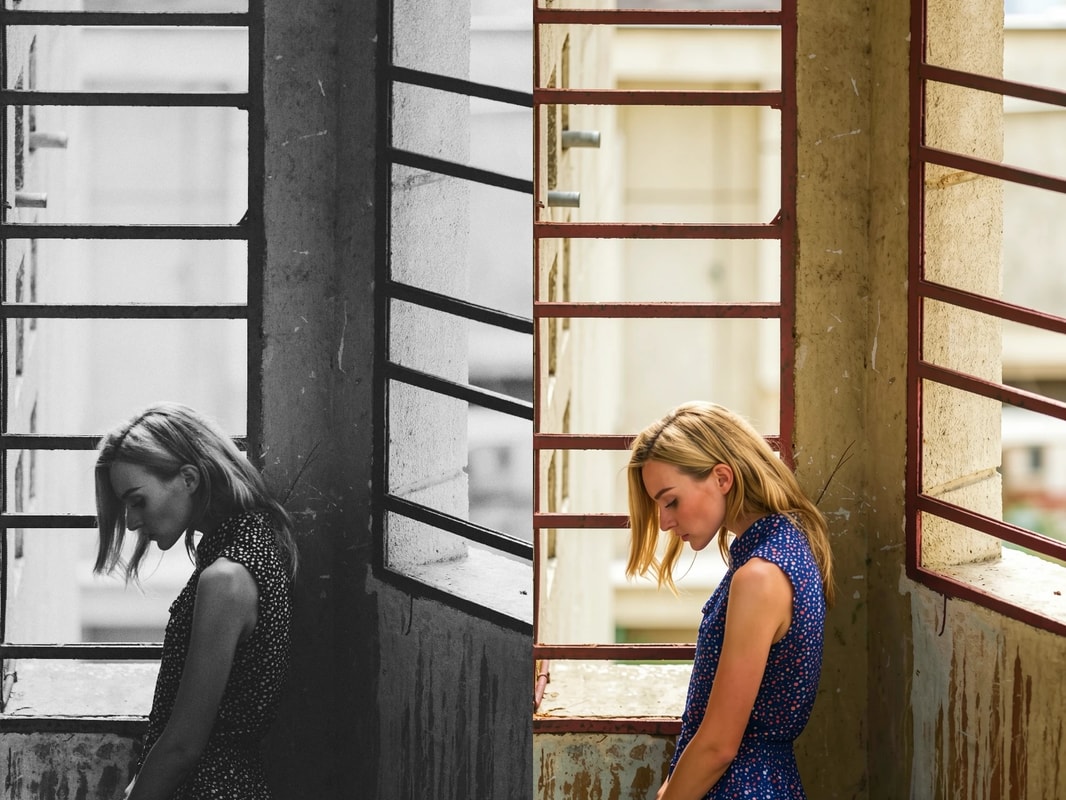
ControlNet-like(Pose)
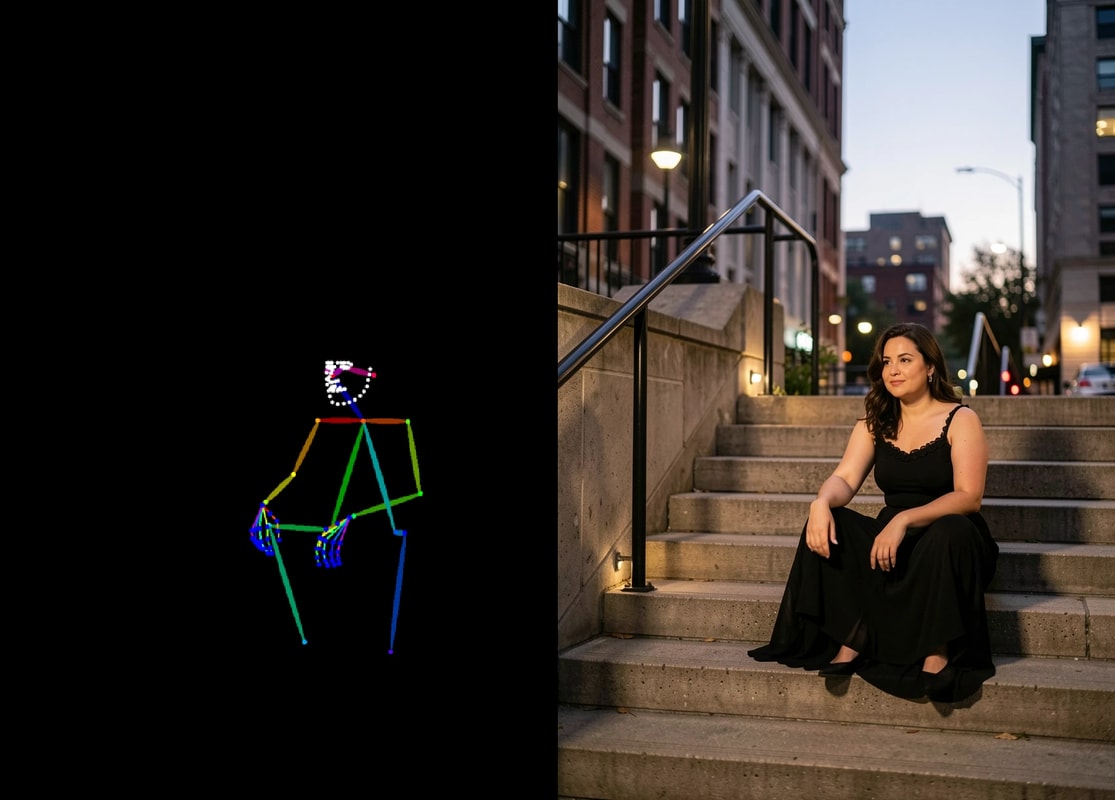
并不是以 ControlNet 的机制在动。
通过给予火柴人或深度图,让其以之为基础生成真实的图像,作为图像编辑可以进行 ControlNet 式 的任务。
A office lady sitting on outdoor stairs at dusk, matching the pose from the reference image. Evening ambient light, calm urban atmosphere. She wears a long skirt and a black camisole with frills. Natural, realistic photo
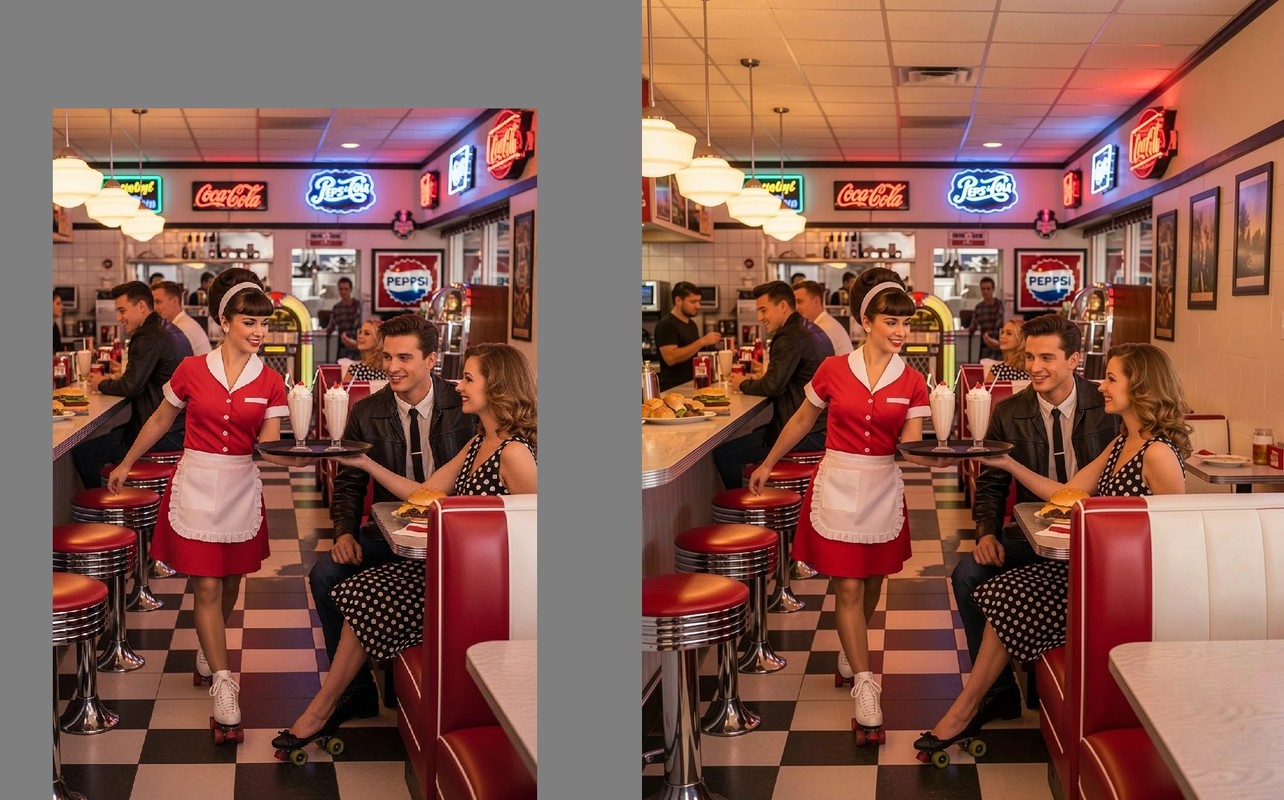
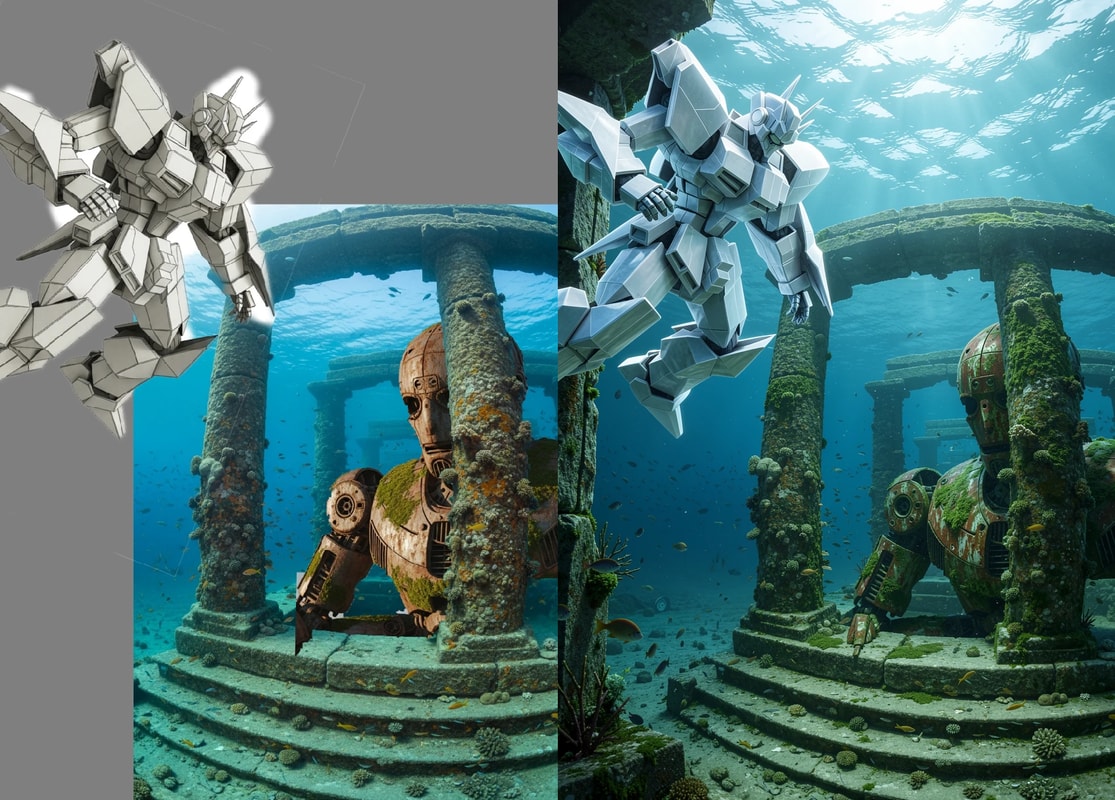
Multi-Reference 图像编辑
WorkflowsMulti-Reference 图像编辑