什么是 Florence-2?
是看图像进行说明文生成・物体检出・分割・OCR 等,1 个模型能完成几个任务的通用 VLM(Visual Language Model)。
在这一页,聚焦于在 ComfyUI 经常使用的“说明文生成”“物体检出(坐标抽出)”“OCR”“关于图像的 Q&A”这 4 个进行处理。
自定义节点
- kijai/ComfyUI-Florence2
- 模型在最初执行时被自动下载。
Florence2Run 节点
Florence2Run 是,为了对输入图像让 Florence-2 执行任务的主节点。通过切换 task,可以区分使用说明文生成或物体检出、OCR 等功能。
caption, detailed caption
从图像生成自然文的说明文。
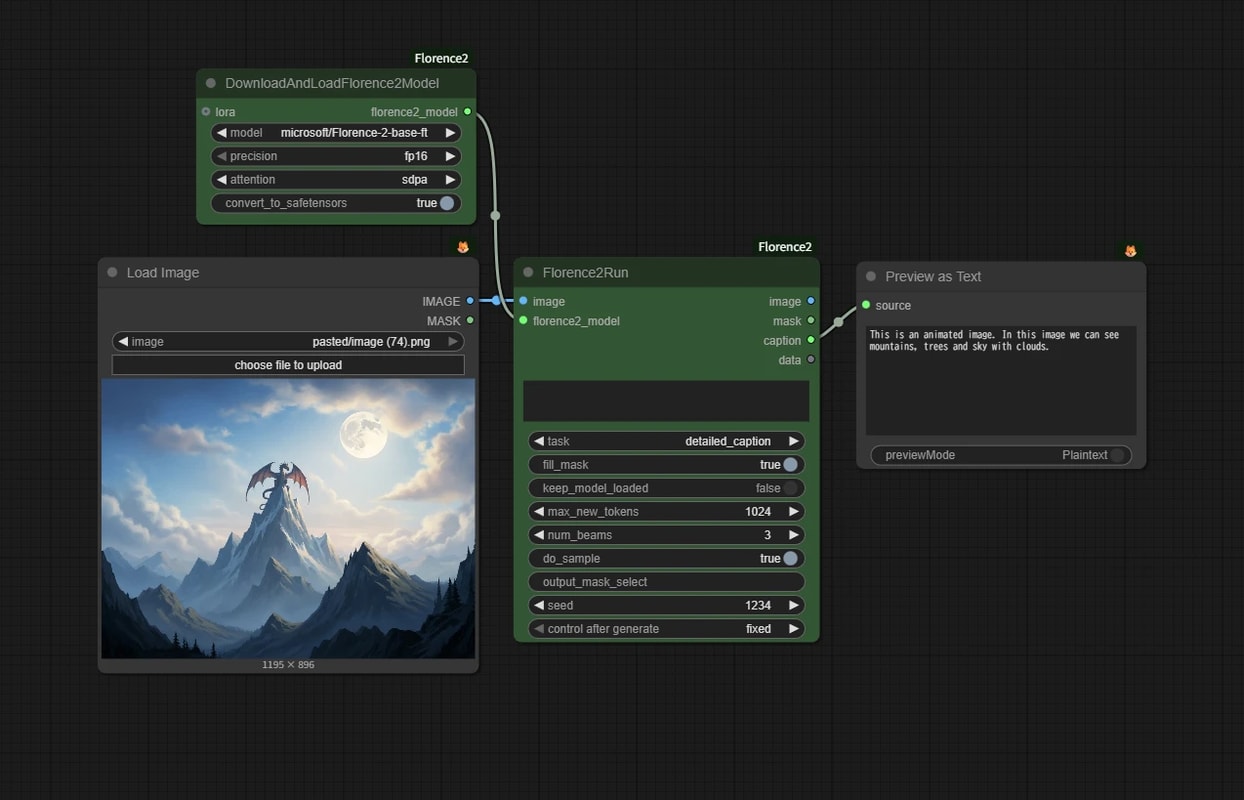
caption- 简单地说明图像的概要。
detailed caption- 稍微详细地说明构图或外观。
但是,如果目的只是“提示词用的说明文”,使用 JoyCaption 等,说明文专用模型的一方会出现遥远地更柔软且高质量的东西。
caption_to_phrase_grounding
每指定说明文的短语,以矩形(边界框)的形式输出物体的位置。
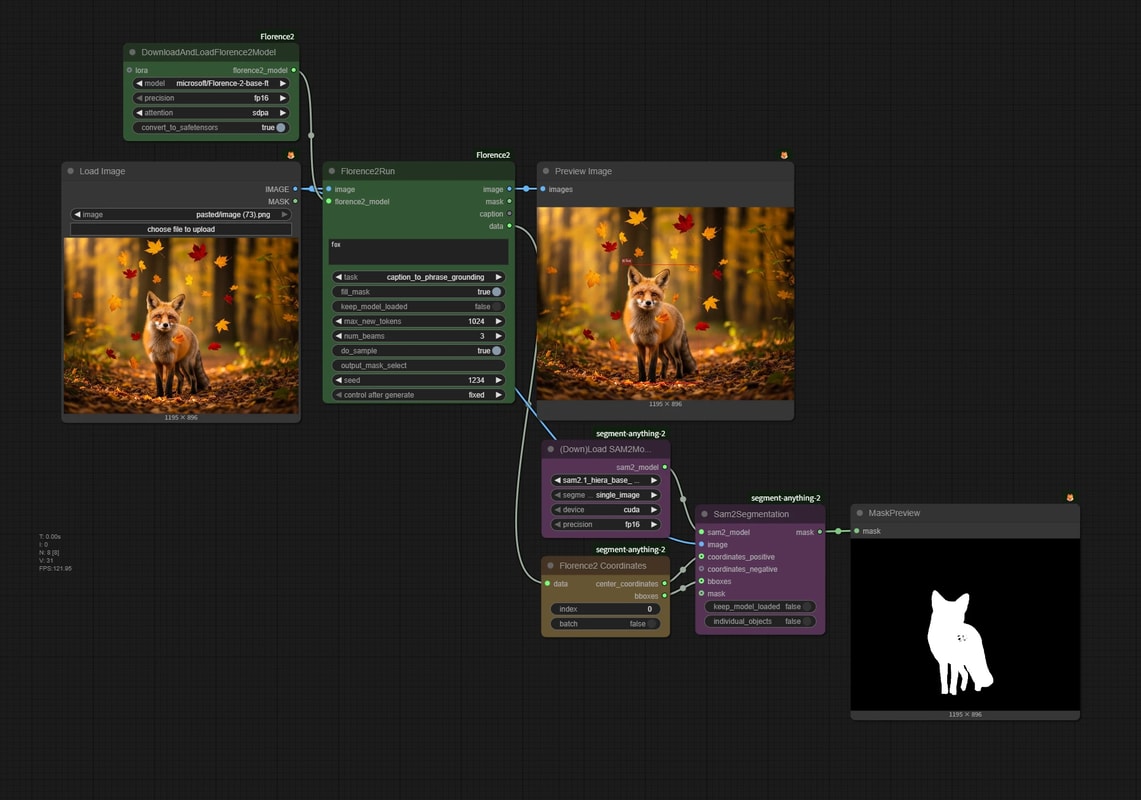
- 能取到“left tree”“red car”等,稍微复杂的指示的位置是特征。
- 🟨 用
Florence2 Coordinates节点取出坐标,通过与 SAM2 等的分割模型组合,可以做只将特定的物体掩膜化这样的使用方法。
ocr
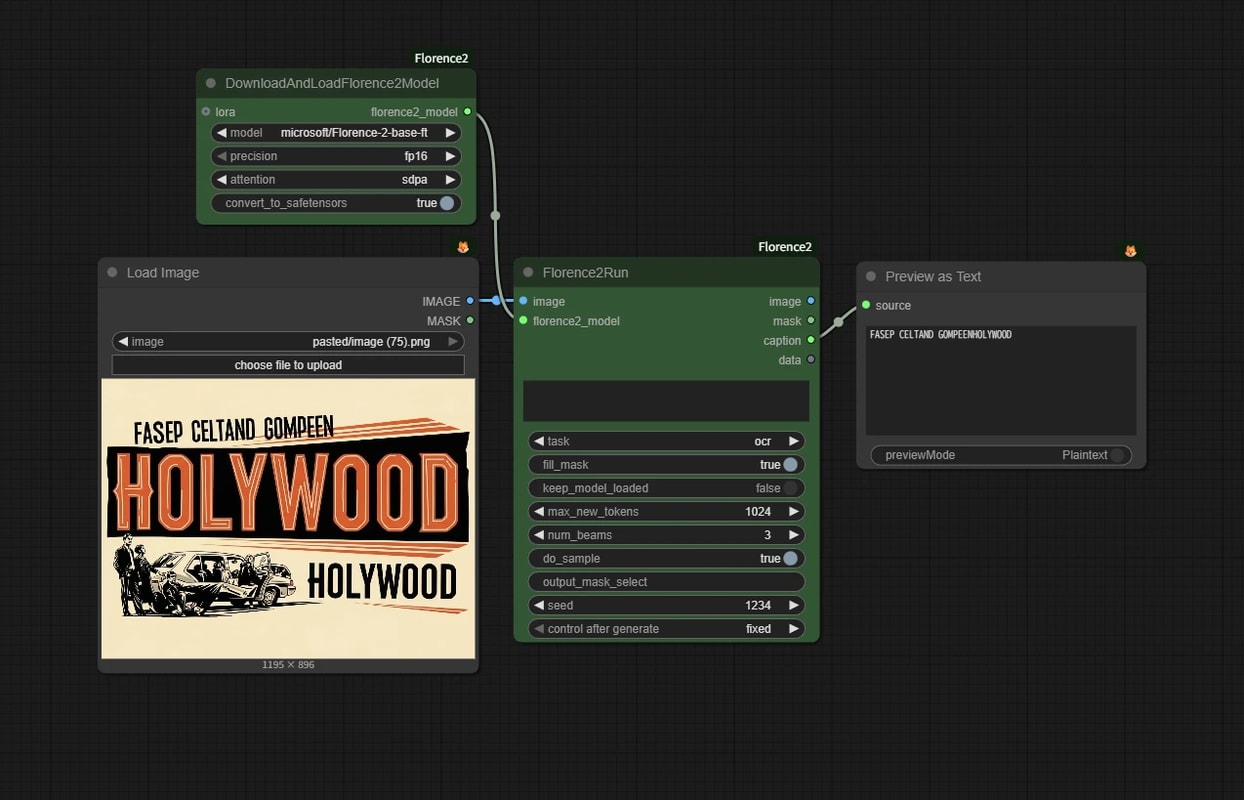
读取图像内的文字,作为文本输出。
docvqa
回答关于图像的问题的任务。
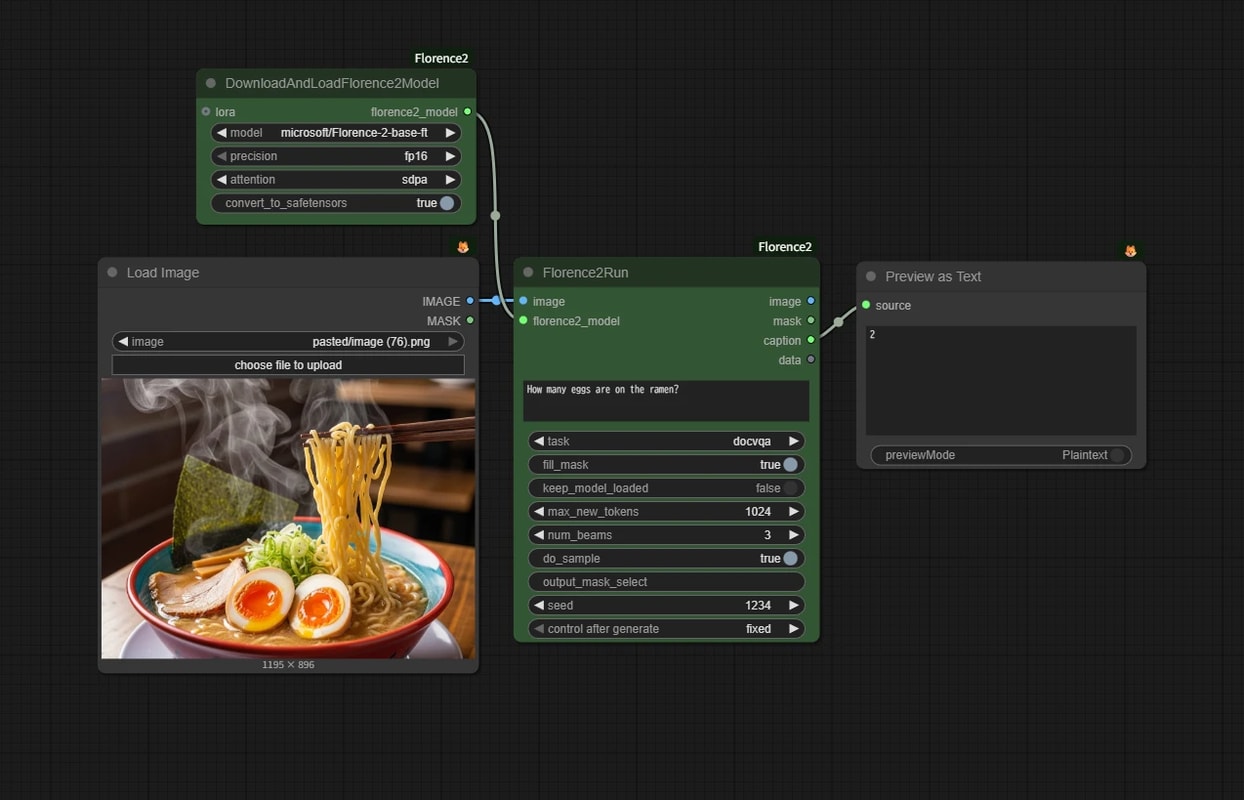
- 投出“这幅图像中〇〇在哪里?”“这个表的值是?”之类的问题,可以以文本接收回答。
- 是向 ChatGPT 投图像提问相似的使用方法的印象。