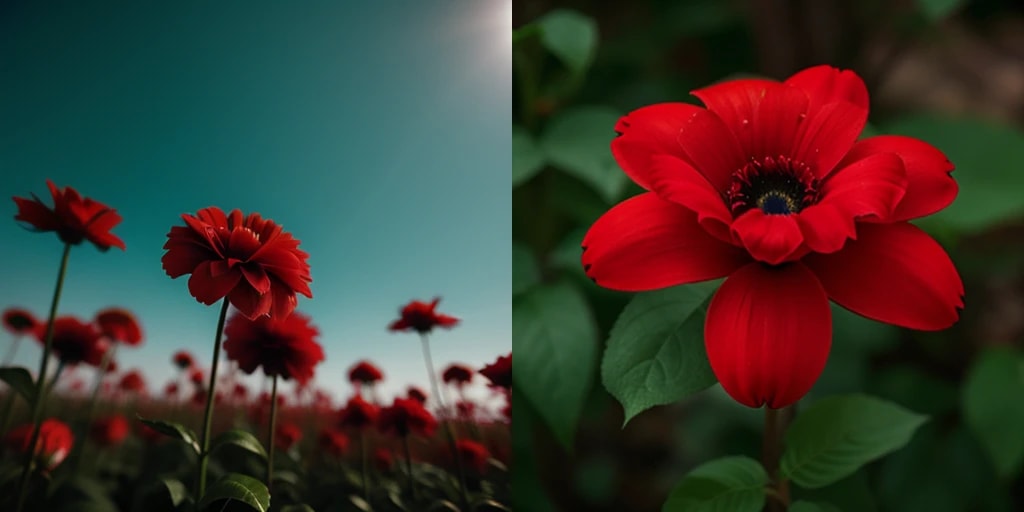
seed1234 和 1235 完全不是一回事
你应该已经有这个经验:只要改 seed,输出图像也会变化。
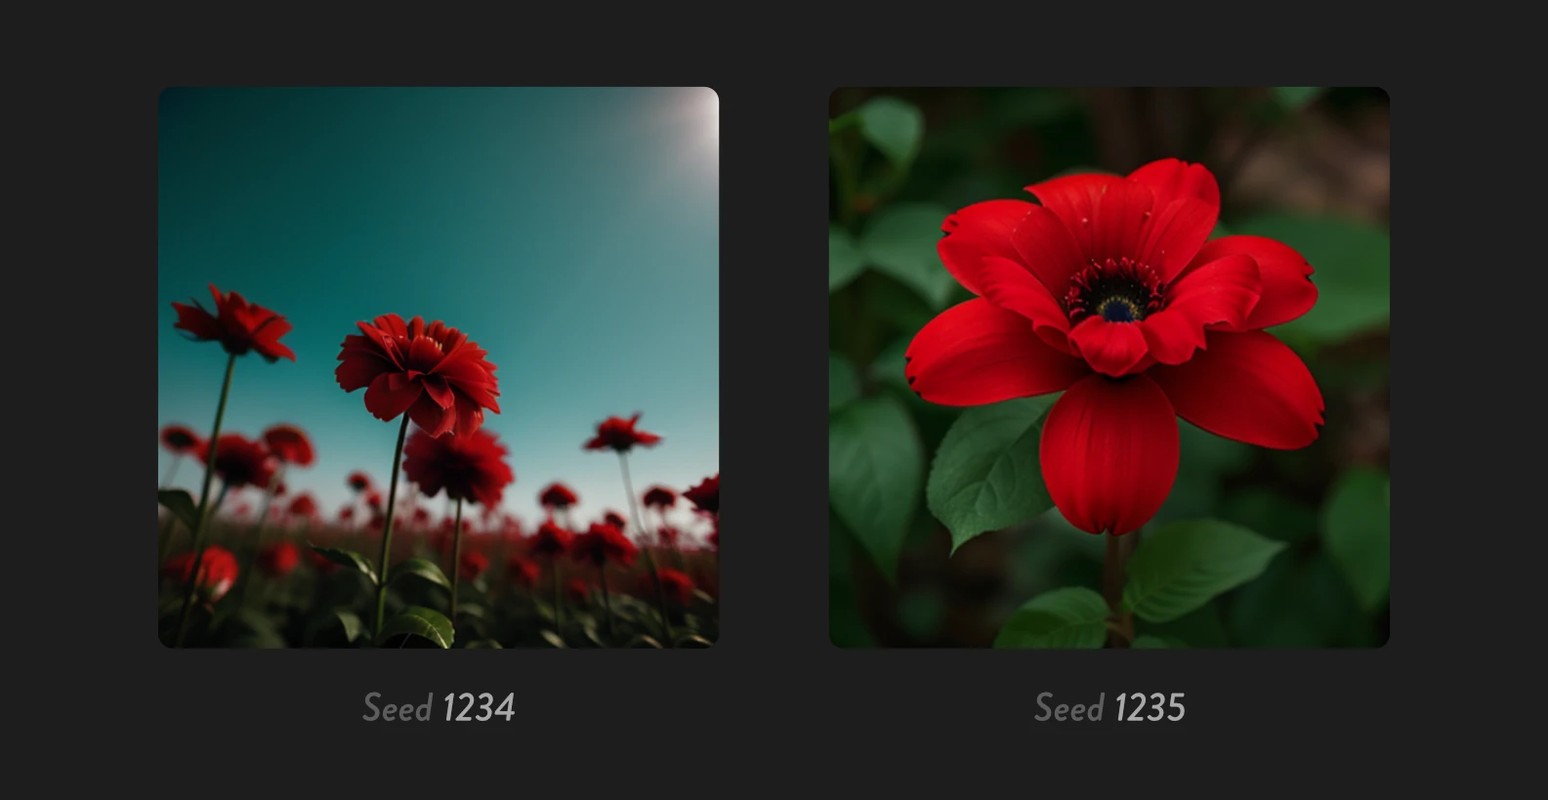
那就试试看,先用 seed=1234 生成一次,再用 seed=1235 生成一次。
数字看起来很接近,但结果往往会完全不同。
为什么会这样?
噪声与生成图像的关系
扩散模型是从噪声出发,再逐步去噪来生成图像的。
(详细可参考 扩散模型)
所以初始噪声不同,最终图像自然也会不同。
噪声与 seed 的关系
在 text2image 中,首先要生成初始噪声。
生成这个噪声时会用到随机数。
seed 就是决定随机数初始化方式的编号。
seed 是“初始化随机数的编号”
计算机并不是真正生成“完全随机数”,而是用伪随机数生成器(PRNG)来生成随机序列。
你可能会觉得“seed 很接近,随机序列也该接近吧?”但实际并不是这样。
1234和1235在人看来只差 1,很接近- 但对 PRNG 来说,它们是不同的初始化输入,生成的随机序列基本互不相关
可以这样理解:字典的第 1234 页和第 1235 页虽然相邻,但页面上的词并不保证相似。
那怎么生成相似图像?
现在我们知道了:seed 的接近程度和输出接近程度并没有直接关系。
那如果 seed=1234 生成了一张很满意的图,怎样做相似变化呢?
1. 使用 image2image
这是最简单的方法。
把已有图像作为输入,再用较小的 denoise,就能得到轻微变化的结果。
2. 混合噪声(blend)
思路很简单。
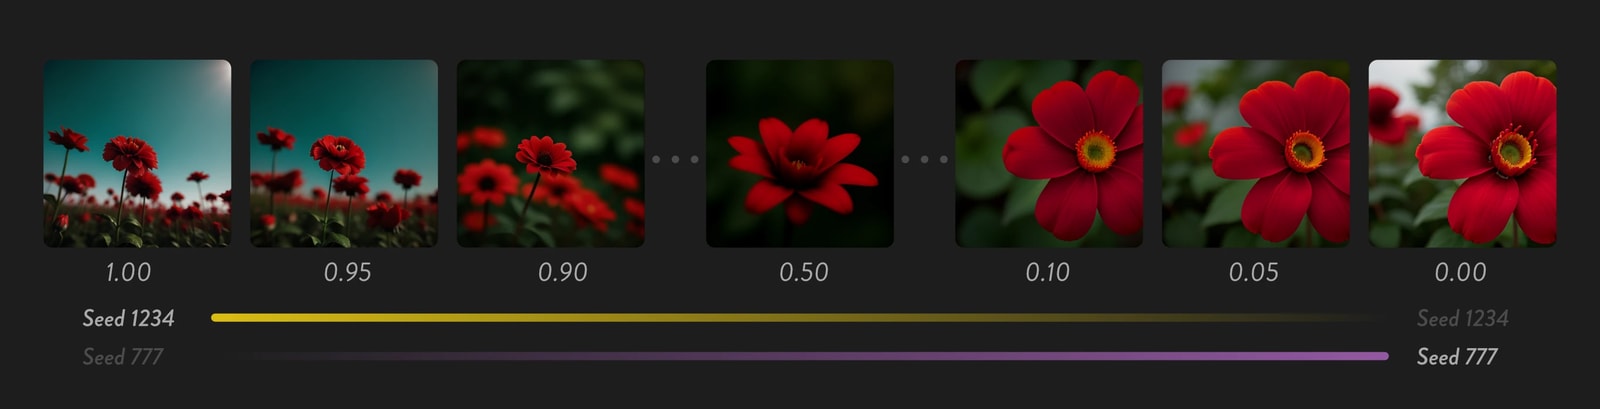
- 用
seed_A生成噪声 A - 用
seed_B生成噪声 B - 以 A 为基础,少量混入 B
通过改变 seed_B 或混合比例,就能生成细微变化的图像。
3. 注入噪声(injection)
另一种方式是:在基础 latent 上再加一点噪声 latent。
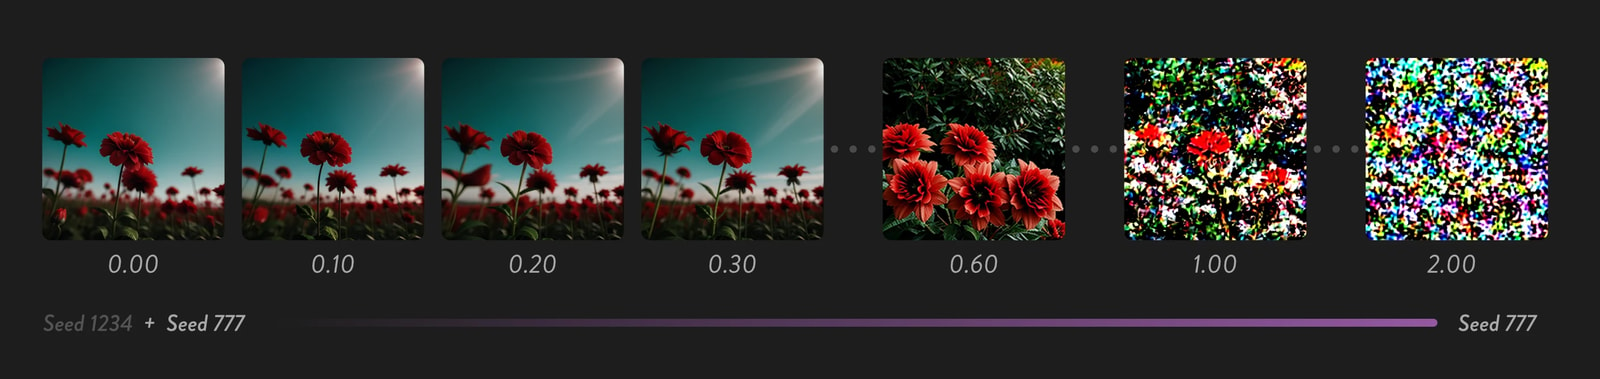
- 用
seed_A生成噪声 A - 用另一组随机数生成小噪声,再乘以
0.01这类系数后加进去
因为是“注入噪声”,总噪声量会增加。
增加一点通常没问题,但如果把 strength 提到 1.0 或 2.0,采样器可能无法充分去噪,更容易输出接近纯噪声的图像。
workflow
在普通 workflow 中,噪声生成和注入通常由 KSampler 内部完成。
而这里的做法是先在 KSampler 之前生成并操作噪声(latent)。
这在 ComfyUI 里算稍微偏“非常规”的玩法,所以很多时候直接用 image2image 会更省心。
混合噪声(blend)
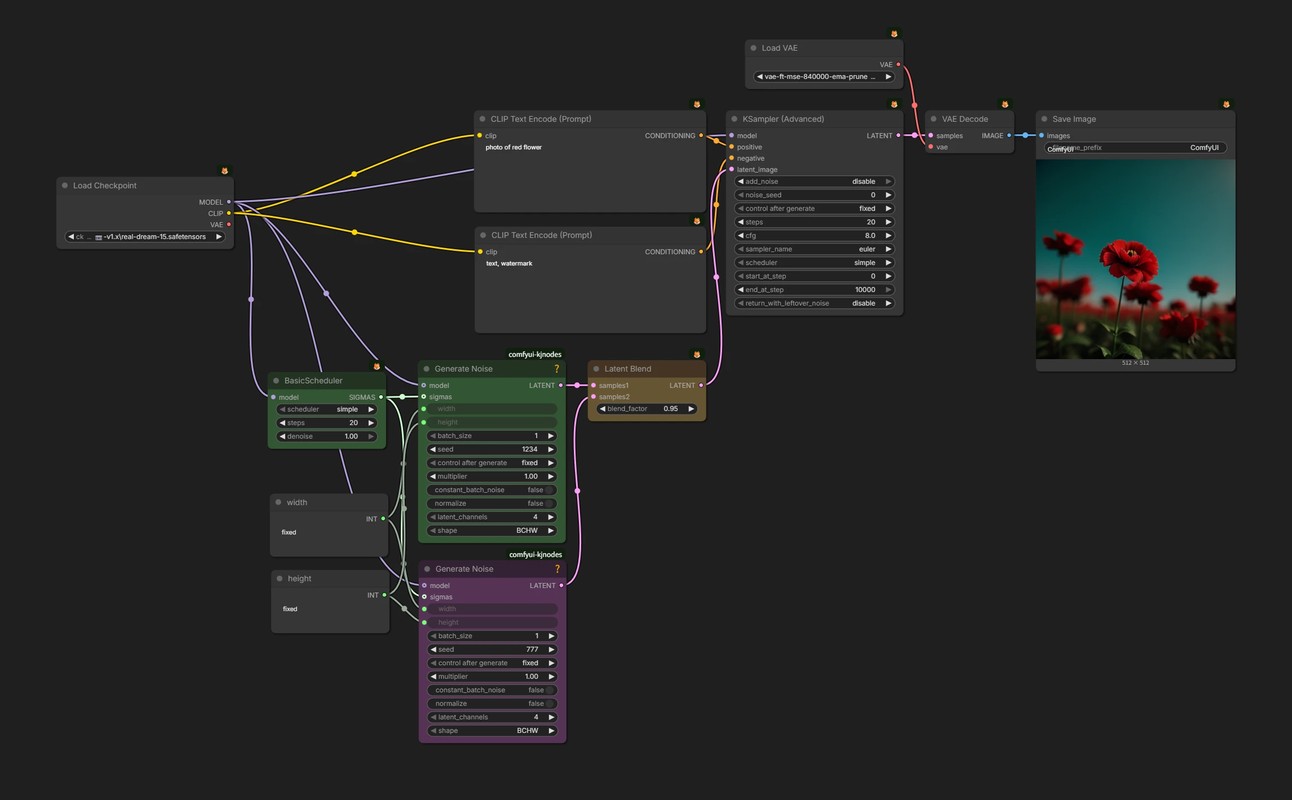
- 🟩 通过
Generate Noise+KSampler (Advanced)(add_noise=disable)这个组合,可以在采样器外部生成噪声。 - 🟪 这里的
Generate Noise用于生成要混入的第二份噪声(latent)。 - 🟨 用
Latent Blend节点把两个 latent 混合。blend_factor=1.0时只保留 samples1,blend_factor=0.0时只保留 samples2。
注入噪声(injection)
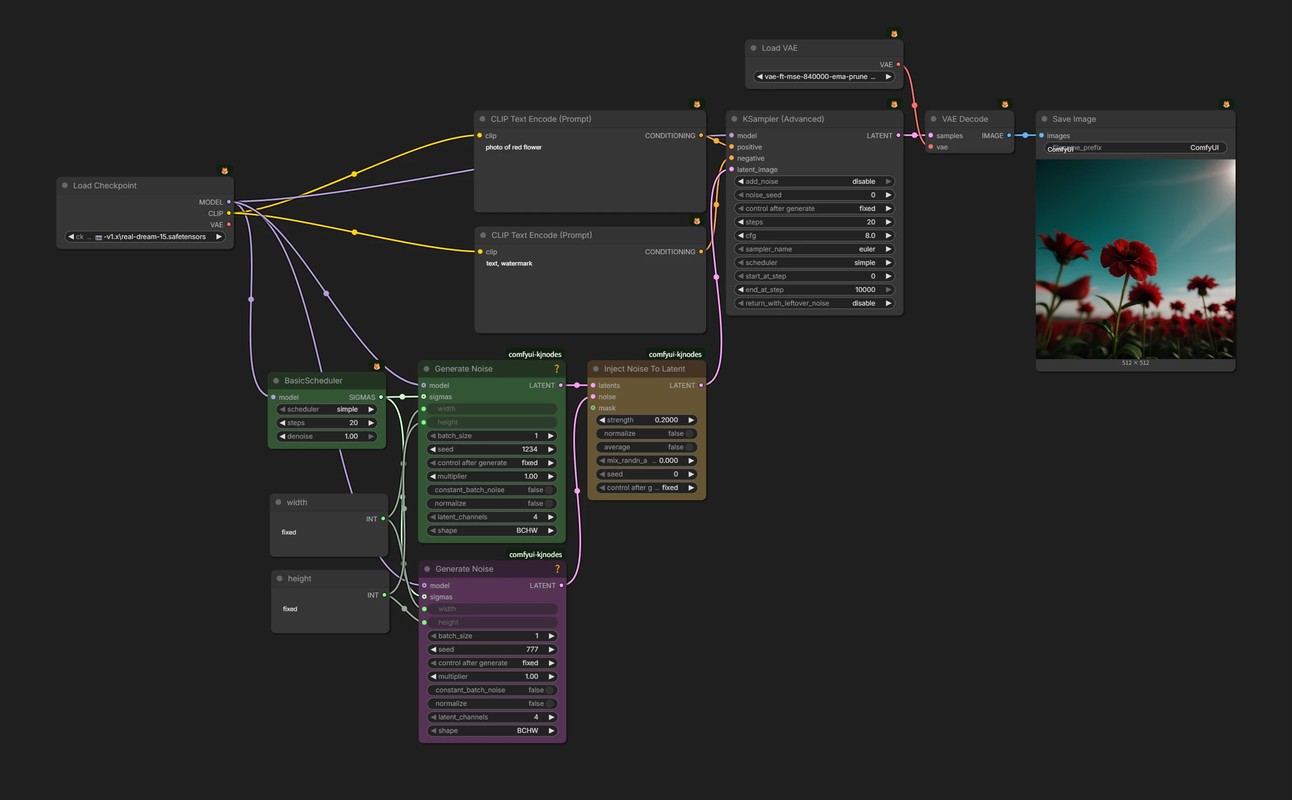
- 🟨 逐步提高
Inject Noise To Latent的strength,就能向基础 latent 里加入第二份噪声。mix_randn_amount调高会再叠加额外随机噪声,这里保持为0。