什么是 image2image?
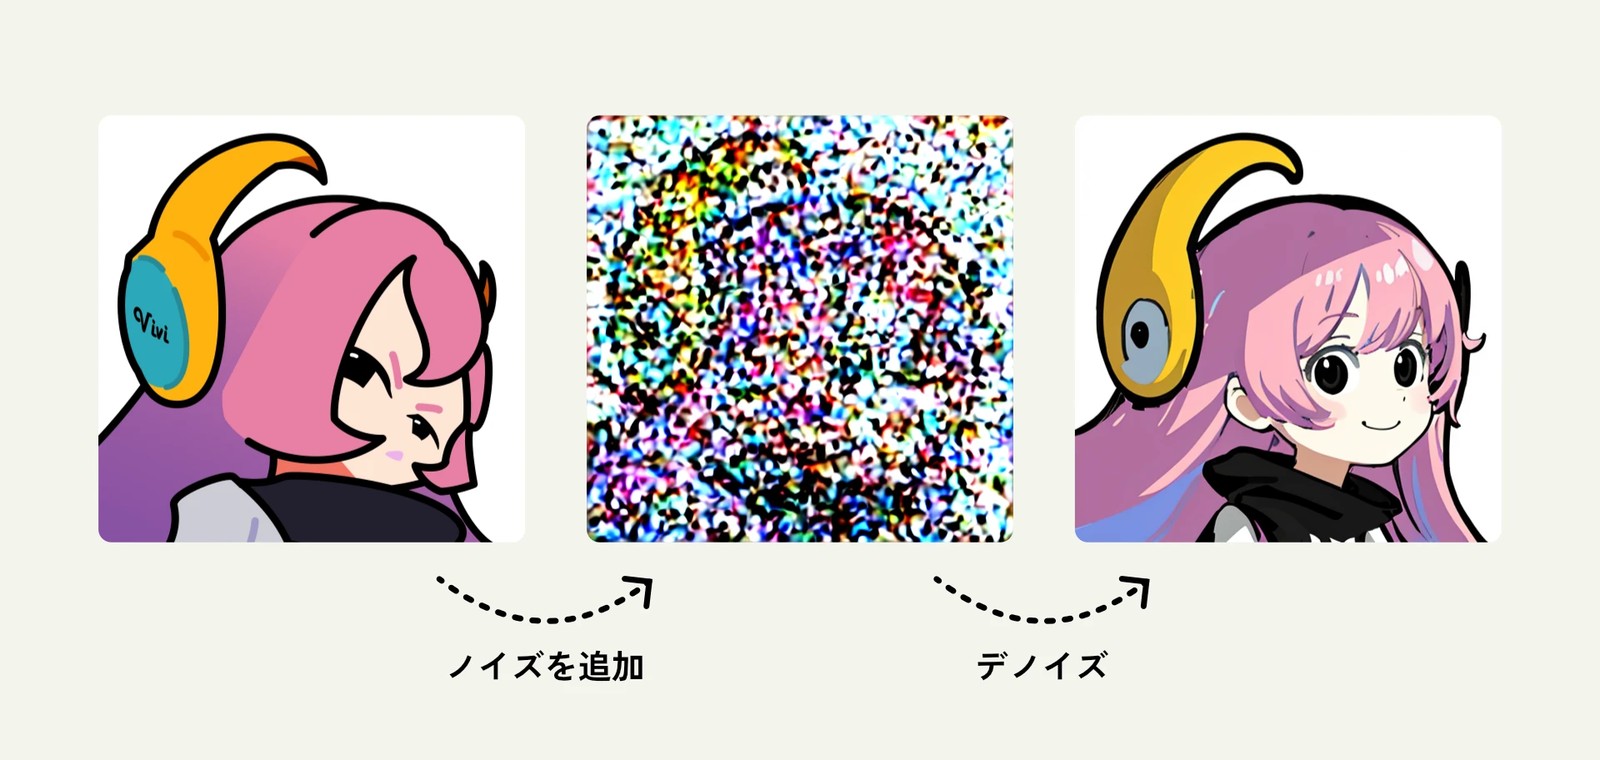
image2image 是 将参考图像作为草稿,在其上画图 的方法。
虽说是作为草稿,如果完美地描图了那就只是复印。没有任何独创性。
因此,在添加能知道原图程度的噪声后,通过去除噪声,适度保留原图的构图和氛围,让它画出符合提示词的别版本的画吧。
image2image 的机制
在这里再次复习一下扩散模型和 Sampling。
在 ComfyUI 中,KSampler 首先用噪声填满“空的 latent”,通过从中一点点去除噪声来生成图像。
在 image2image 中,将这个“空的 latent”替换为 编码了参考图像的 latent。然后,通过 start_at_step 调整 从哪个时间点开始增加噪声。
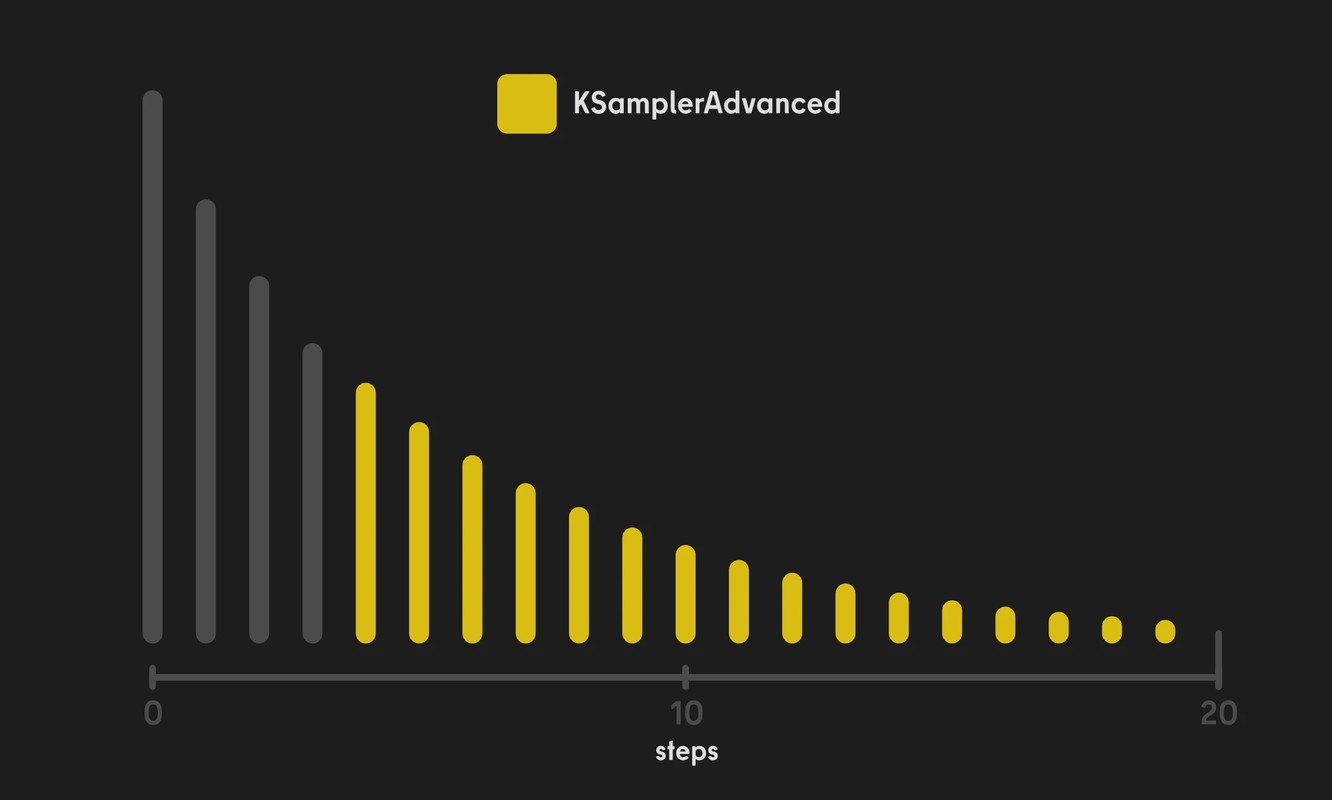
那么,让我们来看看在 steps: 20 的 KSampler (Advanced) 中改变 start_at_step 时的样子。
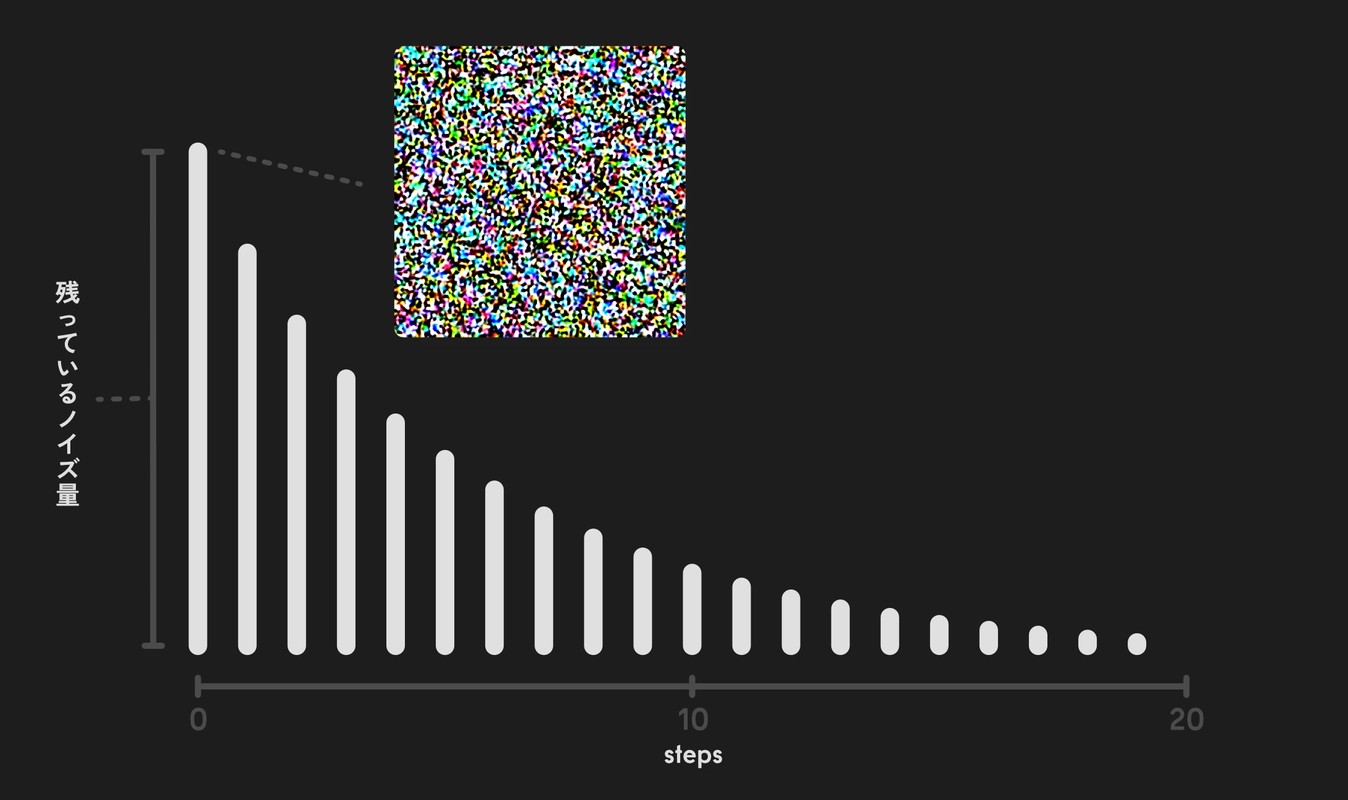
start_at_step: 0
- 从一开始就被噪声填满。
- 完全看不见草稿图像。几乎和通常的 text2image 一样。
-
※仅限 Stable Diffusion 1.5 举动稍微有点不同。
→ denoise 1.0 时的 image2image 和 text2image
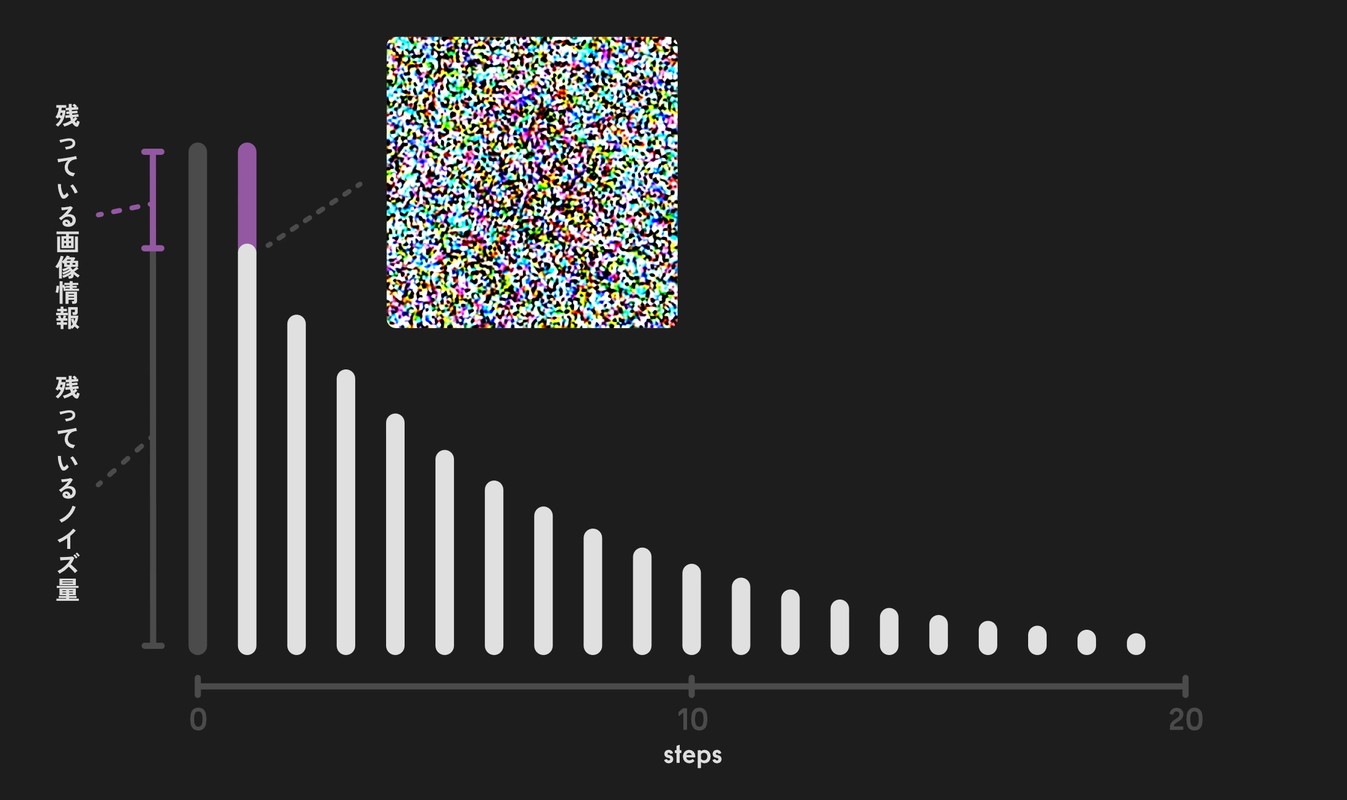
start_at_step: 1
- 从前进了 1 step 的位置开始。
- 因此,添加到草稿的噪声量(=接下来要去除的噪声量)稍微减少。
- 虽说如此,还几乎看不见草稿图像。
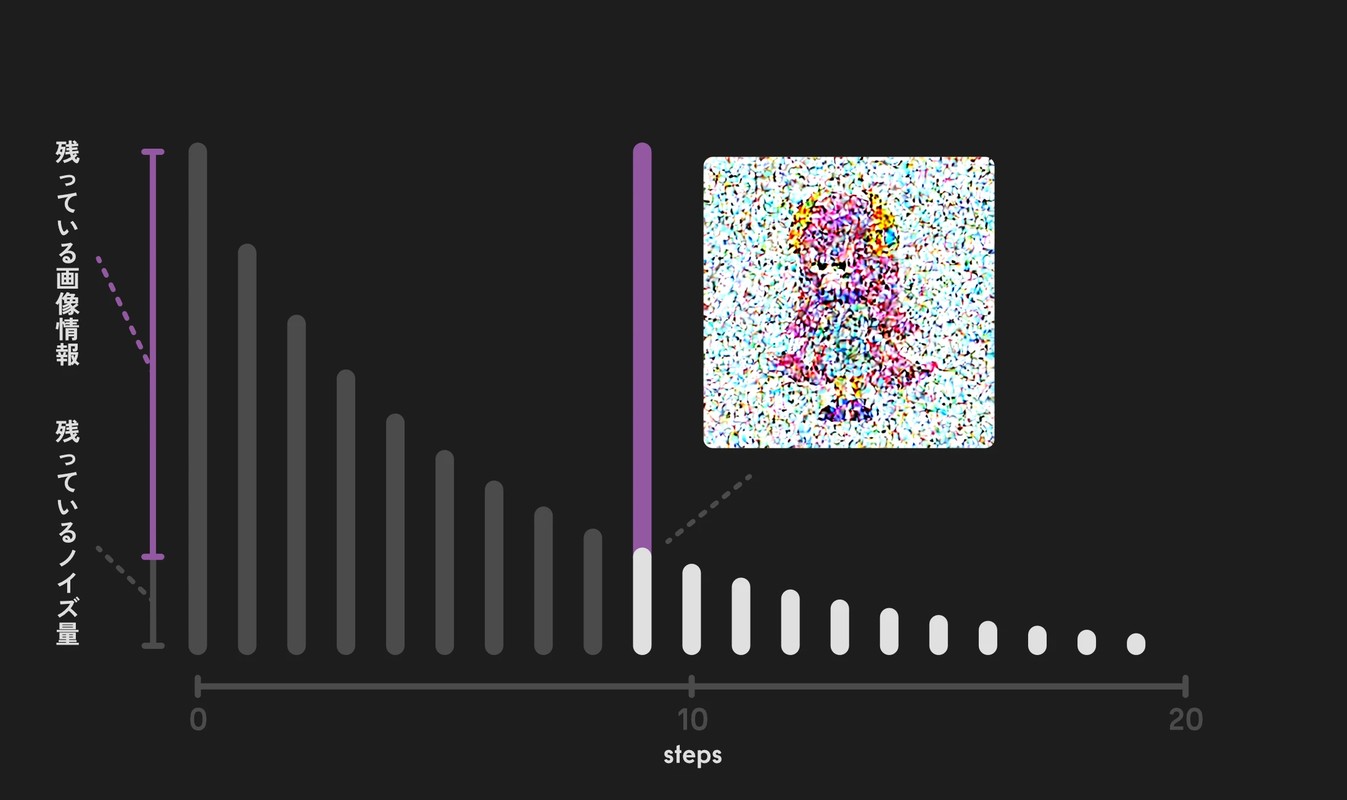
start_at_step: 9
- 添加到草稿的噪声量(=接下来要去除的噪声量)相当减少。
- 草稿的轮廓和构图,残留到了能直接明白的程度
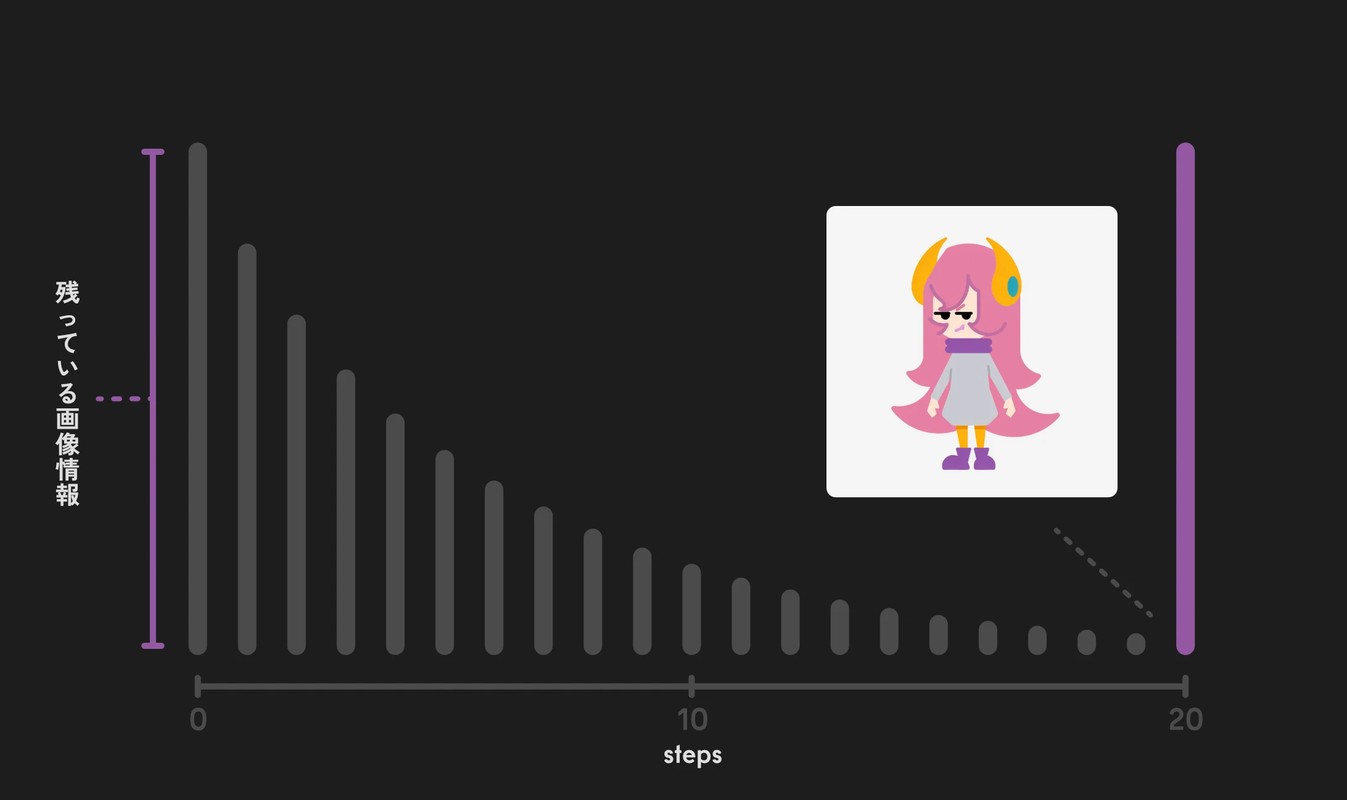
start_at_step: 20
- 既然指定在 20 步中的最后一步开始,实质上和“什么都不做”一样。
- 也就是说,实际上一切采样都不进行,也不添加噪声。
- 因此,输入的图像被原样输出。
像这样,将 start_at_step 设定在 1 ~ (steps - 1) 的某处,就变成了保留原画的同时进行采样的状态。
把这称为 image2image。
KSampler (Advanced) 的工作流
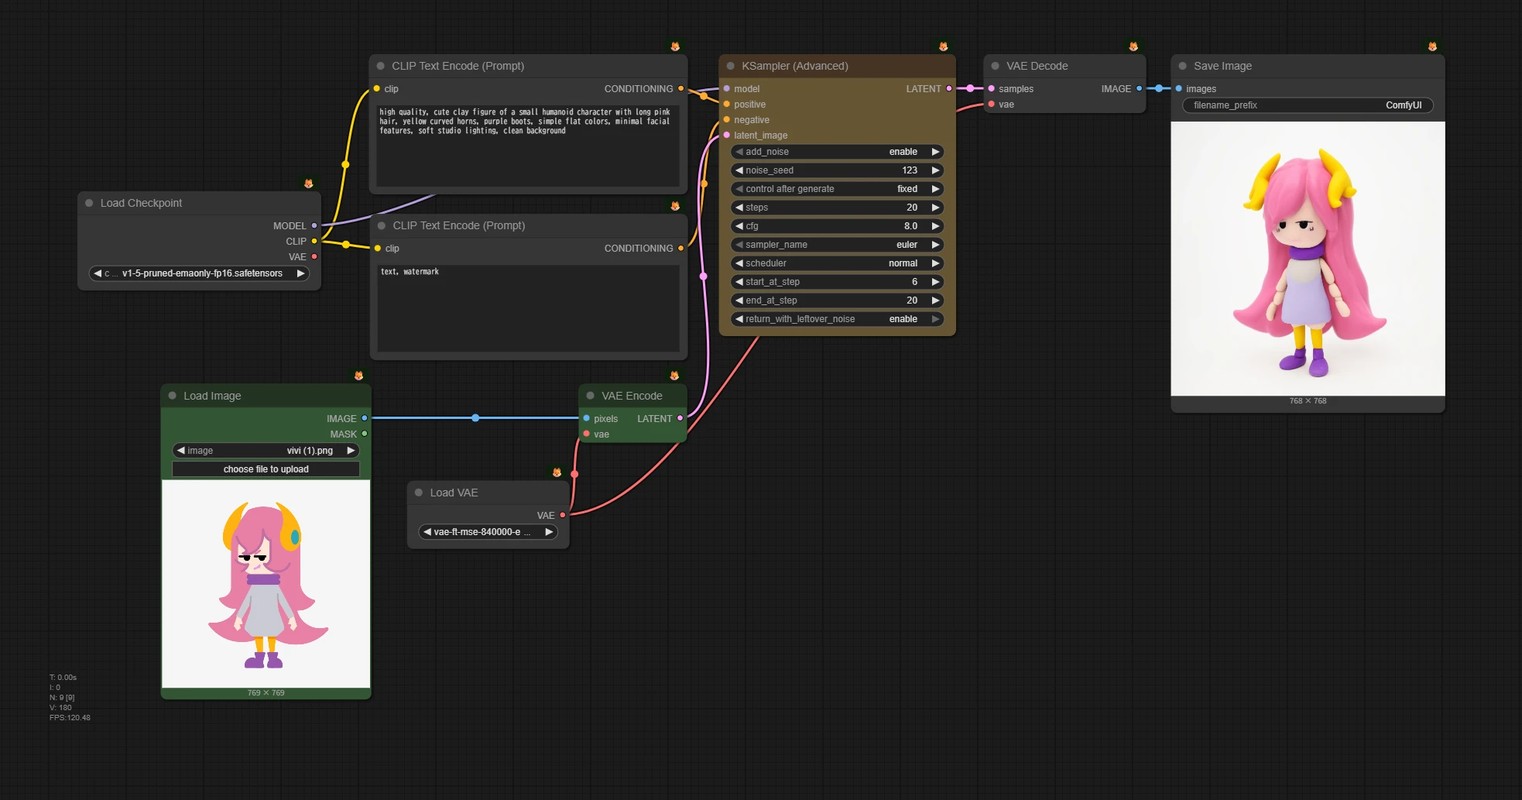
- 🟩 在 VAE Encode 节点,将图像转换为 latent。
- 🟨 更改
start_at_step的值,尝试各种保留多少原图。
KSampler 的工作流
用无印 KSampler,当然也可以做 image2image。
但是,“用哪个旋钮决定原图的残留情况”,和 KSampler (Advanced) 相当不同。
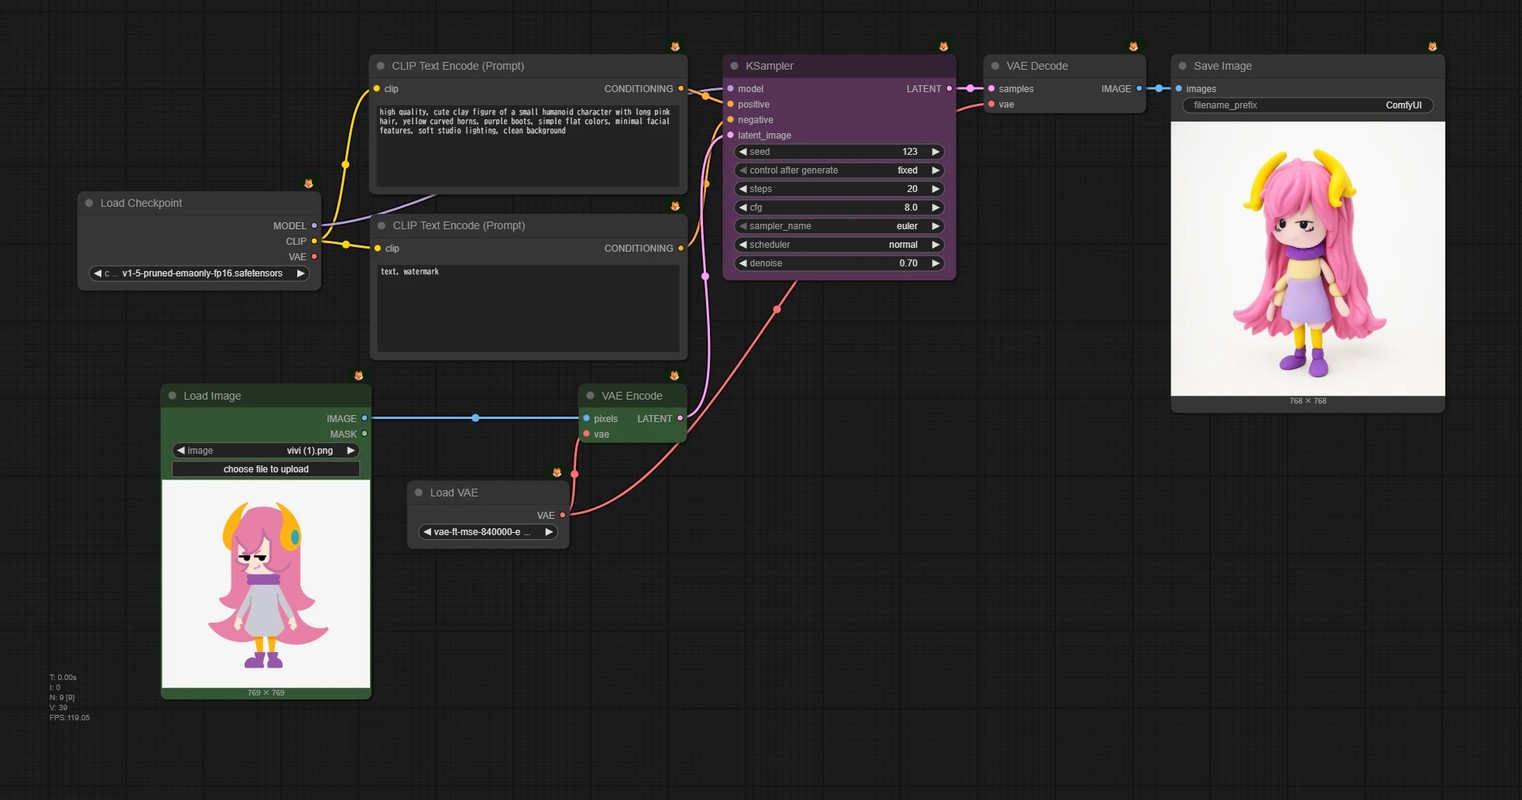
- 🟪 更改
denoise的值,设定保留多少原图。1.0在完全用噪声填满。也就是说和 text2image 一样。0.0则完全不添加噪声,所以原图被原样输出。
无印和 Advanced 的区别
在这里,试着和 KSampler (Advanced) 对比一下。
想做的事情本身是一样的,两者都是调整 “给原图添加多少噪声后,去除多少”。
只是,因为旋钮的分配方法不同,稍微有点混乱。让我们来看看在似乎会变成相同结果的设置下各自的举动。
KSampler (Advanced)
- 例如设为
steps: 20,start_at_step: 4的话,
只执行“全部 20 步中的第 4 步到第 20 步”。 - 实际采样的次数是 20 - 4 = 16 次。
无印 KSampler
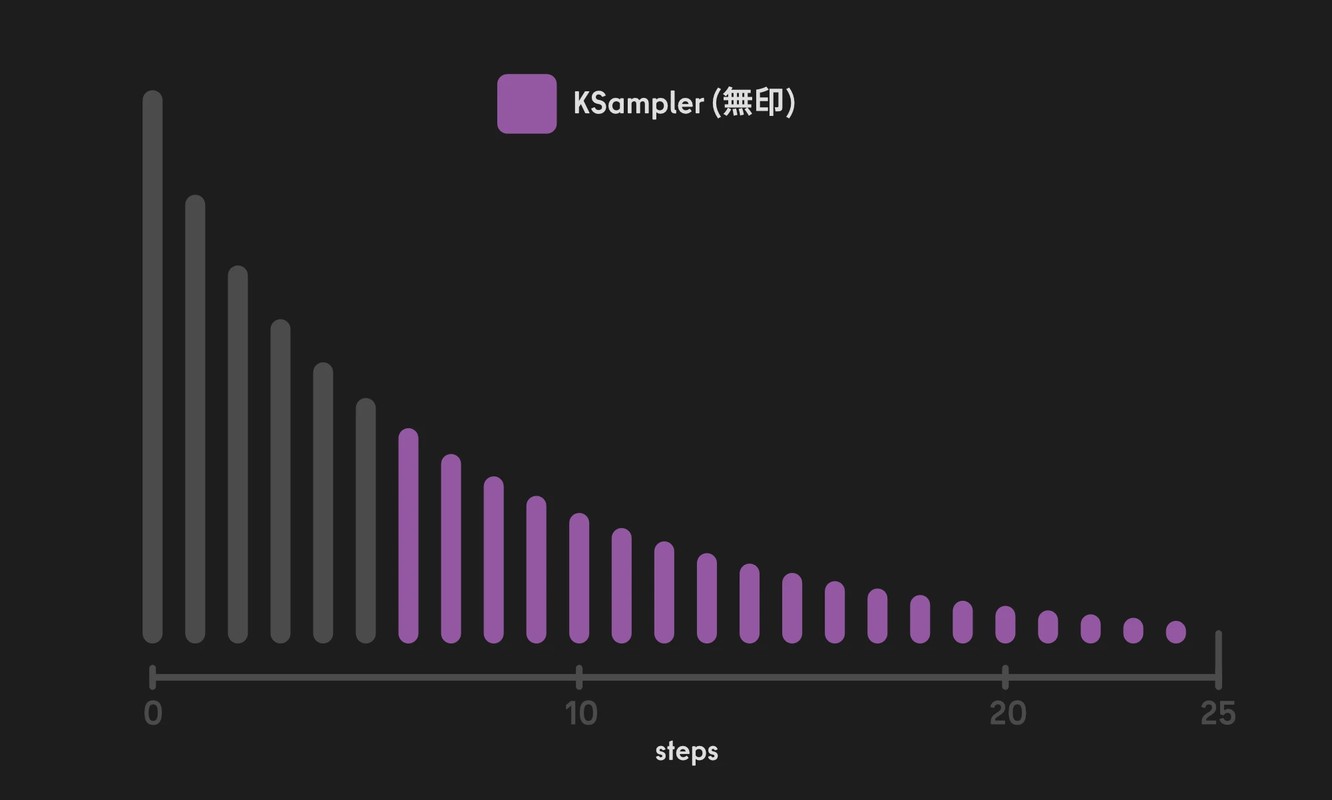
- 同样设为
steps: 20,如果设定denoise: 0.8等,外观上的“噪声施加方式”会变近,但 采样次数仍是 20 次。 - 即使把
denoise的值变为 0.5 或 0.1,也还是采样 20 次。
- Advanced
steps是“整体的步数”,只执行start_at_step以后 → 执行次数变化
- 无印
steps是“实际的执行次数”,denoise只改变噪声的强度 → 执行次数不变
如果,想在无印 KSampler 中变成 Advanced 那样“相近的噪声施加方式”的话,以下的公式大概是个标准。(不会完全一致)
设定的 step 数 ≒ 整体的 step 数 * denoise
没必要特别在意
虽然说明得这么详细,但本来两者都只是决定 “给原图加多少噪声”。
如果混合使用无印 KSampler 和 Advanced 需要注意,但没有组那种工作流的人,所以没必要在意。
只要知道更改哪个参数,原图会保留多少程度就 OK 了。
denoise 1.0 时的 image2image 和 text2image
denoise: 1.0 时,因为用噪声完全填满了原图,所以在机制上 image2image 和使用了 Empty Latent Image 节点的 text2image 应该是一样的。
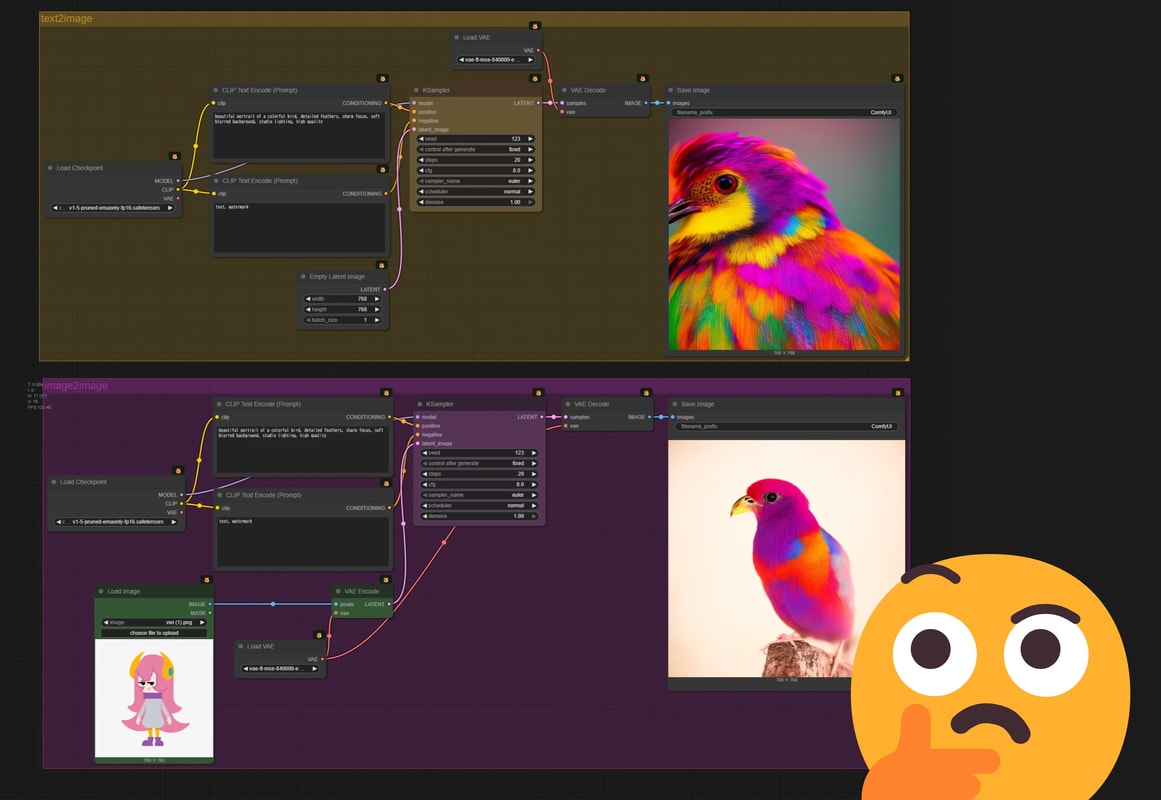
但是,Stable Diffusion 1.5 的话不会变得一样。(虽然我觉得是实现的差异,但不理解所以不知道。)
另一方面,最近的模型 (Flux 等),会变成完全一样的图像。
Stable Diffusion 1.5 作为特殊的例子,在本站,将按本来的设计 “denoise 1.0 的 image2image 和 text2image 是同样的东西” 来处理。