image2imageとは?
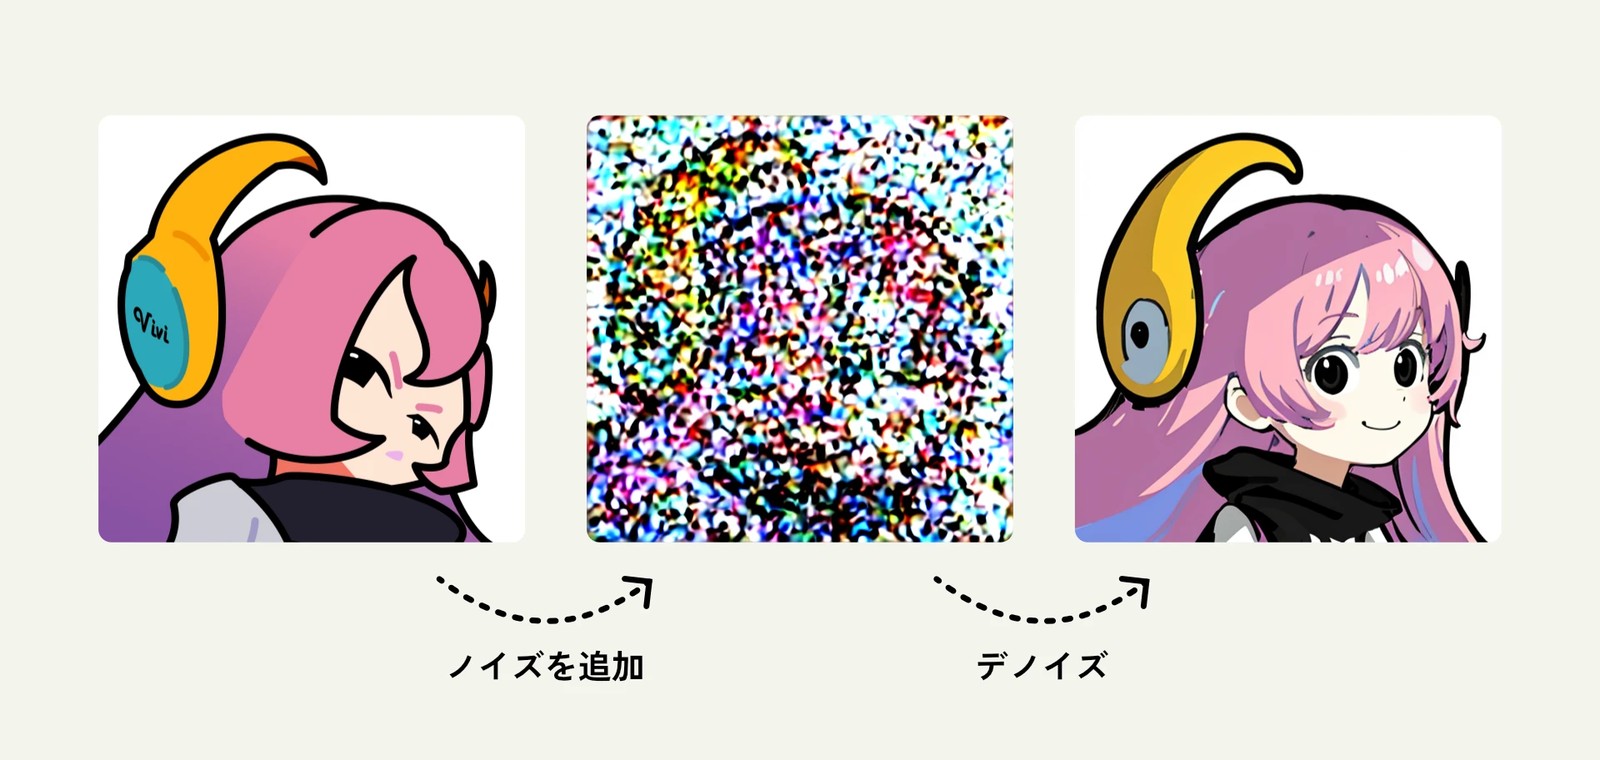
image2imageは 参考画像を下書きにして、その上から絵を描いてもらう 方法です。
下書きにするといっても、完璧にトレスしてしまったらただのコピーです。なんのオリジナリティもありません。
そこで、元の画像が分かる程度にノイズを追加してから、ノイズを除去することで、元画像の構図や雰囲気はほどよく引き継ぎつつ、プロンプトに沿った別バージョンの絵を描いてもらいましょう。
image2imageの仕組み
ここでもう一度、拡散モデルとSamplingのおさらいです。
ComfyUIでは、KSamplerがまず「空の latent」をノイズで埋め、そこから少しずつノイズを取り除くことで画像を生成していました。
image2imageでは、この「空の latent」を参照画像をエンコードした latentに置き換えます。そして、どの時点からノイズを足し始めるかを start_at_step で調整します。
では、steps: 20 の KSampler (Advanced) で start_at_step を変えてみたときの様子を見てみましょう。
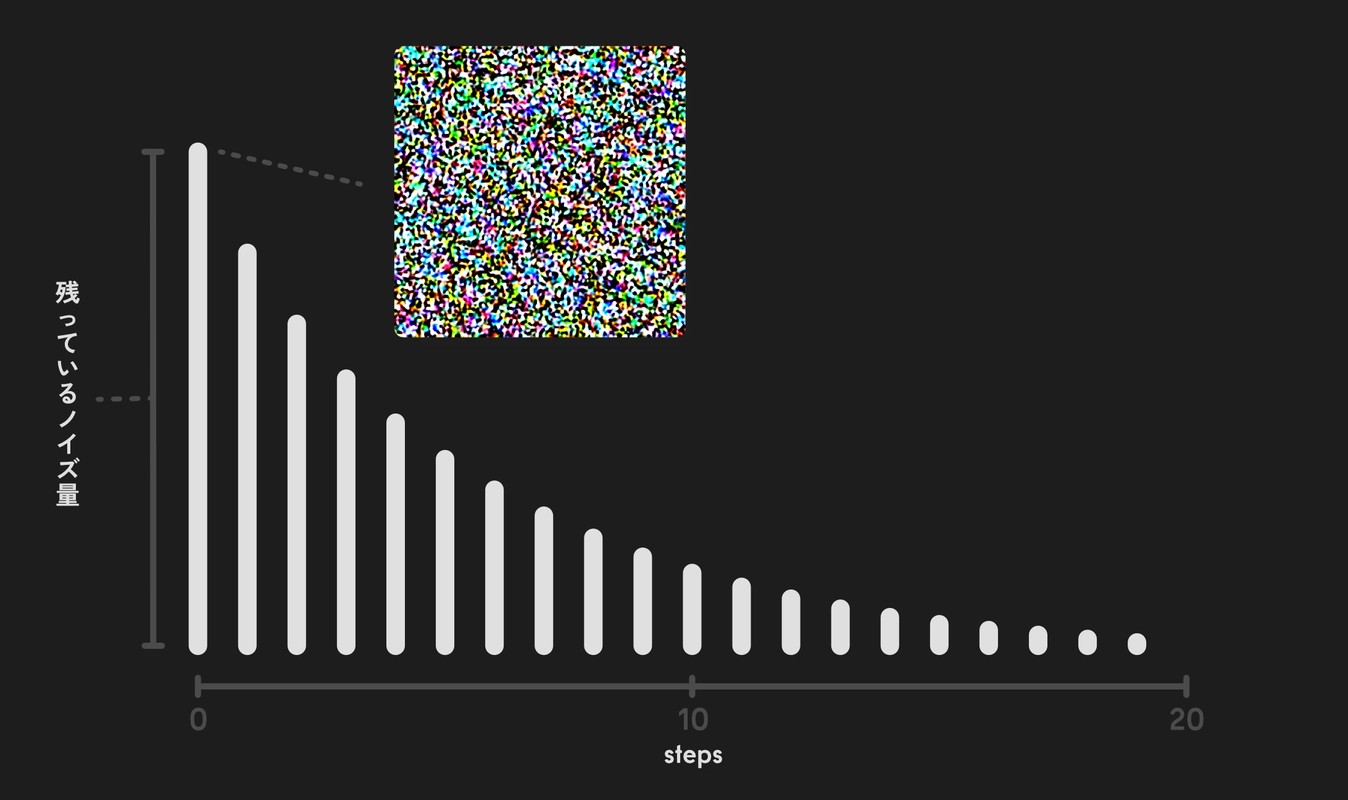
start_at_step: 0
- 最初からノイズで埋められます。
- 下書きの画像は全く見えません。ほぼ通常のtext2imageと同じです。
-
※Stable Diffusion 1.5に限り少し挙動が違います。
→ denoise 1.0のときのimage2imageとtext2image
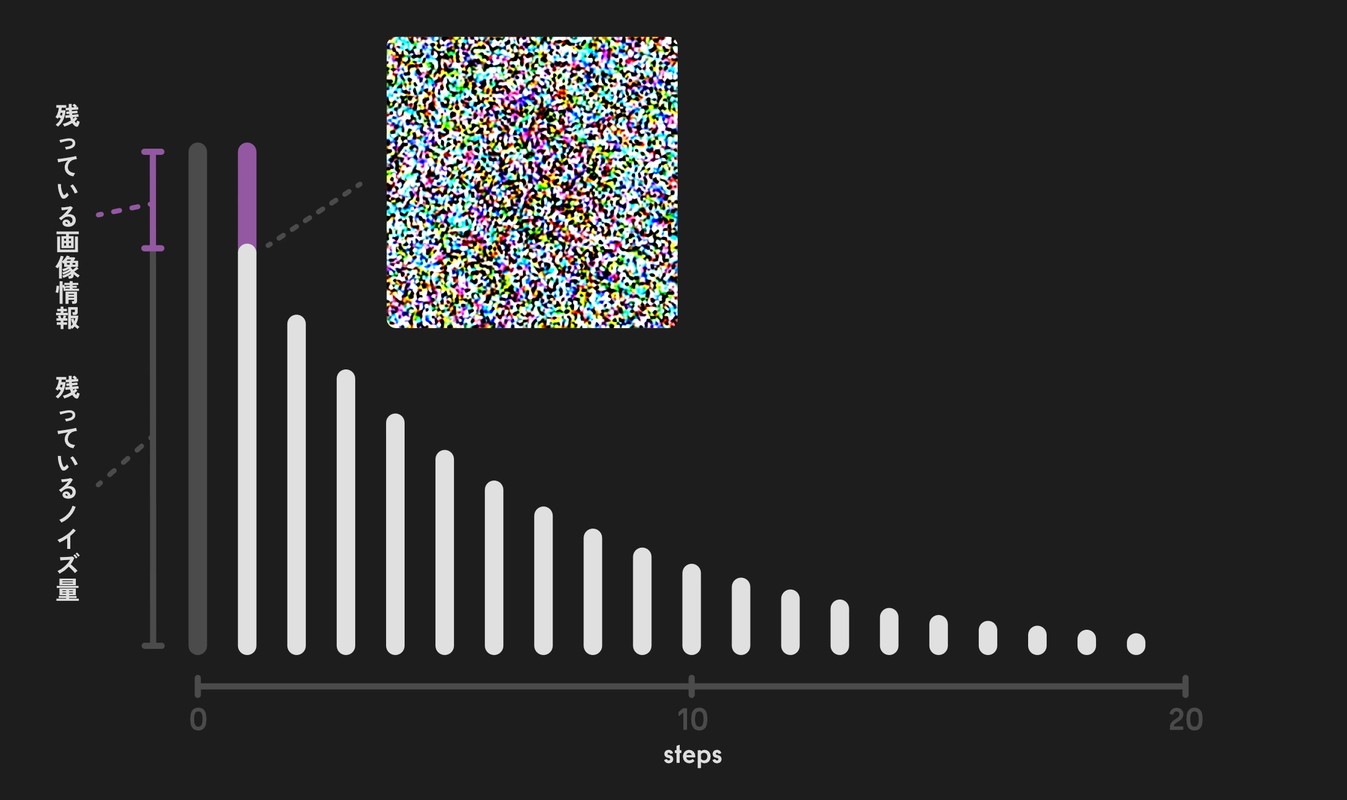
start_at_step: 1
- 1step進んだ場所からスタートします。
- そのため、下書きに追加されるノイズの量(=これから除去するノイズ量)が少し減ります。
- とはいえ、まだ下書きの画像はほとんど見えません。
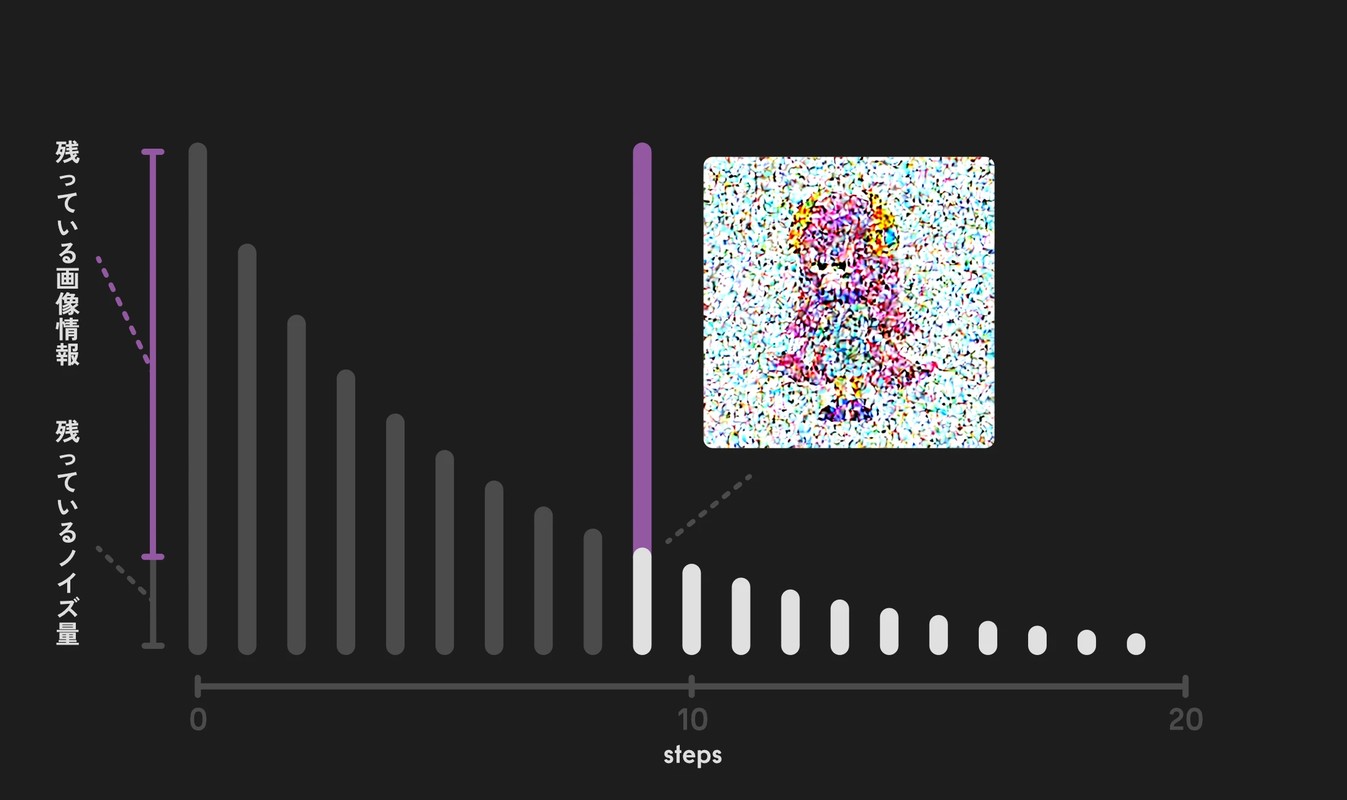
start_at_step: 9
- 下書きに追加されるノイズの量(=これから除去するノイズ量)がかなり減ります。
- 下書きの輪郭や構図が、そのまま分かる程度に残っています
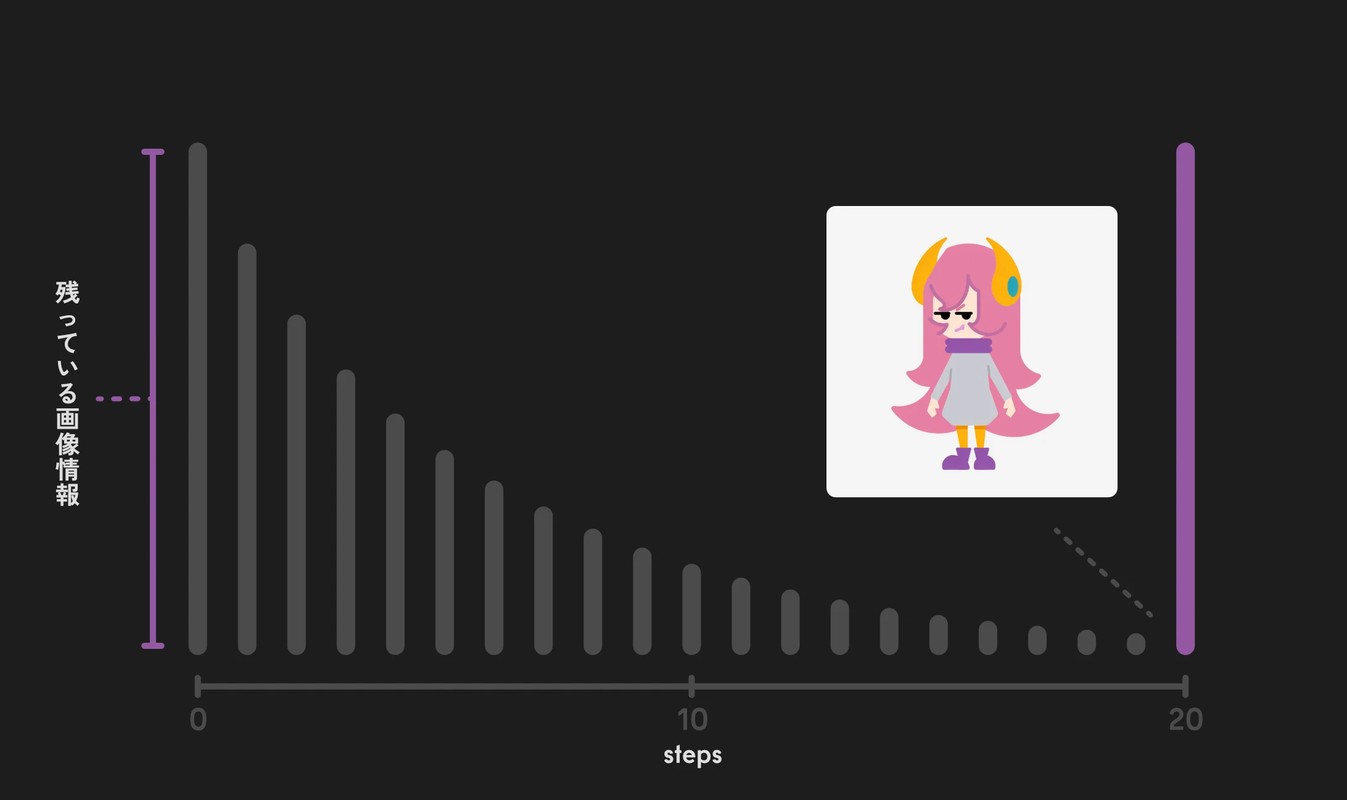
start_at_step: 20
- 20ステップあるうち、最後のステップから始める指定なので、実質「何もしない」のと同じです。
- つまり、実際には一切サンプリングせず、ノイズも追加されません。
- そのため、入力した画像がそのまま出力されます。
このように、start_at_step を 1 ~ (steps - 1) のどこかに設定すると、元の絵を残しつつサンプリングしている状態になります。
これを image2image と呼びます。
KSampler (Advanced)でのworkflow
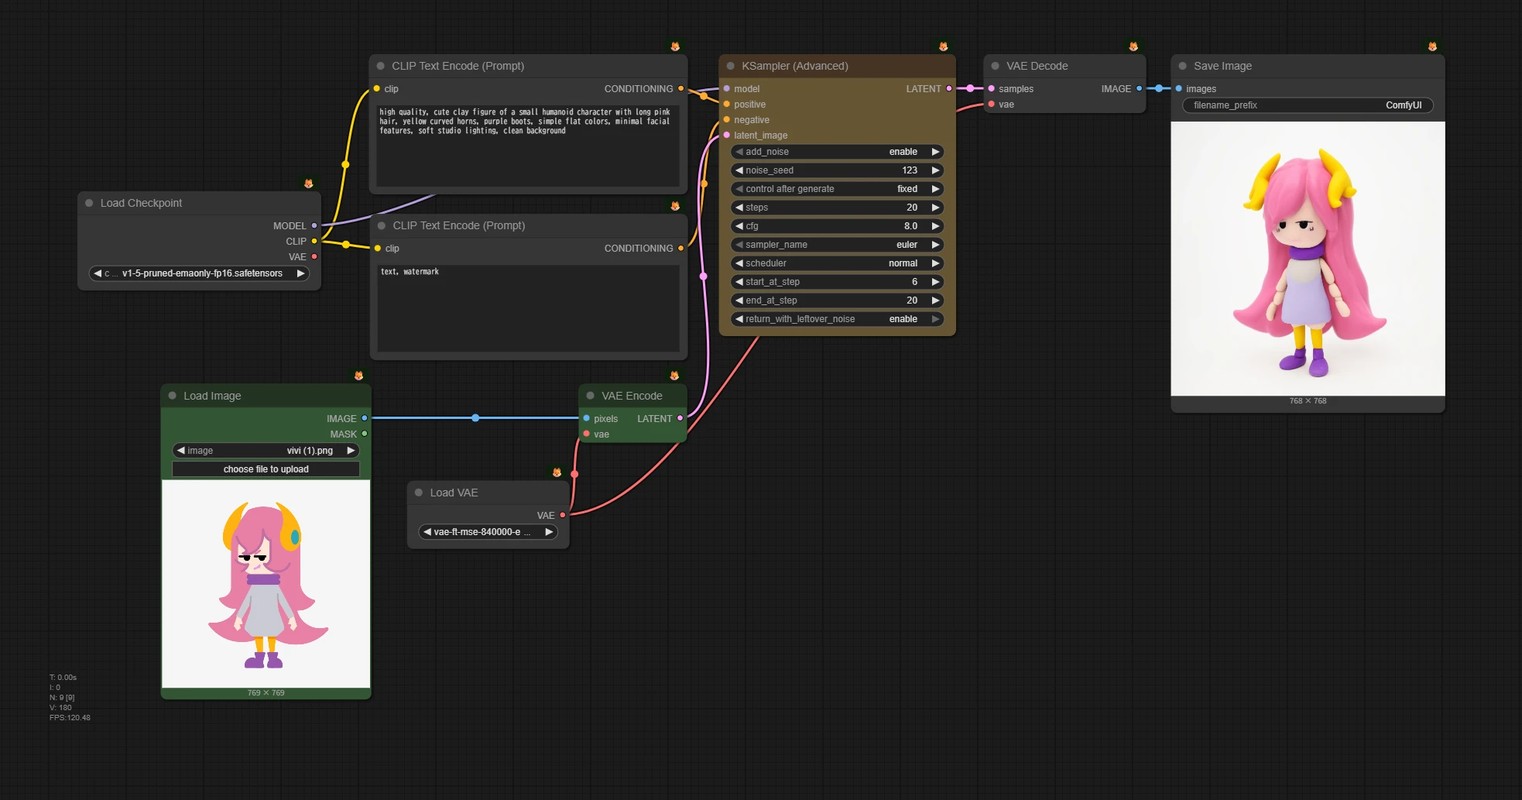
- 🟩VAE Encodeノードで、画像をlatentに変換します。
- 🟨
start_at_stepの値を変更して、元の画像をどれくらい残すか、いろいろ試してみてください。
KSamplerでのworkflow
無印 KSampler でも、もちろん image2image はできます。
ただし、「どのつまみで元画像の残り具合を決めるか」 が、KSampler (Advanced) とかなり違います。
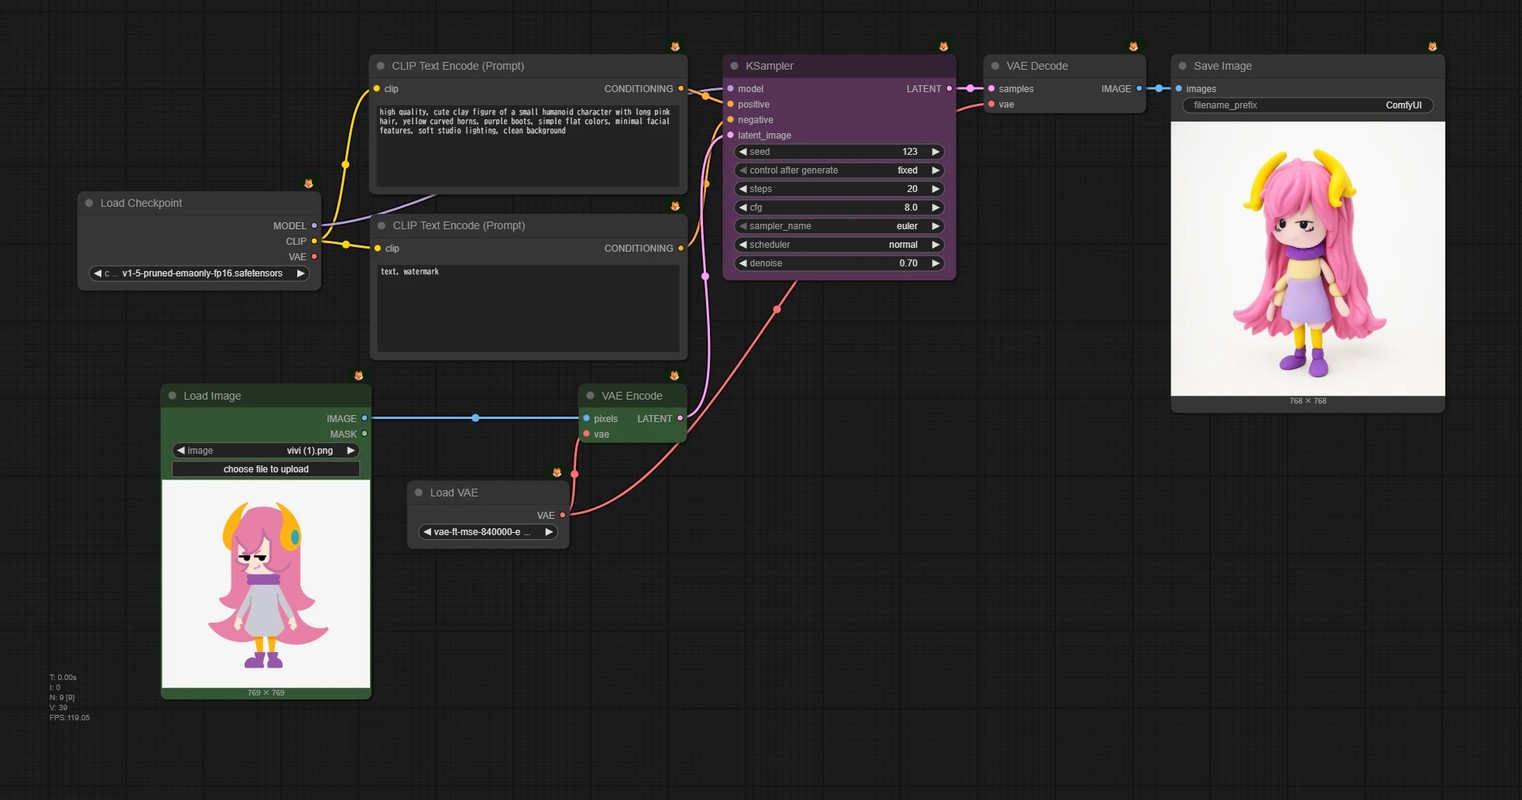
- 🟪
denoiseの値を変更して、元の画像をどれくらい残すかを設定します。1.0では完全にノイズで埋めます。つまりtext2imageと同じです。0.0ではノイズを一切追加しないので、元の画像がそのまま出力されます。
無印と Advanced の違い
ここで、KSampler (Advanced) と見比べてみます。
やりたいこと自体は同じで、どちらも 「元画像にどれくらいノイズを足してから、どれくらい除去するか」 を調整しています。
ただ、つまみの割り当て方が違うため少し混乱します。同じ結果になりそうな設定でそれぞれの挙動を見てみましょう。
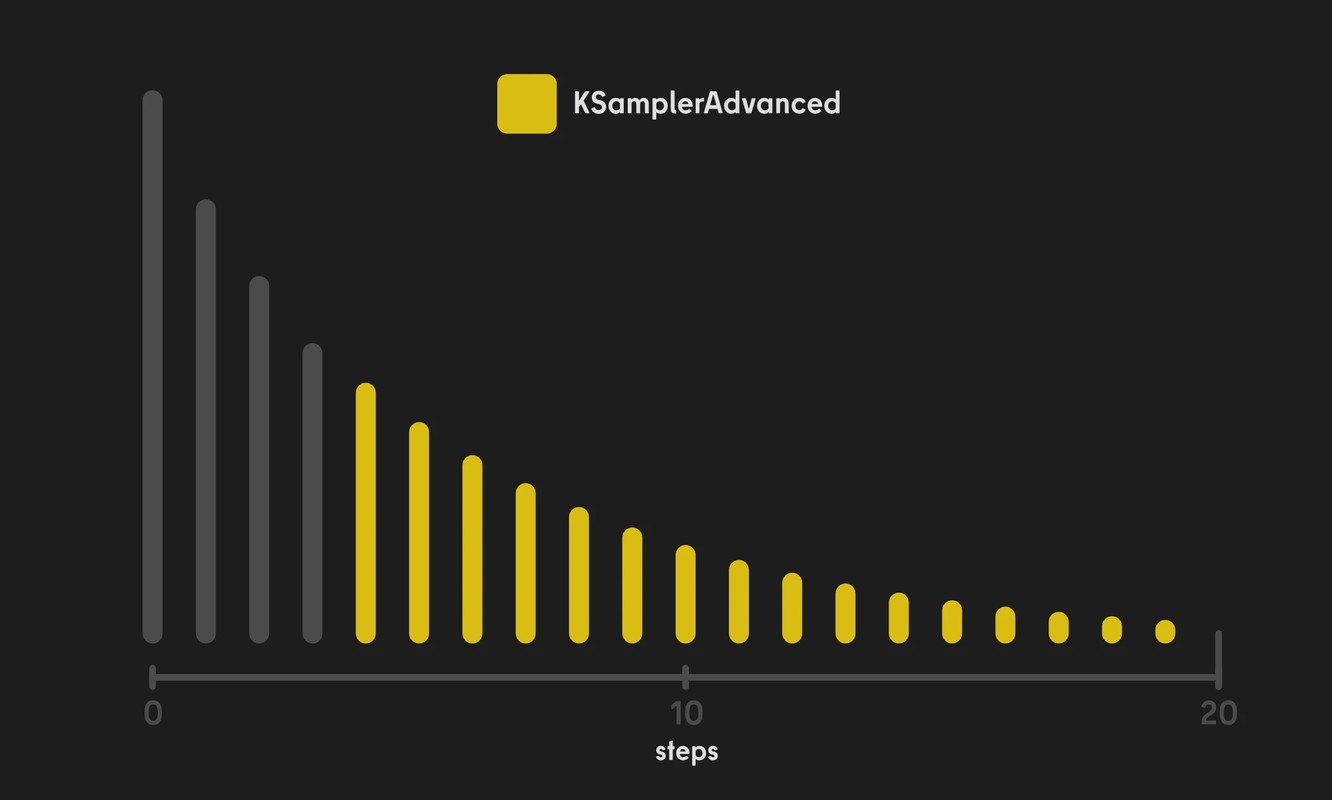
KSampler (Advanced)
- 例えば
steps: 20,start_at_step: 4とすると、
「全体 20 ステップのうち、4 ステップ目から 20 ステップ目まで」だけを実行します。 - 実際にサンプリングされる回数は 20 - 4 = 16 回 です。
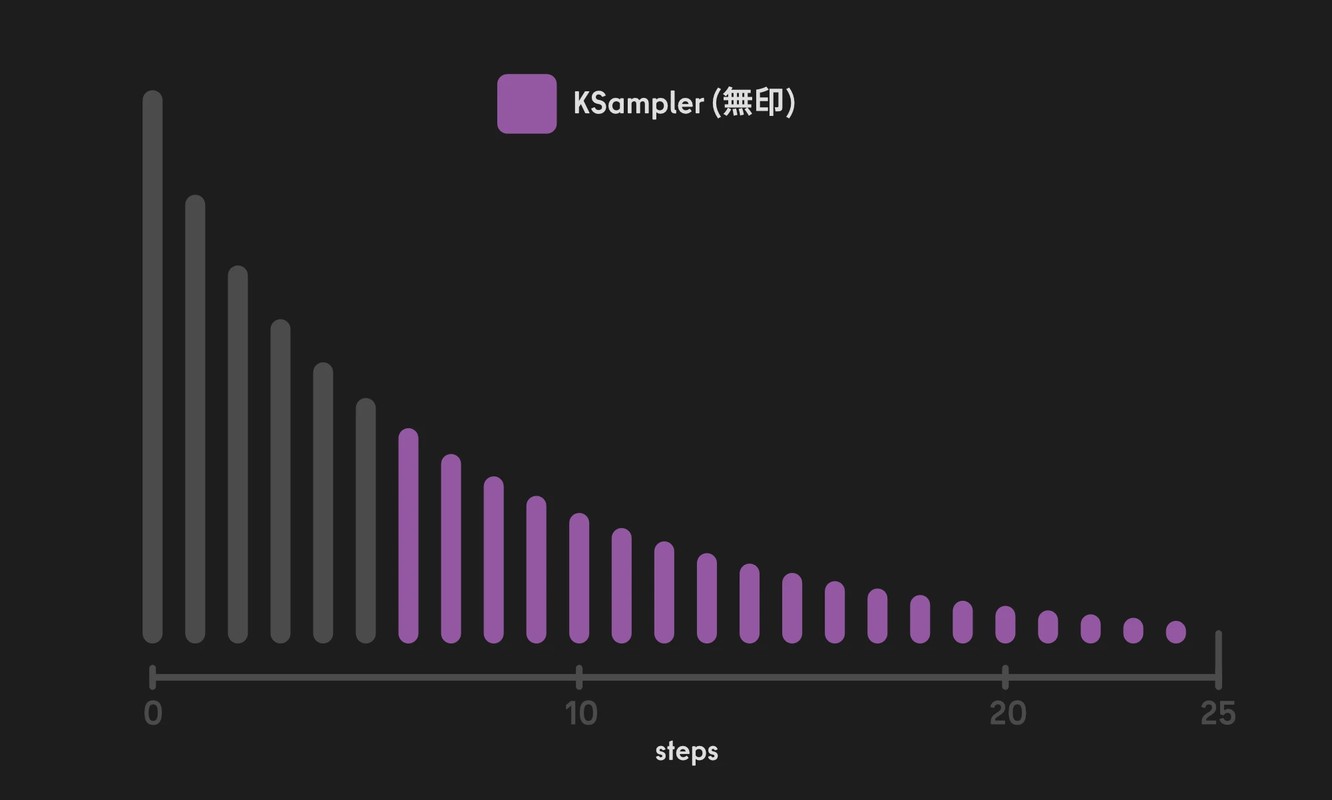
無印 KSampler
- 同じく
steps: 20にして、denoise: 0.8などと設定すると、見た目の「ノイズのかかり方」は近くなりますが、サンプリング回数は 20 回のまま です。 denoiseの値を 0.5 に変えても 0.1 に変えても、やはり 20 回サンプリングします。
- Advanced
stepsは「全体のステップ数」、start_at_step以降だけ実行 → 実行回数が変わる
- 無印
stepsは「実際の実行回数」、denoiseはノイズの強さだけを変える → 実行回数は変わらない
もし、無印KSamplerで Advanced に「近いノイズのかかり方」にしたい場合、以下の式がざっくりした目安になります。(完全に一致はしません)
設定するstep数 ≒ 全体のstep数 * denoise
別に気にしなくていい
ここまでしっかり説明しておいてなんですが、どちらも 「元画像にどれくらいノイズを足すか」 を決めているだけです。
無印KSamplerとAdvancedを混在させる場合は注意が必要ですが、そんなworkflowを組む人はいないので、気にする必要はありません。
どのパラメータを変更すれば、どの程度元の画像が残るかがわかっていればOKです。
denoise 1.0のときのimage2imageとtext2image
denoise: 1.0の時、元の画像をノイズで完全に埋めてしまうので、仕組み的にはimage2imageもEmpty Latent Imageノードを使ったtext2imageも同じになるはずです。
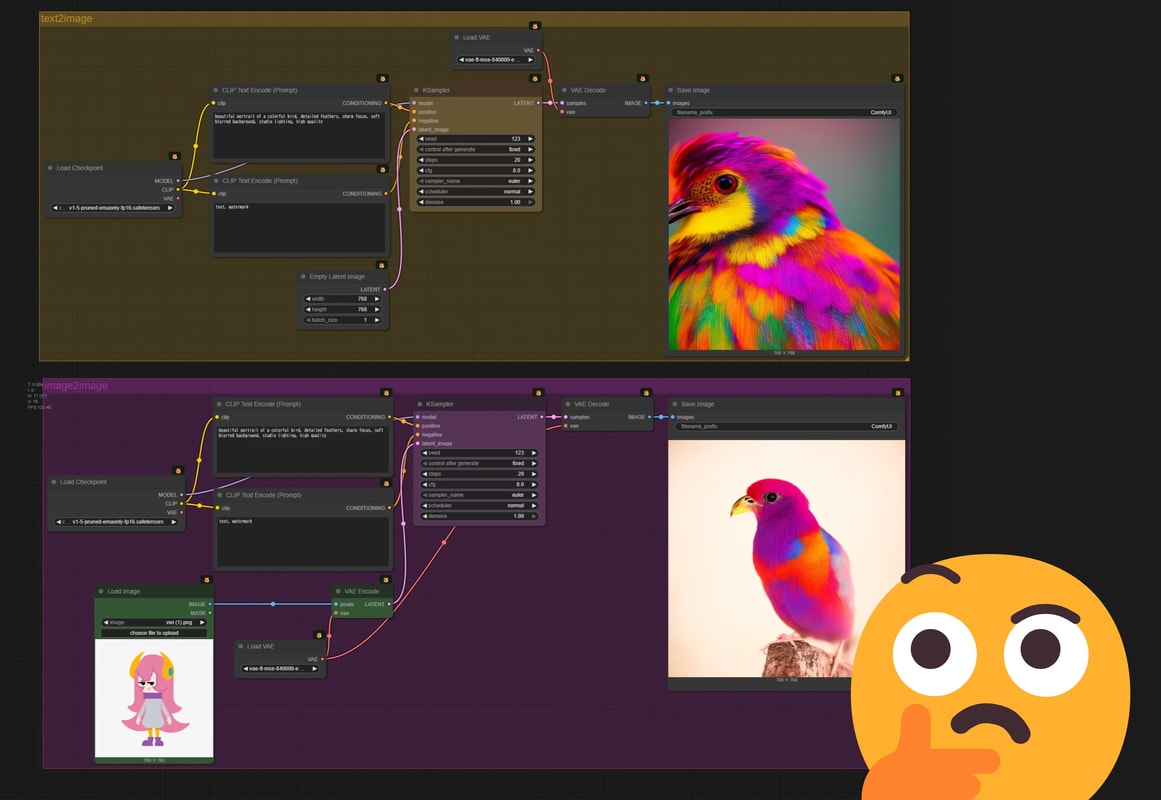
が、Stable Diffusion 1.5だと同じになりません。(実装の違いだと思いますが、理解していないのでわかりません。)
一方で、最近のモデル(Flux等)では、全く同じ画像になります。
Stable Diffusion 1.5は特殊な例として、このサイトでは、本来の設計どおり 「denoise 1.0 の image2image と text2image は同じもの」 として扱っていきます。