Ideogram 4.0とは?
Ideogram 4.0 は、9.3B の DiT 系モデルです。
最大の特徴は、JSON 形式のキャプションを使うことで、画像内の要素をかなり細かく指定できる点です。
似たようなアプローチで FIBO というモデルがありましたが、Ideogram 4.0 は BBOX による座標指定や色指定に強く、ポスター、ロゴ、UI、パッケージのような、DTP 寄りのデザインタスクに向いています。
コントロール性能と引き換えに、既定の形式でプロンプトを書かなければ本来の性能が出ないので、手軽なモデルではないかもしれませんね。
モデルのダウンロード
- diffusion_models
- ideogram4_fp8_scaled.safetensors (9.28 GB)
- ideogram4_nvfp4_mixed.safetensors (5.49 GB)
- ideogram4_unconditional_fp8_scaled.safetensors (9.28 GB)
- ideogram4_unconditional_nvfp4_mixed.safetensors (5.49 GB)
- text_encoders
- qwen3vl_8b_fp8_scaled.safetensors (10.6 GB)
- vae
- flux2-vae.safetensors (336 MB)
📂ComfyUI/
└── 📂models/
    ├── 📂diffusion_models/
    │   ├── ideogram4_fp8_scaled.safetensors
    │   ├── ideogram4_nvfp4_mixed.safetensors
    │   ├── ideogram4_unconditional_fp8_scaled.safetensors
    │   └── ideogram4_unconditional_nvfp4_mixed.safetensors
    ├── 📂text_encoders/
    │   └── qwen3vl_8b_fp8_scaled.safetensors
    └── 📂vae/
        └── flux2-vae.safetensors
詳細はあとで説明しますが、2 つの Diffusion model を読み込む仕組みのため、かなり重いです。
ComfyUI は内部でやりくりしてくれるので、VRAM が足りなくても、まったく生成できないわけではありませんが、非常に時間がかかります。
軽くするために nvfp4 を使う選択肢もありますが、品質は落ちます。
unconditional 側は品質への影響が少ないので、通常側は fp8、unconditional 側は nvfp4 を使うのが良いかもしれません。
プロンプト
単なる自然文でも生成はできますが、既定の JSON schema に従わないと、まともにクオリティが出ません。
基本形はこのようになっています。
{
  "high_level_description": "画像全体の1〜2文の説明。",
  "style_description": {
    "aesthetics": "雰囲気、審美性。",
    "lighting": "ライティング。",
    "medium": "illustration / photograph / graphic_design など。",
    "art_style": "非写真の場合の画風。",
    "color_palette": ["#FFFFFF", "#000000"]
  },
  "compositional_deconstruction": {
    "background": "背景・環境の説明。",
    "elements": [
      {
        "type": "obj",
        "bbox": [100, 200, 800, 700],
        "desc": "物体・人物・要素の説明。",
        "color_palette": ["#FFFFFF", "#000000"]
      },
      {
        "type": "text",
        "bbox": [820, 200, 920, 800],
        "text": "HELLO",
        "desc": "文字の見た目の説明。",
        "color_palette": ["#000000"]
      }
    ]
  }
}
全体の説明、スタイル、背景、各要素の説明、と構成自体はシンプルですが、こんなものを毎回手で書いてはいられません。
特に座標指定は面倒です。画像のどのあたりに、どの要素を置くのかを BBOX で指定する必要があるため、それを頭で想像するのはほぼ無理です。
そこで、いくつかプロンプトを作成するための方法を紹介します。
LLM に任せる
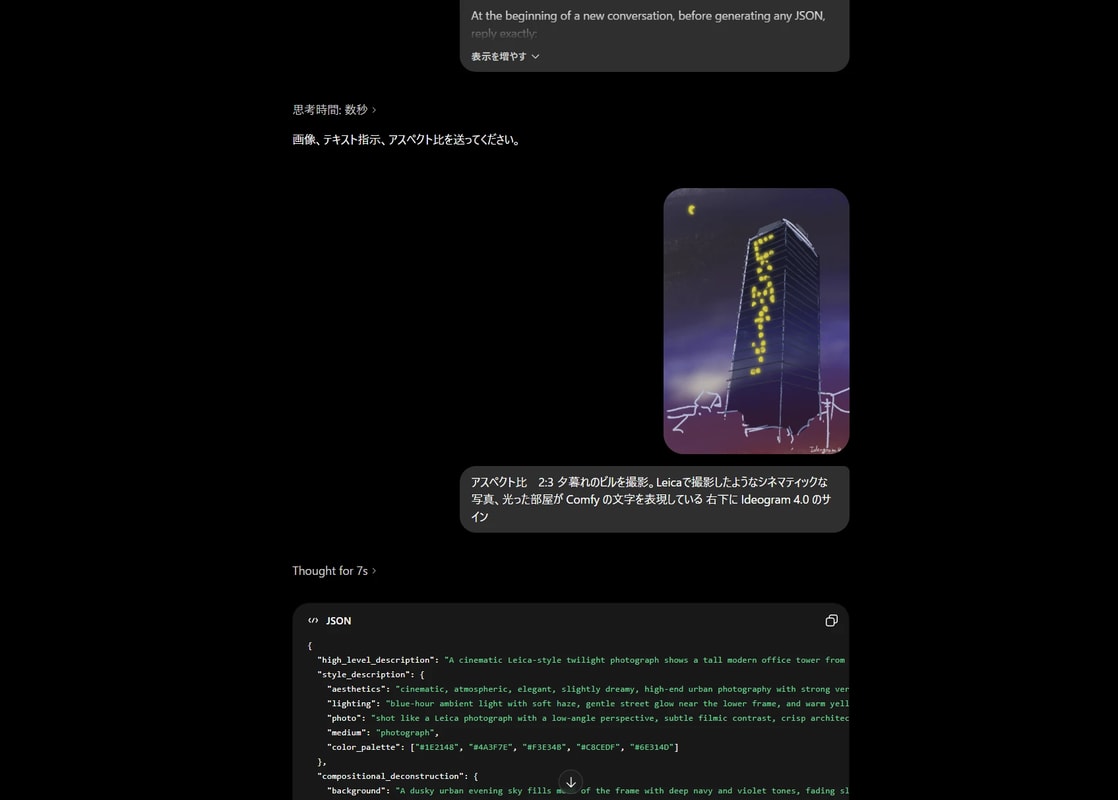
一番楽なのは、公式のプロンプトガイド と、作りたい画像の説明を LLM に渡して、JSON キャプションに変換してもらう方法です。
参考画像だったり、自分が書いたラフを渡して作ってもらってもいいですね。
ComfyUI 上で動かせるレベルのローカルモデルでは性能が足りないので、大人しく ChatGPT や Gemini などに頼った方が良いでしょう。
専用プロンプトビルダーを使う
専用のプロンプトビルダーを使って、視覚的にプロンプトを作る手もあります。
例えば ComfyUI-KJNodes の Ideogram 4 Prompt Builder KJ ノードはよく使われているものの一つです。
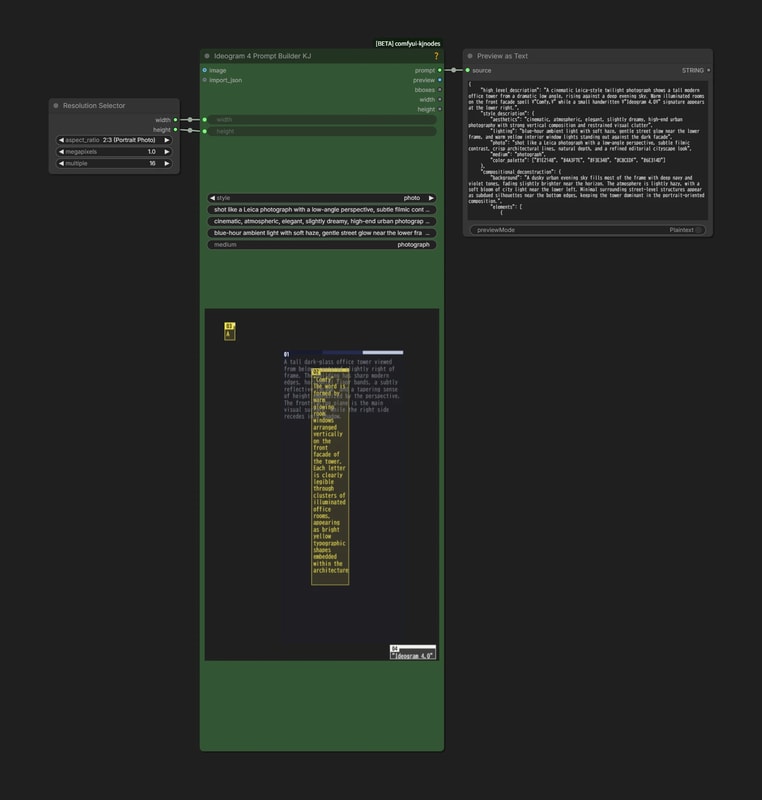
- 生成する画像のサイズを設定し、背景やスタイルといったものを入力していきます。
- region 欄でドラッグすると、BBOX を作ることができ、そこに描かせたいもののプロンプト、及びカラーコードを設定します。
text2image
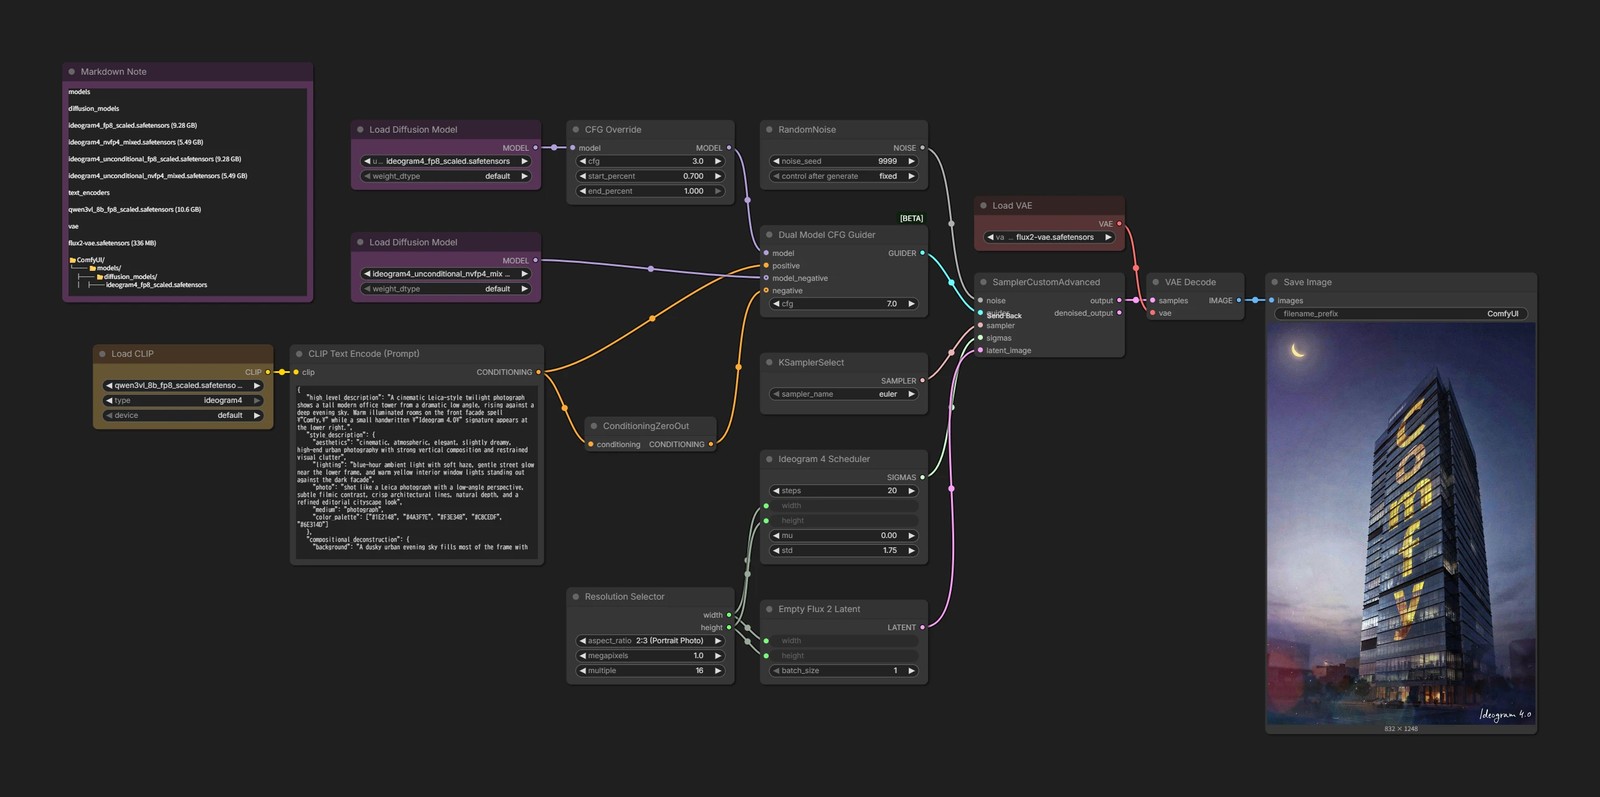
プロンプト以外にも、一般的な workflow と比べると少し特殊な部分があるので、そちらだけ見ていきましょう。
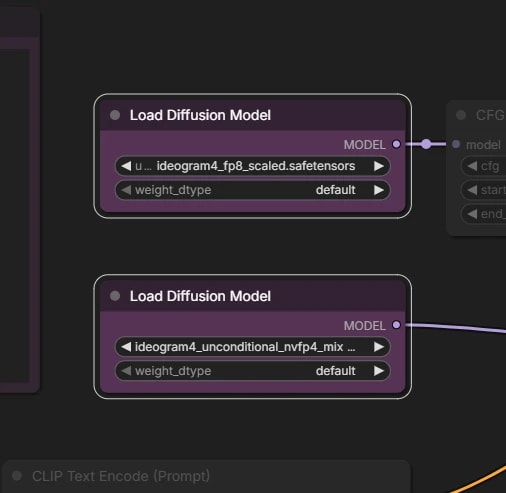
Load Diffusion Model
Ideogram 4.0 では、少し特殊な CFG のために diffusion model を 2 つ読み込みます。
- 通常の CFG では、プロンプトありの結果と、プロンプトなしの結果を比べることで、プロンプト方向へ生成を寄せます。
- 一方で Ideogram 4.0 では、unconditional 側に空プロンプトを渡すのではなく、テキスト token を使わない image-only の入力を unconditional 用モデルに通します。
- なにが違うんだという感じもしますが、より positive prompt を繊細に扱うための工夫といった感じでしょうか。
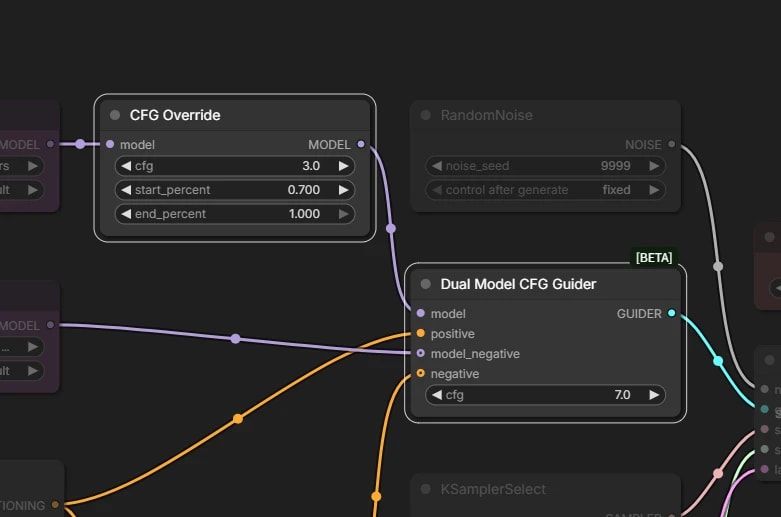
CFG
昔からある細かいテクニックですが、サンプリングの前半と後半で CFG の値を変えます。
- この workflow では、前半が CFG 7、後半は CFG 3
- 高い CFG を最初から最後までかけ続けるより、途中で弱めたほうが安定するんですね。
- そのために使用するのが
CFG Overrideノードです。 - 指定したステップ範囲だけ CFG の値を上書きします。
- この workflow では、全体の 70% 以降は cfg が 3 になります。
Ideogram 4 TurboTime LoRA
Ostris さんが公開している、2〜8 step で生成できる LoRA です。
モデルのダウンロード
- loras
- ideogram_4_turbotime_v1.safetensors (847 MB)
📂ComfyUI/
└── 📂models/
    └── 📂loras/
        └── ideogram_4_turbotime_v1.safetensors
text2image (8 step)
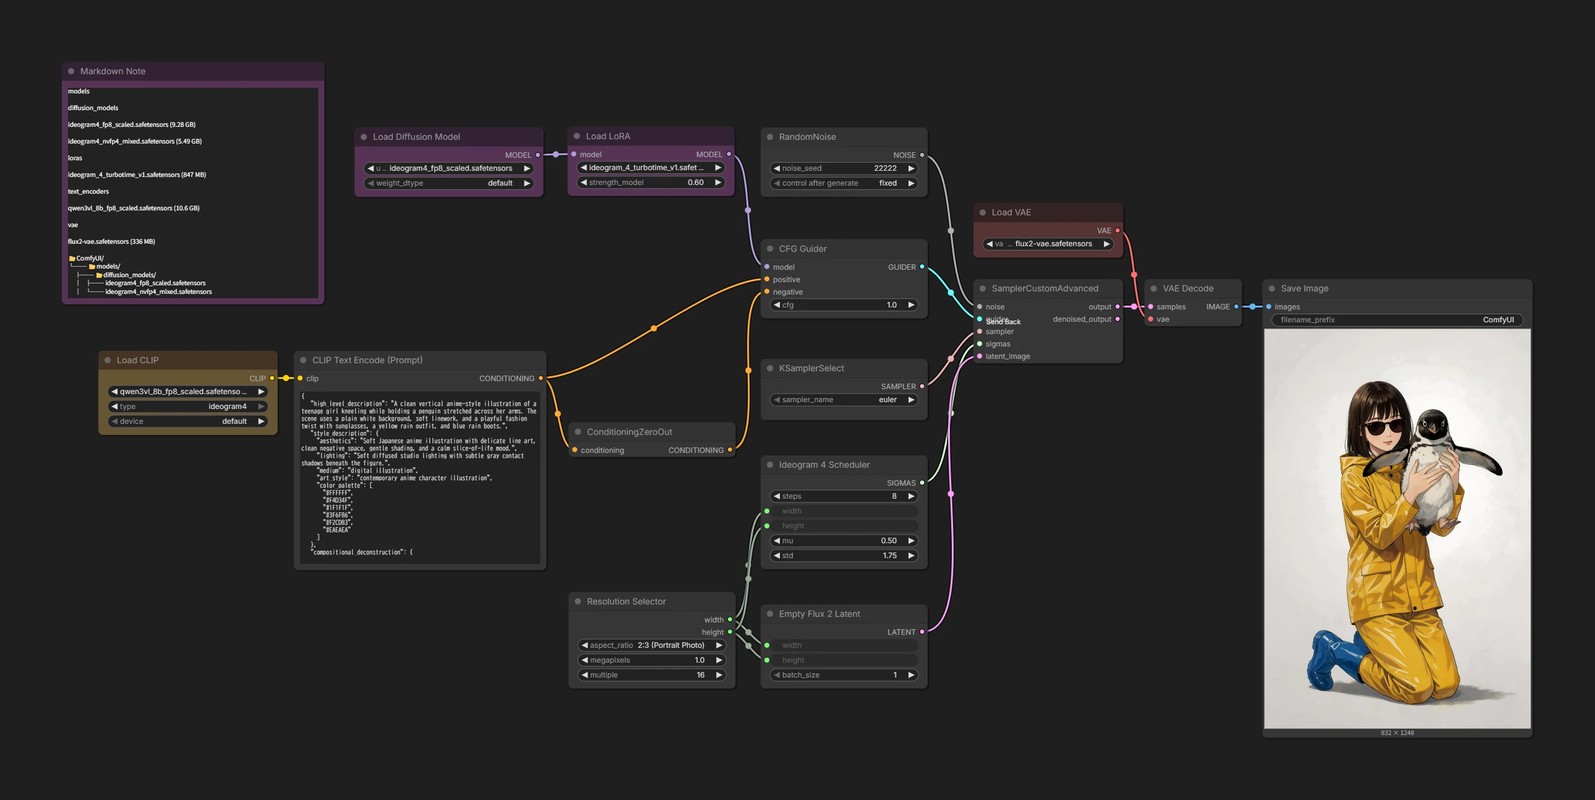
- CFG 1.0 で生成するため、unconditional model は不要になります。
- 2〜8 step 用とされていますが、step 数が少なすぎると明確に崩れ始めるので、現状は 8 step で使うのがいいでしょう。