JoyCaptionとは?
JoyCaption は、画像からキャプションを生成するためのVLM(Visual Language Model)です。
実写・アニメ・デジタルアート など、幅広いジャンルの画像を対象に高精度なキャプションを生成できます。なにより NSFW な画像でも検閲せず扱ってくれるため、より高性能な汎用MLLMが登場している現在でも、「キャプション専用モデル」として人気があります。
LLaVA系のマルチモーダルモデルをベースにしているため tagger と比べると軽量とはいえませんが、ComfyUI のノードとしてローカルの画像生成パイプラインに組み込みやすい手軽さがあります。
カスタムノード
JoyCaptionノード
入力された画像からキャプションを生成します。
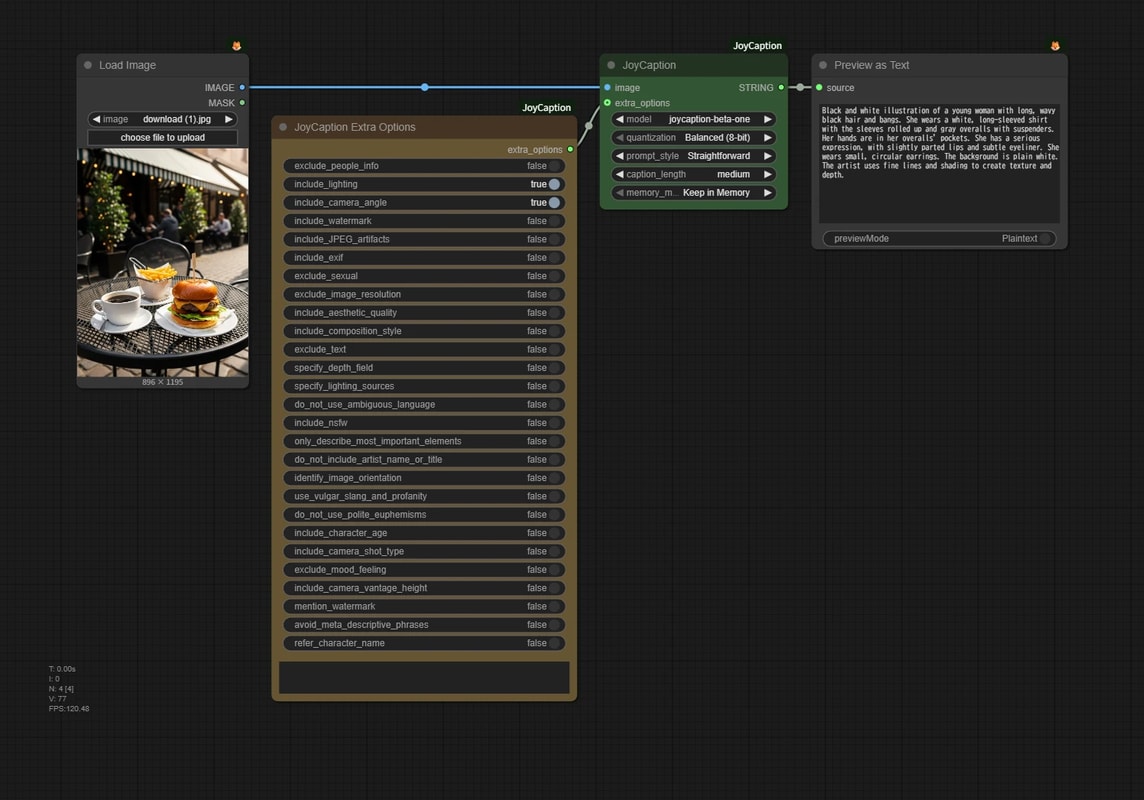
-
prompt_style- Descriptive
- 形式的で長めの散文として記述します。
- 画像の内容を詳しく残したいときには便利ですが、そのままプロンプトに使うには冗長になりがちです。
- Straightforward
- 簡潔かつ客観的な文体で記述します。
- プロンプトやLoRA用キャプションなどにそのまま流用しやすいスタイルです。
- Stable Diffusion Prompt
- Stable Diffusion 向けのプロンプト形式で記述します。
- Danbooru tag list
- Danbooru のタグ形式(例:
1girl,blue_hair)でタグを列挙します。
- Danbooru のタグ形式(例:
- Descriptive
-
caption_length- 出力するキャプションのボリューム(短め/長め)を指定します。
-
Extra Options- キャプション生成をガイドするための追加指示を設定します。
- 例として、カメラアングルや画質・解像度、NSFW要素などについて「詳しく書く/あまり触れない」といった方針を指定できます。