Wan2.2とは?
Wan2.2 は、Wan-2.1 の正当後継にあたる動画生成モデルファミリーです。 大きく 2 つのモデルで構成されています。
- 14B:
high_noise/low_noiseの 2 モデルを切り替える二段構成 - 5B:text2video と image2video を単一モデルで扱う TI2V モデル+Wan2.2 VAE
Wan2.2 14Bモデル
Wan2.2-A14B は、サンプリング前半を high_noise モデル、後半を low_noise モデルが担当する二段パイプラインになっています。
2つのモデルに分けることにより、VRAMの使用量はWan2.1から増やさずにモデルの大きさを二倍にして性能向上を図っています。
推奨設定値
- 推奨解像度
- 480p(854×480)〜 720p(1280×720)
- 最大フレーム数
- 81フレーム
- FPS
- 16fps 付近で出力されることが多い
- ただ、16fps だとスロモーションのような動画になることが多いので、24fps で保存したり、コマ落としで調整したりしてください。
モデルのダウンロード
- diffusion_models
- text_encoders
- umt5_xxl_fp8_e4m3fn_scaled.safetensors(Wan2.1 と共通)
- vae
- wan_2.1_vae.safetensors(Wan2.1 と共通)
- gguf(任意)
📂ComfyUI/
└── 📂models/
    ├── 📂diffusion_models/
    │   ├── wan2.2_t2v_high_noise_14B_fp8_scaled.safetensors
    │   ├── wan2.2_t2v_low_noise_14B_fp8_scaled.safetensors
    │   ├── wan2.2_i2v_high_noise_14B_fp8_scaled.safetensors
    │   └── wan2.2_i2v_low_noise_14B_fp8_scaled.safetensors
    ├── 📂text_encoders/
    │   └── umt5_xxl_fp8_e4m3fn_scaled.safetensors
    ├── 📂unet/
    │   ├── wan2.2_t2v_high_noise_14B-XXXX.gguf    ← gguf を使う場合のみ
    │   ├── wan2.2_t2v_low_noise_14B-XXXX.gguf     ← gguf を使う場合のみ
    │   ├── wan2.2_i2v_high_noise_14B-XXXX.gguf    ← gguf を使う場合のみ
    │   └── wan2.2_i2v_low_noise_14B-XXXX.gguf     ← gguf を使う場合のみ
    └── 📂vae/
        └── wan_2.1_vae.safetensors
text2video(14B)
KSampler Advanced を使って前半を high_noise、後半を low_noise モデルで処理します。
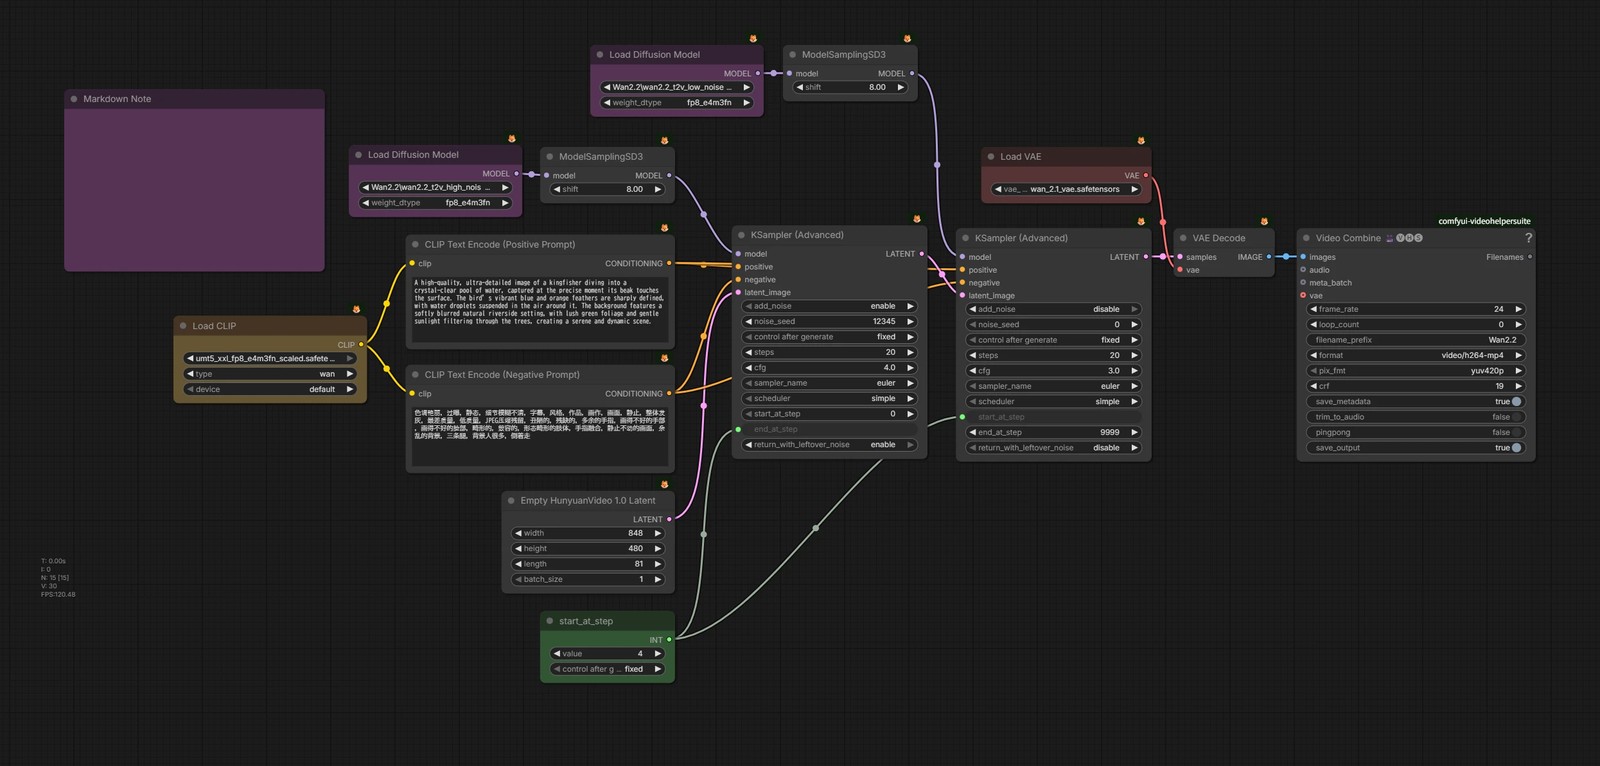
- 🟩 全体 20 steps のうち、何 step 目で
high_noise→low_noiseに切り替えるかを指定します- この切り替えるタイミングですが、規定では 「ノイズじゃない部分」と「ノイズ部分」の割合 が、
1 : 1の時を推奨されています。 - これを計算することはできますが、Sampler / Scheduler / sigma_shift / step数が絡み合い難しいです。
- また、これを完璧あわせたものが必ず最適というわけでもありません。
- この workflow では、4 steps で切り替えていますが、まずは、これを基準に色々試してみてください。
- この切り替えるタイミングですが、規定では 「ノイズじゃない部分」と「ノイズ部分」の割合 が、
- 🟨🟥 テキストエンコーダと VAE は Wan2.1 と同じです。
image2video(14B)
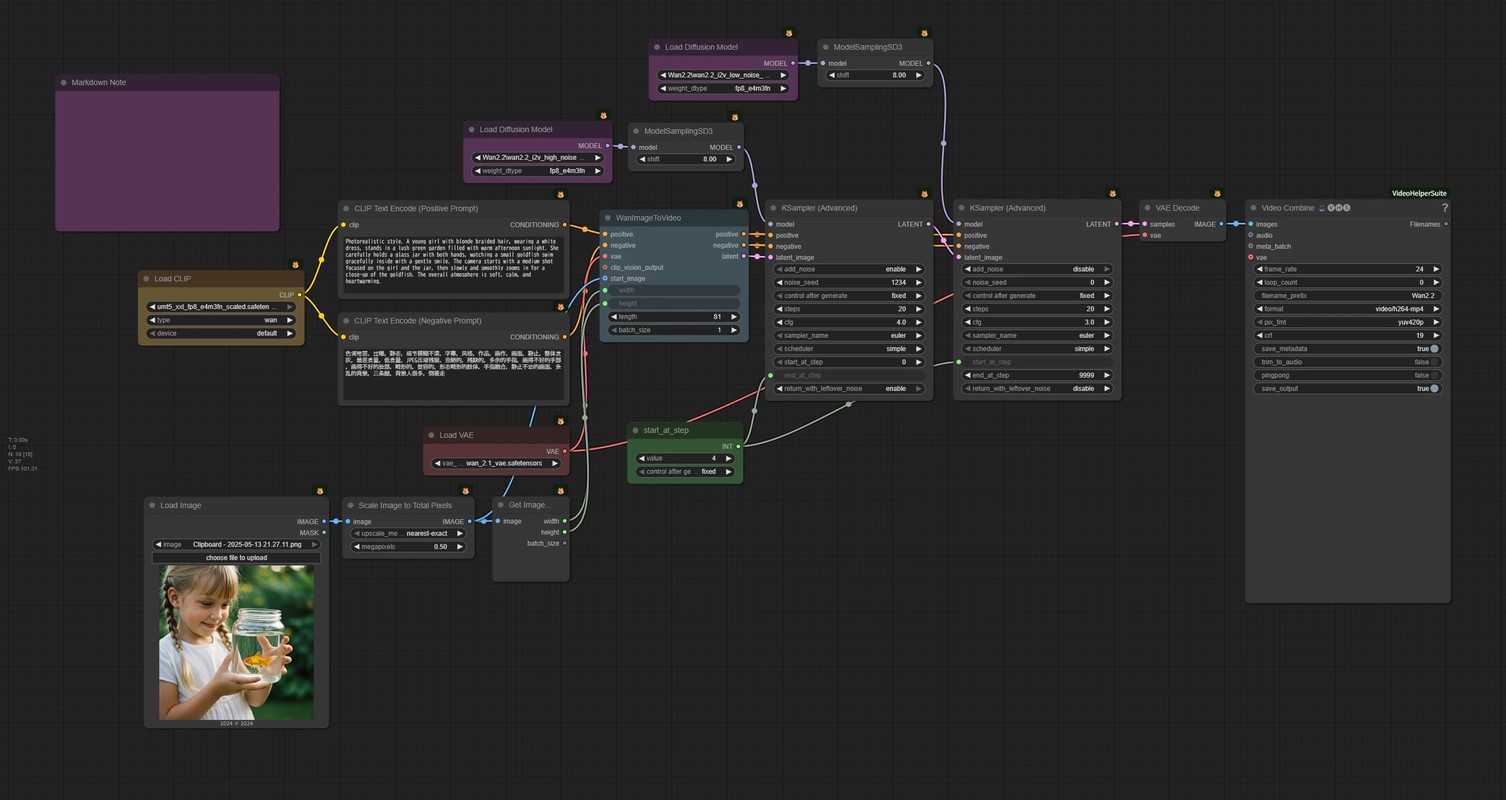
- 🟦 スタート画像は
WanImageToVideo系ノードに入力します。 - Wan2.2ではWan2.1のときと違い、
clip_visionを使用しません。
FLF2V(14B / First–Last Frame to Video)
Wan2.1 では FLF2V は専用モデルがありましたが、Wan2.2 の image2video モデルは FLF2V にも対応しています。
ComfyUI では WanFirstLastFrameToVideo ノードに Start / End の 2 枚の画像を入力するだけで、2 枚の間を補間した動画を生成できます。
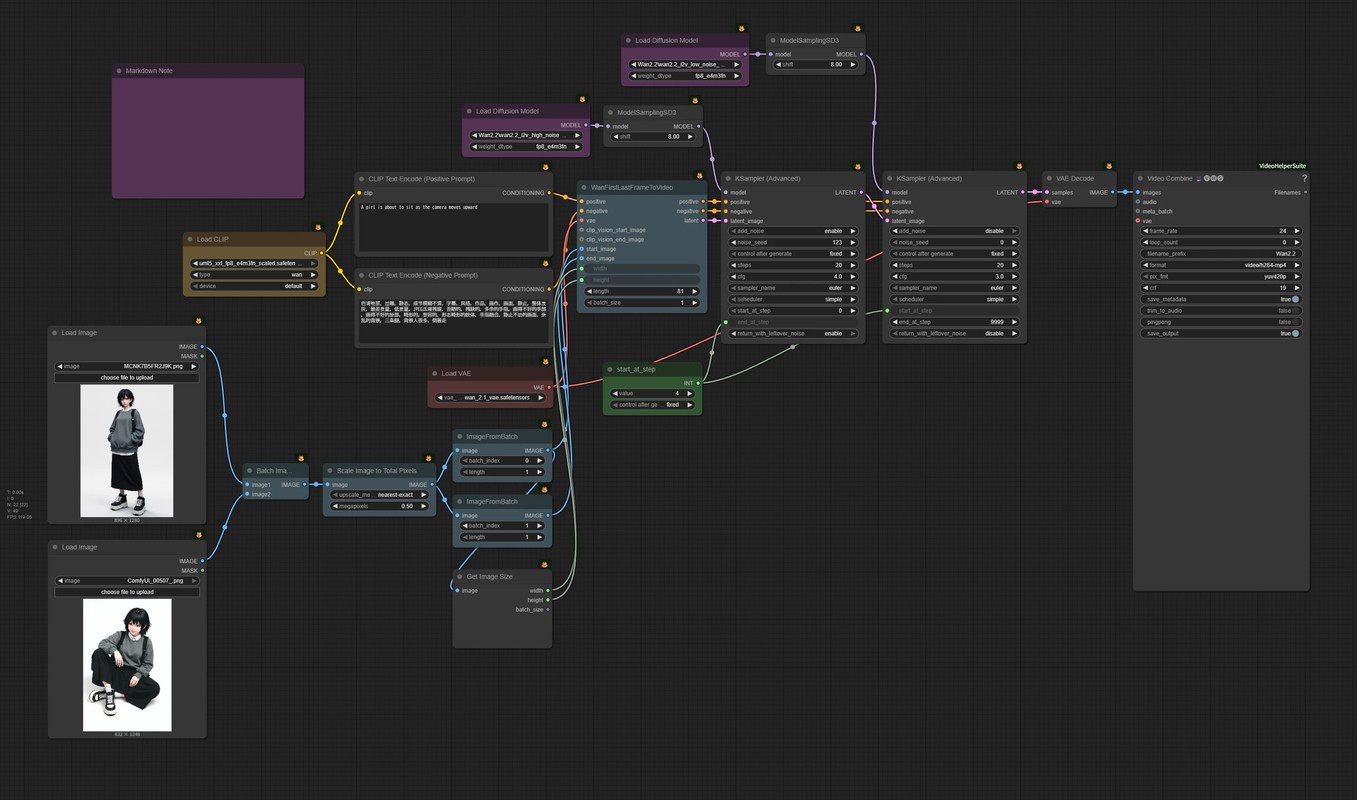
- 🟦 Wan2.1 と同様、
WanFirstLastFrameToVideoノードに Start / End 画像を入力します。
Wan2.2 5Bモデル(TI2V-5B)
Wan2.2-TI2V-5B は、text2video / image2video の両方を 1 つのモデルで扱う TI2V モデルです。 より圧縮率の高い VAE やパッチ化処理を組み合わせることで、720p・24fps・5秒程度の動画を、14B より軽い計算コストで生成できます。
14B の 1.3B 的な縮小版というよりは、もう少し根本から設計の異なるラインと考えたほうがいいでしょう。
設計は面白いのですが、残念ながらやはり14Bに性能で勝てず、実際のところほとんど使われていません。
推奨設定値
- 推奨解像度
- 720p(1280×720)
- 最大フレーム数
- 121フレーム
- FPS
- 24fps
モデルのダウンロード
- diffusion_models
- vae
- gguf(任意)
配置例です。
📂ComfyUI/
└── 📂models/
    ├── 📂diffusion_models/
    │   └── wan2.2_ti2v_5B_fp16.safetensors
    ├── 📂unet/
    │   └── Wan2.2-TI2V-5B-XXXX.gguf     ← gguf を使う場合のみ
    └── 📂vae/
        └── wan2.2_vae.safetensors
text2video(5B)

5B の text2video では、内部的には「最初のフレーム latent」を経由して動画を生成します。
- 🟥 VAE は
wan2.2_vaeを使用します Wan2.1 の VAE と圧縮構造が異なるため、差し替え忘れると画質や動きが大きく崩れます。 - 🟩 text2video でも TI2V 用の latent ノード(例:
Wan22ImageToVideoLatent)を挟みます 5B は「1フレーム latent → 動画」のパイプライン前提で設計されているため、ここを飛ばす構成は想定されていません。
「text2video だが、中身は image2video の特別ケース」という理解でいると、他の TI2V 系モデルと併せて整理しやすいと思います。
image2video(5B)
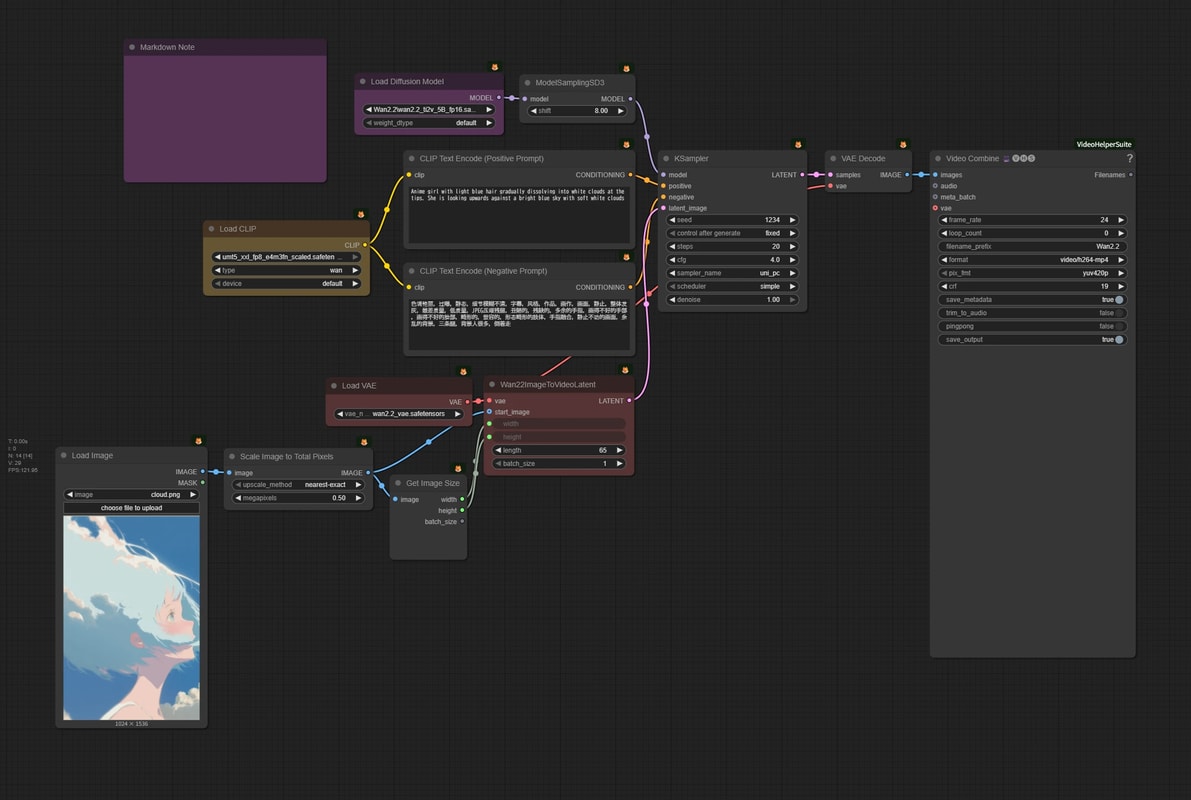
image2video も text2video と同じ TI2V モデルを使います。 入力が増えるだけで、後段の KSampler 以降はほぼ共通です。
- 🟦 start 画像は TI2V 用の latent ノードに入力し、圧縮 latent を作ります。
- 🟩 text2video / image2video の両方が同一モデルで済むので、 まず 5B でワークフローを固めてから、必要に応じて 14B を足す、といった運用がしやすくなっています。