PixelDiT
PixelDiT は、NVIDIA が公開している ピクセル拡散モデル です。
Stable Diffusion 以降の画像生成モデルの多くは、Latent Diffusion Model という仕組みを使っています。
画像を 1 ピクセルずつ計算するのは大変なので、一度 latent という小さな表現に圧縮することで計算量を減らしつつ、形や色、構図のような特徴を扱いやすくしているんですね。
ただ、latent からピクセルに戻すときに、細かい文字、模様といった細部がどうしても劣化してしまいます。
ピクセル拡散モデル は、latent を介さずに画像をピクセル空間のまま扱います。そのため、VAE による復元劣化は仕組み的に起きません。
計算量を下げるための latent だったんじゃないの?という疑問は残りますが、画像全体をそのまま細かく見るのではなく、パッチに分けて大まかに見つつ、細部はピクセル側で描き込むといった工夫でこれを解決しています。
モデルのダウンロード
- diffusion_models
- text_encoders
- gemma_2_2b_it_elm_bf16.safetensors (5.23 GB)
📂ComfyUI/
└── 📂models/
    ├── 📂diffusion_models/
    │   └── pixeldit_1300m_1024px_bf16.safetensors
    └── 📂text_encoders/
        └── gemma_2_2b_it_elm_bf16.safetensors
text2image
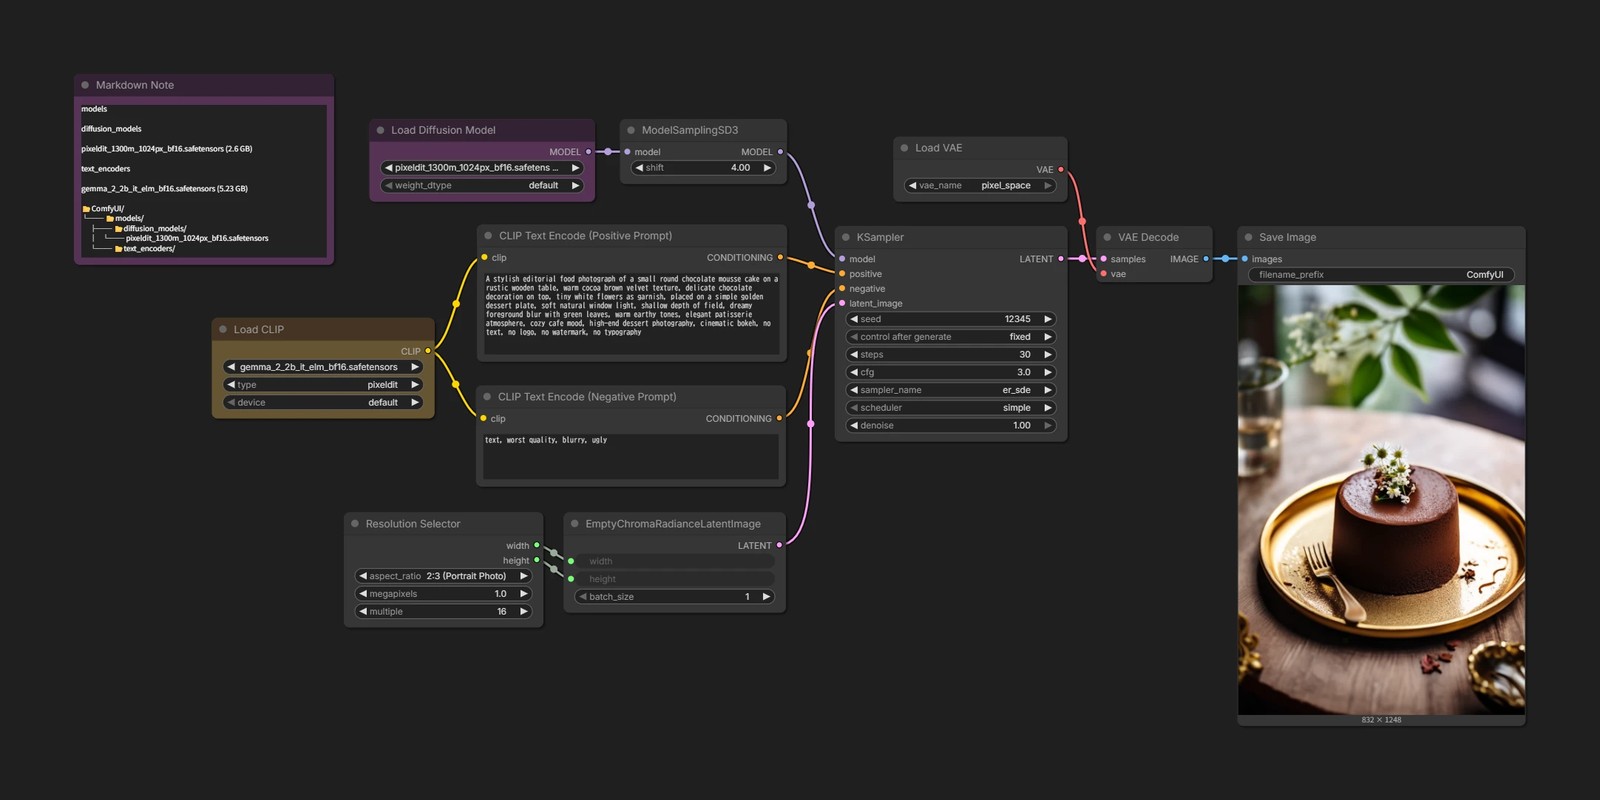
ピクセル拡散モデルなので、本来は Load VAE も VAE Decode も必要ありません。
ただ、ComfyUI では既存の workflow 形式に合わせるため、Load VAE で pixel_space を選び、それを VAE Decode へ繋ぎます。
pixel_space という VAE でデコードしているように見えますが、これは KSampler から IMAGE 出力を得るための操作だと思ってください。
PiD
PiD は、VAE Decode の代わりに使う PixelDiT です。
通常は、生成した latent を VAE Decode して画像に戻します。 PiD では、その latent を PixelDiT に渡して、画像への復元と拡大をまとめてやっちゃおうという面白いアイデアです。
例えば、Z-Image-Turbo で 1024×1024 の latent を作り、VAE Decode する前に PiD へ渡します。
1024_to_4096 の PiD なら、それを 4096×4096 の画像として出力します。
既存モデルの生成力を使いつつ、VAE Decode による細部劣化を避けられる、というわけですね。
モデルのダウンロード
-
SDXL 用
-
Qwen-Image 用
-
Flux.1 / Z-Image 用
-
Flux.2 用
📂ComfyUI/
└── 📂models/
    └── 📂diffusion_models/
        ├── pid_sdxl_1024_to_4096_4step_bf16.safetensors
        ├── pid_1.5_qwenimage_1024_to_4096_4step_bf16.safetensors
        ├── pid_flux1_512_to_2048_4step_bf16.safetensors
        ├── pid_1.5_flux1_1024_to_4096_4step_bf16.safetensors
        ├── pid_flux2_512_to_2048_4step_bf16.safetensors
        └── pid_1.5_flux2_1024_to_4096_4step_bf16.safetensors
すべて入れる必要はありません。使うベースモデルに対応した PiD だけ配置します。
モデルの選び方
どの PiD モデルを選ぶかについて、二点注意する必要があります。
-
ベースモデルの種類
- 元のモデルが使っている latent タイプに合わせる必要があります。
- SDXL なら SDXL 用、Z-Image なら Flux.1 用 といった具合です。
-
拡大率
- モデル名を見ると
1024_to_4096のような文字が見えますが、これは拡大率です。 - これを使えば勝手に拡大されるわけではなく、たとえば
1024_to_4096なら、1024px 相当の latent / 出力を PiD に渡し、4096px の画像が出力されるようにパラメータを設定します。 - 大まかな解像度があっていればアスペクト比は自由です。
- モデル名を見ると
Z-Image-Turbo → PiD
Z-Image-Turbo の latent を、PiD でデコードしてみましょう。
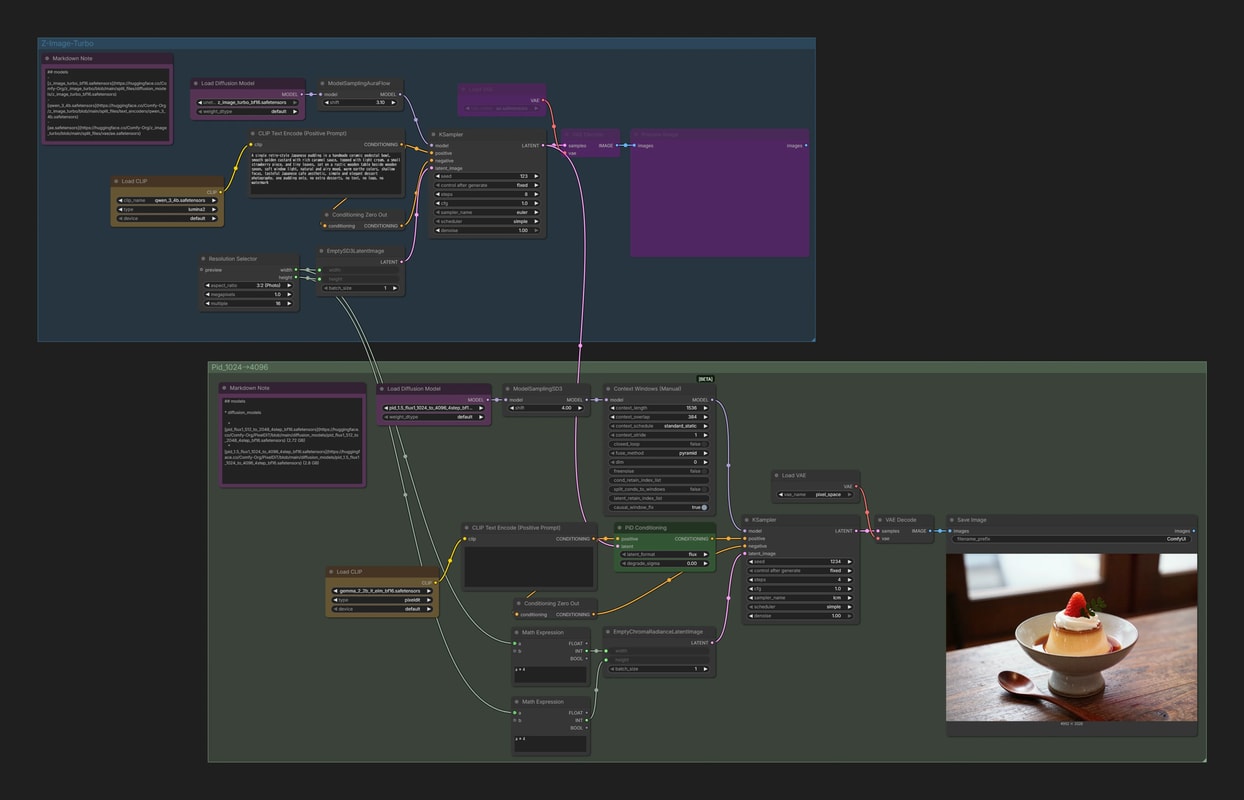
- 🟦 左上は通常の Z-Image-Turbo workflow です。
- 🟩 出力された latent は VAE Decode せず、PixelDiT 側の
PiD Conditioningに繋ぎます。
- 🟩 出力された latent は VAE Decode せず、PixelDiT 側の
- 今回は
1024_to_4096モデルを使います。- Z-Image-Turbo 側は 1M ピクセル相当で生成し、PiD 側ではその 4 倍の解像度を指定します。
- PiD は 4 ステップ蒸留モデルなので、ここでは
stepsを 4、cfgを 1.0 にしています。 Context Windows (Manual)ノードは、いわゆるタイリング用です。 OOM する場合や、縦長・横長の画像で出力が荒れる場合に使います。
任意の画像をアップスケール
PiD Conditioning に渡しているのは、ただの latent です。
そのため、前段でわざわざ text2image をしなくても、好きな画像を一度 VAE Encode して PiD に渡せば、アップスケーラーのように使うこともできます。
今回は、PiD 1.5 の Flux.2 用モデルと flux2-vae.safetensors を使います。
- flux2-vae.safetensors (336 MB)
📂ComfyUI/
└── 📂models/
    └── 📂vae/
        └── flux2-vae.safetensors
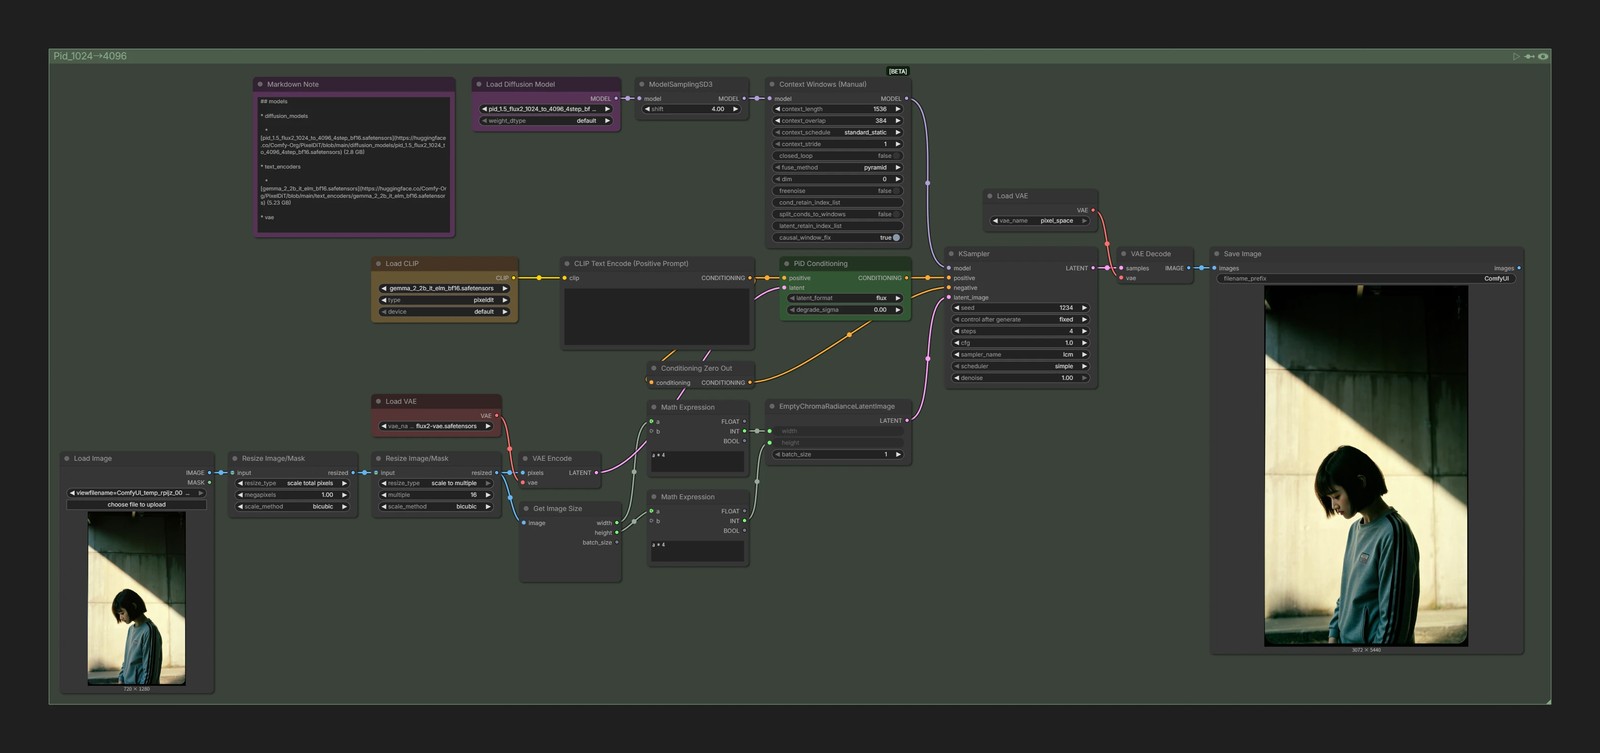
- 入力画像を 1M ピクセル相当、かつ 16 の倍数になるようにリサイズ
- リサイズ後の高さと幅を取得し、4 倍した値を PiD 側の出力サイズに使用
やっていることは本質的には描き直しなので、アップスケーラーというよりエンハンスです。
忠実な再現が必要な用途にはあまり向きません。