SDXLとは?
SDXL(正確には SDXL 1.0)は、Stable Diffusion 1.5 を開発した Stability AI による正統後継モデルです。(Stable Diffusion 2.1 という系統もありましたが、まあ…性能がね……)
Stable Diffusion からの大きな違いとして、だいたい次の2点があります。
base と refiner の二段構成
- 基本的な text2image は
baseモデルだけで完結します。 - その後、
refinerモデルで image2image することで、ディテールや質感を整える「仕上げ」を行う設計になっています。
学習時の解像度の変更
- Stable Diffusion 1.5
- 512 × 512px の正方形画像を中心に学習
- SDXL
- 1024 × 1024px を中心に、さまざまなアスペクト比で学習
- 元から解像度の高い画像生成や、縦長・横長の構図にもある程度対応しやすくなっています。
モデルのダウンロード
📂ComfyUI/
  └── 📂models/
      └── 📂checkpoints/
          ├── sd_xl_base_1.0_0.9vae.safetensors
          └── sd_xl_refiner_1.0_0.9vae.safetensors
baseモデルだけで text2image
まずは base だけで、シンプルに text2image してみましょう。
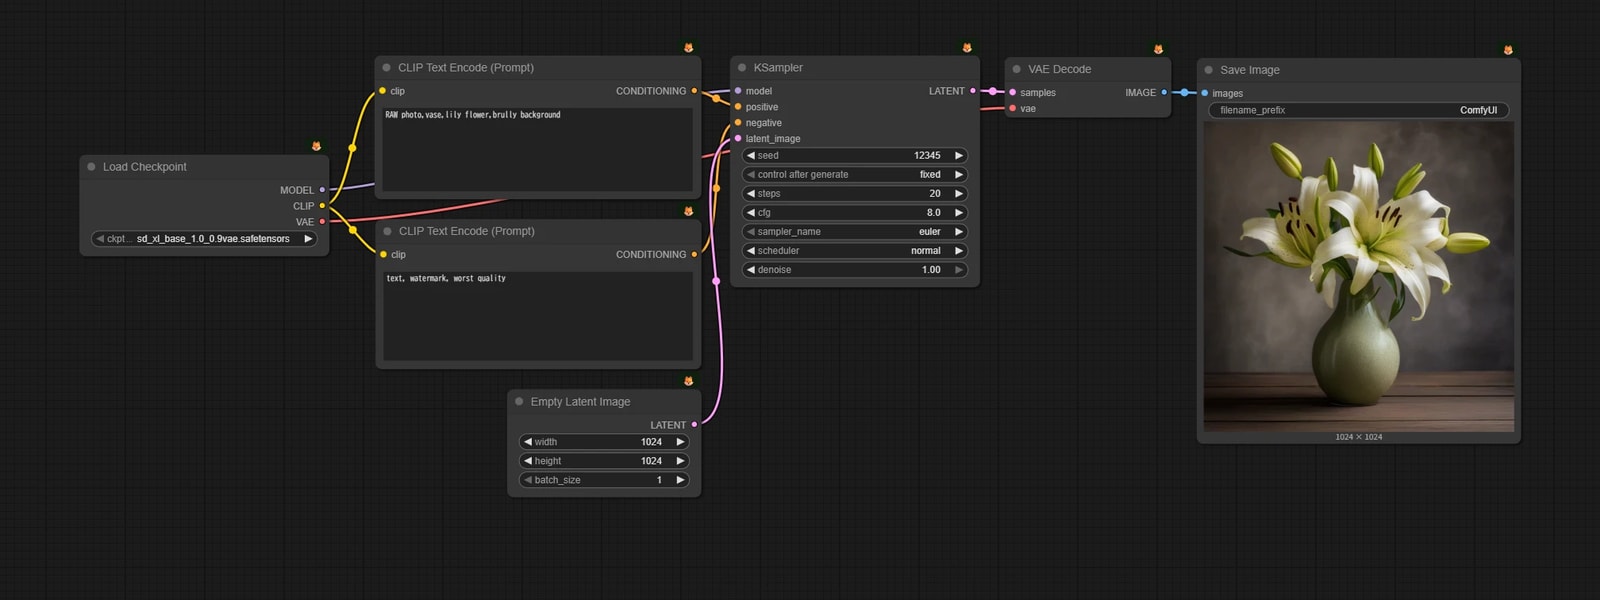
SD1.5 の text2image の workflow で、Checkpoint を SDXL base に差し替えるだけで基本的な生成はできます。
-
解像度は、おおよそ 1M ピクセル(1024 × 1024px 前後)を目安にします。
- 例:1024 × 1024 / 896 × 1152 / 1152 × 896 など
CLIPTextEncodeSDXL
SDXL base はテキストエンコーダとして、2種類の CLIP(OpenCLIP-ViT/G, CLIP-ViT/L)を組み合わせた構成になっています。
ComfyUI には、それぞれの CLIP に別々のテキストを入力できるノードもありますが、先に言っておくと 使う必要はありません。
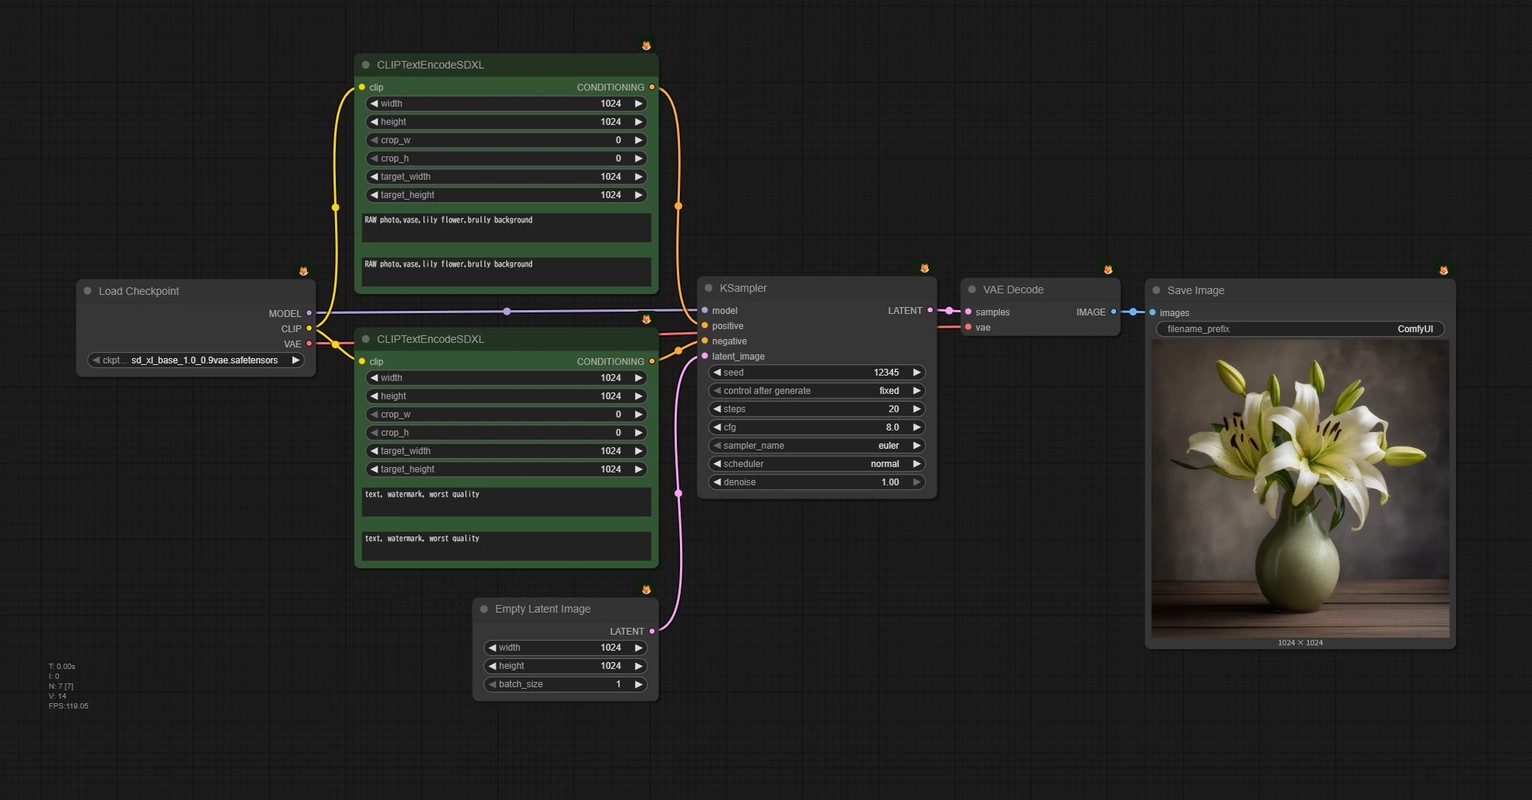
- 両方の CLIP に同じプロンプトを入れた場合、結果としては
CLIP Text Encodeノードを使ったときとほぼ同じ挙動になります。 - 実験の結果でも、両方の CLIP に同じテキストを入れたときが、もっとも安定した出力になりやすいことが分かっています。
base + refiner
次に、base が生成した画像を refiner で仕上げてみます。
base で生成 → refiner で image2image
SDXL base と SDXL refiner は、同じ latent 表現を使います。 そのため、base で生成した latent を、そのまま refiner 側の KSampler に入力して image2image できます。
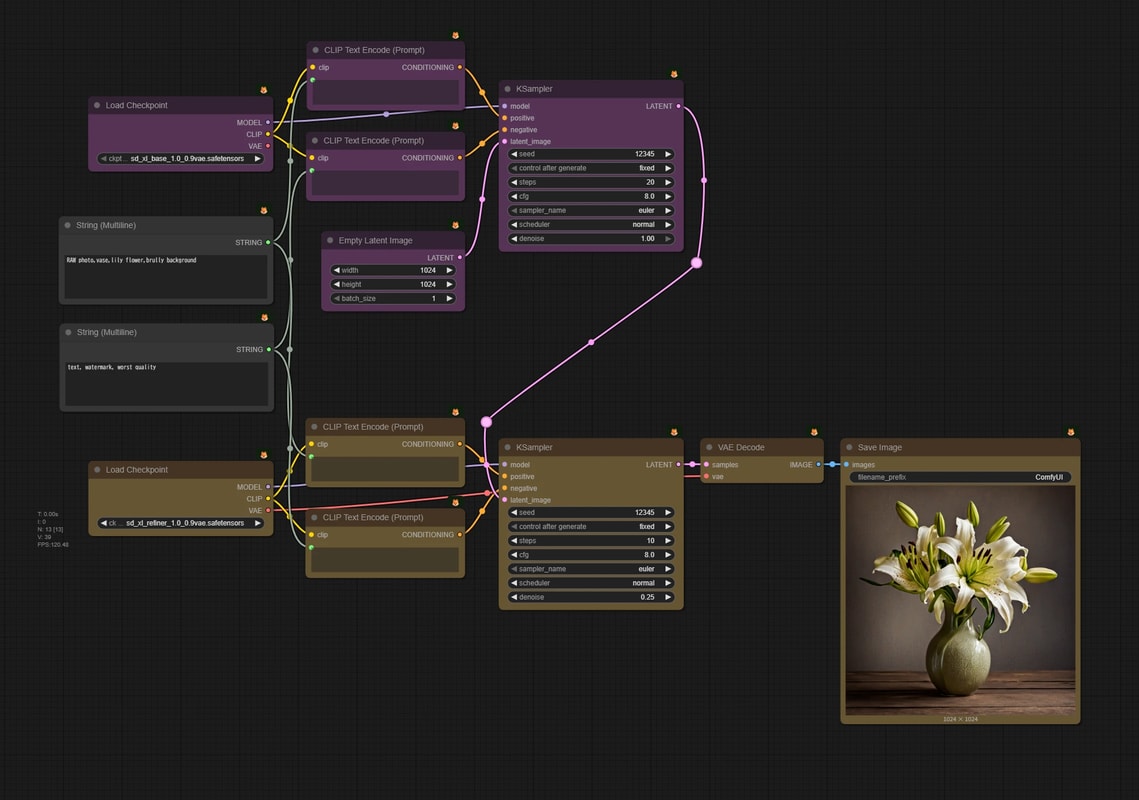
- 1. 🟪 SDXL base で通常どおり text2image(latent を出力)
- 2. 🟨 その latent を、SDXL refiner を使った KSampler に接続
- 3. 🟨 低い
denoise(例:0.2〜0.3)で image2image- ディテールを増やすことに特化しているため、本当に少しで十分です。
もともとの base の絵柄は活かしつつ、細部や質感だけを refiner に整えてもらうイメージです。
サンプリング途中で切り替え(KSampler Advanced)
もう少しスマートにやる方法として、サンプリング途中で base → refiner に切り替えるやり方もあります。 KSampler (Advanced)ノード を使います。
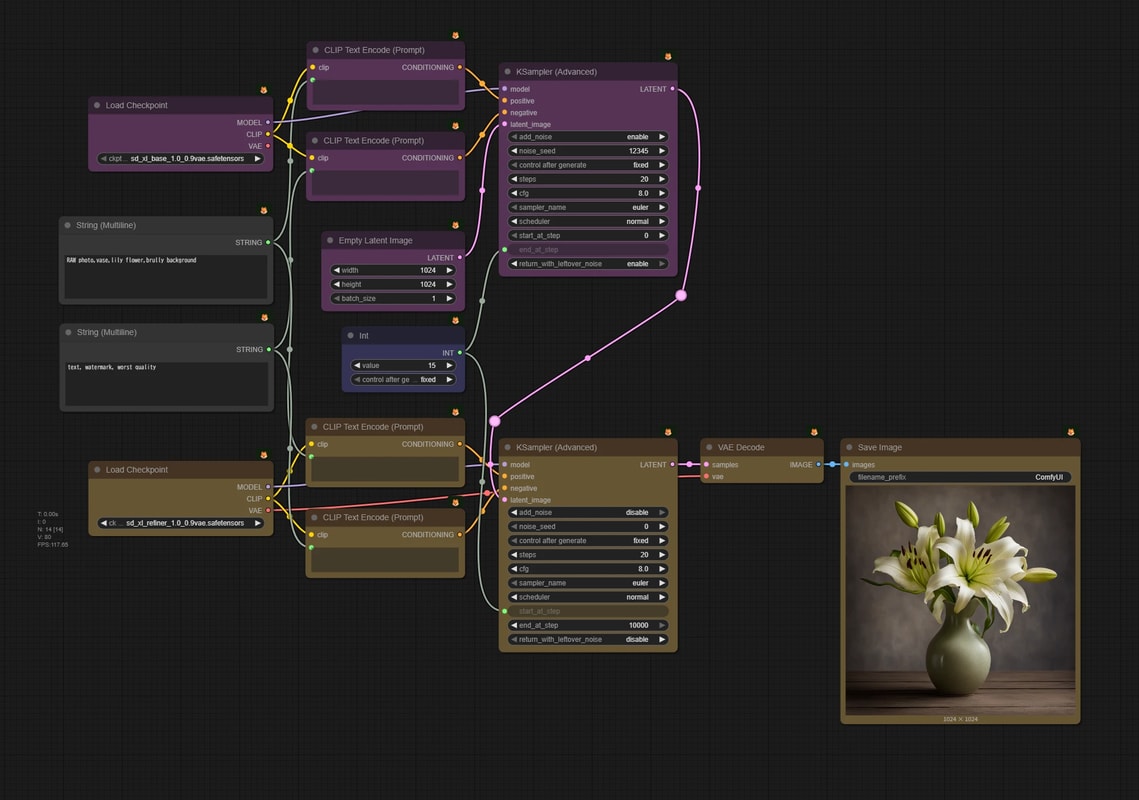
- 🟪 中盤までは SDXL base でサンプリング
- 🟨 残りのステップを SDXL refiner に切り替えサンプリング
- 🟦
intノードで切り替えるタイミングを設定します。
個人的には image2image のほうが分かりやすいので好みではありますが、このように、1回のサンプリングパスの中で base と refiner の切り替えができるというのは覚えておいてもいいかもしれません。
refinerはいらないが、「refiner的な考え方」は大事
refiner レスな SDXLモデル
SDXL をベースにした派生モデル(コミュニティモデルや商用モデル)は数多くありますが、多くのモデルは refiner を使わなくても十分な画質が出るように調整 されています。
少し強い言い方をすれば、「refiner で後処理をする」という設計は、当時の base 単体の性能を補うための妥協策でもありました。
refiner的な考え方
とはいえ、「複数のモデルにまたがって1枚の画像を仕上げる」という考え方自体は、今でも十分通用する発想です。
- 絵柄は好みだが、プロンプトにはあまり従ってくれないモデル
- 逆に、プロンプトにはよく従うが、絵柄が好みではないモデル
といった「帯に短し」のようなモデルは、いくらでもあります。
こうした場面では、SDXL の refiner 的な考え方が役に立ちます。
- 構図やプロンプト再現性に優れたモデルで、まずベースとなる画像を生成する
- その画像を、絵柄が好みのモデルで image2image して仕上げる
という二段構成にすることで、「構図は A モデル」「絵柄は B モデル」といった、いいとこ取りの workflow を組むことができます。
SDXL における base / refiner は、その一つの具体例に過ぎません。 「複数モデルをどう掛け合わせるか」自分なりの組み合わせを探してみてください。