IP-Adapterとは?
絵や写真を見ながら「これと同じ雰囲気で描いてほしい」と思っても、テキストだけで細部まで説明するのはほぼ不可能です。
そこで、「テキストを介さずに、AI に直接画像を見てもらう」仕組みがいくつか提案されてきました。
その中でも、スタイルや被写体の“転送” に使われてきた古典的な手法のひとつが IP-Adapter です。
「reference2image」「subject 転送」の元祖的な位置づけだと思ってください。
必要なカスタムノード
SD1.5 × IP-Adapter
IP-Adapterにはいくつか種類がありますが、最もスタンダードなものをまずは試してみましょう。
モデルのダウンロード
- IP-Adapter 本体(SD1.5 用)
- CLIP Vision モデル
- model.safetensors
- 分かりにくいので
OpenCLIP-ViT-H-14にリネームしてください。
- 分かりにくいので
- model.safetensors
📂ComfyUI/
  └── 📂models/
      ├── 📂clip_vision/
      │   └── OpenCLIP-ViT-H-14.safetensors
      └── 📂ip_adapter/
          └── ip-adapter_sd15.safetensors
workflow
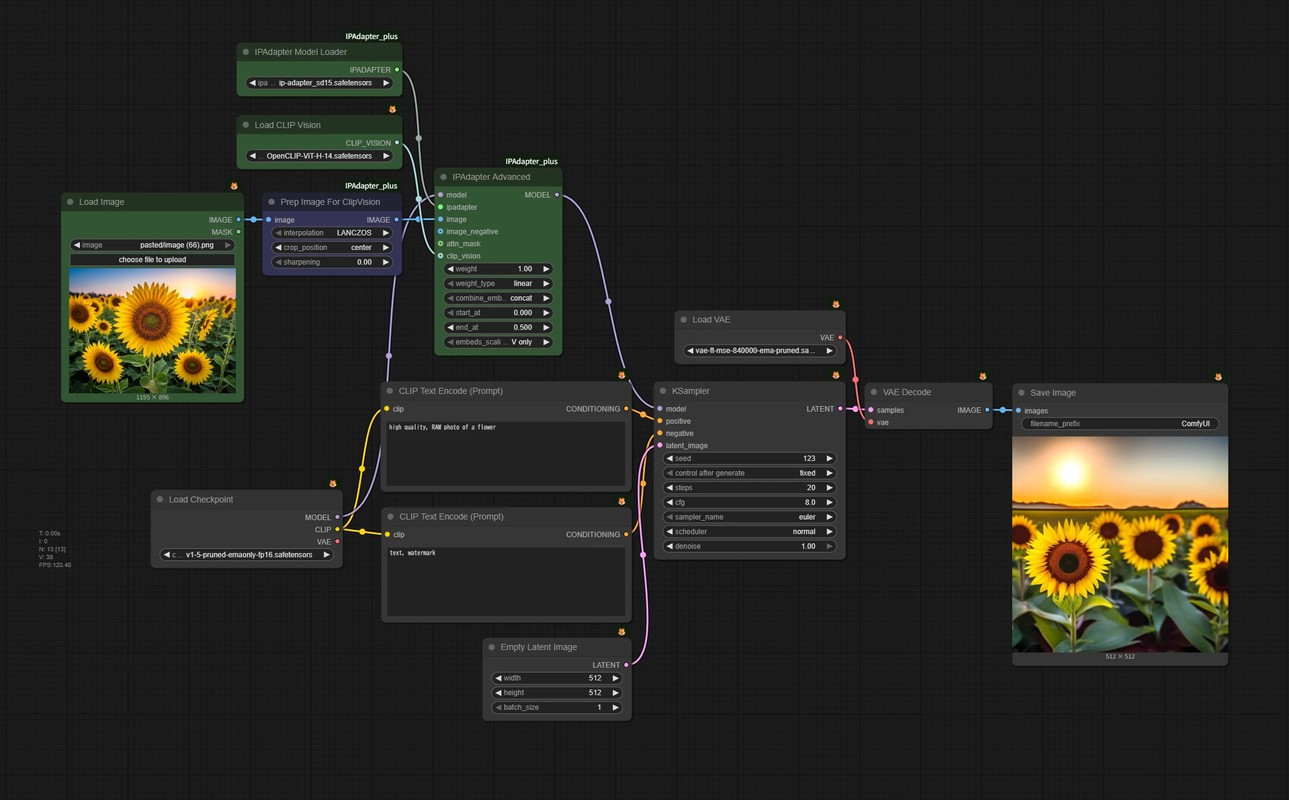
- 🟩
IPAdapter Advancedノードに各種モデルと参考にしたい画像を接続します。 - 🟦
Prep Image For ClipVisionノードで参考画像をクロップします。- 詳細は下に
どこを「見て」いるか
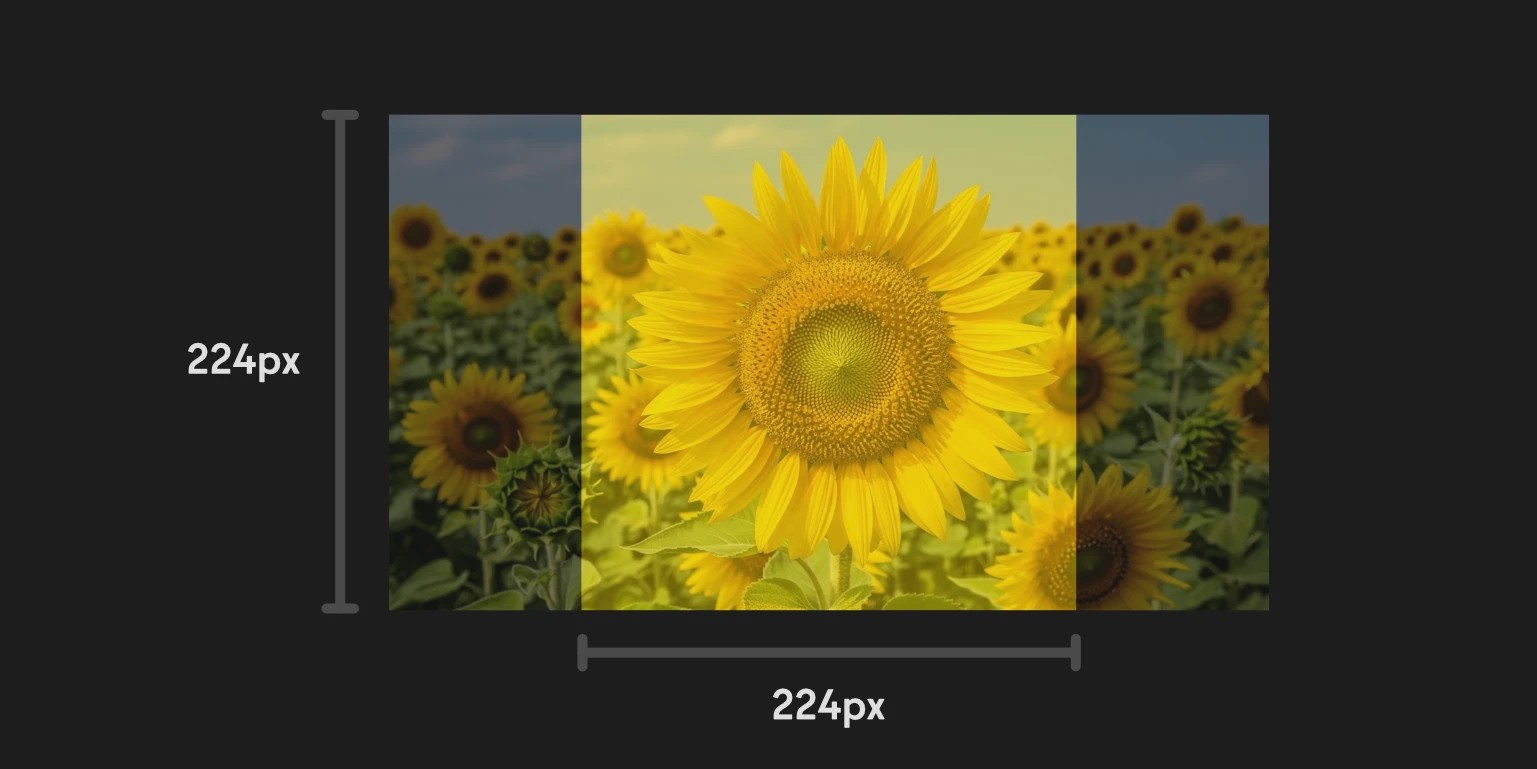
IP-Adapter の「目」にあたる CLIP ViT-H-14 は、基本的に 224 × 224 の範囲しか見ていません。
そのため、縦長の人物写真をそのまま渡すと、顔や足が切れたり、体の真ん中あたりだけを手がかりに特徴を取ってしまったりします。
どの部分を基準にしてほしいか決めたい場合は、上のworkflowのように先にリサイズ・クロップをしてください。
IP-Adapterの主なモデル
いくつか派生モデルがありますが、参照画像から「何をどこまで借りてくるか」は、モデルごとにだいぶ性格が違います。
ip-adapter-plus_sd15
構図やオブジェクトの位置を強めに転送するモデルです。
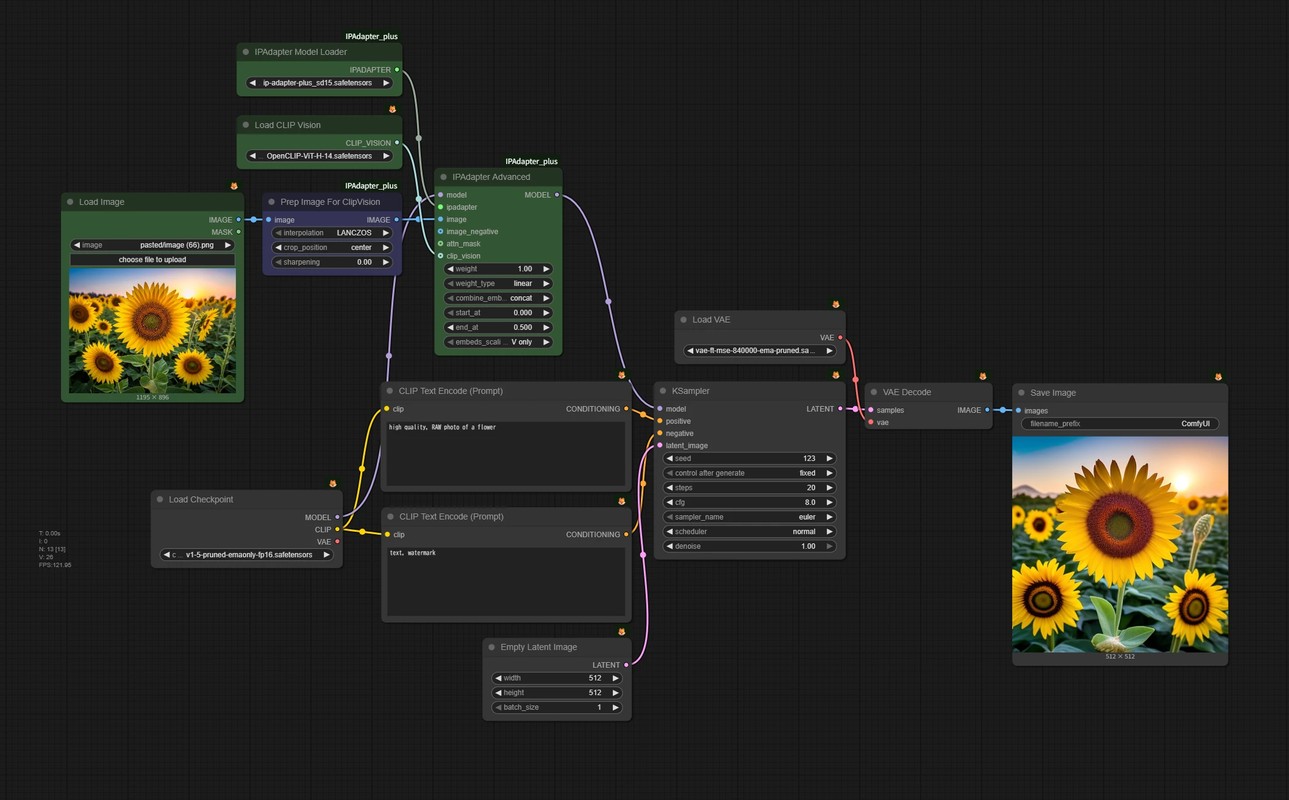
- ip-adapter-plus_sd15.safetensors
- 参照画像とかなり近い構図になる
ip-adapter_sd15_light
テキストプロンプト優先寄りのモデルです。
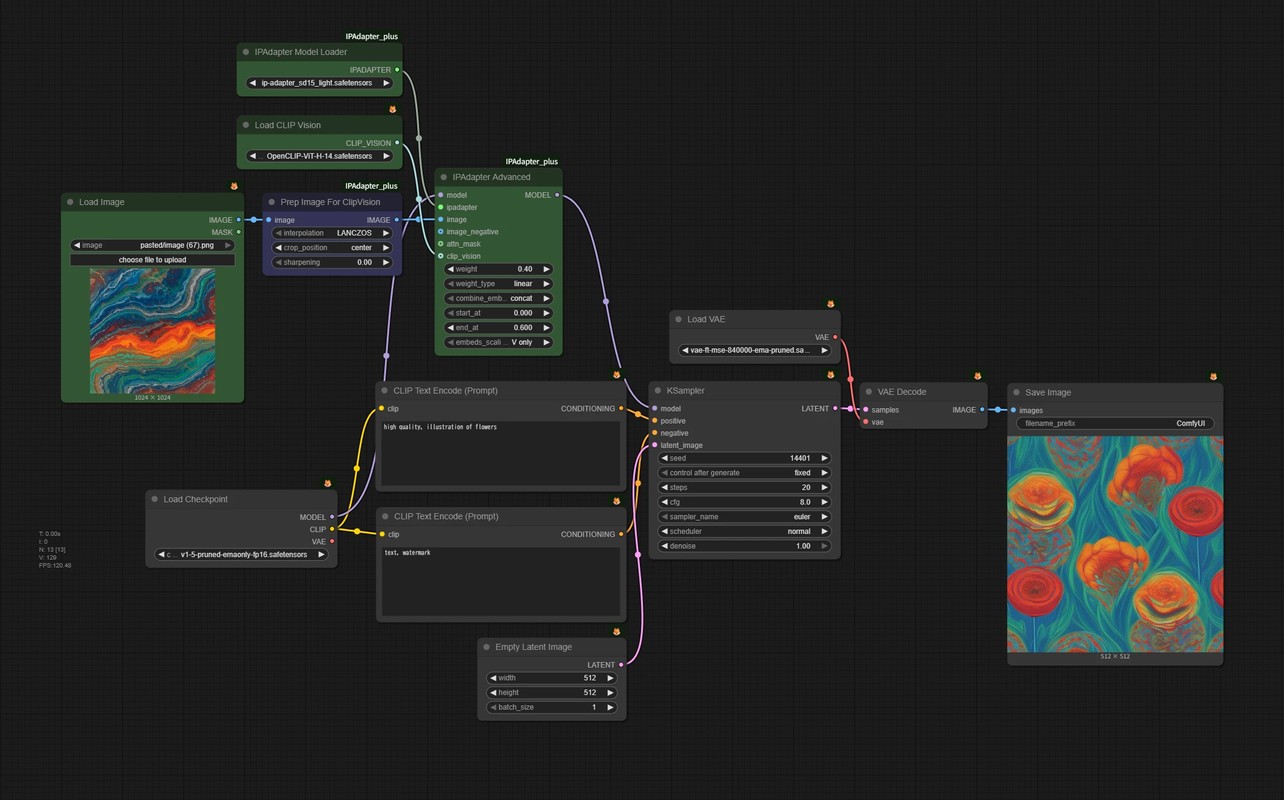
- ip-adapter_sd15_light.safetensors
- テキストの指示を強めに残す
- 参照画像は主に「スタイル・雰囲気」のヒント程度
ip-adapter-plus-face_sd15
顔(頭部)に特化した IP-Adapter です。
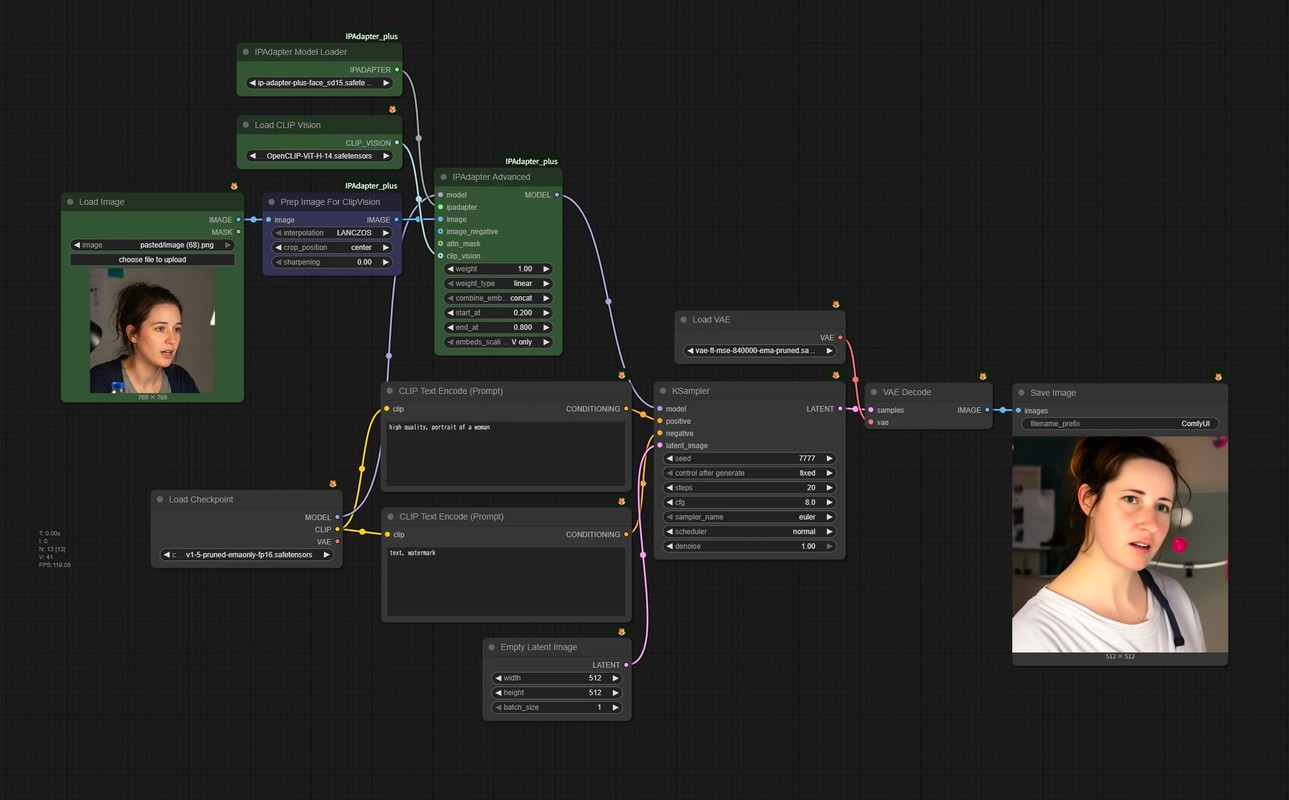
- ip-adapter-plus-face_sd15.safetensors
- 顔立ち・輪郭・目鼻立ちなどをかなり強く固定する
SDXL用モデルリンク
もしSDXLも試してみたい方向けに、SDXL用のモデルリンクの一覧です。