Wan-Animateとは?
Wan-Animate は、人・キャラへのモーション転送に特化した Wan2.1-14B-I2V ベース のモデルです。
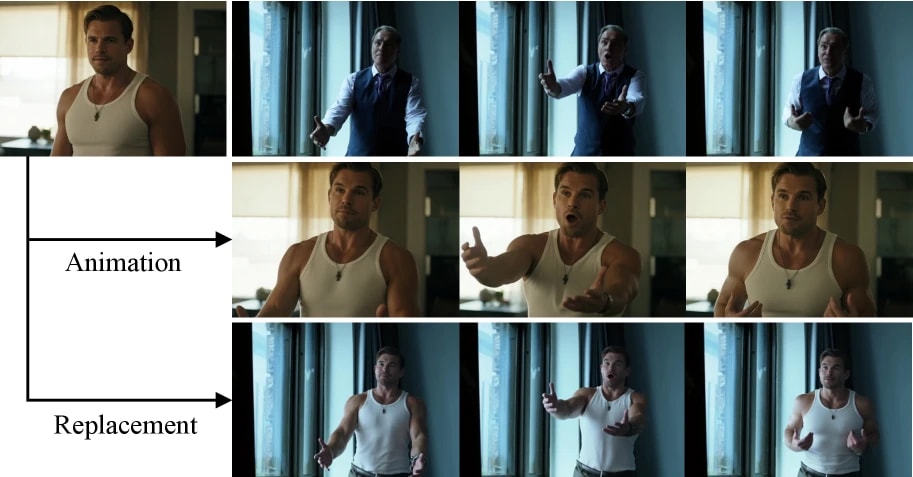
- 入力した画像を、参照動画の人物の動きに合わせて動かす Animation モード
- 入力した動画の人物を、参照画像の人物に置き換える Replacement モード
2 パターンの生成モードがありますが、Replacement モードは Animation モードに「背景になじむような処理」を追加したもの、と考えると分かりやすいと思います。
Wan2.1 ベースのため 77 フレームまでしか生成できませんが、Wan2.1 VACE の Extension と同じように、最後の数フレームを抽出してその続きを生成する処理を繰り返すことで、実質的に長尺の動画を扱うこともできます。
必要なカスタムノード
事前処理として顔検出やポーズ推定を行います。次のカスタムノードがあると非常に便利です。
- ComfyUI-WanAnimatePreprocess
- YOLO による顔検出
- ViTPose によるポーズ(棒人間)抽出
- ComfyUI-segment-anything-2
- SAM2 を使った人物マスクの生成(Replacement モードで使用)
モデルのダウンロード
Wan-Animate 本体と、Wan2.1 系で共通のモデルを揃えます。
- diffusion_models
- loras
- clip_vision
- text_encoders
- vae
- gguf(任意)
配置例です。
📂ComfyUI/
└── 📂models/
    ├── 📂clip_vision/
    │   └── clip_vision_h.safetensors
    ├── 📂diffusion_models/
    │   └── Wan2_2-Animate-14B_fp8_e4m3fn_scaled_KJ.safetensors
    ├── 📂loras/
    │   └── WanAnimate_relight_lora_fp16.safetensors
    ├── 📂text_encoders/
    │   └── umt5_xxl_fp8_e4m3fn_scaled.safetensors
    ├── 📂unet/
    │   └── Wan2.2-Animate-14B-XXXX.gguf      ← gguf を使う場合のみ
    └── 📂vae/
        └── wan_2.1_vae.safetensors
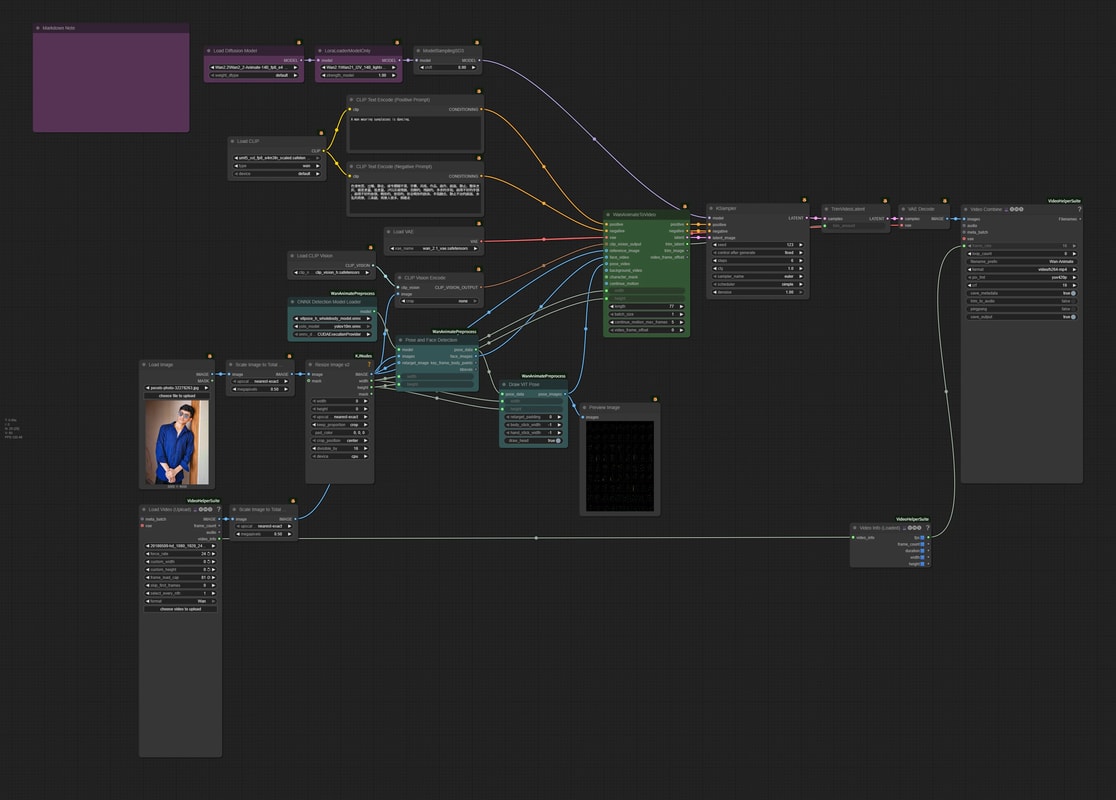
Animationモード
入力した静止画を、参照動画の人物の動きに合わせて動かすモードです。
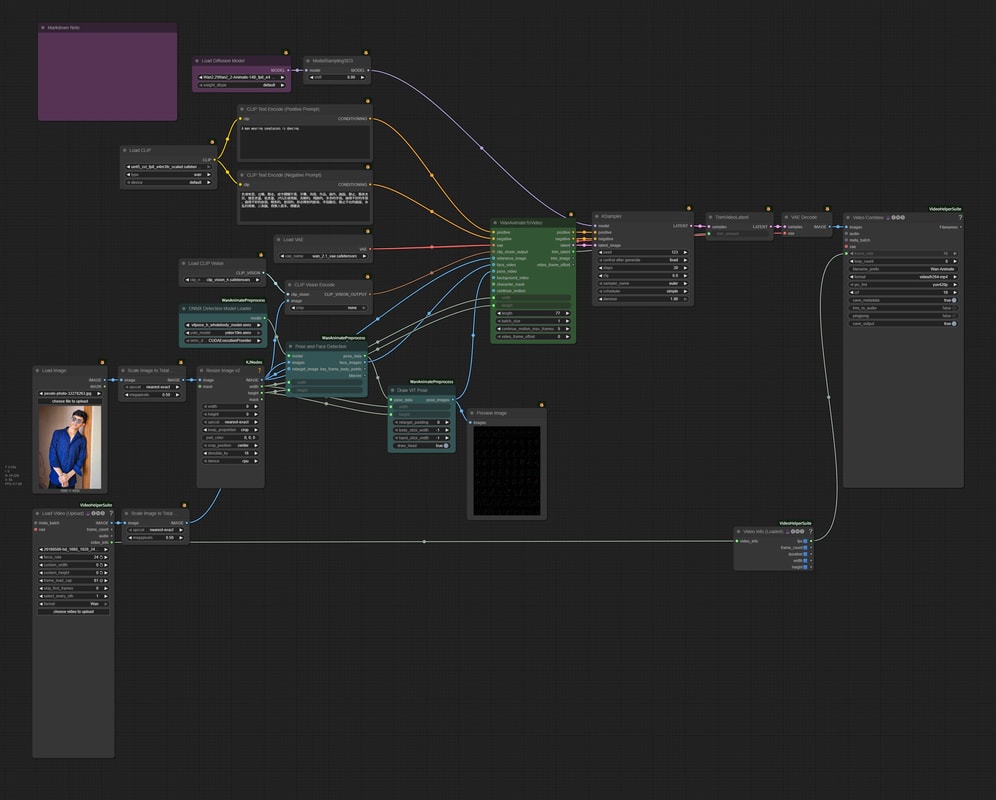
かなり巨大なのでドキドキしますが、ベースは Wan2.1 image2video の形そのままです。臆せず進めていきましょう。
Wan-Animate モデルを読み込む
Load Diffusion ModelでWan2_2-Animateを読み込みます。
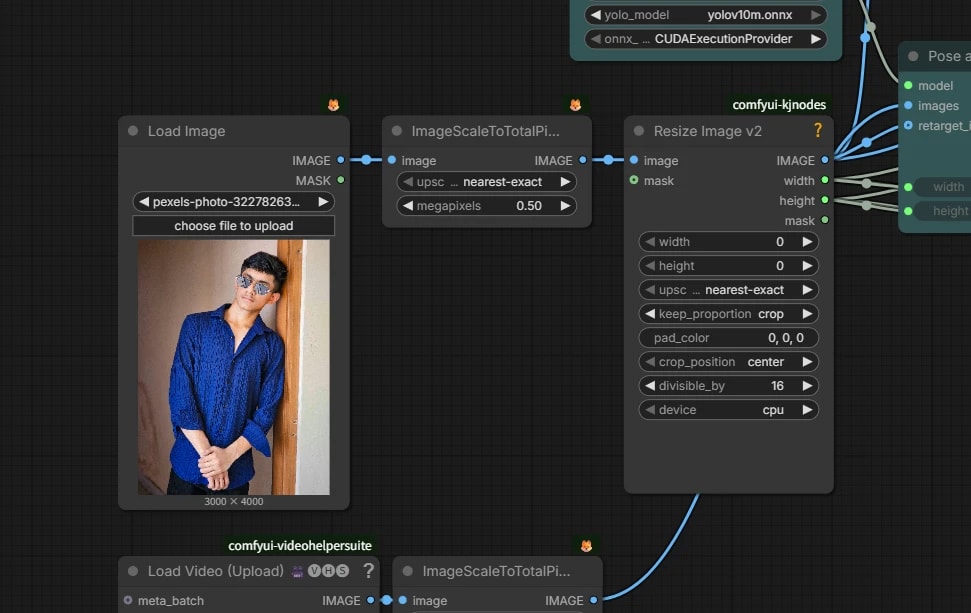
生成解像度を決める
- 入力画像に合わせて
Scale Image to Total Pixelsで総ピクセル数を調整します。 - PC のスペックに合わせて値を変えてください。
- 最後に解像度を 16 の倍数にクロップ します。
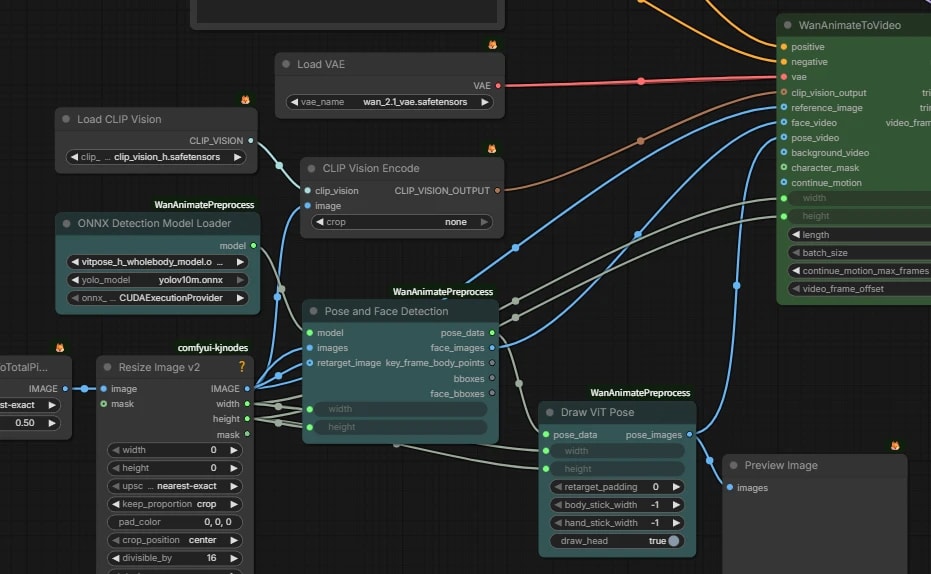
WanAnimateToVideo ノードに追加情報を入力する
reference_image動かしたい静止画。face_video参照動画から顔部分をクロップした動画。Pose and Face Detectionが自動で YOLO による顔検出 → クロップを行います。pose_video参照動画から ViTPose で棒人間(キーポイント)を生成した動画。 ドライビング動画と動かしたい画像では骨格や位置が違うため、retarget 処理で調整されます。
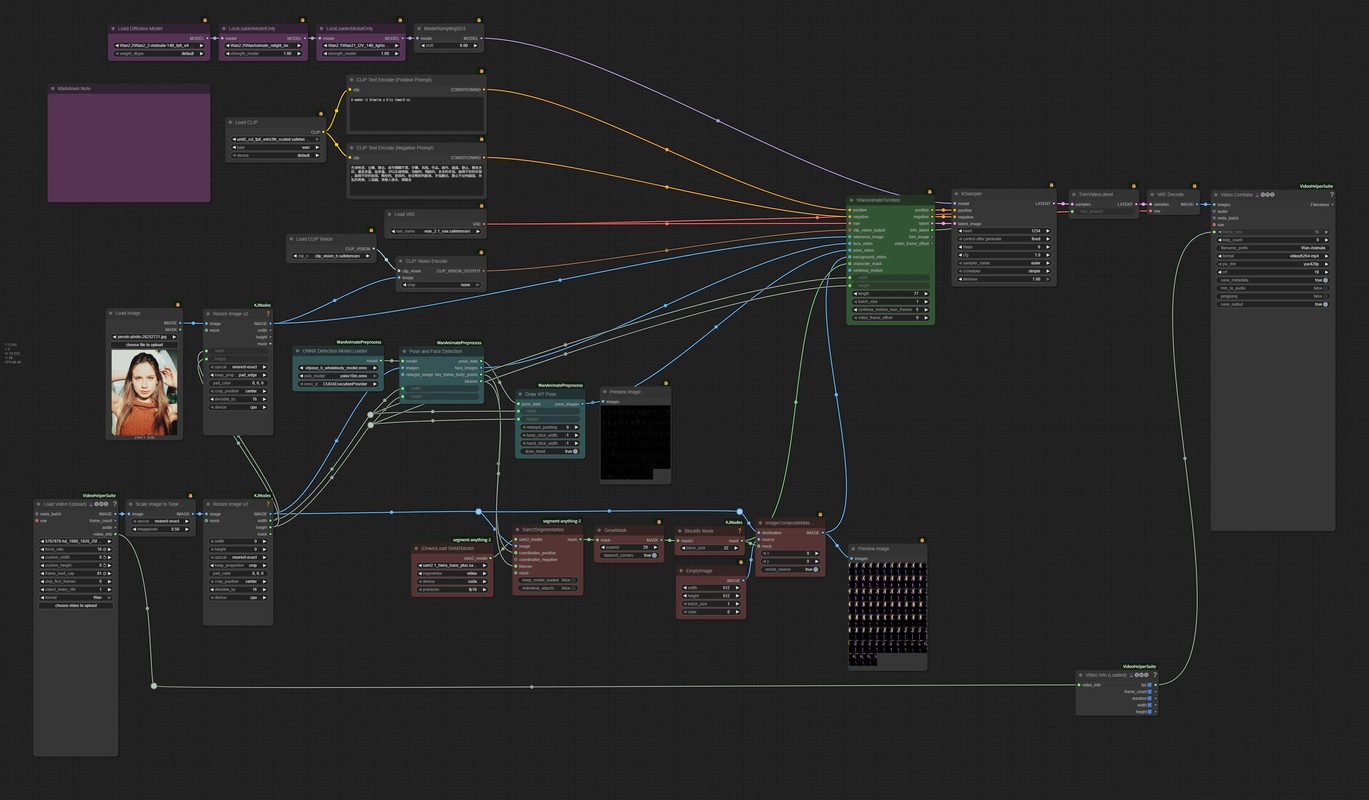
Replacementモード
入力した動画の人物を、参照画像の人物に置き換えるモードです。
Animation モードに、人物を inpainting するためのマスクと、背景になじませるためのリライト処理を追加したものになります。
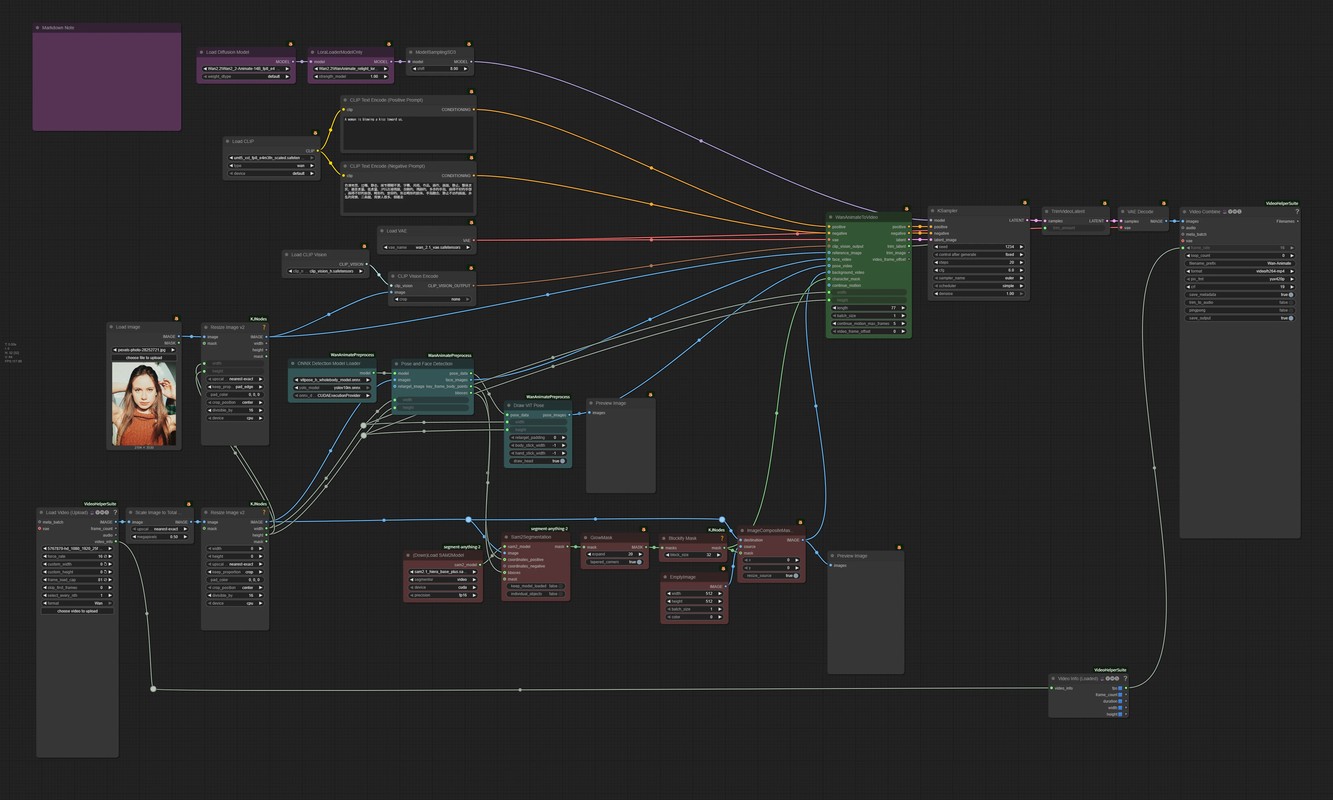
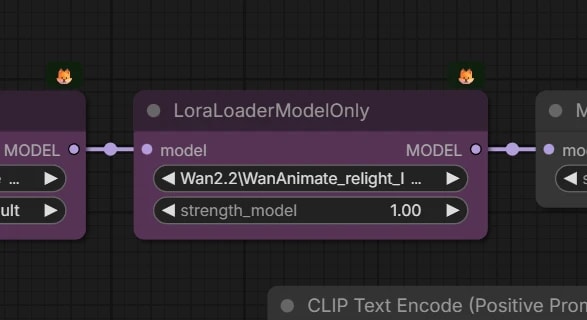
リライト LoRA の追加
- 入れ替えた人物を背景に溶け込ませるためのリライト LoRA を追加します。
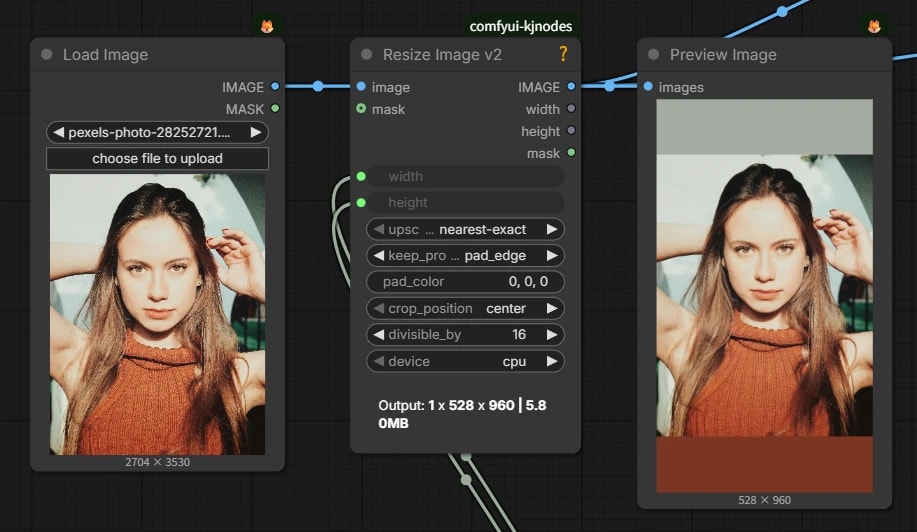
参照画像の padding
- 今回基準になるのは動画なので、動画の解像度に合わせて参照画像を padding します。
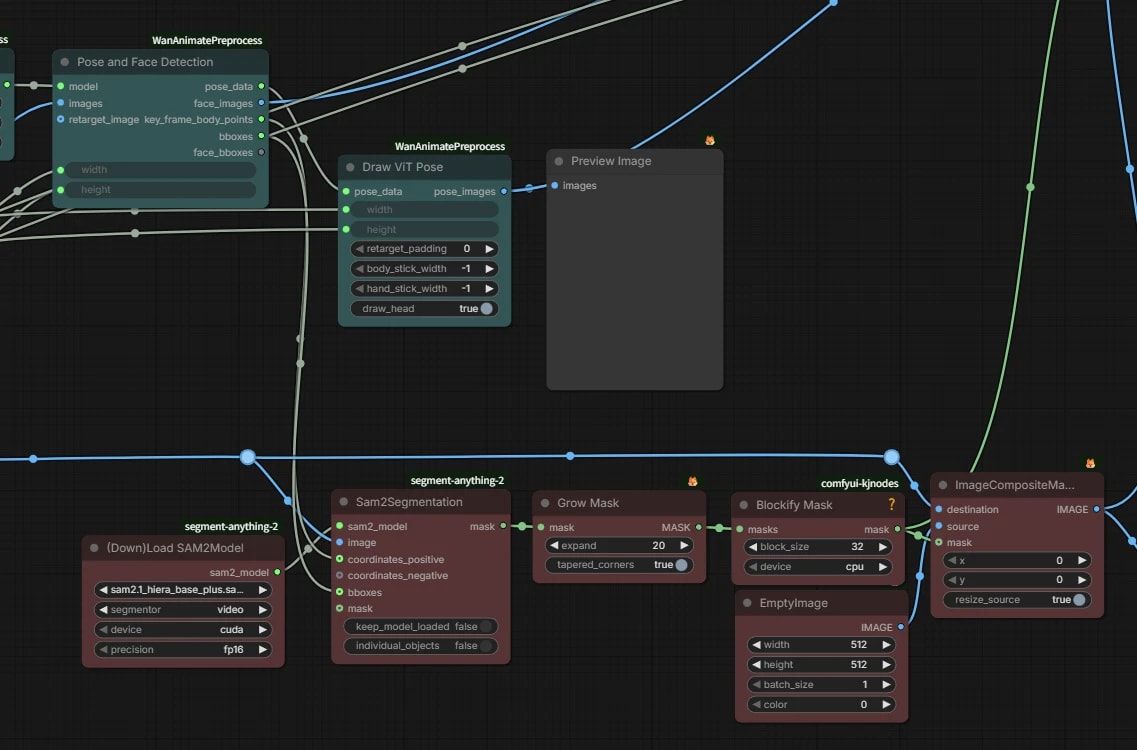
人物マスク生成
Pose and Face Detectionが取得した人物座標を SAM2.1 に渡してマスクを生成します。- マスクをやや大きめに膨張させ、
Blockifyノードでドット絵のようなカクカクしたマスクに変換してcharacter_maskにします。 これをしないとなぜか生成された動画の輪郭に細い縁が残ります。 ImageCompositeMaskedでマスクした部分を黒で塗りつぶした動画をbackground_videoとして使います。
6ステップ推論(Lightx2v LoRA)
蒸留 LoRA を使って、サンプリングステップを 4〜6 steps まで減らすことができます。
text2video で使うと劣化が気になりましたが、Wan-Animate では 0 から動画を作るわけではないため、あまり気になりません。積極的に活用していきたいところです。
モデルのダウンロード
📂ComfyUI/
└── 📂models/
    └── 📂loras/
        └── Wan21_I2V_14B_lightx2v_cfg_step_distill_lora_rank64.safetensors
Animationモード(高速版)
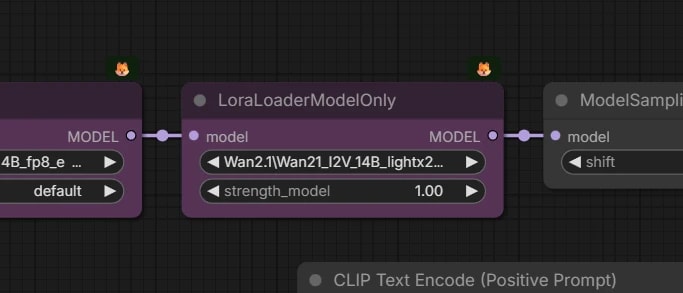
LoRA の適用
-
🟪
LoraLoaderModelOnlyで Lightx2v LoRA を読み込みます。 -
KSampler の設定
steps… 4〜6cfg… 1.0
Replacementモード(高速版)
長尺動画のために処理を繰り返す
Wan-Animate のベースは Wan2.1 I2V と同様で、1 回の推論で生成できるのは 77 フレーム が上限です。 これを超える長尺動画を作る場合は、「最後の数フレームを引き継ぎながら何回も生成を繰り返す」構成にします。
ComfyUI ではループ処理ができないため、ほぼ同じ workflow を後ろへ後ろへ直列につなぐ形になります。
ここは正直スマートな処理とはいえず、Kijai さんの ComfyUI-WanVideoWrapper での実装に一歩譲る部分です。
Animationモード(リピート)
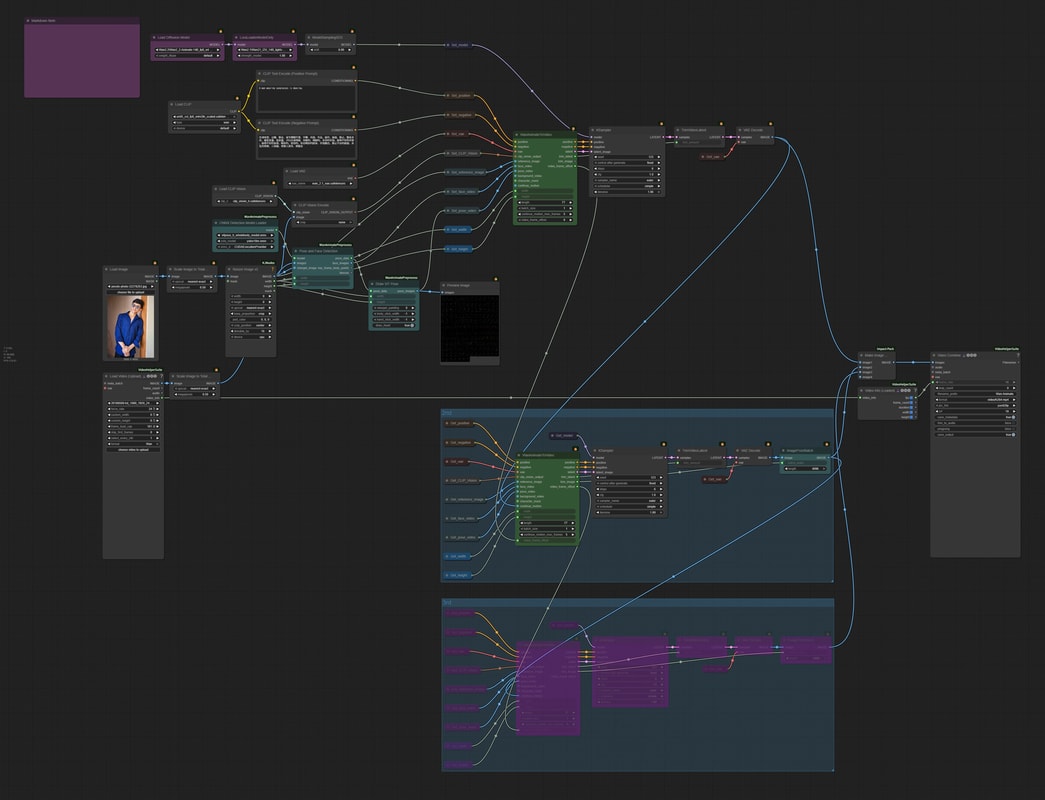
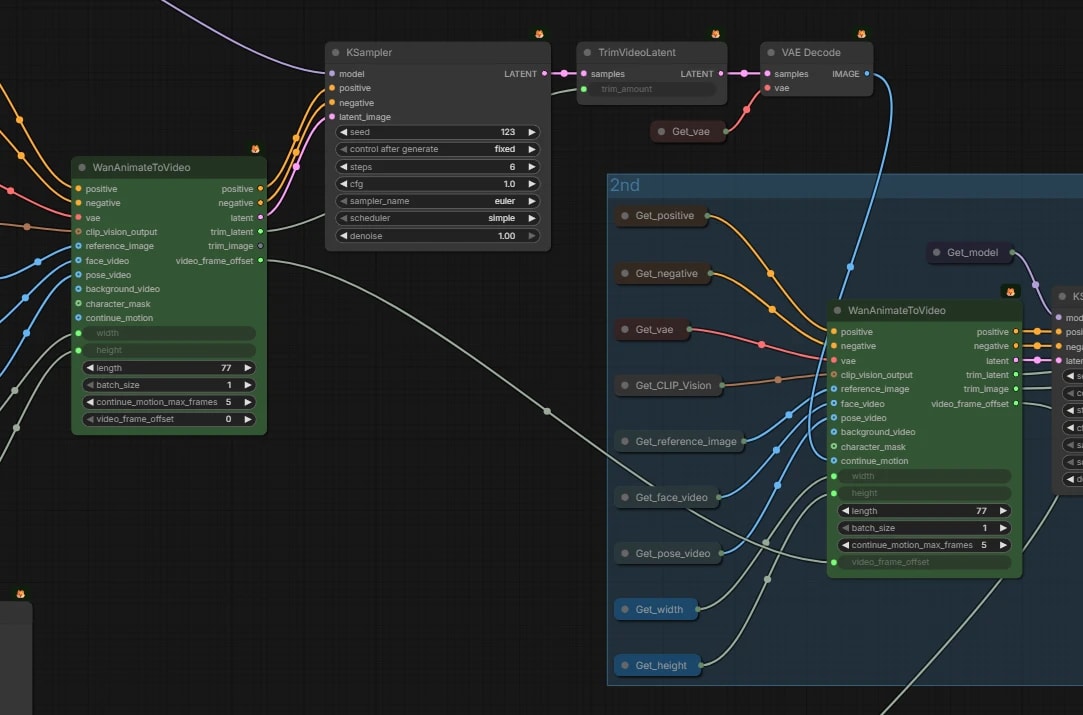
ぱっと見は莫大な workflow に見えますが、これまでのものと違う点は次の 2 点だけです。
-
video_frame_offset- 1 回目で 77 フレーム生成した場合、2 回目では
face_videoやpose_videoを 78 フレーム目以降から使う必要があります。 video_frame_offsetにオフセットフレーム数を入れると、face_video/pose_videoの参照開始位置を自動でずらしてくれます。
- 1 回目で 77 フレーム生成した場合、2 回目では
-
continue_motion_max_frames- のりしろとなるフレーム数を設定します。
- 例えば
lengthを 77、continue_motion_max_framesを 5 にすると、前回の最後の 5 フレームを使い、残り 72 フレームを新しく生成します。
このグループを繰り返しつないでいけば、理論上はいくらでも長い動画を作ることができます。 ただしコピー機と同じで、少しずつ誤差は蓄積されていきます。
Replacementモード(リピート)