
物体検出とは?
物体検出(Object Detection)は、画像の中から「何が写っているか(クラス)」「どこにあるか(位置)」を見つけるタスクです。
一般的には、物体ごとにバウンディングボックス(長方形)とラベルを出力します。
ComfyUI では、もっぱらマスク生成の入口として使います。 画像の中から犬を検出して消したり、顔だけ検出してリファインしたり… とにかく出番が多い技術ですね。
代表的な手法
本来の物体検出の世界ではいろいろな系統がありますが、ComfyUI 目線だと以下が代表的です。
YOLO 系
特定の物体(車、人、犬など)を検出するための、伝統的かつ強力なモデル群です。
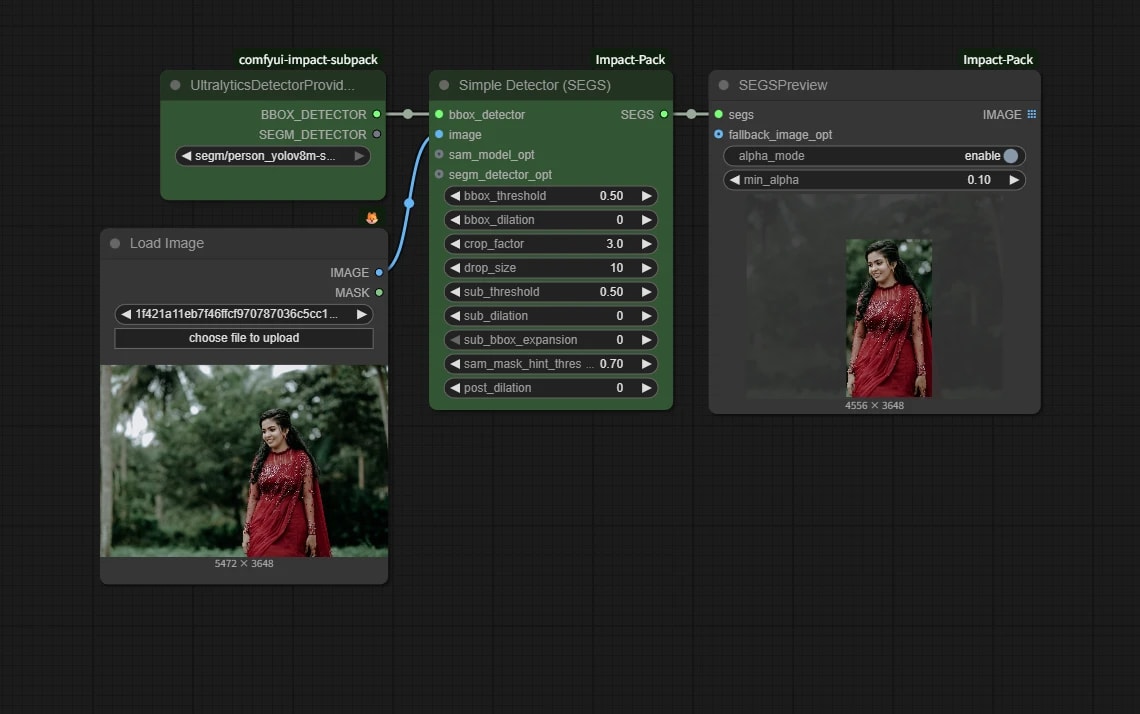
- 圧倒的に高速で、リアルタイム処理に使われるほど軽いです。
- 「人」「車」など、あらかじめ決めたクラス集合に対して学習しておき、その中から検出するです。
- モデルが無い場合は、自分で学習する必要があります。
DETR 系
CNN ではなく Transformer を使った検出モデルです。
ComfyUI で直接扱う機会はほとんどありませんが、物体検出の文脈で名前だけ見かけることはあると思います。
テキストでの物体検出
上の検出器は、あらかじめ決めたクラスしか検出できないため、人や車といった代表的なもの以外を検出しようとすると途端に使いづらくなります。
ComfyUI 的に重要なのは、テキストで物体を指定できるタイプ の検出です。
Grounding DINO
- 画像エンコーダ+テキストエンコーダで画像とテキストの特徴を対応付けるモデルです。
- 「red car」「traffic light」など、プロンプト(テキスト)で指示したものを何でも検出できます。
Florence-2
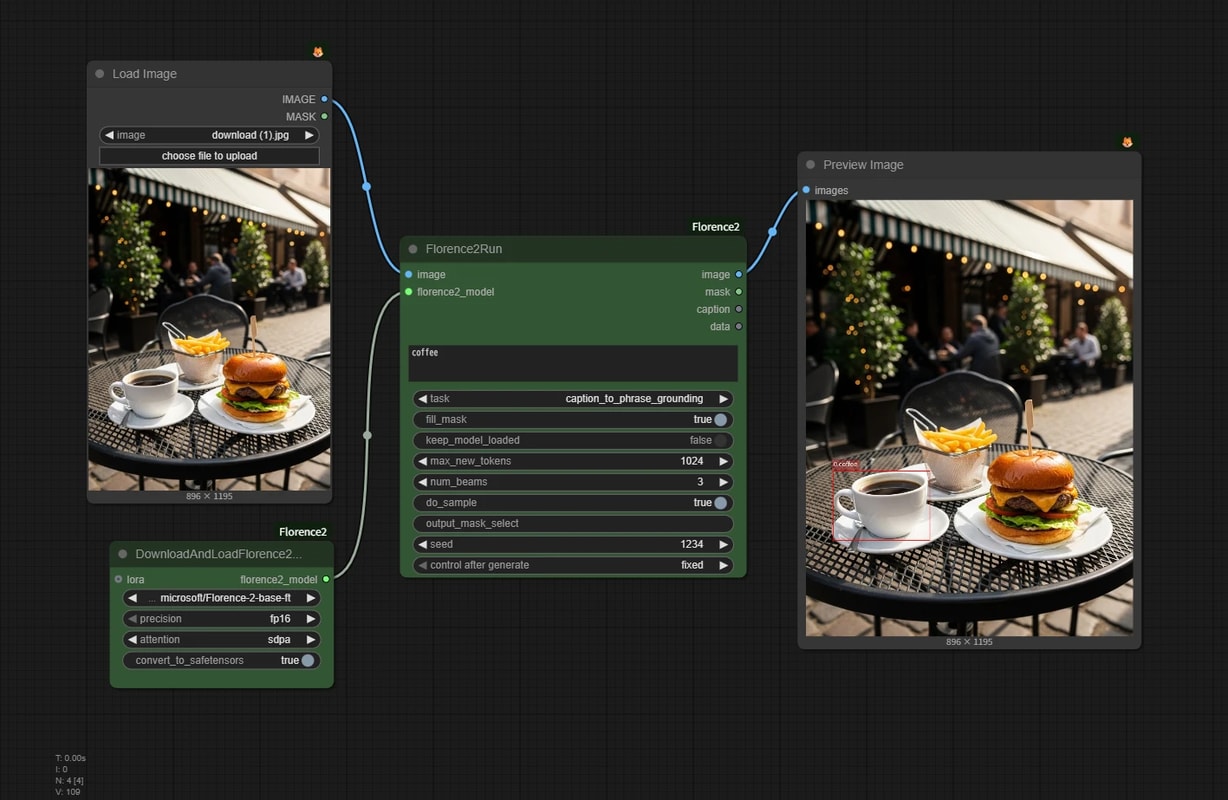
- 画像を見てキャプション生成・物体検出・セグメンテーションなど、1 つのモデルで何役もこなす汎用的な VLM です。
- LLM に近い構造を持つため、Grounding DINO よりも複雑な文章で指示できるのが強みです。
ComfyUI での使いどころ(マスク生成として)
ComfyUIでは、物体検出はほぼ マスク生成の入口 として使います。
とはいえ、物体検出モデルから出力されるのは BBOX(長方形)だけです。
これだけでも inpainting によるオブジェクト除去などには役立ちますが、例えば人を検出したとき、そのほとんどの領域が背景で、マスクとして使うには少し無駄が多いですね。
そのため、これらの検出結果は単体で使うのではなく、後段のマッティングやセグメンテーションと併用することが多いです。次はそれらを見ていきましょう。