Wan2.1 VACEとは?
Wan2.1 VACE は、Wan2.1 の動画生成における編集用モデルです。
動画版の ControlNet と inpainting / outpainting / reference2video を 1 つのノード(WanVaceToVideo)にまとめたような機能を持っています。
- 既存動画に対して、ポーズや深度マップで「動きだけ」コントロールする
- reference 画像を元に、キャラを入れ替えたりスタイルを寄せる
- 特定の領域だけ inpainting / outpainting する
- 動画の続きを生成(Extension)したり、ループ・中割りを作る
といったことを、Wan2.1 の生成品質のまま扱うことができます。
推奨設定
- 推奨解像度
- 720p 前後、かつ 16 の倍数
- 最大フレーム数
- 81 フレーム
モデルのダウンロード
Wan2.1 VACE 用には、通常の T2V モデルとは別の VACE 専用 diffusion model を使います。 ここでは 14B のみ扱います。
- diffusion_models
- text encoder
- VAE
- gguf(任意)
📂ComfyUI/
└── 📂models/
    ├── 📂diffusion_models/
    │   └── wan2.1_vace_14B_fp16.safetensors
    ├── 📂text_encoders/
    │   └── umt5_xxl_fp8_e4m3fn_scaled.safetensors
    ├── 📂unet/
    │   └── Wan2.1_14B_VACE-XXXX.gguf   ← gguf を使う場合のみ
    └── 📂vae/
        └── wan_2.1_vae.safetensors
基本構造
どのパターンでも Wan2.1 text2video をベースに、WanVaceToVideo ノードを追加した形が基本になります。
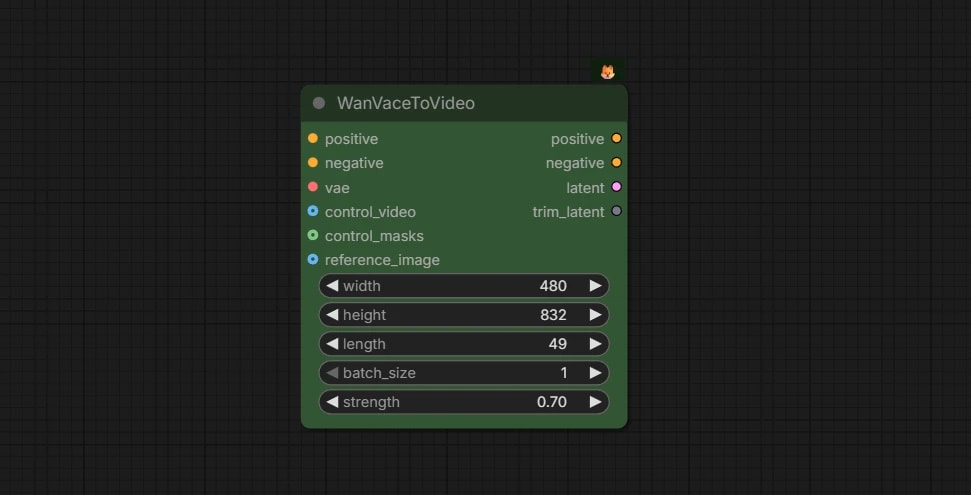
control_video- ポーズ・深度マップ・scribble・optical_flow・layout などの「ガイド動画」
control_masks- inpainting 用のマスク
reference_image- キャラやスタイルを転送したい参照画像
ControlNet的な使い方
ポーズや深度マップなどを使って、動画の動きをコントロールします。
Deep diveControlNet的な使い方
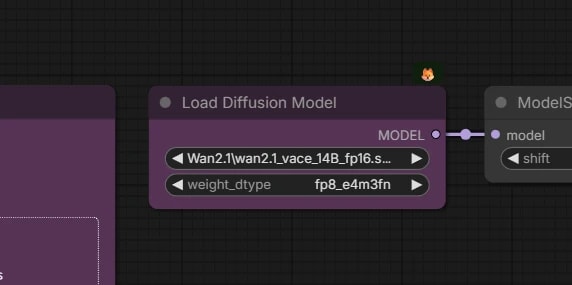
Wan2.1 VACE モデルを読み込む
Load Diffusion Modelでwan2.1_vace_14B_fp16.safetensorsを読み込みます。- そのままでは VRAM をかなり使うため、
dtypeをfp8_e4m3fnに切り替えて、VRAM の使用量を削減します。
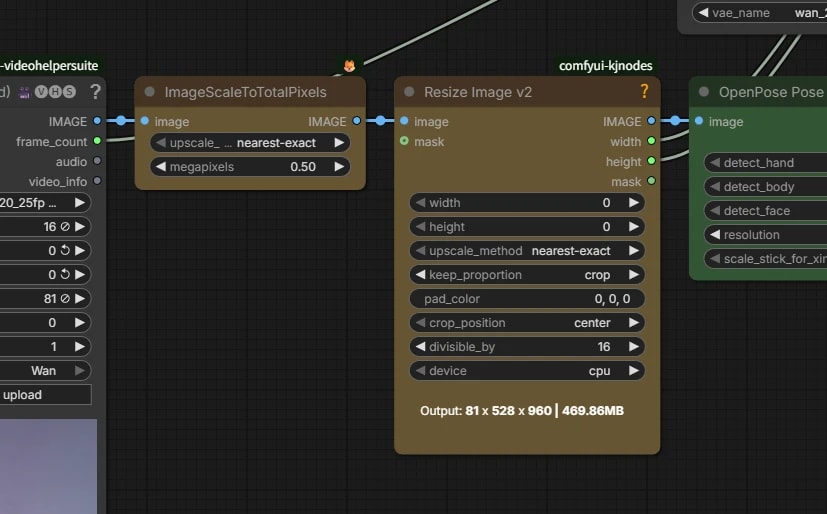
動画のリサイズ
ImageScaleToTotalPixelsで適度なサイズに縮小します。- Wan は 720p(1MP)まで生成できますが、私のPCでは VRAM が足りないため 0.5MP にしています。
Resize Image v2で 16 の倍数になるようにクロップします。- このノードだけで 0.5MP に揃えることもできますが、処理の意図を分けるために二段構成にしています。
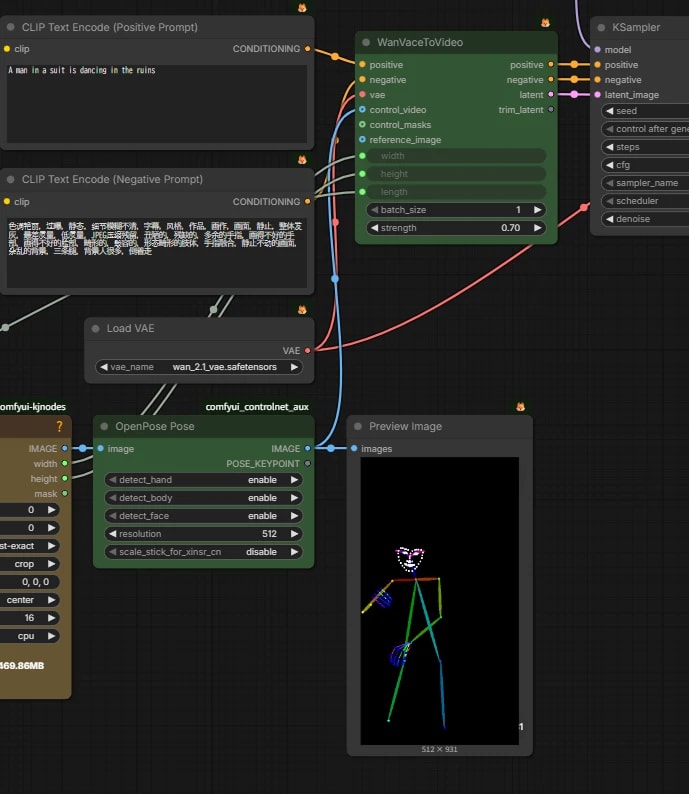
control_video の作成と入力
OpenPose Poseで動画から棒人間のポーズ動画を作ります。- それを
WanVaceToVideoのcontrol_videoに入力します。
reference2video
reference 画像のキャラやスタイルを、動画に転送します。
Deep divereference2video
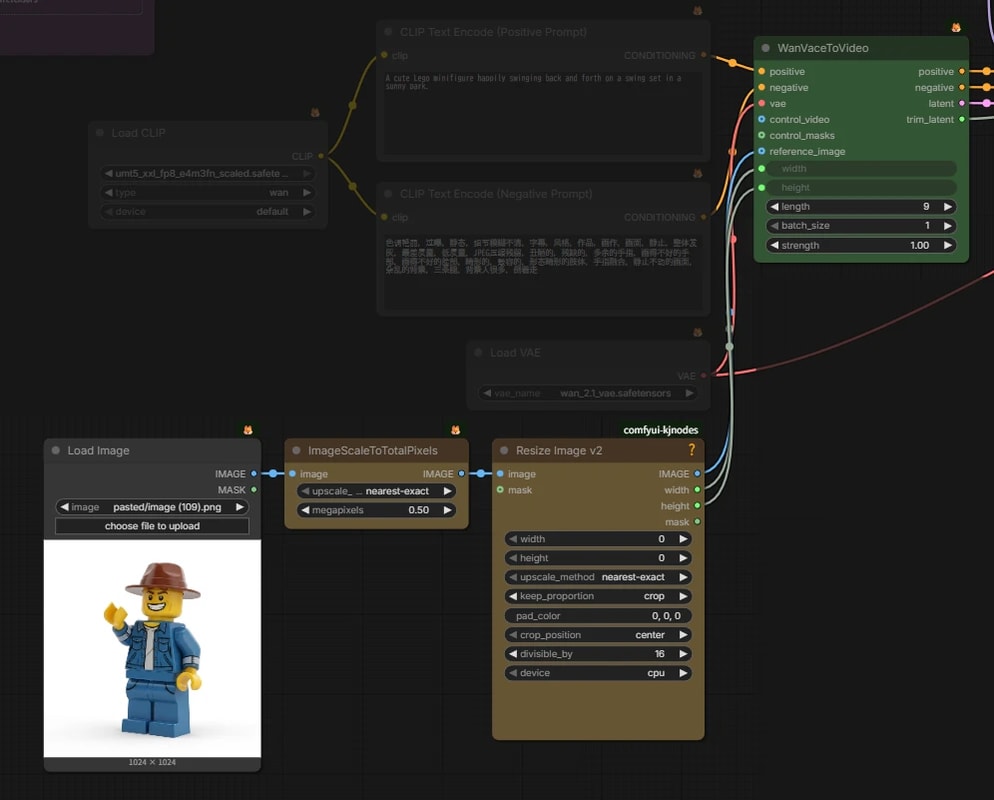
参照画像の下処理・入力
WanVaceToVideoのreference_imageに、キャラ画像やイラストを入力します。- 背景を切り抜いて白で埋めた画像を使うと安定しやすいです。
- reference2video と言いながら、仕組み上、参照画像の位置関係をそのまま受け継ぎます。
- そのため、生成する動画のサイズと参照画像は同じであったほうが良く、キャラの位置や大きさも、最終的に置きたい位置に近づけておくといった前処理が重要になります。
初期フレームカット
- reference2video では、最初の数フレームに「参照画像+生成結果が重なったフレーム」が出力されます。
- これが VACE が参照画像を使用できる仕組みそのものなのですが、この部分は必要ありません。
- 🟥
TrimVideoLatentで、初期フレームを latent の段階でカットしてから動画を書き出します。
空間的な inpainting
動画の一部分だけを差し替えます。
Deep dive空間的な inpainting
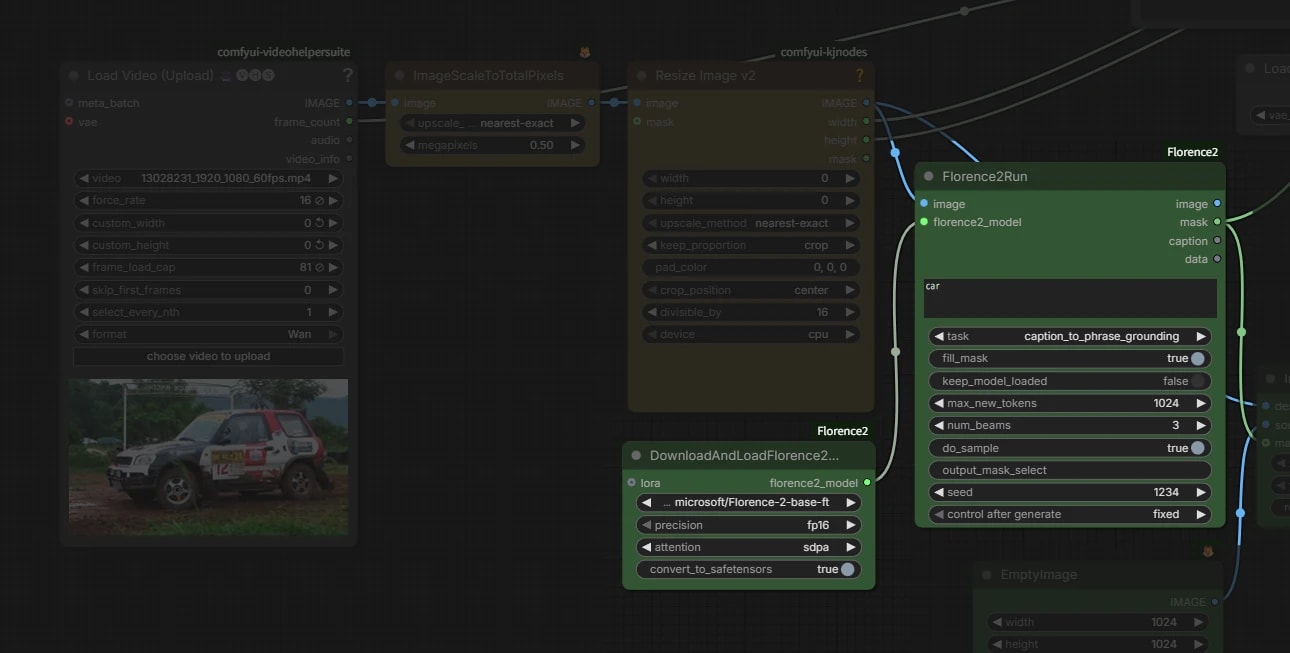
マスク生成
- 好きな方法でマスクを作成してください。
- この workflow では
Florence-2でクルマを検出し、その BBOX をそのままマスクとして使っています。
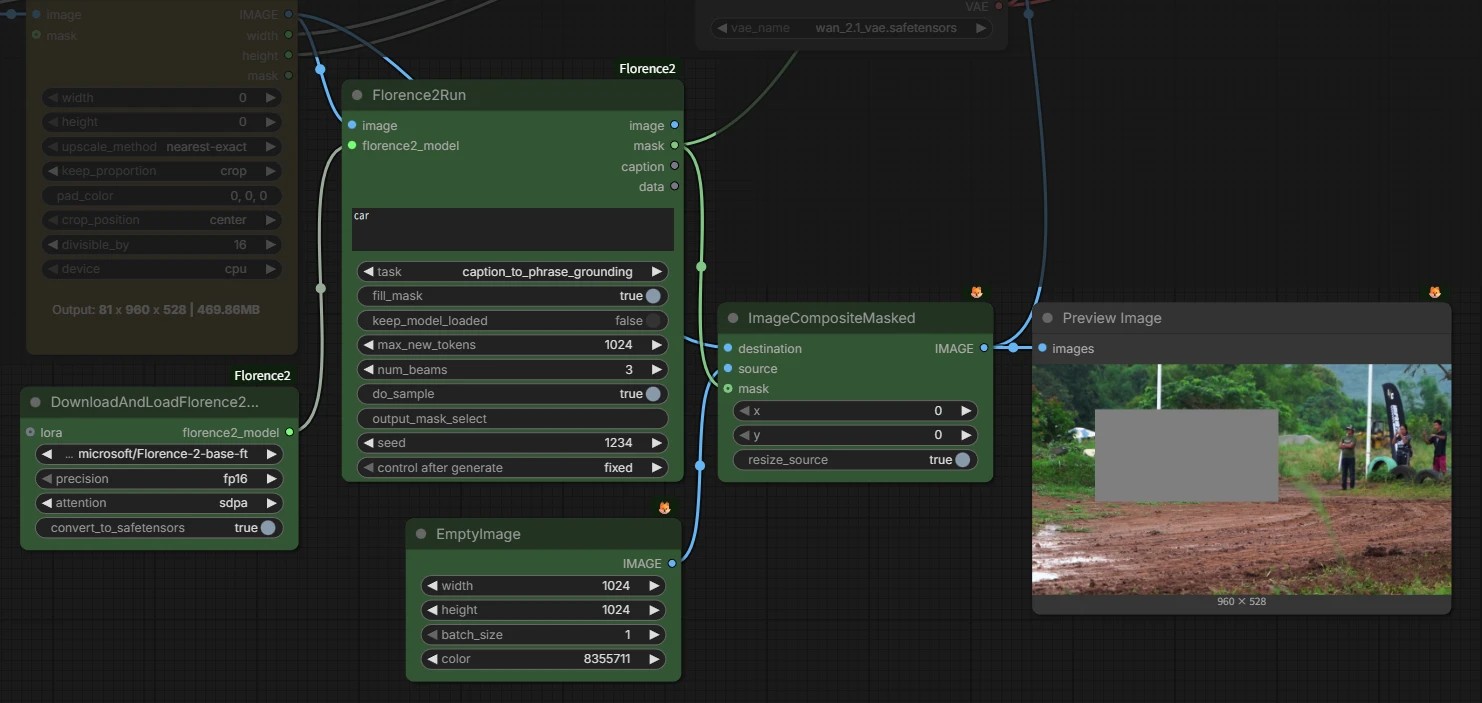
control_video の作成
control_videoには、マスク部分を灰色(RGB 127,127,127)で埋めた動画 を使用します。ImageCompositeMaskedでマスク部分を灰色で塗りつぶします。WanVaceToVideoノードに、作成したcontrol_videoとマスクを入力します。
時間的な outpainting(Extension)
動画の「時間方向」を伸ばすのが Extension です。 入力動画の一部フレームだけを使い、その先を VACE に補完してもらいます。
- この workflow では、入力動画の最後 5 フレームを元に、その先の 72 フレーム(81 - 5)を生成しています。
Deep dive時間的な outpainting(Extension)
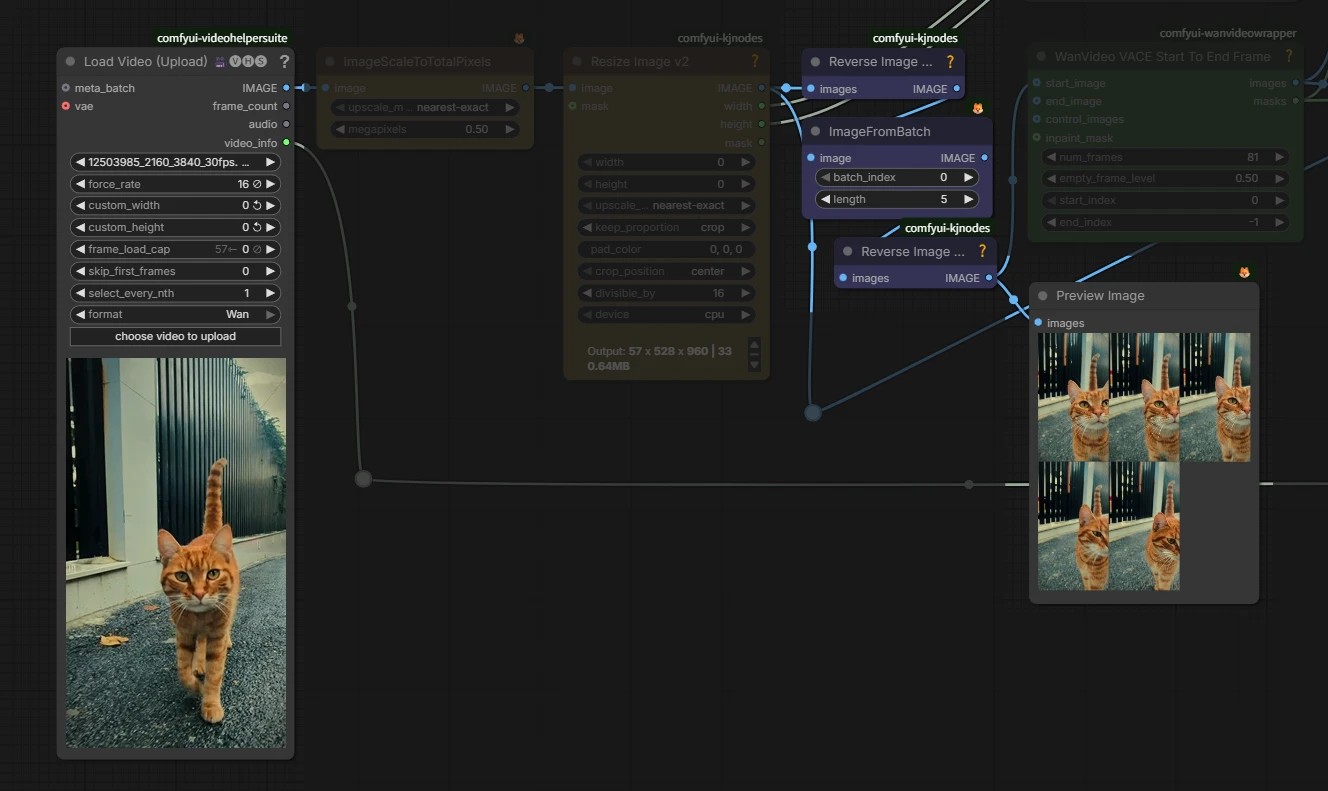
最後 5 フレームの取得
- 入力動画を一度逆転し、先頭から 5 フレームだけ抜き出します。
- その 5 フレームだけのバッチを、再度逆転して「元動画のラスト 5 フレーム」として使います。
- もう少しスマートなノードが欲しいところですが、現状はこの手順しかありません。
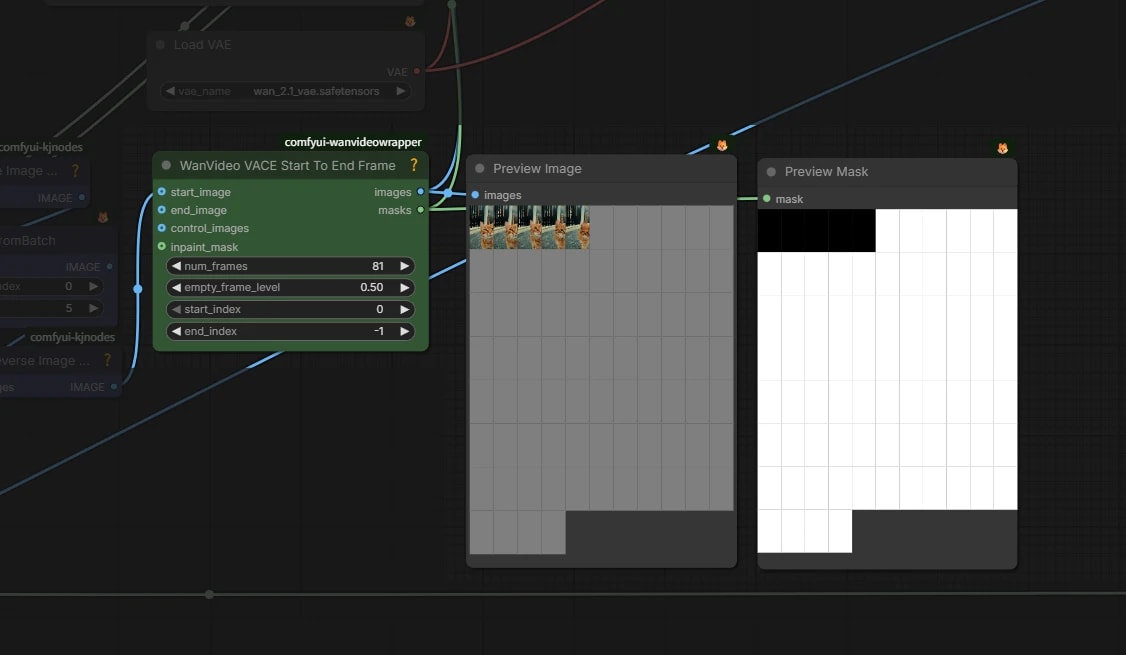
control_video とマスクの作成
- Extension を時間的な in/outpainting と表現しましたが、実際、先程の空間的な inpainting の workflow に似ています。
- 生成したいフレーム数(ここでは 72 フレーム)分の灰色画像と、その全域を覆うマスクを作ります。
- この区間を丸ごと inpainting するイメージです。
- これを
WanVideo VACE Start To End Frame(kijai/ComfyUI-WanVideoWrapper) で作り、WanVaceToVideo に渡します。- コアノードだけでも構成できますが、ノード数が跳ね上がるので、ここは素直に Wrapper ノードに頼ったほうが良いと思います。
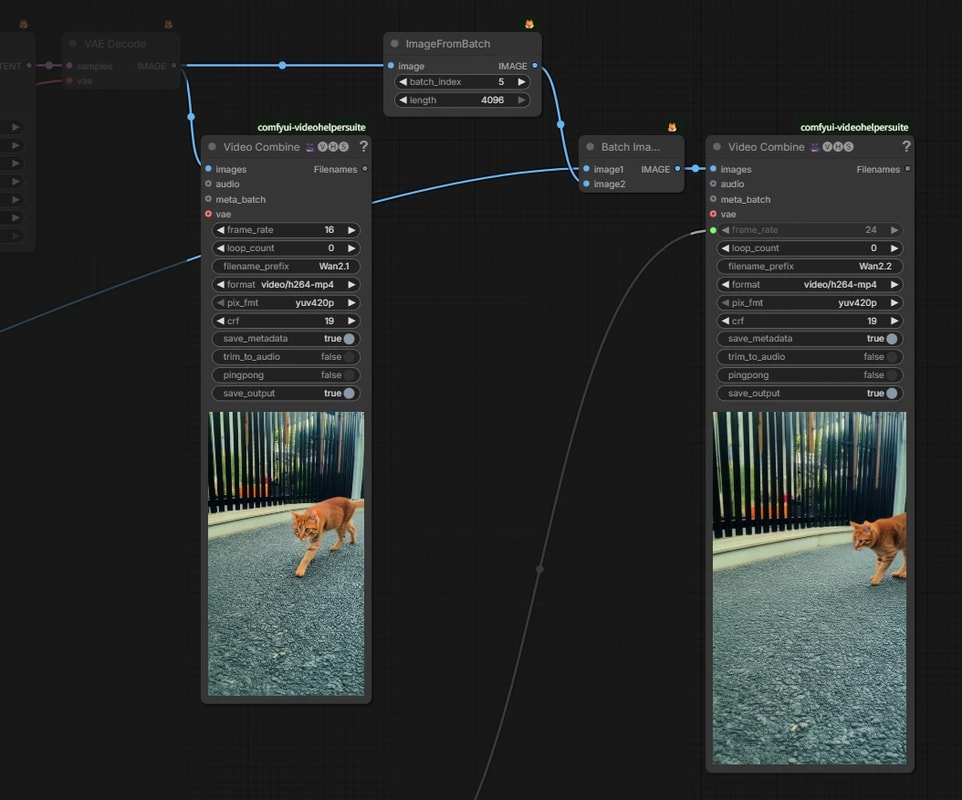
生成動画と元動画をつなげる
- 生成動画は「元動画 5 フレーム + 生成した 72 フレーム」です。
- このまま元動画と繋げてしまうと 5 フレーム重複してしまいます。
- そのため
ImageFromBatchノードで最初の 5 フレームを切り捨ててから、元動画の後ろに接続します。
動画のループ化
動画の最後の数フレームと、最初の数フレームを抽出し、最後 → 最初 につながるようにすればループ動画が作れます。 これまでも FLF2V を使えば作れましたが、VACE では複数のフレームを入力として使えるため、動画の流れを受け継いだような挙動に出来るのが面白いところです。
- 上の Extension に加えて、最初から 5 フレーム も取得します。
- それを
WanVideo VACE Start To End Frameのend_imageに入力します。 - 効果があるかはケースバイケースですが、1 フレーム目を抽出して
reference_imageとしても使っています。