Florence-2とは?
画像を見てキャプション生成・物体検出・セグメンテーション・OCR など、1つのモデルでいくつものタスクをこなせる汎用 VLM(Visual Language Model)です。
このページでは、ComfyUI でよく使う「キャプション生成」「物体検出(座標抽出)」「OCR」「画像に関するQ&A」の4つに絞って扱います。
カスタムノード
- kijai/ComfyUI-Florence2
- モデルは最初の実行時に自動でダウンロードされます。
Florence2Run ノード
Florence2Run は、入力画像に対して Florence-2 にタスクを実行させるためのメインノードです。task を切り替えることで、キャプション生成や物体検出、OCR などの機能を使い分けることができます。
caption, detailed caption
画像から自然文のキャプションを生成します。
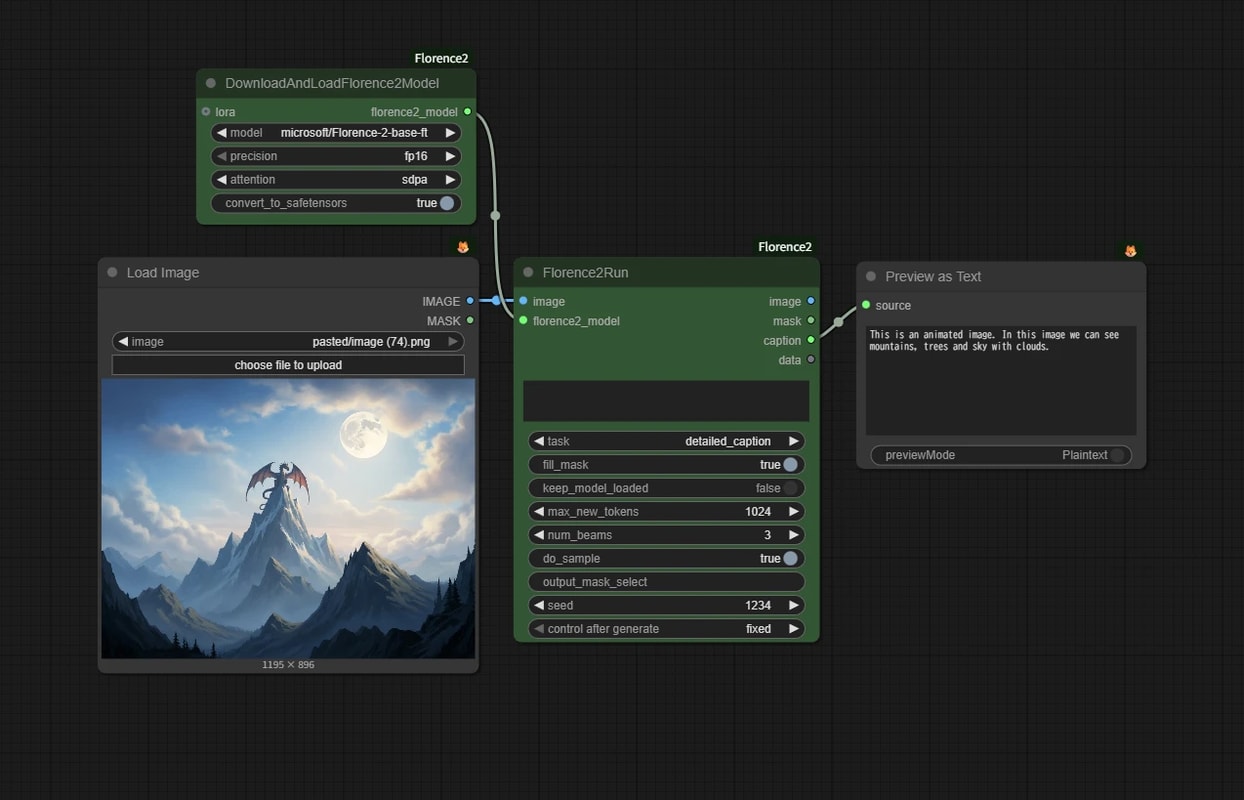
caption- 画像の概要をシンプルに説明します。
detailed caption- 構図や見た目をもう少し細かく説明します。
ただし、「プロンプト用のキャプション」だけが目的であれば、JoyCaption など、キャプション専用モデルを使ったほうが遥かに柔軟でクオリティの高いものが出てきます。
caption_to_phrase_grounding
指定したキャプションのフレーズごとに、物体の位置を矩形(バウンディングボックス)の形で出力します。
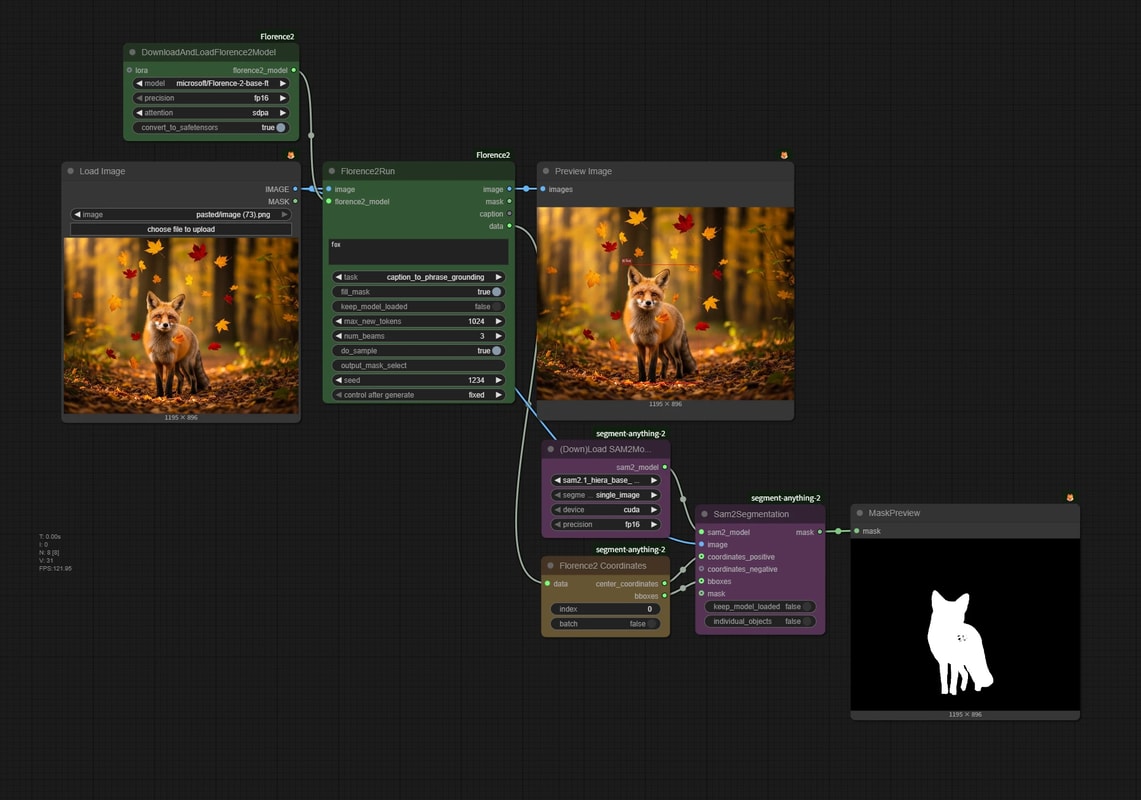
- 「left tree」「red car」など、少し複雑な指示でも位置を取れるのが特徴です。
- 🟨
Florence2 Coordinatesノードで座標を取り出し、SAM2 などのセグメンテーションモデルと組み合わせることで、特定の物体だけをマスク化するといった使い方ができます。
ocr
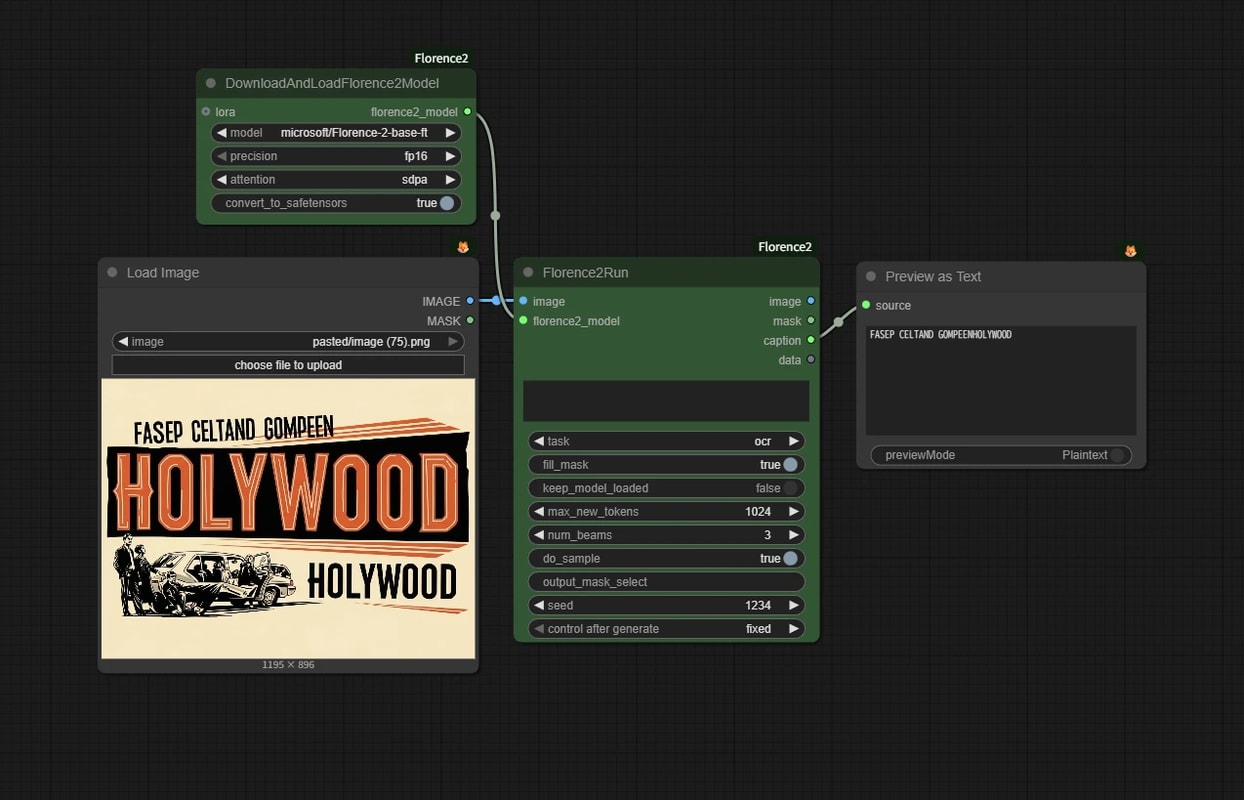
画像内の文字を読み取り、テキストとして出力します。
docvqa
画像についての質問に答えるタスクです。
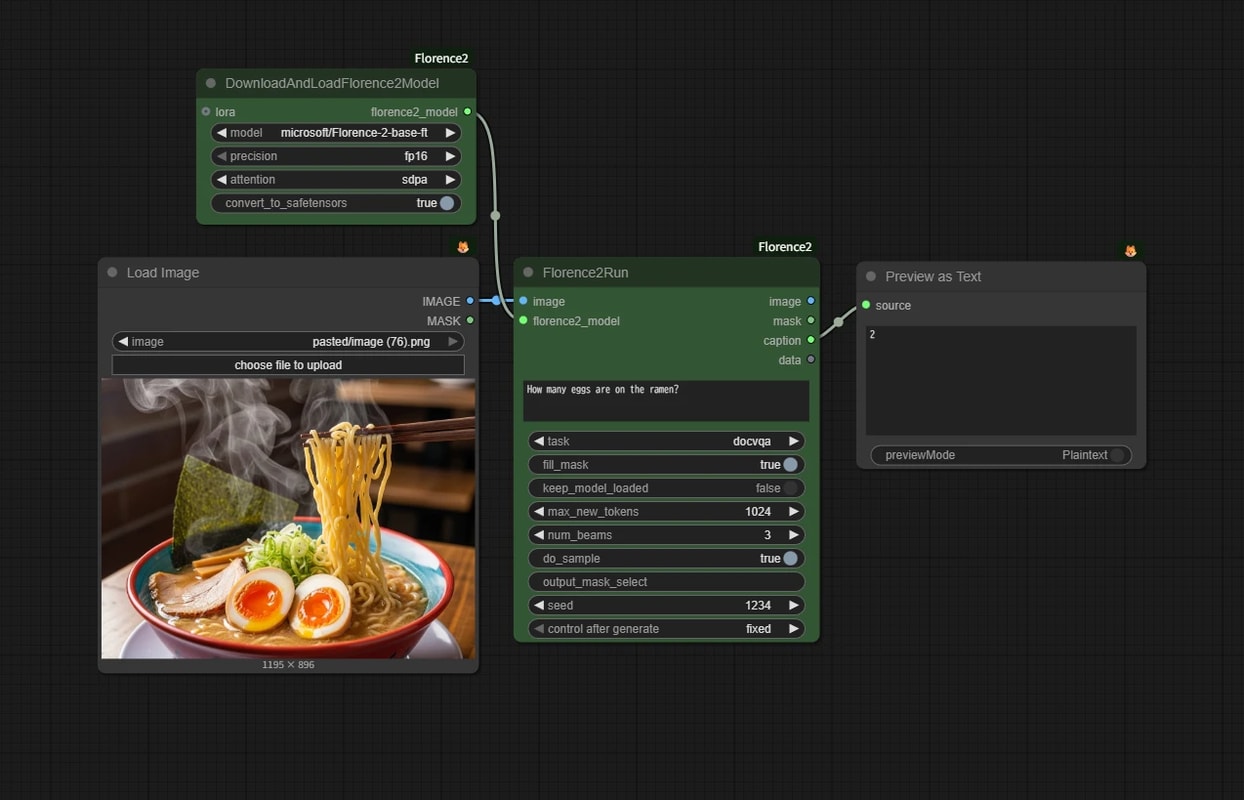
- 「この画像の中で○○はどこにあるか?」「この表の値は?」といった質問を投げて、回答をテキストで受け取ることができます。
- ChatGPT に画像を投げて質問するのと似た使い方のイメージです。