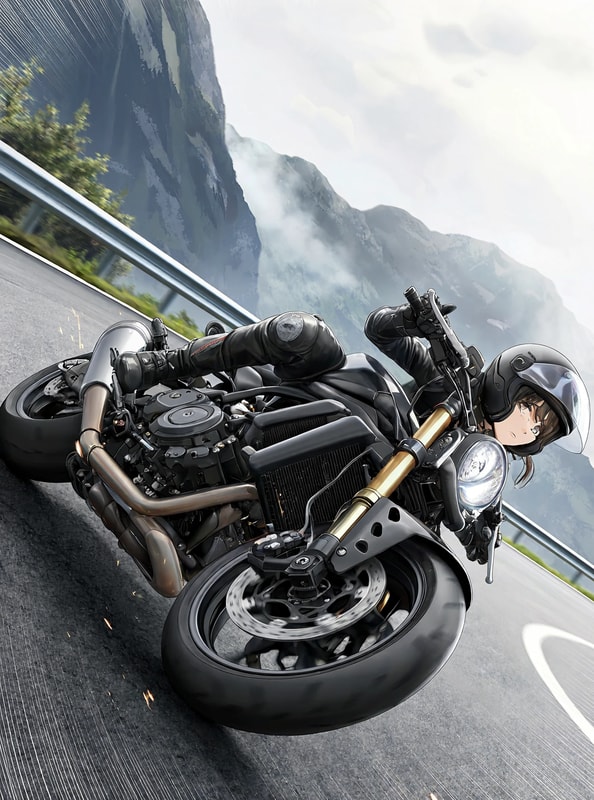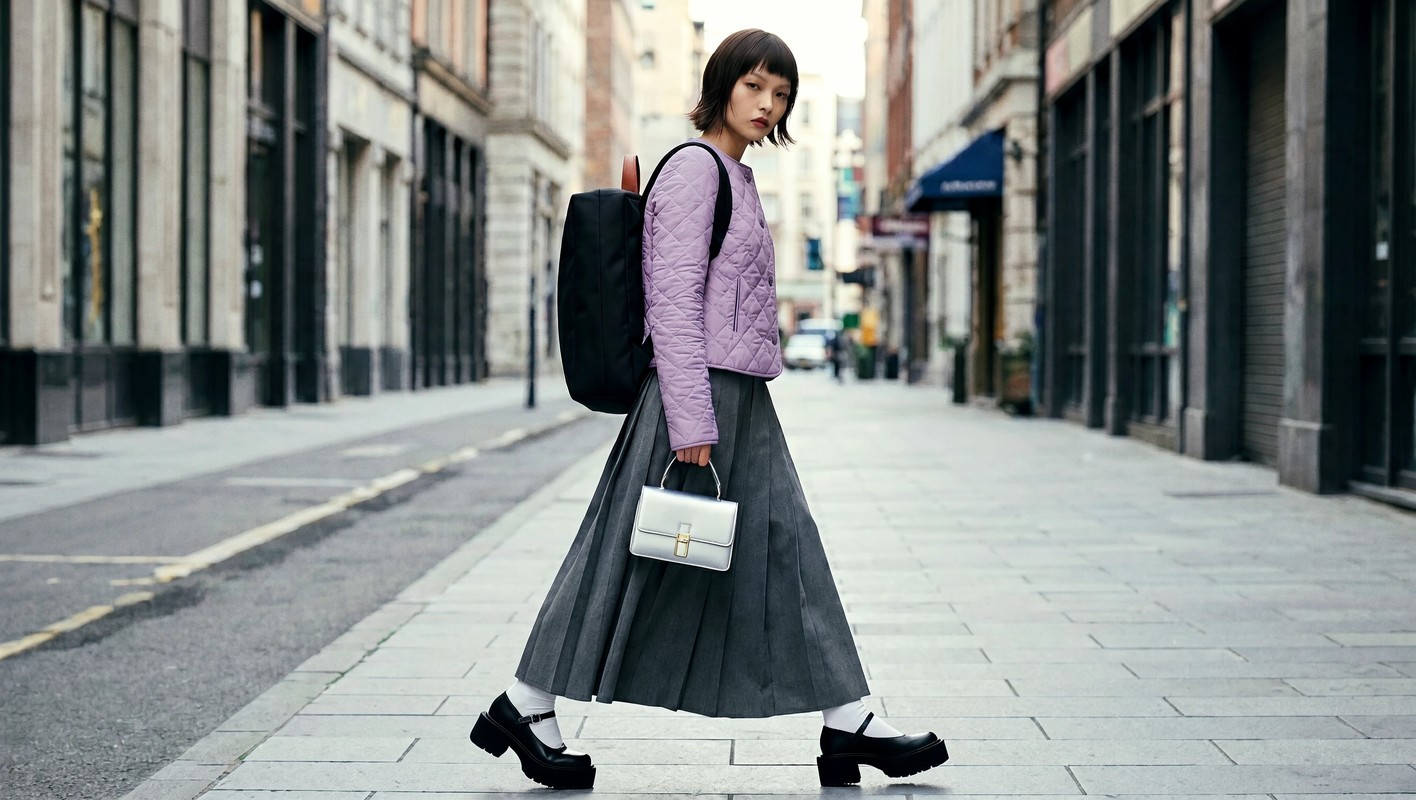
MiniMax H3 Imageとは?
MiniMax H3 Image は、MiniMax が公開した画像生成モデルです。
動画生成モデルの MiniMax H3 と同じ祖先から派生したもので、画像生成と画像編集を 1 つのモデルで扱えます。
特徴は 16 MP という超巨大なサイズを一発で生成できることで、6 ステップ蒸留も相まって、4 MP なら非常に高速に生成できます。
推奨設定値
- 解像度
- 4〜16 MP
- 1:1 なら 2048 × 2048 〜 4096 × 4096 px です
- 幅と高さは 32 の倍数にします
- 4〜16 MP
大きな解像度も生成できる、というよりは、大きな解像度でないとうまく生成できません。最低でも 4 MP 以上でないと崩れます。
モデルのダウンロード
- diffusion_models
- text_encoders
- vae
- minimax_h3_image_vae_fp16.safetensors (1.17 GB)
📂ComfyUI/
└── 📂models/
    ├── 📂diffusion_models/
    │   └── minimax_h3_image_pruned_int8_convrot.safetensors
    ├── 📂text_encoders/
    │   └── qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors
    └── 📂vae/
        └── minimax_h3_image_vae_fp16.safetensors
プロンプト
以下が MiniMax 公式のプロンプトガイドですが、動画の MiniMax H3 と比べると、それほどシビアなプロンプトは求められません。自分の言葉で詳しく伝えてください。
Ref2Image・画像編集
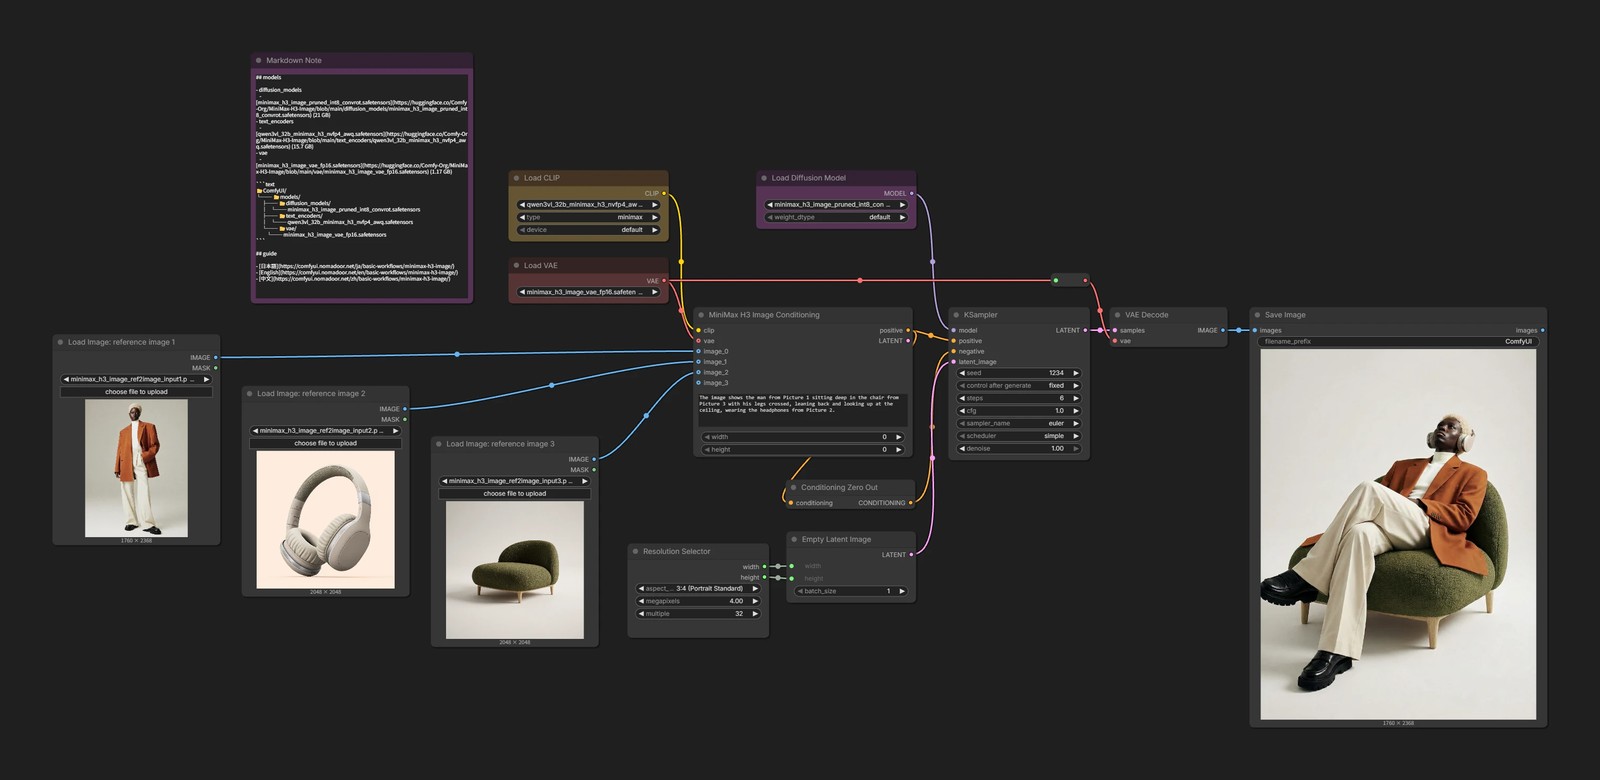
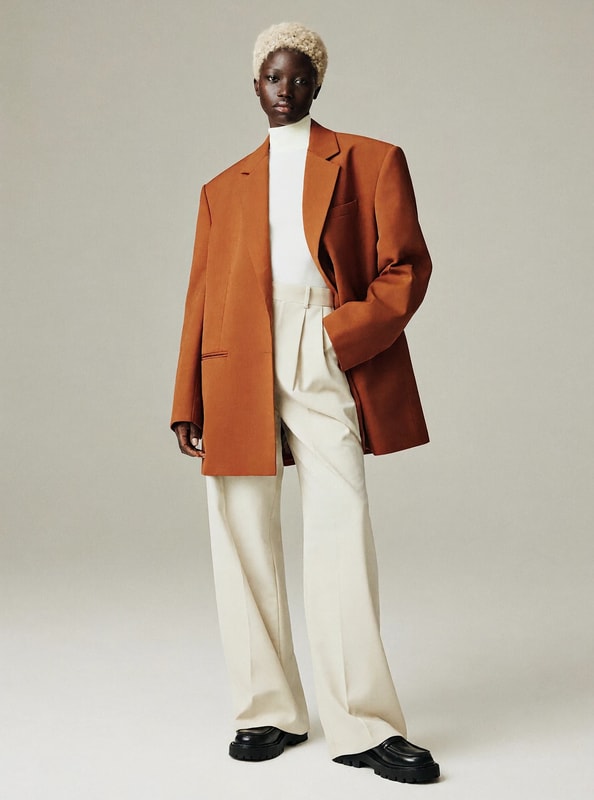
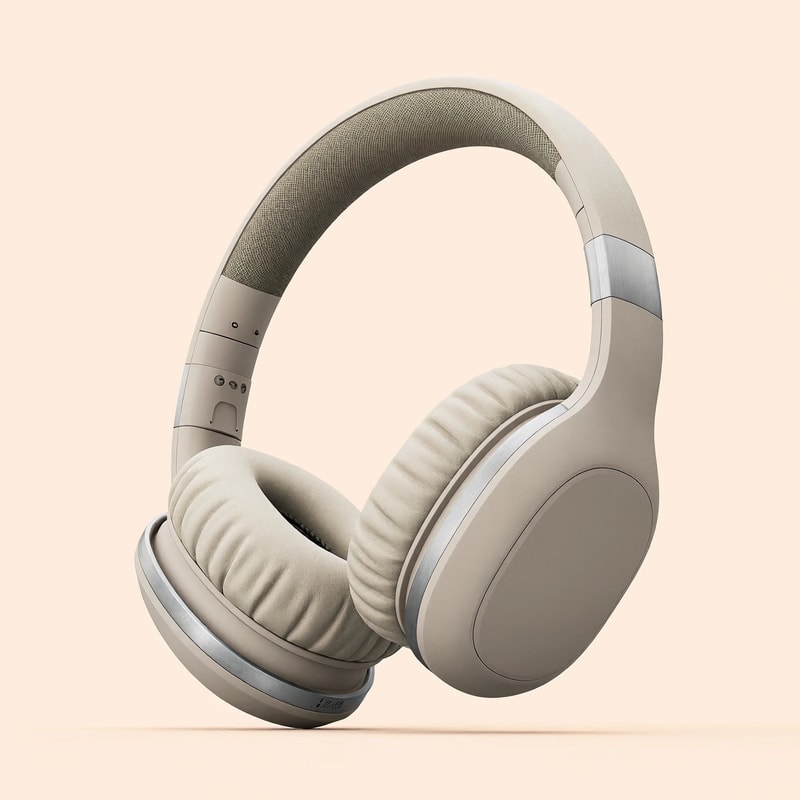
公式の書き方では <Subject 1> のように定義してから書く必要がありますが、試した限り、参照画像はつないだ順に Picture 1、Picture 2 と普通に書けば大丈夫です。
また、画像編集であっても、「〜に変えて」と指示の形で書くより、出来上がりの絵を描写したほうが安定するような気がします。
The image shows the man from Picture 1 sitting deep in the chair from Picture 3, wearing the headphones from Picture 2.
プロンプトエンハンスは、Qwen3.5 9B では処理時間がかかるわりにミスも多く、短い文でも十分に生成できたので使っていません。
text2image
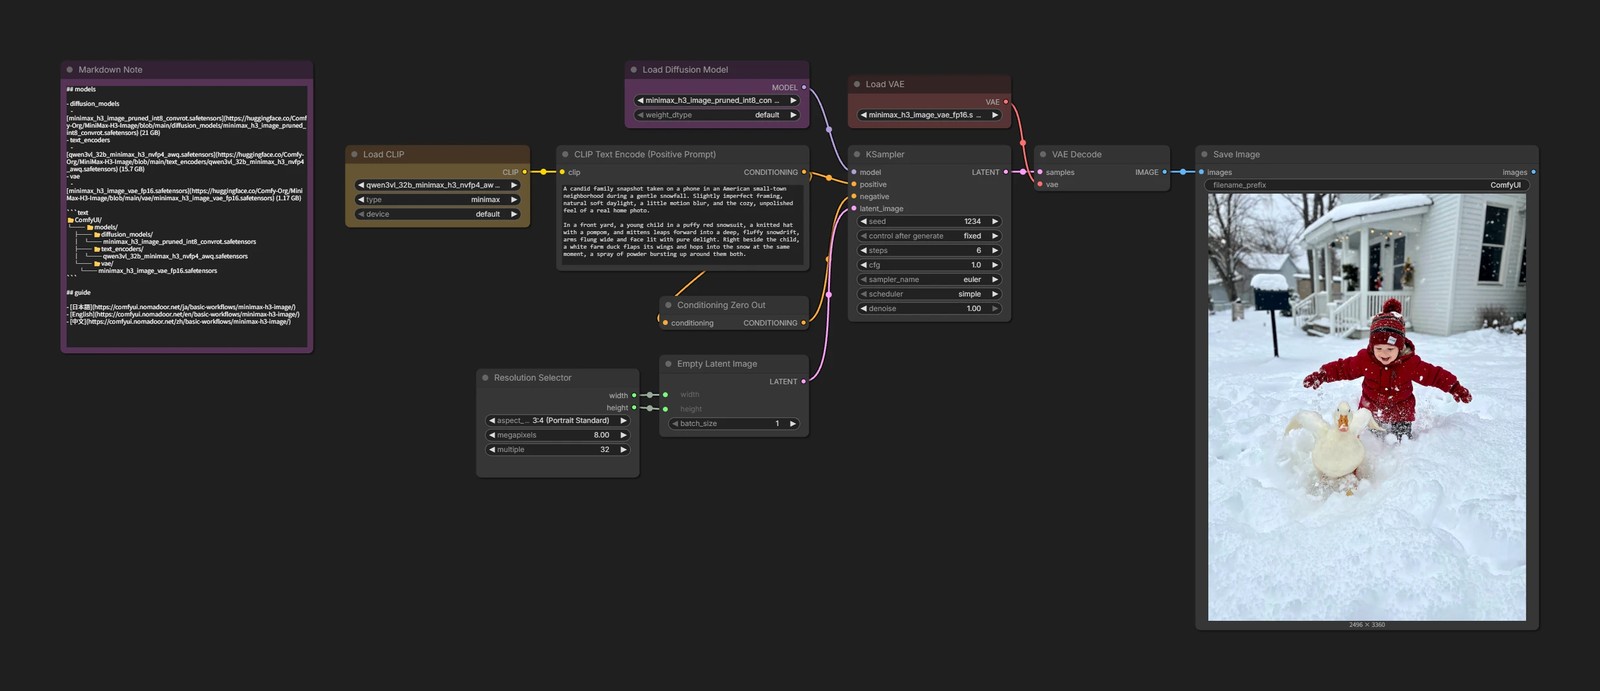
Outputs
Ref2Image
参照画像を組み合わせて、新しい画像を生成します。
参照画像は最大 16 枚まで使えます。
Outputs
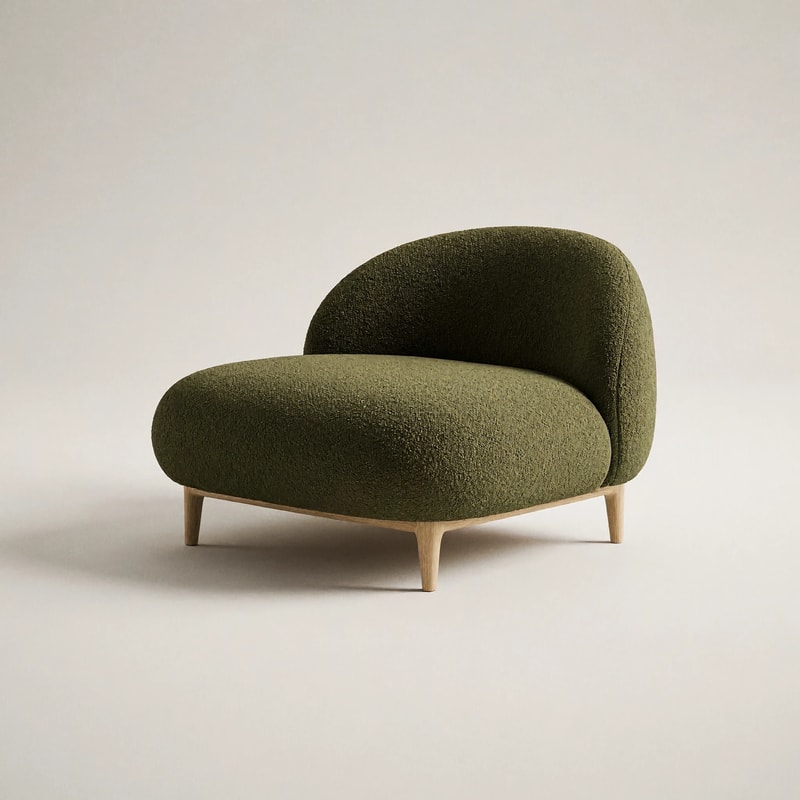
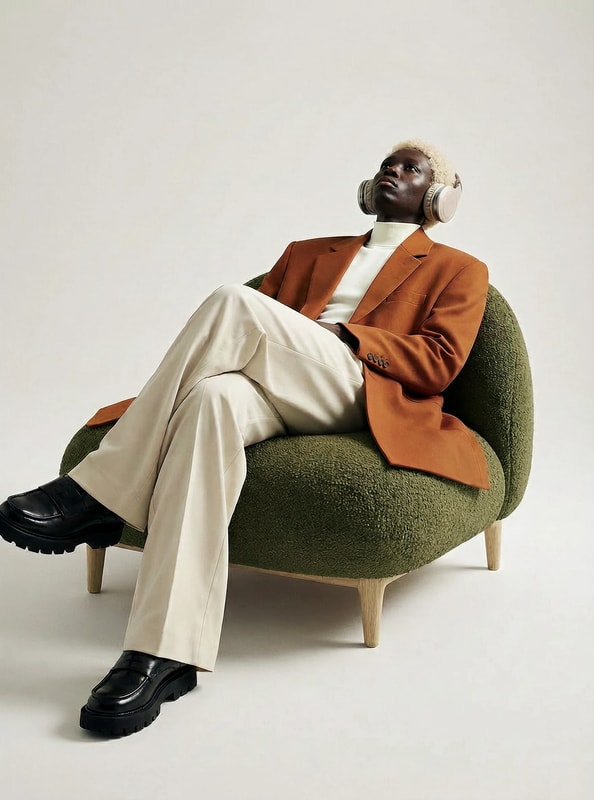
画像編集
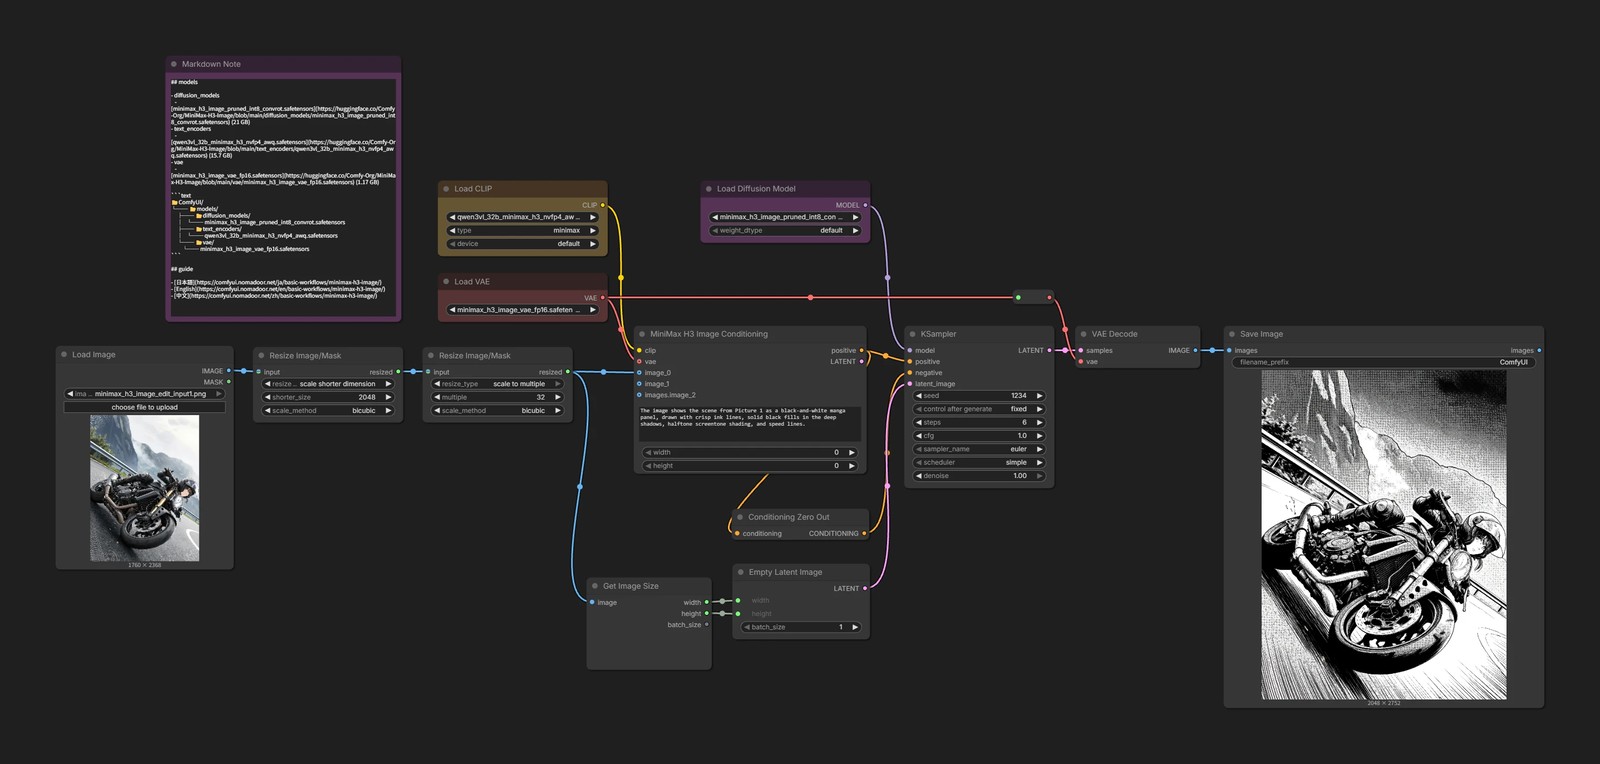
Resize Image/MaskMiniMax H3 Image Conditioningは、入力画像の短辺が 1024〜2048 px に収まるよう、内部で勝手にリサイズしてしまいます。- 入力と出力のサイズをぴったり揃えるため、先に短辺を 2048 px にしています。
全身の写真がアップに変わるなど、構図が勝手に変わってしまうことがあります。そのときは、変えたくないものもプロンプトに書いておきましょう。
The framing, pose, and background are the same as Picture 1.
Outputs