Hires.fixとは?
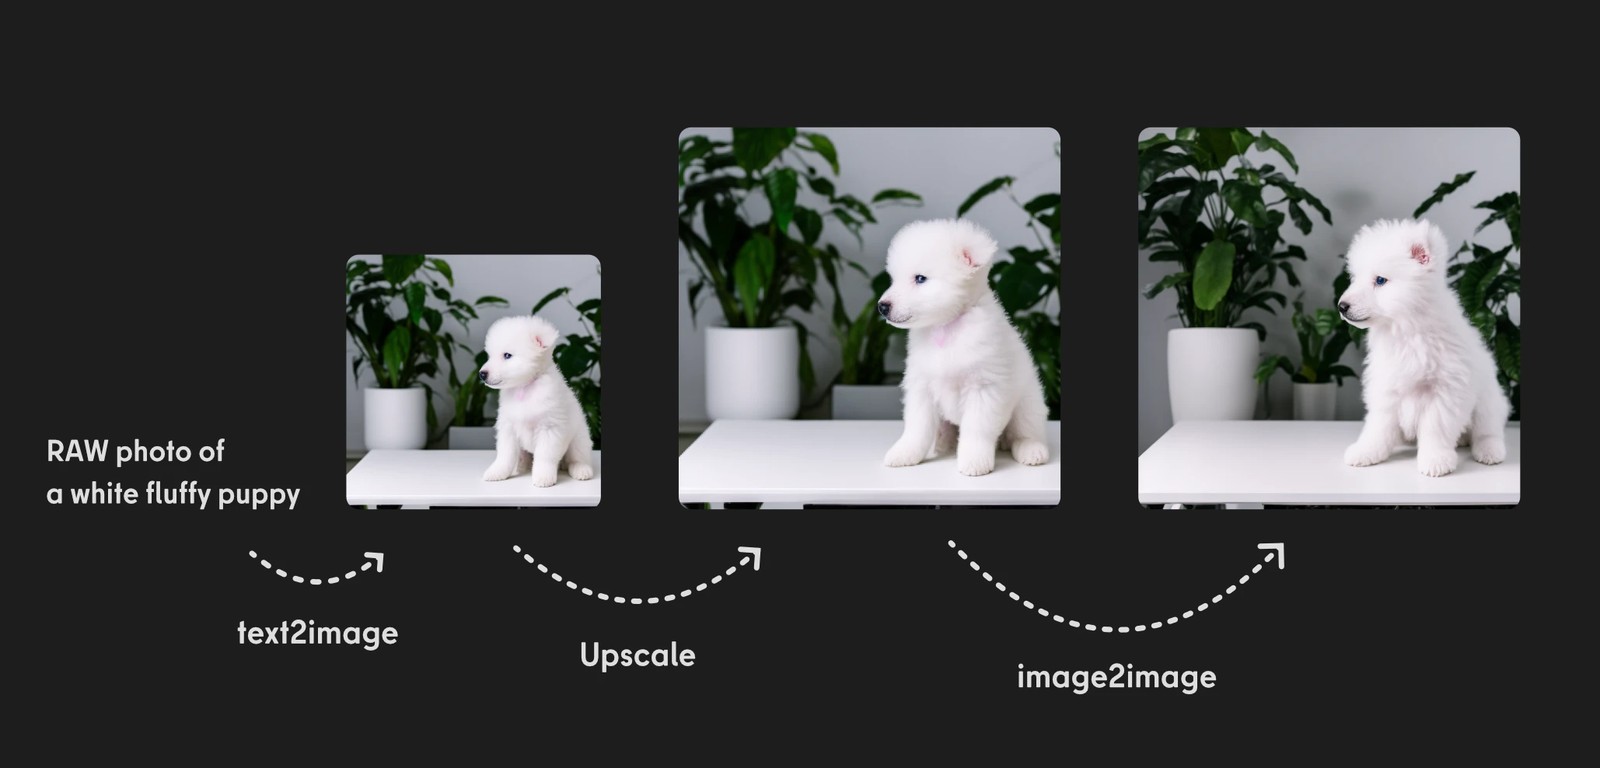
かっこいい名前ですが、やっていることはそこまで複雑ではありません。
まず text2image で画像を生成し、その画像を 1.5〜2 倍にリサイズします。
その拡大画像を image2image に入れて、もう一度描き直してもらう。
この手順をひとまとめにしただけのものです。
なぜこの手法が生まれたか?
Stable Diffusion 1.5 で推奨されていた解像度は 512 × 512px で、大きな画像は生成できませんでした。
ここには大きく 2 つの理由があります。
計算コストの問題
解像度が上がるほど、必要な VRAM と計算時間は一気に増えます。
画像生成が登場した当時は、いまほど最適化も進んでおらず、大きな画像をいきなり生成するのはかなり重い処理でした。
学習に使った画像サイズの問題
より本質的なのは、モデルが 「どのサイズの画像で学習されたか」 です。
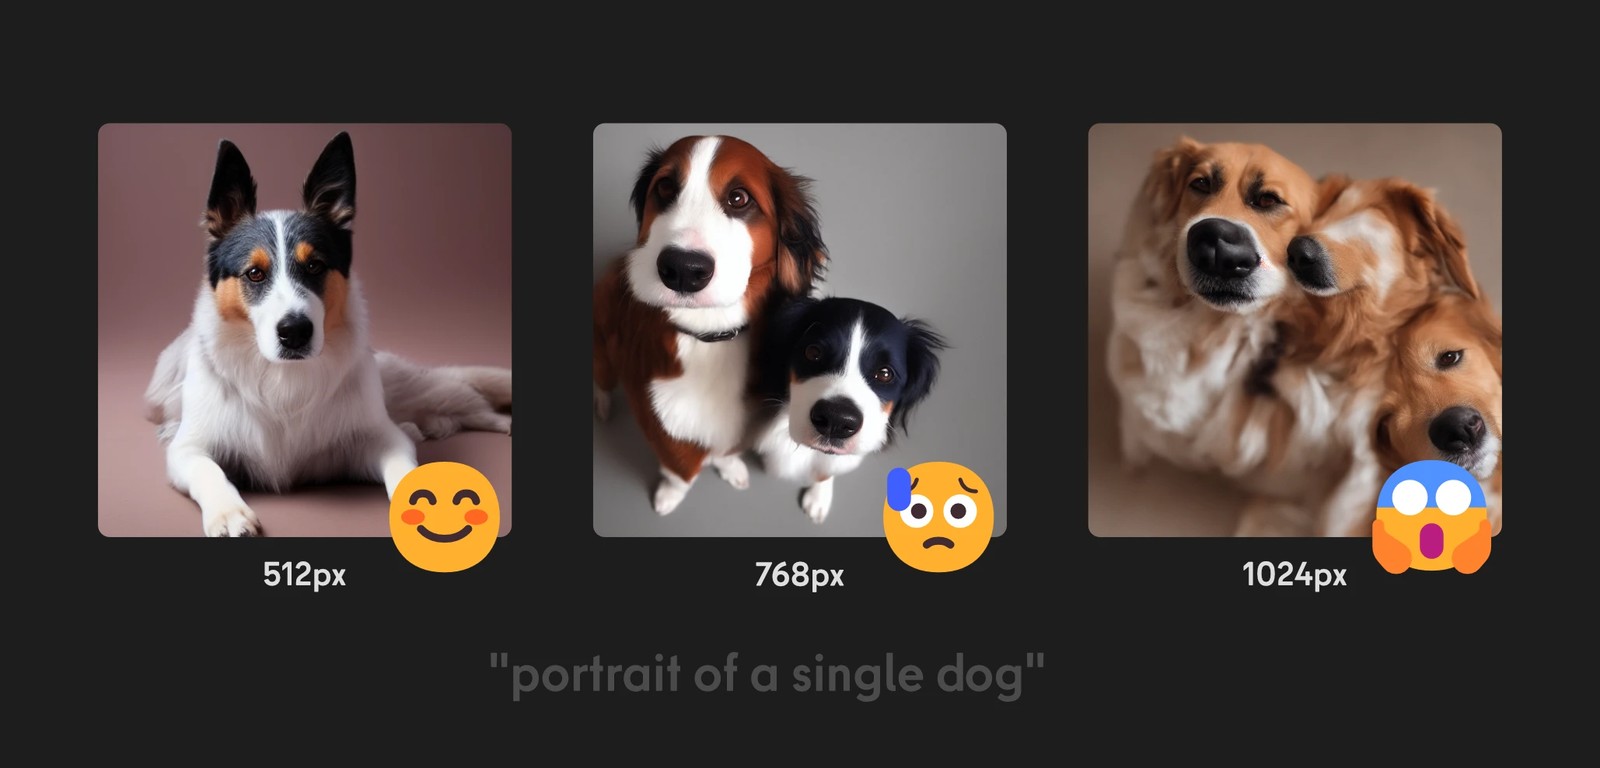
Stable Diffusion 1.5 は、ほぼ 512 × 512px の画像だけで学習されています。
つまり、このサイズ付近の絵を描くのは得意ですが、それ以外の解像度はそもそも練習していません。
漫画家に、いきなり体育館の壁いっぱいに絵を描いてもらうとしましょう。
ふだん原稿用紙サイズで描いているので、おそらくその感覚のまま、小さなコマやキャラをびっしり並べてしまうでしょう。
「壁一面を使って巨大な1枚絵を描く」という描き方自体を練習していない、そもそも発想すら湧かないのです。
Hires.fixの誕生
そこで、まずモデルが得意な 512 × 512px 付近で描いてもらい、それを拡大、拡大した画像を下書きにしてもう一度描き直してもらう。
この二段構えのやり方が生まれました。
この「モデルの得意な解像度を一度経由してから高解像度に持ち上げる」工夫が、Hires.fix の背景にある考え方です。
ベーシックな方法
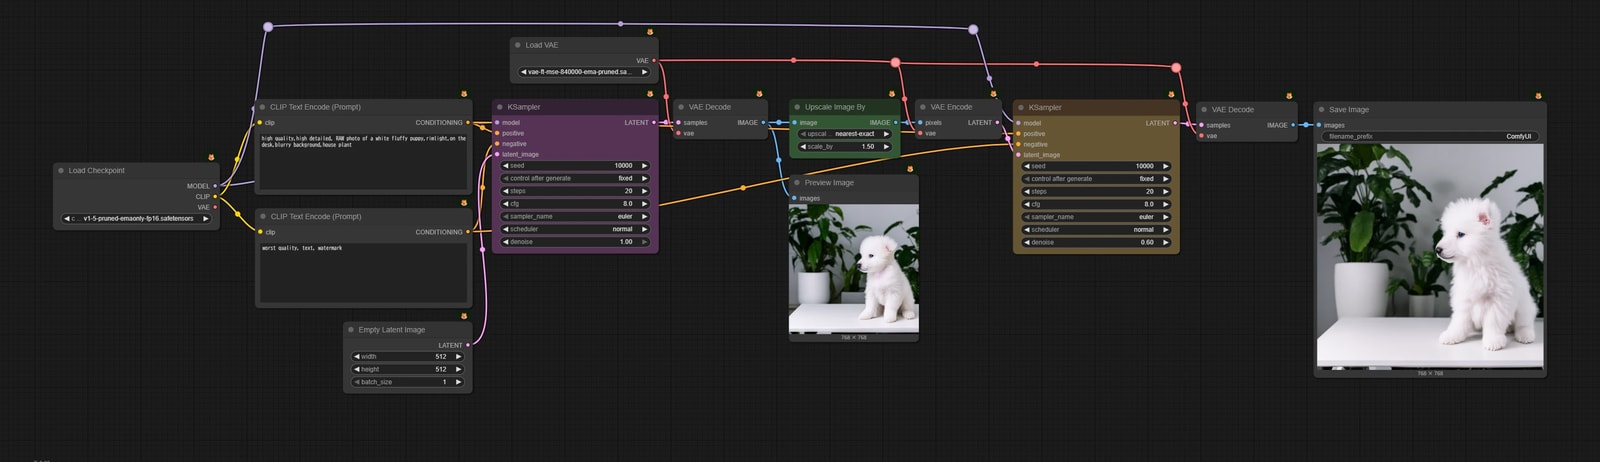
- 🟪 text2image
- 🟦
Upscale Image Byノードでデコードした画像を1.5倍に拡大 - 🟨 拡大した画像を image2image に入力
Latent のまま拡大する方法
先ほどの workflow では、text2image した画像を一度ピクセル画像にデコードしてから拡大し、再び latent に変換して image2image する流れになっていました。
ここで「わざわざピクセル画像に戻さず、latent のまま拡大できるんじゃない?」という発想が出てきます。
ただし、単純に latent を拡大するだけだと、許容できないほどの劣化が発生します。
そのため長らく実用的ではなかったのですが、「劣化を抑えた latent 拡大」を行うカスタムノードが登場しました。
- Goktug/ComfyUI_NNLatentUpscale (forked from Ttl)
- ニューラルネットワークを使ってlatentをアップスケールします。
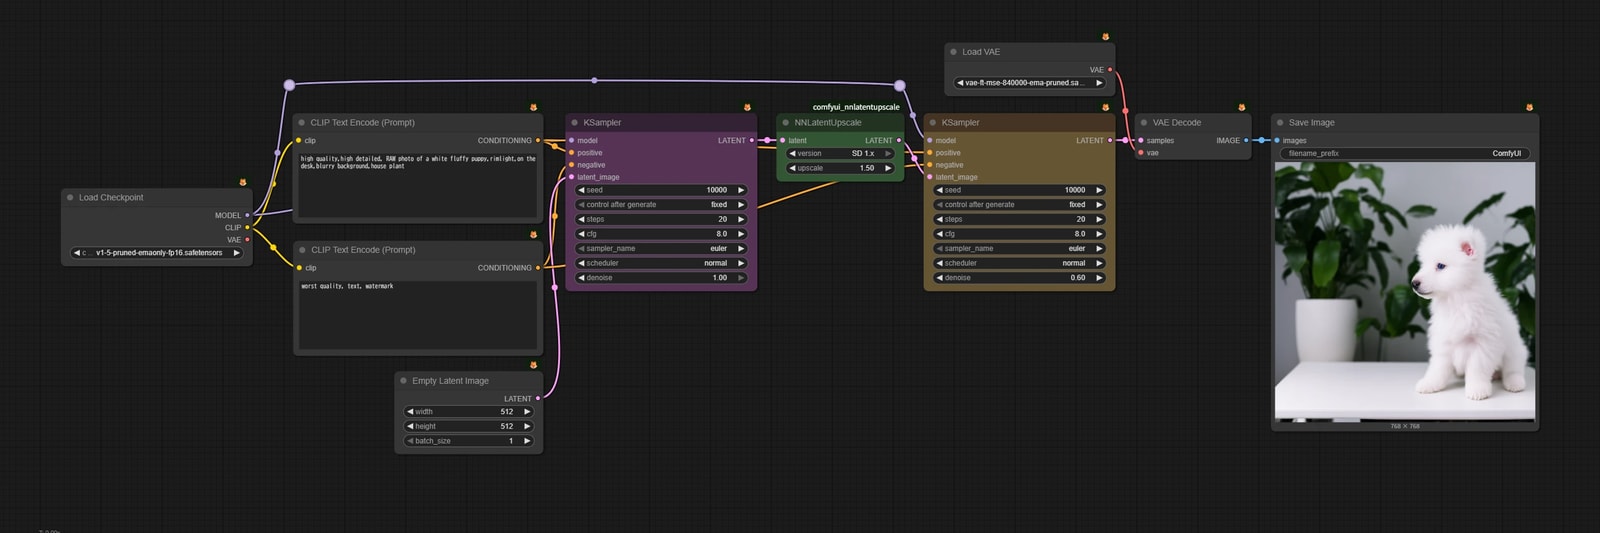
- 🟩 text2image から出てきた latent を
NNLatentUpscaleノード でそのまま拡大 - 🟨 拡大した latent を image2image にそのまま流す
あくまで体感ですが、一度ピクセル画像にデコードする方法のほうが品質は良いと思います。