SAM 3 / 3.1とは?
SAM 3 は、Meta の Segment Anything Model シリーズの新しいモデルです。
これまでの SAM は、あくまで 物の形が分かる だけで、指定したオブジェクトを切り抜くには、BBOX や座標で位置を指定してあげる必要がありました。
SAM 3 では、VLM のようにテキストで対象を指定し、単独でセグメンテーションを完結させることができるようになっています。
SAM 3.1 は SAM 3 の更新版です。動画で複数オブジェクトを追跡する処理が改善されています。
モデルのダウンロード
- sam3.1_multiplex_fp16.safetensors (1.75 GB)
📂ComfyUI/
└── 📂models/
    └── 📂checkpoints/
        └── sam3.1_multiplex_fp16.safetensors
workflow
静止画
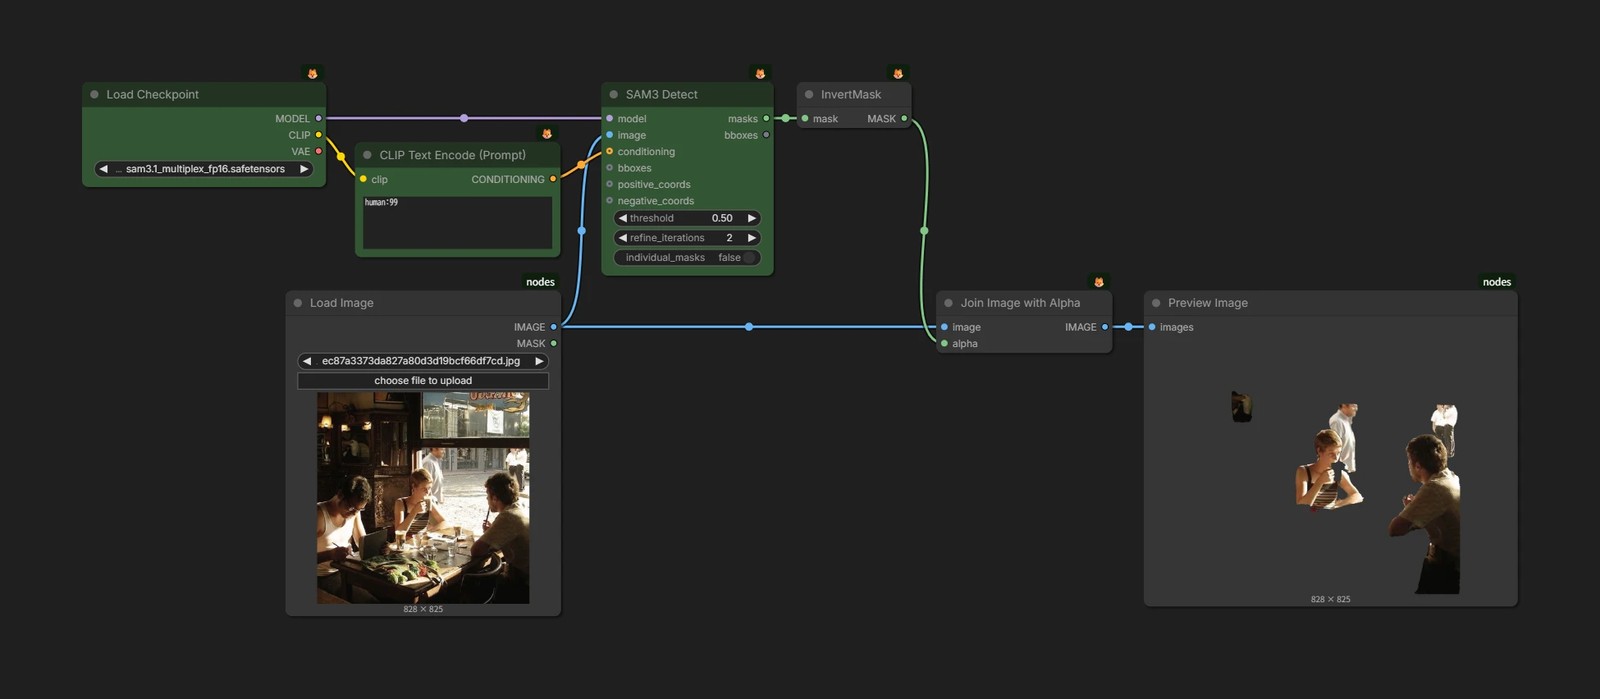
SAM3 Detectノードに、画像・マスク、切り抜く対象の情報(テキストプロンプト、BBOX、座標)を入力します。- 少しややこしい仕様ですが、そのプロンプトに対応する対象が複数あった場合、単に
carのように書くだけでは、そのうちの一番それらしいものしか検出しません。- N 番目までセグメンテーションしたい場合は、
car:Nのように書く必要があります。 - 単に画面に映っている対象をすべて検出したい場合は、
car:99のように書いてしまってもいいでしょう。
- N 番目までセグメンテーションしたい場合は、
動画
SAM3 Video Trackノードを使用します。- 出力を
SAM3 Track to Maskノードに渡すことで、マスクとして使用できます。 SAM3 Track Previewノードは、画像とtrack_dataを入力すると、マスク部分を色付けして見やすくしてくれます。