領域指定生成とは?
デザインにおいて、レイアウトは重要な要素です。
単に「街の中で壁に寄りかかっている女性」というプロンプトで画像を生成するだけでは、魅力的な作品は作れません。
画面の右端にレンガの壁があり、そこに寄りかかっている女性、そのすぐ手前に街灯を配置し、画面左はオブジェクトを減らして余白を作り出す……。
好きな場所に好きなオブジェクトを置いた画像を生成するための技術が「領域指定」です。
プロンプトで位置を指示する
最もシンプルな方法は、プロンプトにそのまま位置関係を書く方法です。
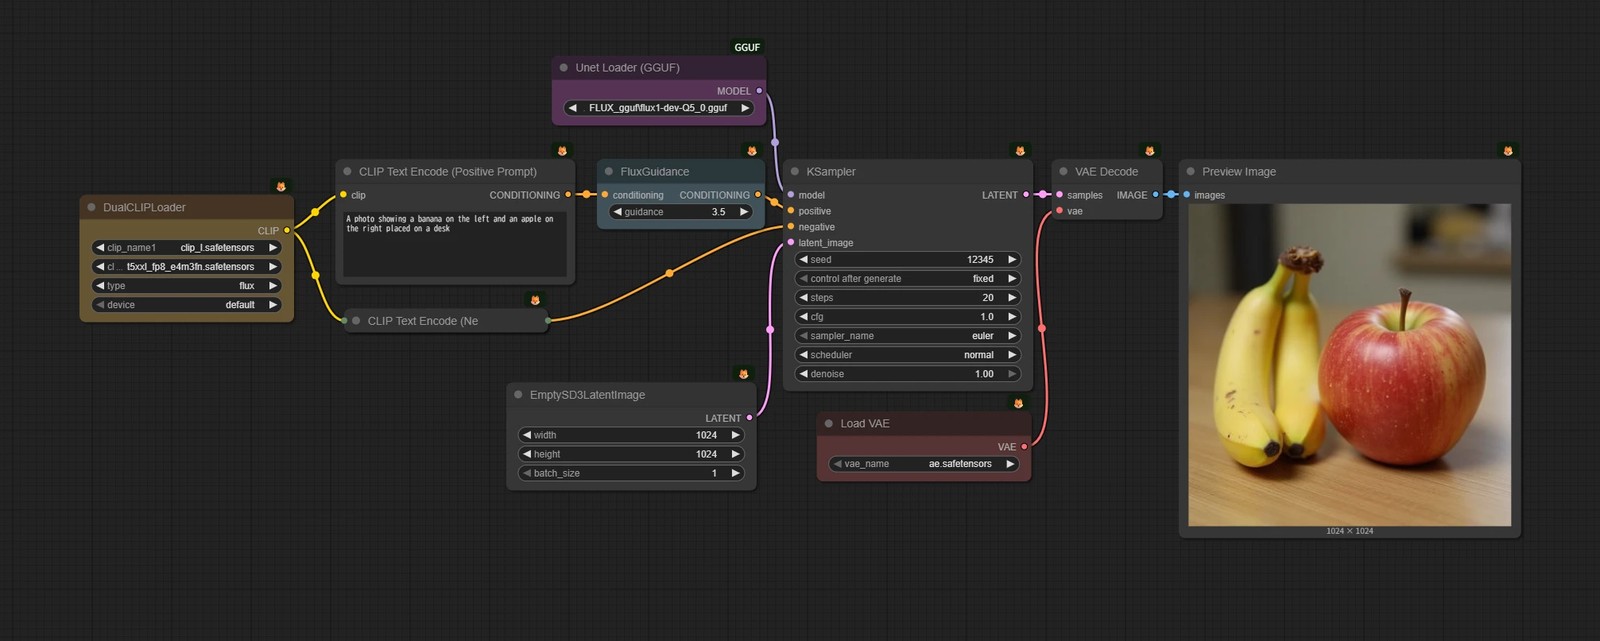
「左にバナナ、右にリンゴ」
Stable Diffusionのテキストエンコーダは位置関係をほとんど理解できなかったのですが、Flux以降のモデルでは、ある程度は位置関係を反映してくれるようになってきています。
それでも、複雑な構図になると破綻しやすく、厳密な領域指定というよりは、ゆるいレイアウトの希望を伝える手段です。
Inpaintingを繰り返す
一度画像を生成してから、Inpaintingを何度も繰り返す方法です。
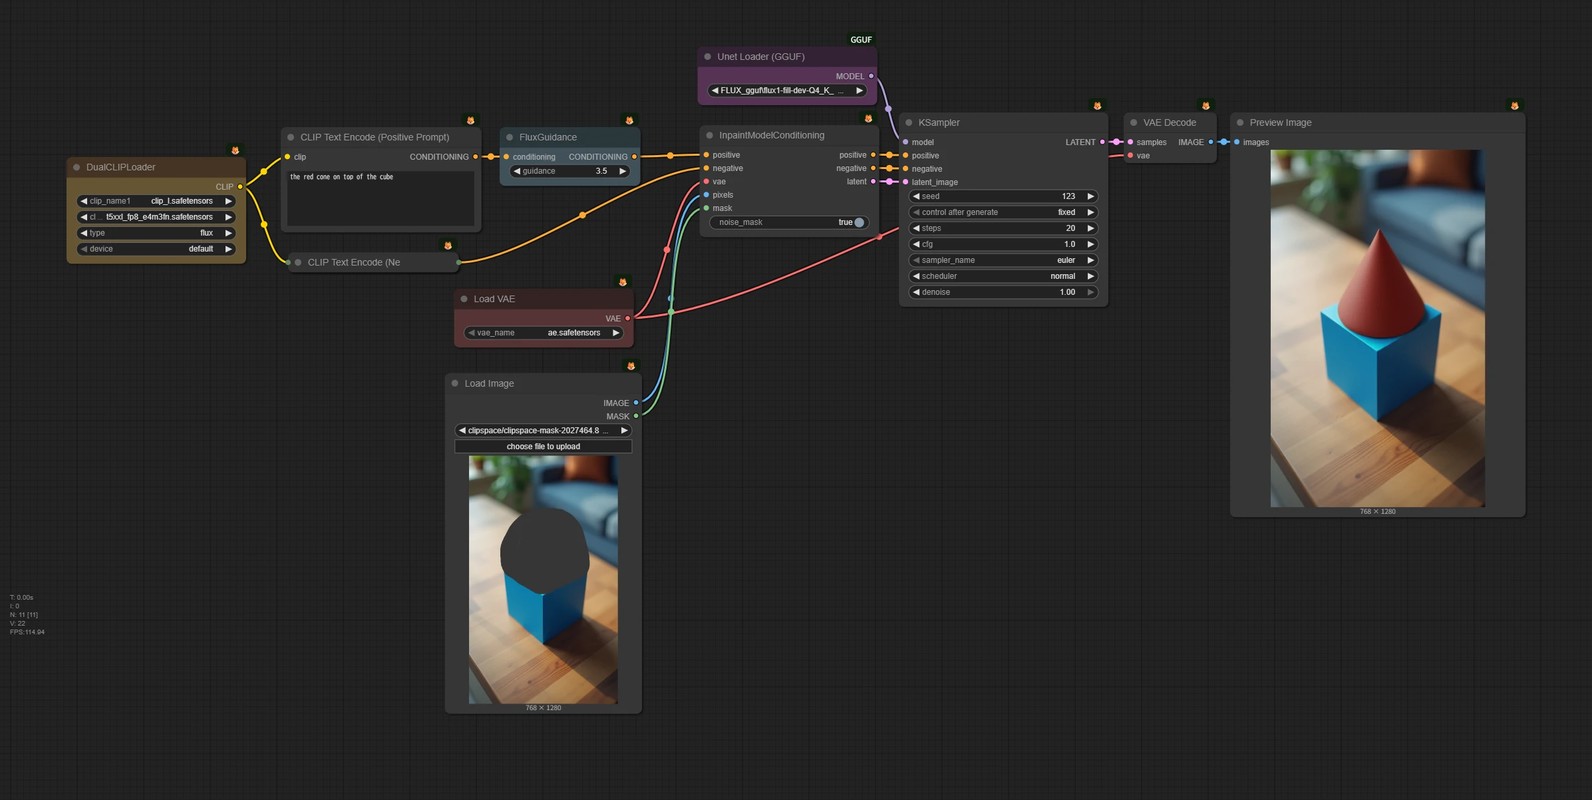
- 1. ベースとなる画像を生成する
- 2. 編集したい領域にマスクをかけてInpaintingする
- 3. 必要に応じて、別の領域にもマスクを変えてInpaintingする
あまりスマートではないと思うかもしれませんが、確実で安定した手法です。プロンプトが混ざらず、LoRAもマスク外には基本的に影響しません。各領域を完全に独立したステップとして扱えます。
弱点は、別々に生成するため対象同士の絡み合いができないこと。人物同士が握手している画像などは、目線が合わなかったり違和感が出やすいです。
Conditioning Set Area(Regional Prompting系)
画像の各位置に異なるテキスト条件を適用しようとする手法です。Cross-Attention層を利用して、領域ごとに別のプロンプトを使います。
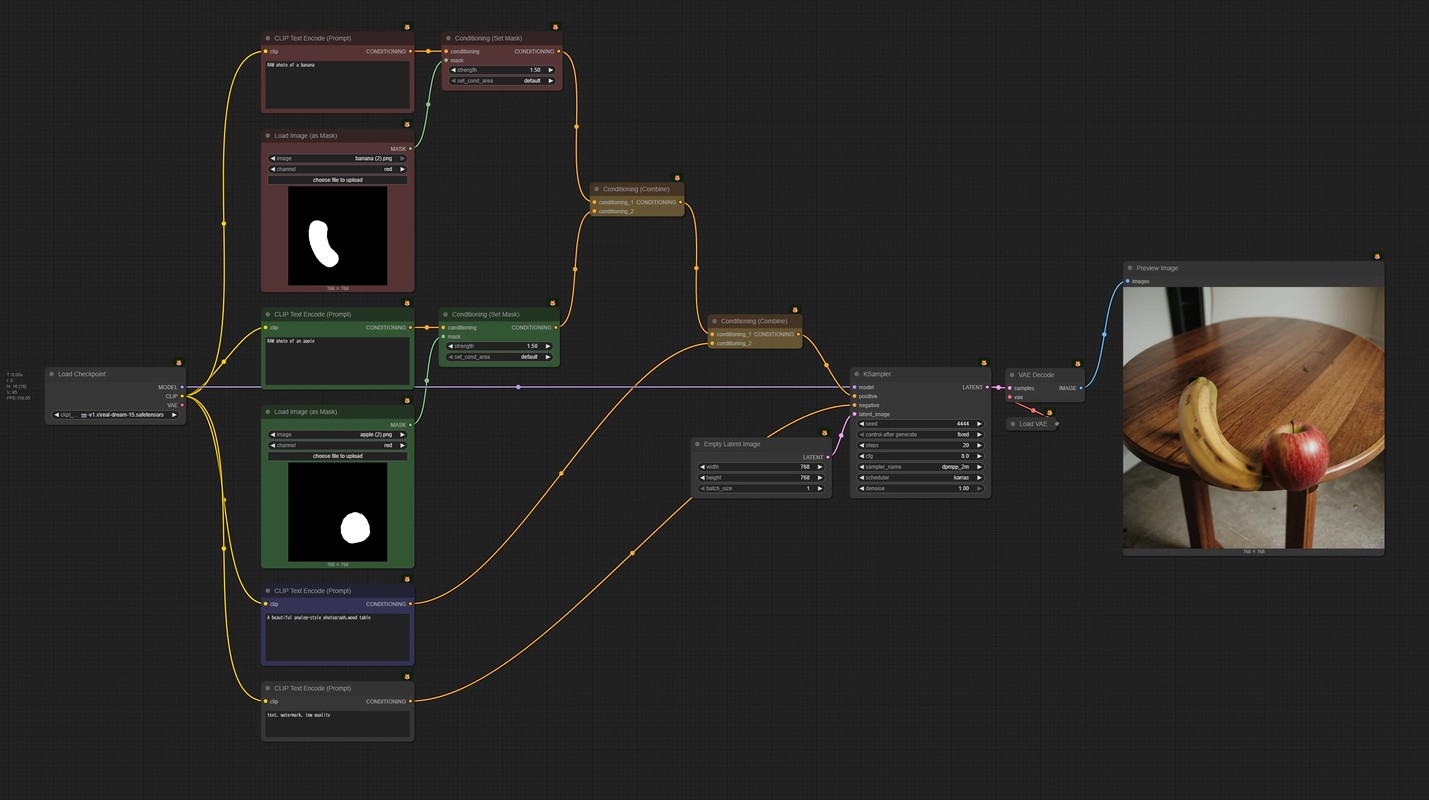
理屈はきれいですが、実際には境界がにじんだり、きっちり切り替わらないことが多く、実用性は高くありません。
また、LoRAを領域指定することはできません。
Latent Composite(潜在空間での合成)
潜在空間の段階で画像を合成する方法です。
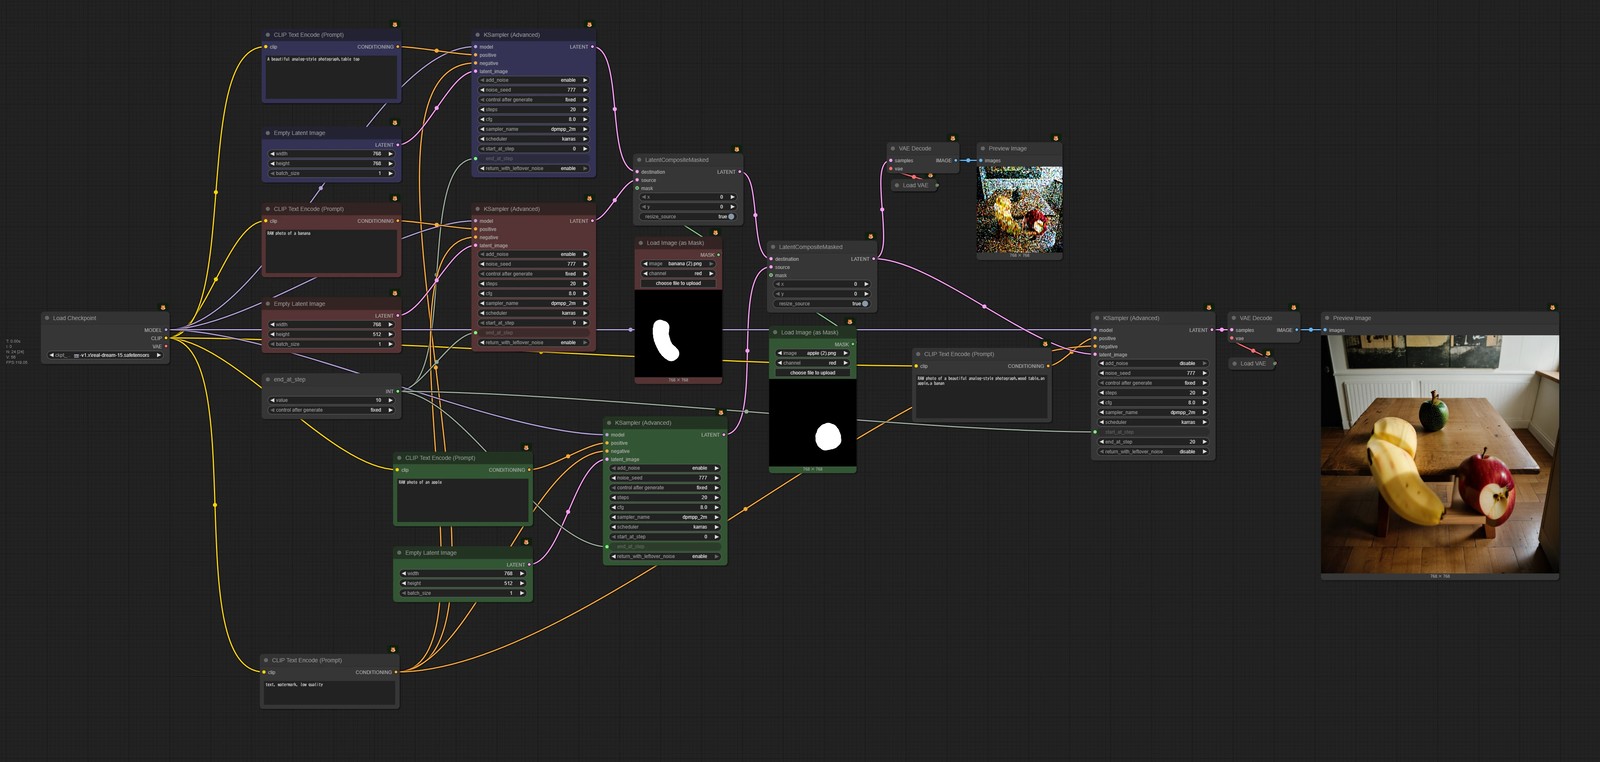
- 1. まず複数の画像(バナナ画像、リンゴ画像、背景画像など)を生成する
- 2. それぞれのlatentを、マスクを使って1枚分のlatentに貼り合わせる
- 3. その合成されたlatentに対して、残りのサンプリングステップを回す
各オブジェクトを別々の条件で生成でき、最後に「一枚の画像」としてなじませられます。
ただし、これを使うくらいなら複数回Inpaintingして、最後に全体をimage2imageしたほうが確実な場面も多いです。
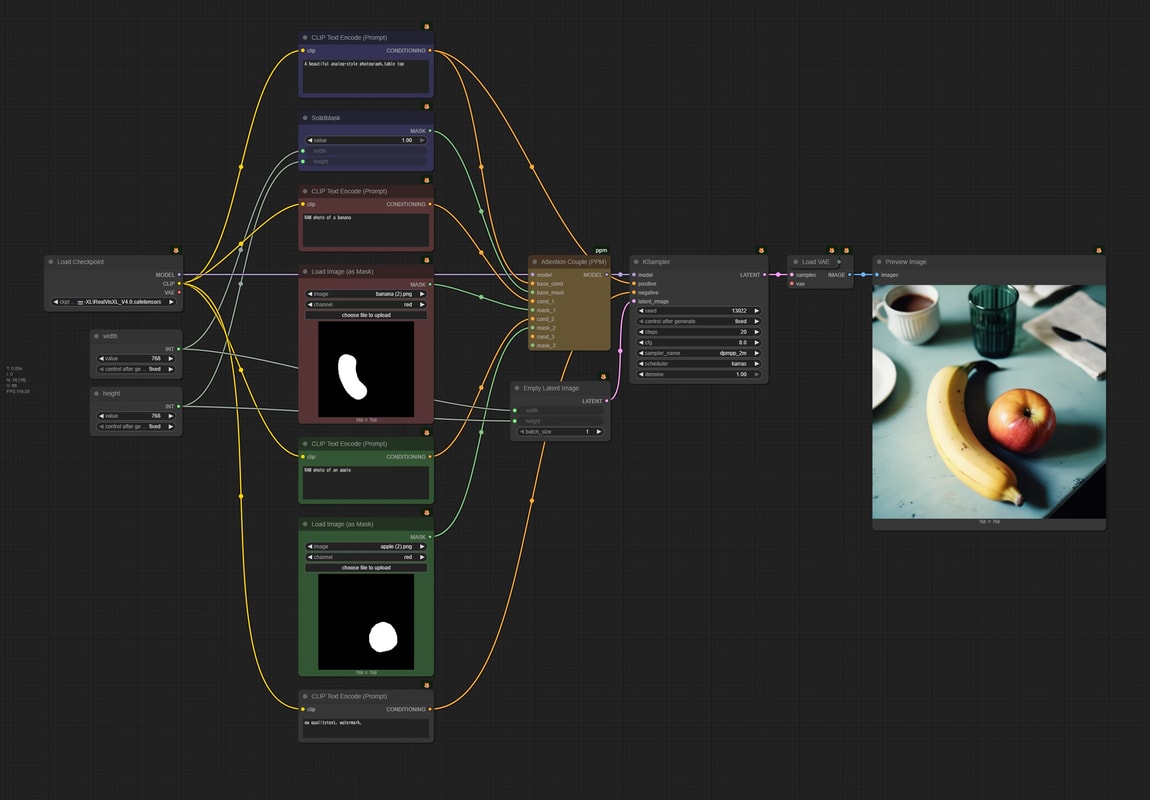
Latent Couple / Attention Couple
Latent Couple
潜在空間を領域ごとに完全に分割し、それぞれ別々の設定(プロンプト・LoRAなど)で生成してから結合する方法です。
- 各領域にまったく別の設定を使えるという点では理想的
- 領域の数だけ画像を生成しているのと同じなので、計算量が大きい
現時点でComfyUIに直接の実装はありません
Attention Couple
Lantent CoupleではUNet丸々計算していましたが、こちらはCross-Attention層のみ計算します
その分計算量は大分少なくなりますが、LoRAの領域別指定はできません
雑コラのリファイン (おすすめ)
雑なコラージュ画像を作って、それをもとに自然な絵になるように作り直させる方法です。
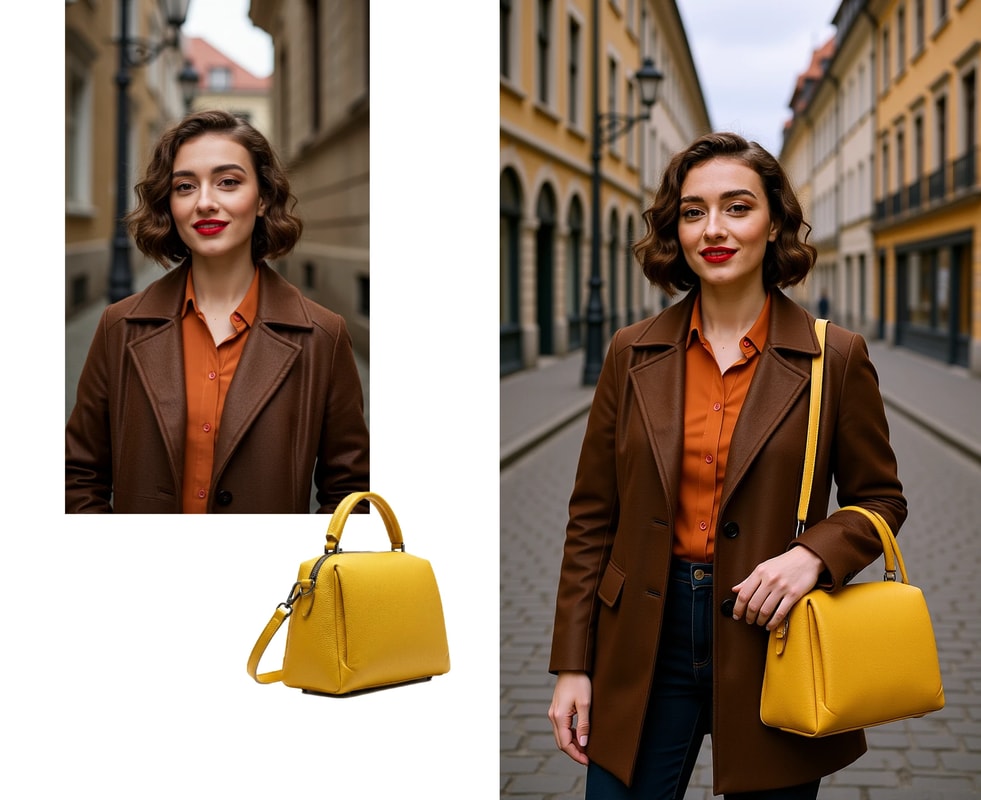
非常に直感的に位置を指定できますし、生成する物自体も適当なオブジェクトを貼り付けておけばよいので、実際のところかなりおすすめの方法です。
詳しくは → 雑コラのリファイン