LTX 2.5とは?
LTX 2.5 は、LTX-2、LTX 2.3 と続いてきた Lightricks の動画生成モデルの新しいバージョンです。
基本的な仕組みは LTX 2.3 と同じですが、単純に出力が綺麗になっただけでなく、いくつか大きな改善が施されています。
- Multi-shot
- 1 回の生成の中で複数のショットを作れるように
- Gemma 4 Text Encoder
- Text Encoder が Gemma 3 から Gemma 4 に変更
- Diffusion Decoder
- VAE Decode の代わりに、拡散モデルを使って latent から映像を復元します
- 考え方としては PiD に近いですね
他にもいくつかの改善点がありますが、ComfyUI で使うなら、ひとまずこれだけ分かっていれば OK です。
推奨設定値
- 解像度
- 32 の倍数である必要があります
- FPS
- 決まった値に固定されていません
- 既定値は 24 FPS です
- フレーム数
8n + 1である必要があります
- 動画最大長
- 481 frames
- 24 FPS なら約 20 秒です
モデルのダウンロード
LTX 2.5 のモデルは、認証しないとダウンロードできません。Hugging Face のアカウントでログインし、LTX-2.5 のページ で
Agree and Accessをクリックしてください。後半で使う IC-LoRA も、それぞれのページで同じように同意が必要です。
- diffusion_models
- latent_upscale_models
- text_encoders
- vae
- ltx-2.5-video-vae-bf16.safetensors (1.47 GB)
- ltx-2.5-audio-vae-bf16.safetensors (365 MB)
📂ComfyUI/
└── 📂models/
    ├── 📂diffusion_models/
    │   └── ltx-2.5-22b-distilled-transformer-comfy-int8-convrot.safetensors
    ├── 📂latent_upscale_models/
    │   └── ltx-2.5-latent-spatial-upscaler-x2-bf16-1.0.safetensors
    ├── 📂text_encoders/
    │   └── gemma4-12b-with-proj-ltx-2.5-comfy-int8-convrot.safetensors
    └── 📂vae/
        ├── ltx-2.5-video-vae-bf16.safetensors
        └── ltx-2.5-audio-vae-bf16.safetensors
text2video
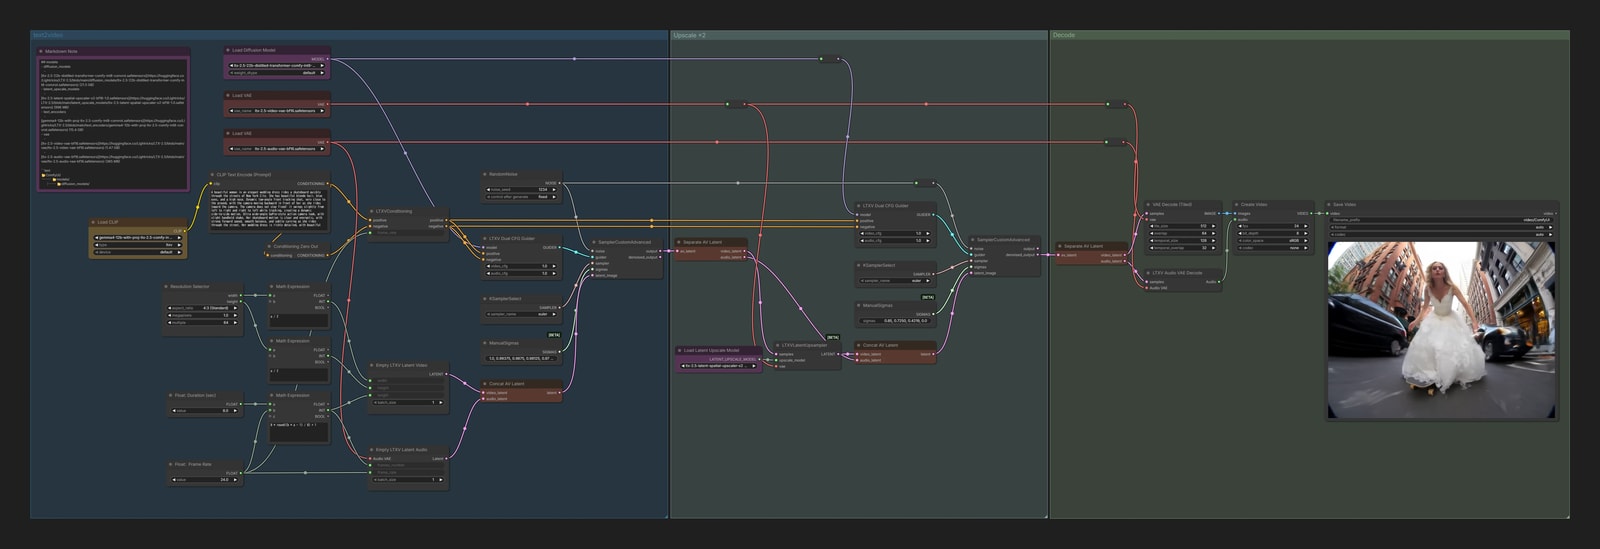
LTX-2 と同じく、まず目標の半分の解像度で作り、そのあと 2 倍にアップスケールする 2 段階の workflow です。
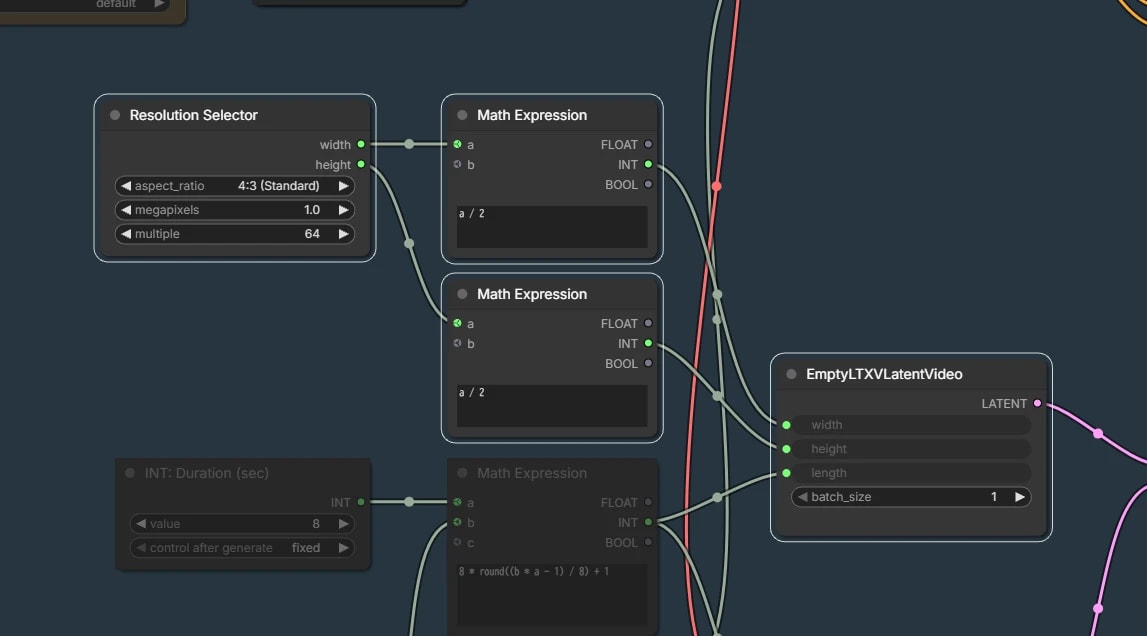
解像度設定
あとから 2 倍にするため、目標解像度の半分の値を EmptyLTXVLatentVideo に入力します。
この値も 32 の倍数にする必要があるため、目標の幅・高さは 64 の倍数にしてください。
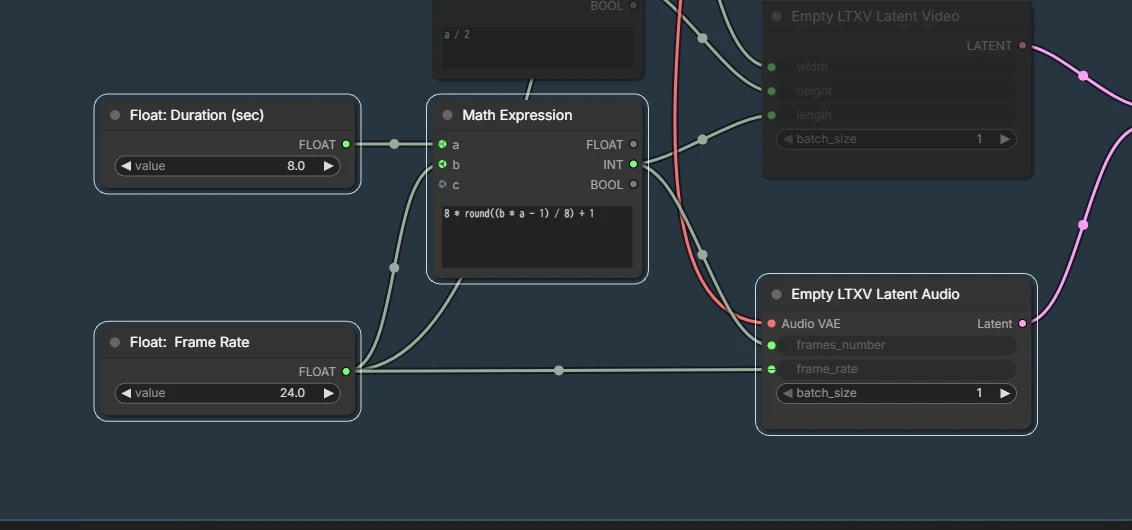
フレーム数の設定
この workflow では、作りたい動画の秒数(sec)と FPS を入力すると、適切な 8n + 1 のフレーム数に丸められます。
Multi-shot
Seedance 2 などから一般的になってきましたが、1 回の生成で複数のショットを作ることができます。
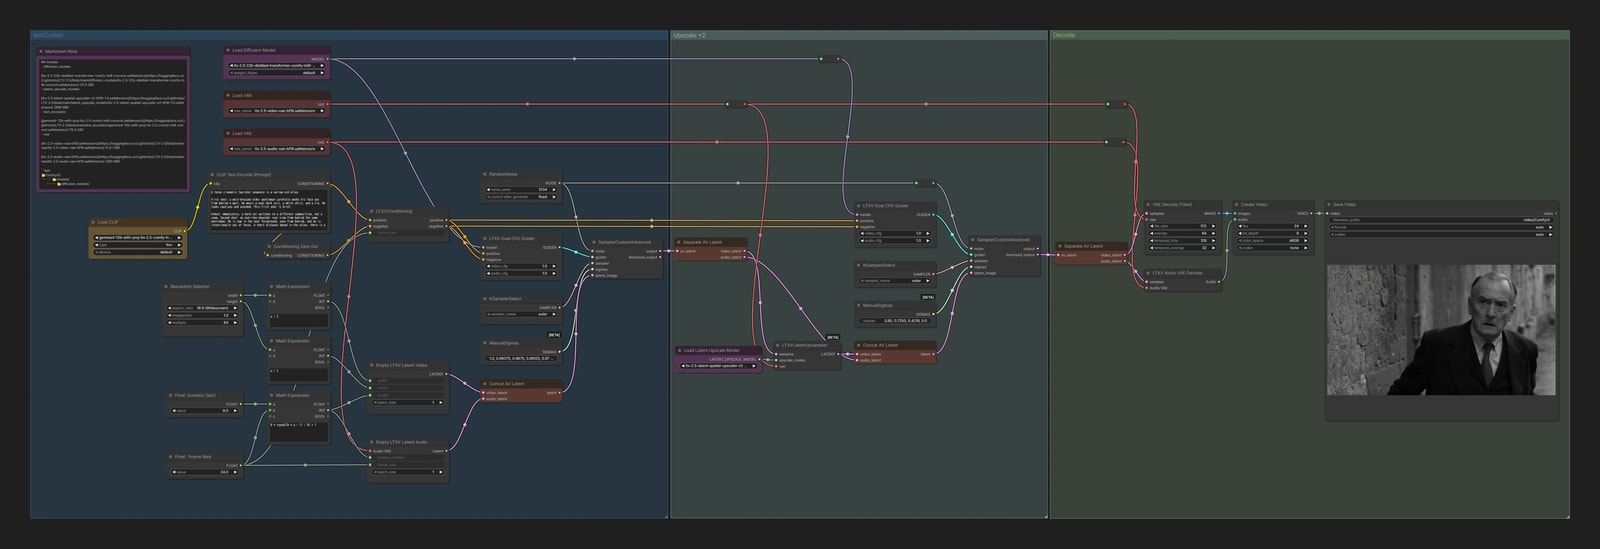
特別な書き方は必要なく、自然文で「ここにカットが入り……」と書けば認識してくれます。
気楽に書ける反面、Multi-shot として認識してくれないこともあります。うまくいかないときは、気長に何度か試してみてください。
Duration Predictor
動画の長さは基本的に手動で設定しますが、このプロンプトなら何秒がちょうどよいのか……というのは意外と悩ましいものです。
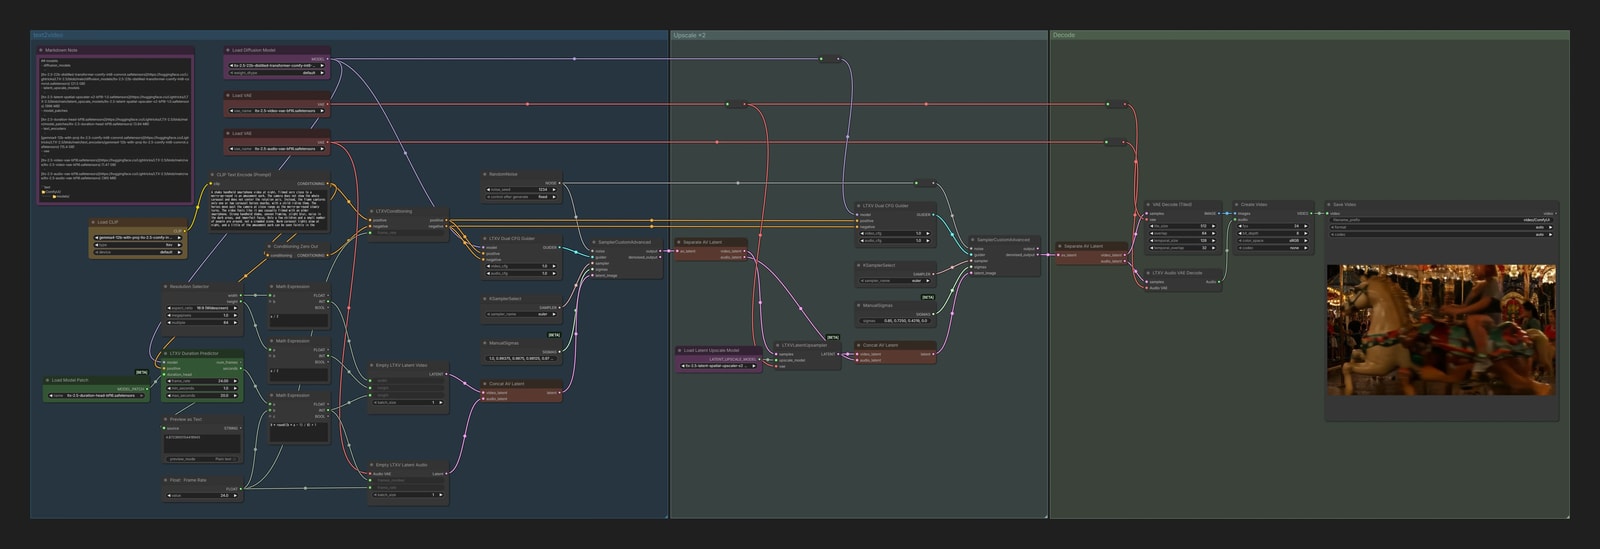
LTX 2.5 には、プロンプトの内容から、それを表現するために必要な動画の長さを自動で推定する機能があります。
モデルのダウンロード
- model_patches
- ltx-2.5-duration-head-bf16.safetensors (3.84 MB)
📂ComfyUI/
└── 📂models/
    └── 📂model_patches/
        └── ltx-2.5-duration-head-bf16.safetensors
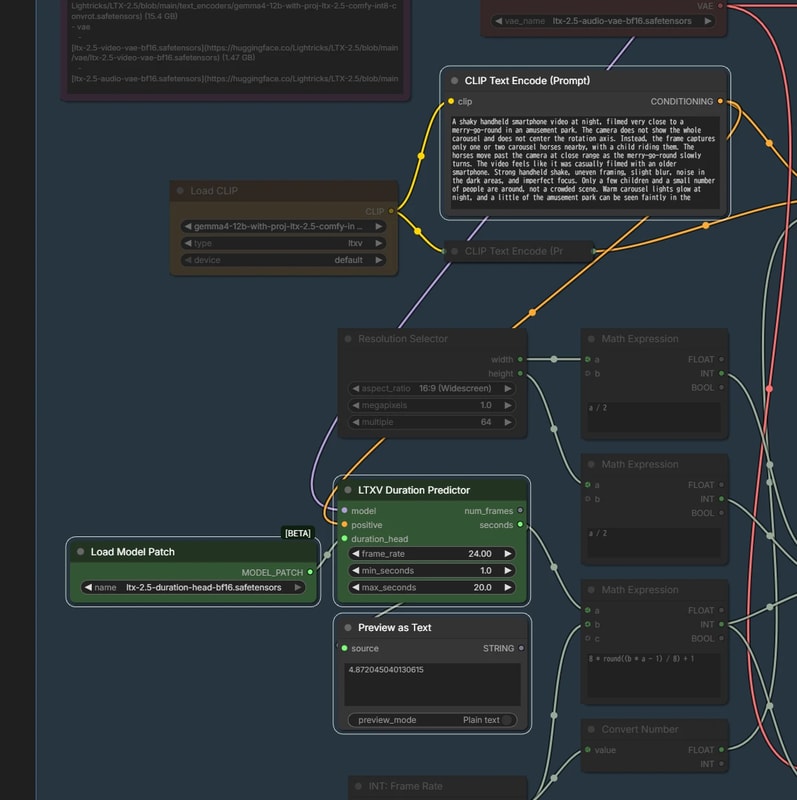
LTXV Duration Predictor
プロンプトから予測されたフレーム数が出力されるので、通常の text2video workflow の length へつなぎます。
あくまで予測なので、思っていたより短くなったり、長くなったりすることもあります。それでも、動画の長さを自動で予測してくれるのは面白い機能ですね。
image2video
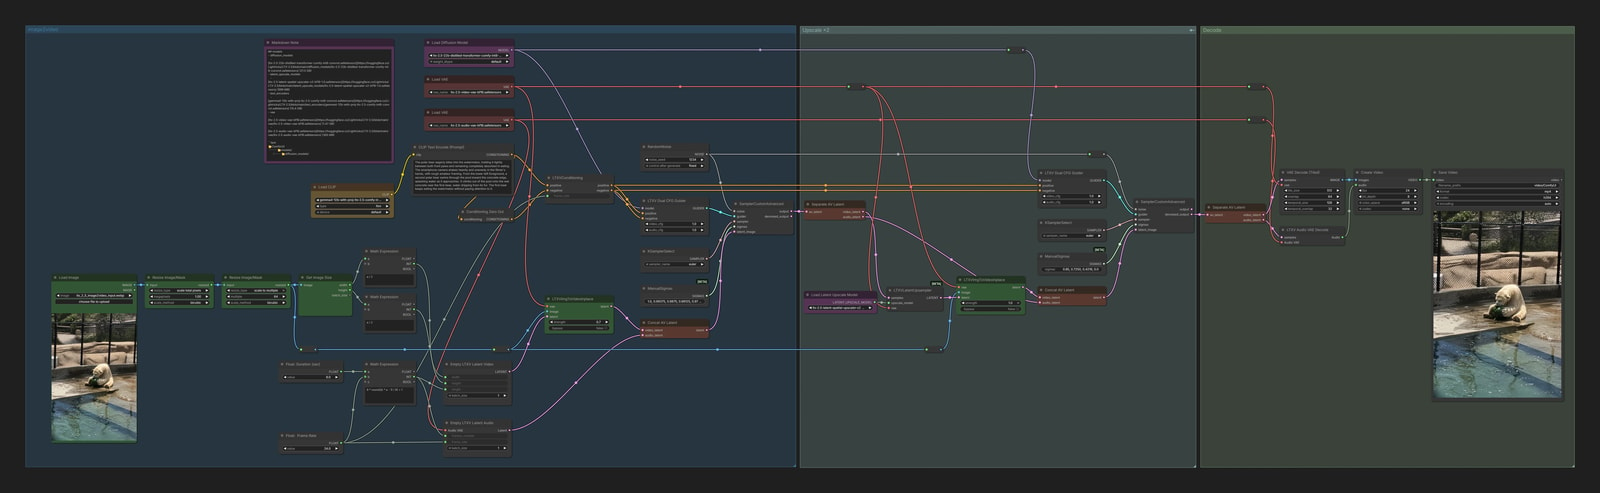
LTX 2 の image2video と同じです。LTXVImgToVideoInplace で 1 フレーム目に入力画像を差し込みます。
以前は、いろいろな理由から
LTXV Preprocessで入力画像をわざと劣化させていましたが、LTX 2.5 では、少なくとも私が使った限りでは必要なさそうなので外しています。
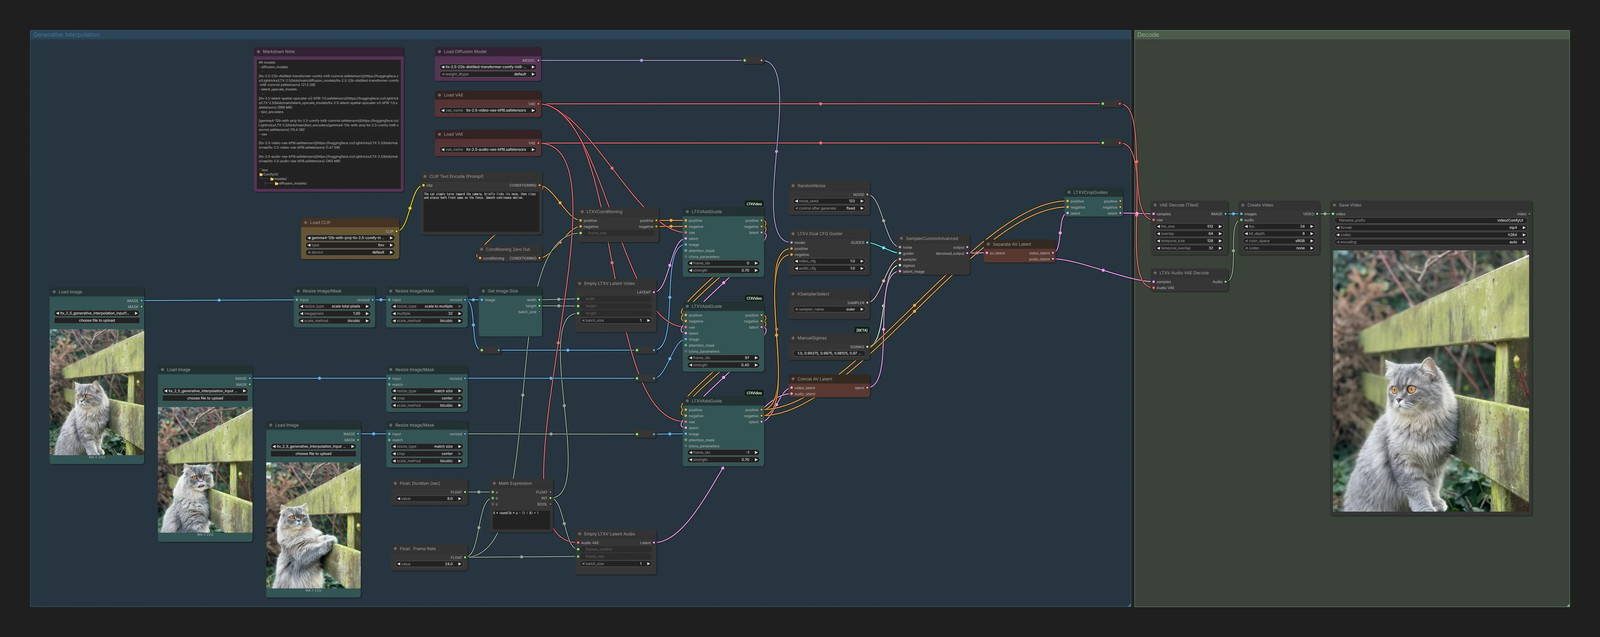
Generative Interpolation / FLF2V
任意の数の画像を渡し、その間を滑らかに埋めてもらう workflow です。
動画の最初と最後だけを指定すれば、いわゆる FLF2V というものになります。
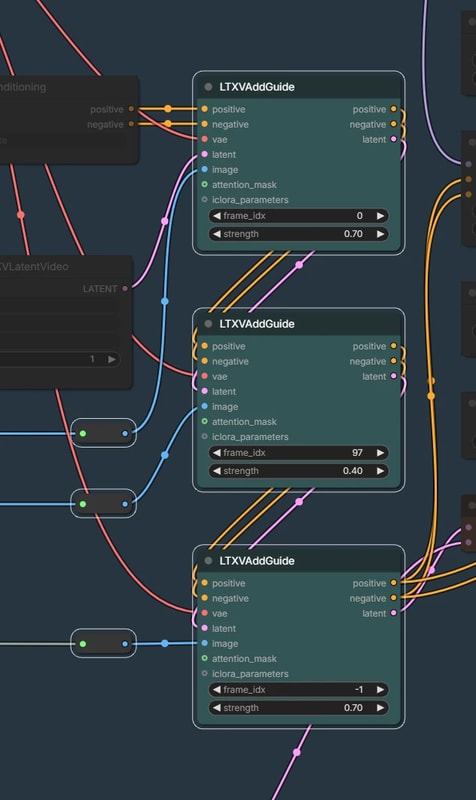
LTXV Add Guide
frame_idx に画像を入れる位置を指定します。
0:最初のフレーム-1:最後のフレーム
ノードを増やし、直列につなげれば、Generative Interpolation になります。
画像にはよりますが、フレーム補間ではなく、トランジションのようになってしまうことがあります。
中間に差し込むLTXVAddGuideのstrengthは、0.3〜0.4 くらいまで小さくしたほうが良いかもしれません。
IC-LoRA
LTX における ControlNet や、動画編集 LoRA のような役割を持つのが IC-LoRA です。
LTX 2.5 は LTX 2.3 用 IC-LoRA の多くと互換性があり、そのまま使えます。
Union Control
一般的な ControlNet と同様、線画や深度マップ、ポーズ動画で生成動画を制御できます。
モデルのダウンロード
- loras
📂ComfyUI/
└── 📂models/
    └── 📂loras/
        └── ltx-2.3-22b-ic-lora-union-control-ref0.5.safetensors
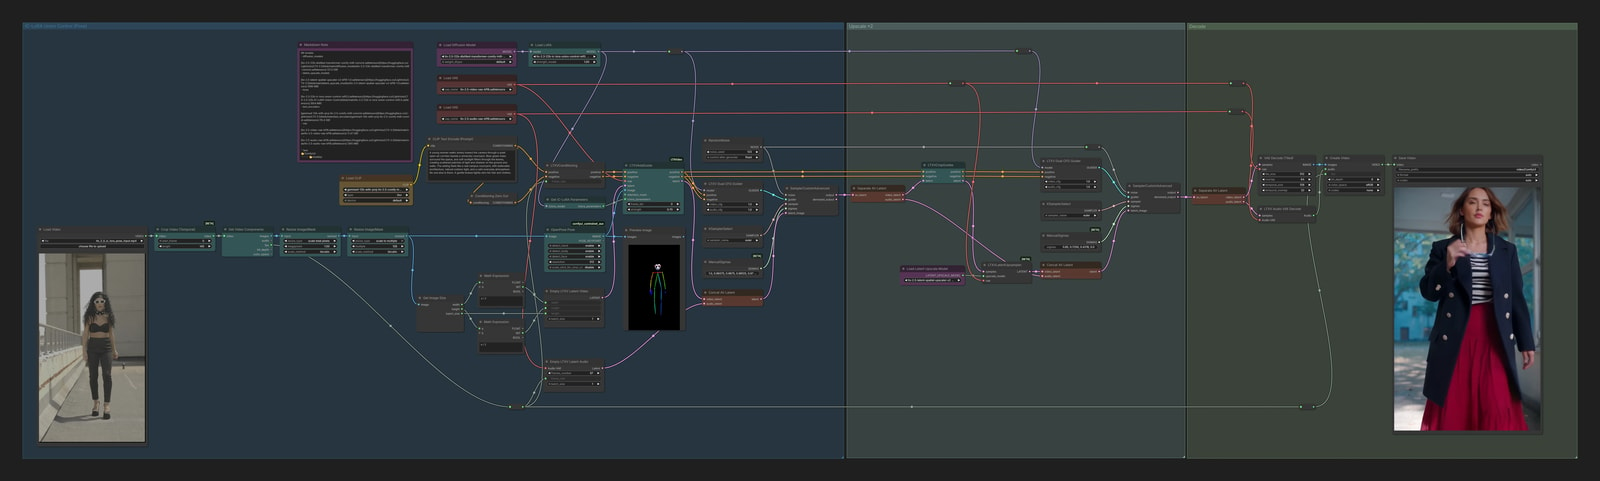
IC-LoRA の詳しい解説は LTX 2/IC-LoRA (Pose) で行っているので、興味があれば見てみてください。
Clean Plate
Lightricks 公式から、LTX 2.5 でできる VFX 処理として、愉快な IC-LoRA がたくさん出ています。
昼を夜にしたり、水浸しにしたりと色々なものがありますが、今回は動画内の特定のものを消す Clean Plate を使ってみましょう。
モデルのダウンロード
- loras
📂ComfyUI/
└── 📂models/
    └── 📂loras/
        └── ltx-2.5-22b-ic-lora-clean-plate-1.0.safetensors
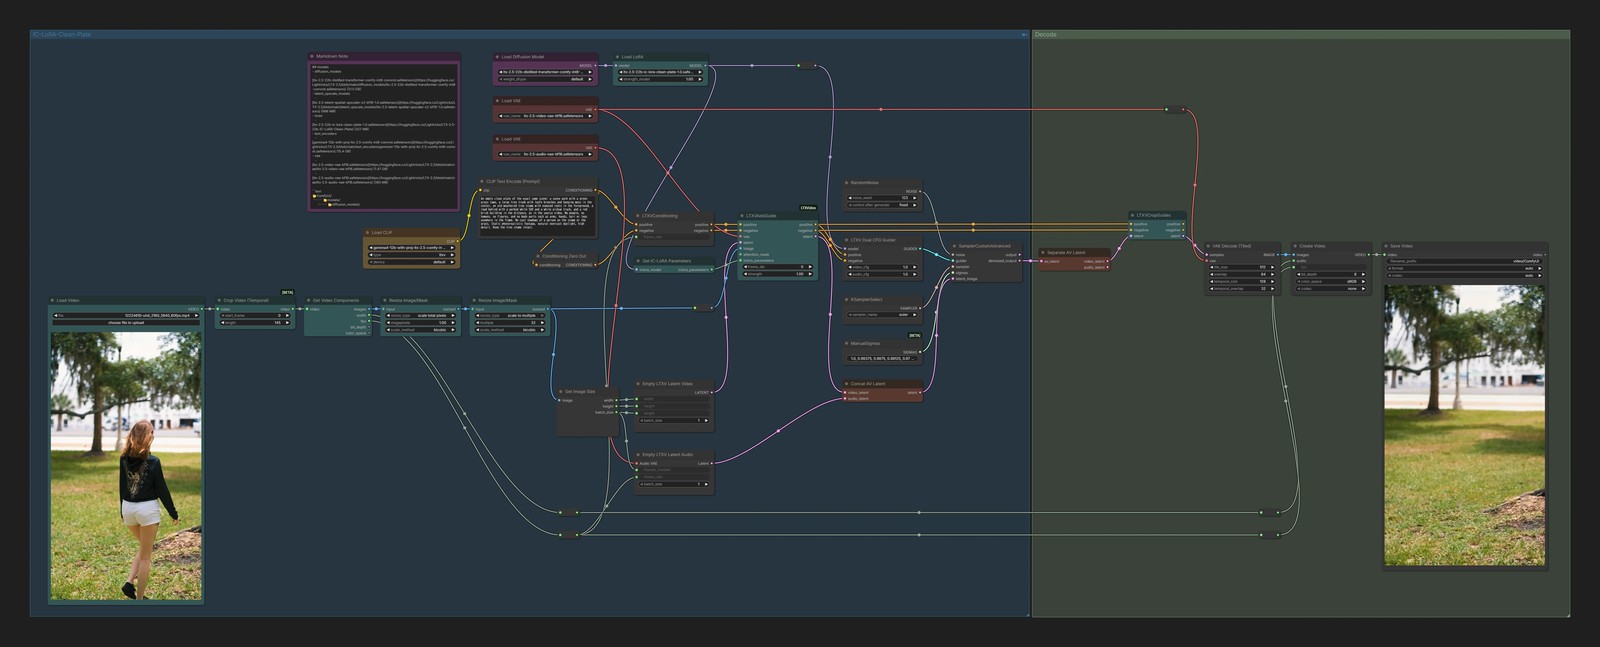
プロンプトの書き方に少し注意が必要です。
画像編集のように「〇〇を消して」と書くのではなく、〇〇が消えたあとの景色を、普通の文章として書きます。消したいものがはっきりしているときは、no bicycle anywhere in the frame のように、それが無いことも書き添えると効きやすくなります。
画面の端にあるものや、一部が隠れているものは綺麗に消えやすい一方、画面の真ん中を大きく占めるものは苦手なようです。消したあとの背景の手がかりが、映像の中にほとんど残らないからでしょうね。
基本的には、この workflow で他の IC-LoRA も動かせます。ただ、専用の workflow が必要なものもいくつかあるので、以下で見ていきます。
Alpha Gen
動画の中から前景を切り抜くことができます。
ただし、背景が透過された動画がそのまま出てくるわけではないので、少し後処理をしてあげる必要があります。
モデルのダウンロード
- loras
📂ComfyUI/
└── 📂models/
    └── 📂loras/
        └── ltx-2.5-22b-ic-lora-alpha-gen-0.9.safetensors
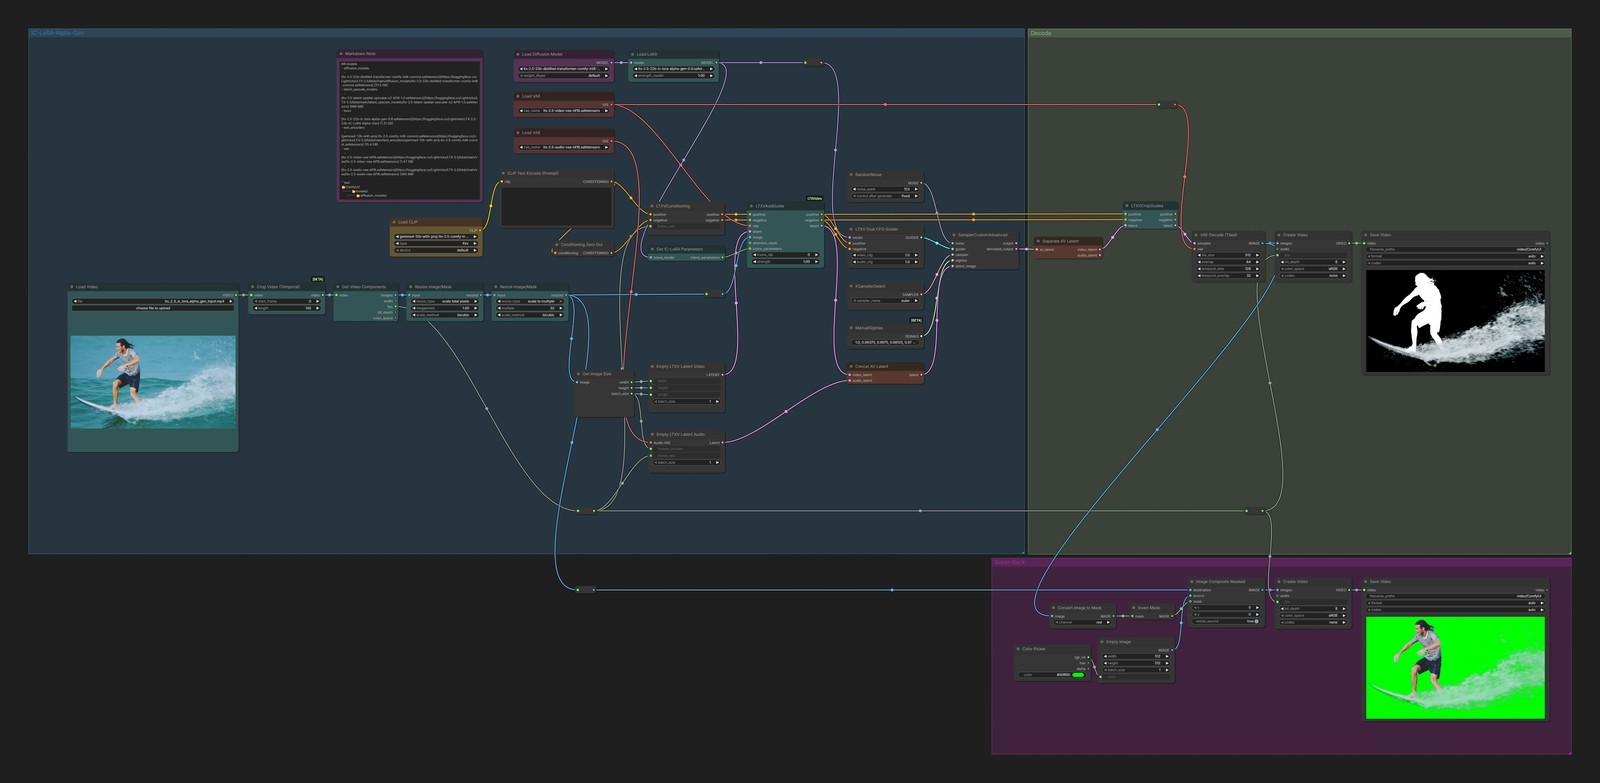
プロンプトは使いません。空のままにしておきます。
出力されるのは、白黒のマスク動画です。
ComfyUI では透過動画は作れないので、ここではグリーンバックの動画にしてみましょう。
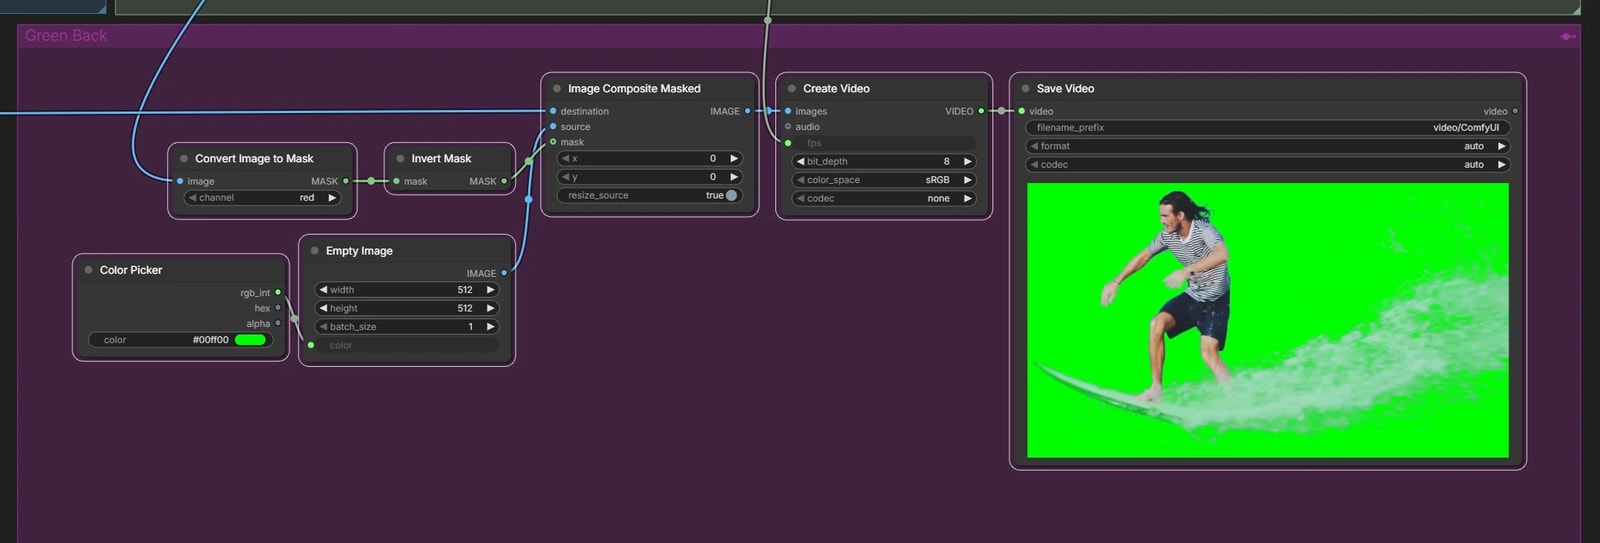
グリーンバックに合成する
- 白黒の動画を
ImageToMaskでマスクにする InvertMaskで反転するImageCompositeMaskedで、緑一色のEmptyImageを背景部分に合成する
145 frames より長い動画では、元の映像がマスクに混ざり始めるようです。workflow では 145 frames で切っています。
Refine Details
任意の動画を、細部を描き込みながら、4K のような高解像度にアップスケールします。
計算量を抑えるためにタイルに分けて処理するので、カスタムノードが必要です。
カスタムノード
モデルのダウンロード
- loras
📂ComfyUI/
└── 📂models/
    └── 📂loras/
        └── ltx-2.5-22b-ic-lora-refine-details-1.0.safetensors
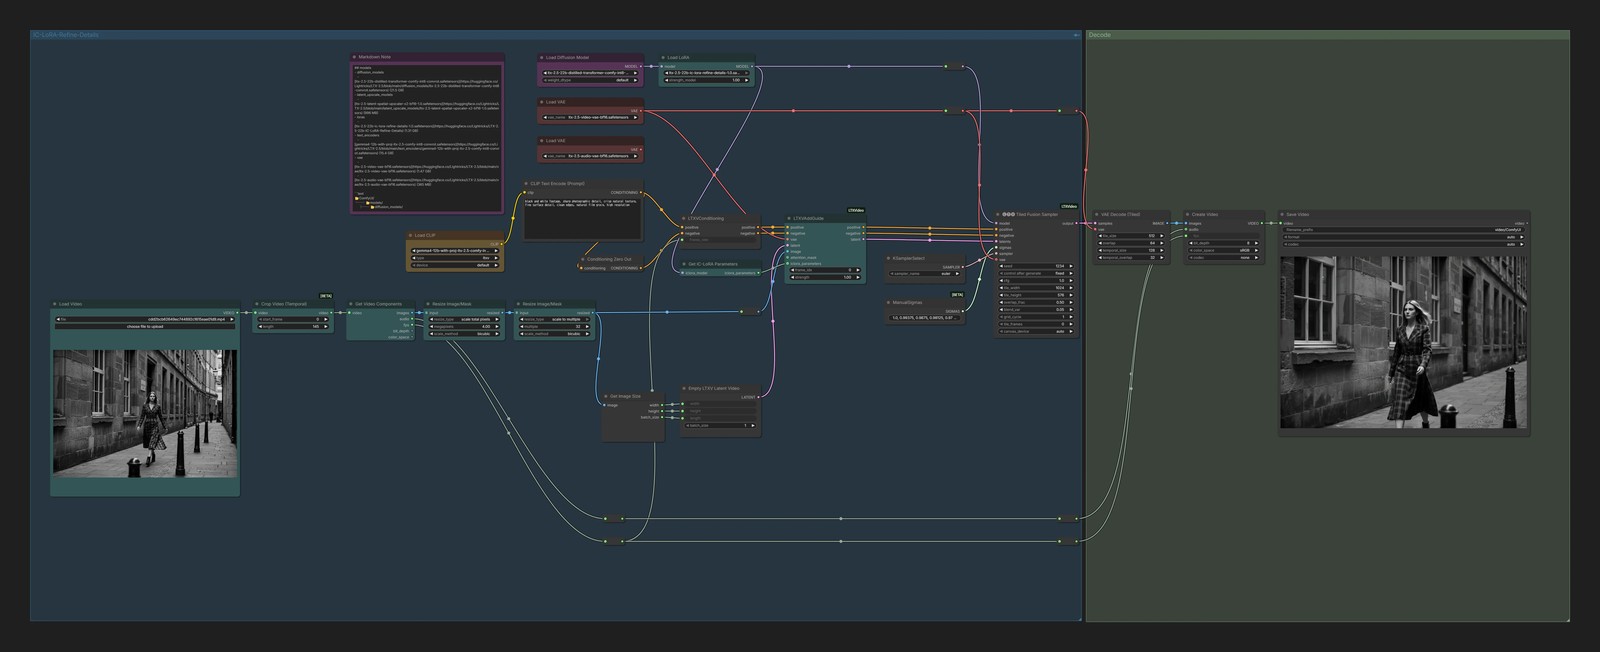
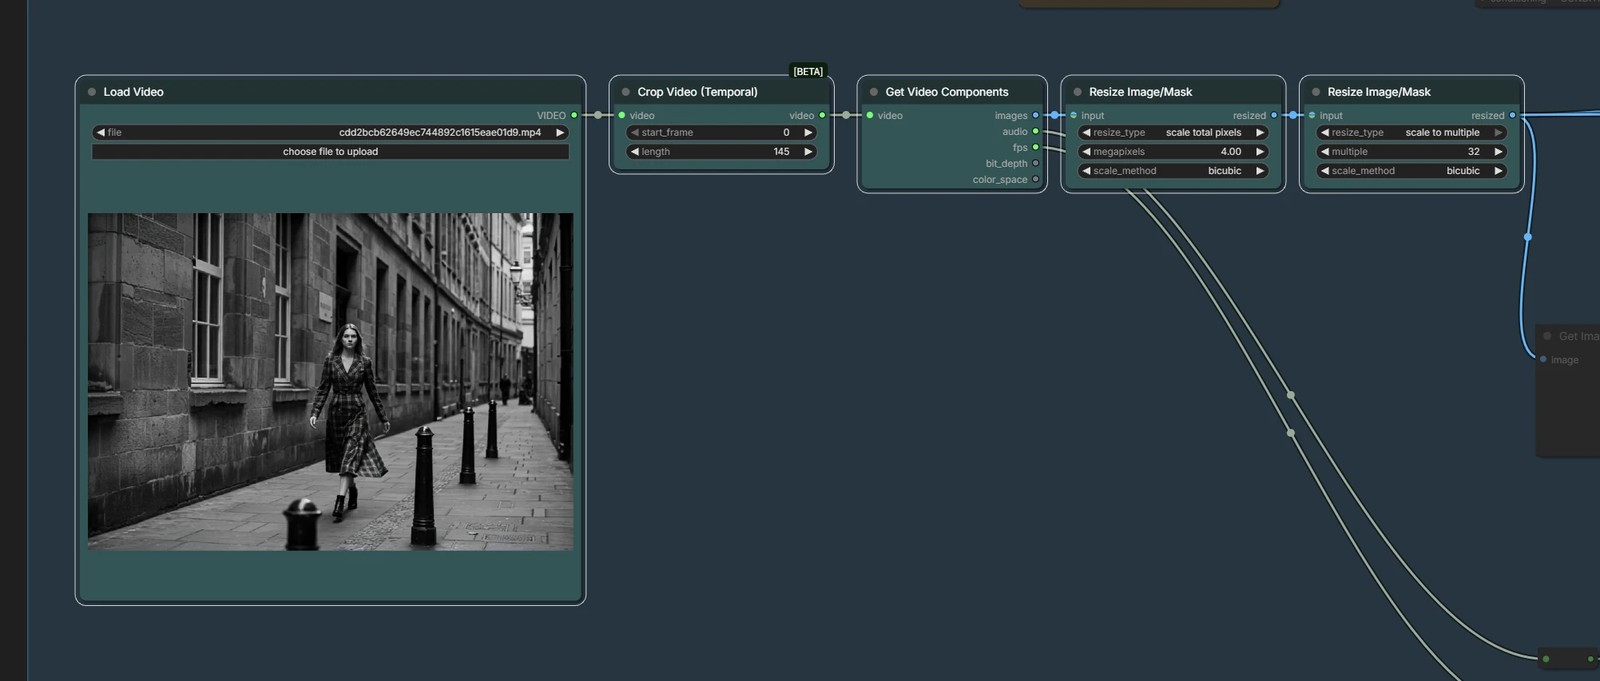
先に動画をリサイズする
先に、動画を大きなサイズ(この workflow では約 4 MP)へ引き伸ばしておきます。
Refine Details がやるのは、引き伸ばされてぼやけた動画を、綺麗に描き込み直す作業ということですね。
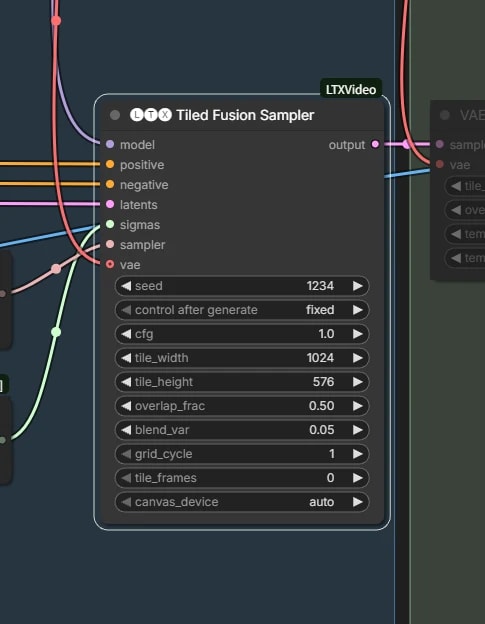
Tiled Fusion Sampler
LTXVTiledFusionSampler が、動画をタイル状に分割してサンプリングしてくれます。
設定は特に変更する必要はありません。
プロンプトには、写っているものではなく、sharp photographic detail や natural film grain のような、画質についての言葉を書きます。タイルごとにプロンプト全体が渡されるので、人物などを書くと、その人がいないタイルにまで描き込まれてしまいます。