LoRAとは?
Textual Inversion は「テキストでは説明しづらい見た目」を 1 つの単語に押し込める技術でしたが、モデルがもともと知らないものをゼロから描けるようにする力はありません。
「モデルが元々描けなかったものも描けるようにしたい!」と思ったとき、従来はモデル全体をファインチューニングする必要がありました。
しかし、学習にかなりのコストがかかります。
そこで使われるようになったのが、もともと LLM で使われていた LoRA(Low-Rank Adaptation) です。
LoRA は、モデルの重みそのものを書き換えるのではなく、「変更分」だけを小さな追加データとして外部に保存する方式です。
ベースモデルに対して、あとから拡張パックを読み込むような感覚で、新しいスタイルやキャラクターを足せます。
LoRAを適用した text2image
LoRAのダウンロード
今回は例として、ピクセルアート風にする LoRA を使ってみます。
-
  📂ComfyUI/
    └── 📂models/
        └── 📂loras/
            └── PX64NOCAP_epoch_10.safetensors
workflow
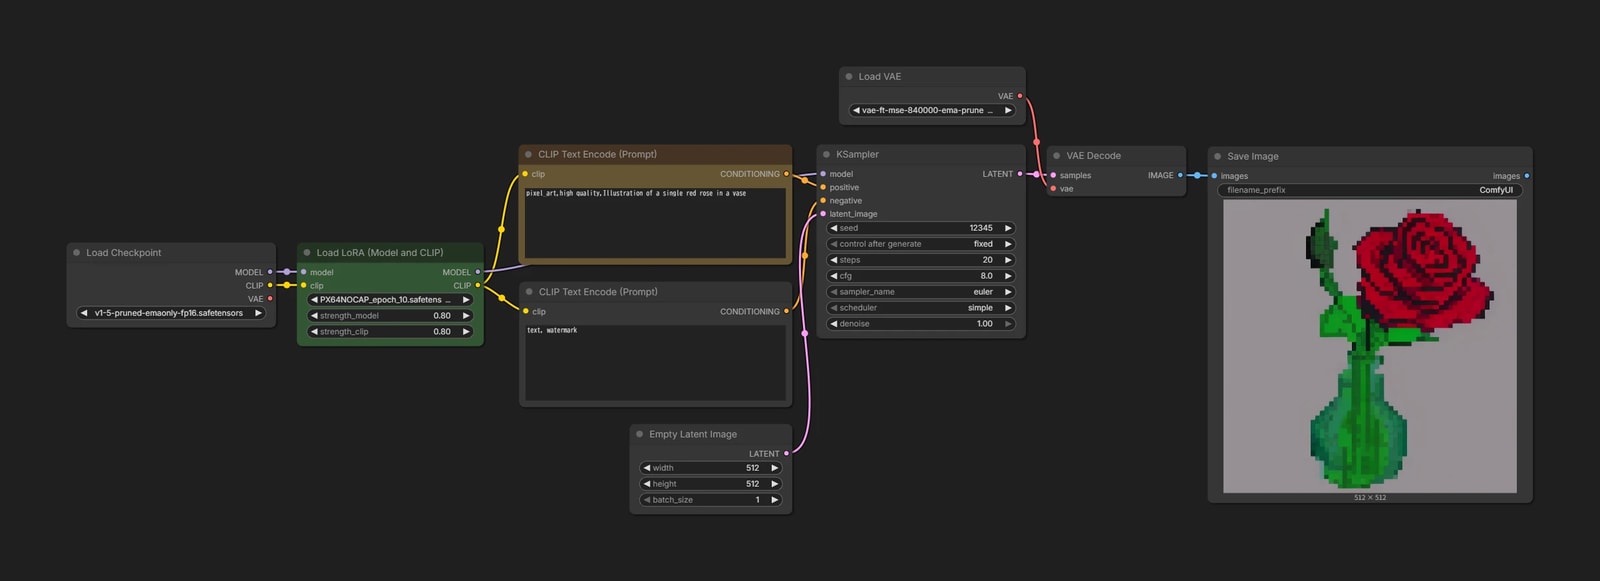
- 🟩
Load LoRA (Model and CLIP)ノードを追加します。Load CheckpointとCLIP Text Encode/KSamplerの間に挟む形で接続します。- MODEL と CLIP の両方を
Load LoRA (Model and CLIP)経由で通す必要があります。
strength_model/strength_clip: LoRA の適用強度です。基本は1.0ですが、効きすぎるときは下げます。- 🟨トリガーワード
- LoRA を適用しただけで、内部的にはドット絵を描く能力がベースモデルに上乗せされています。
- ただし、その能力を確実に引き出すには、作者が学習時に使ったワードをプロンプトに含める必要があります。
- これをトリガーワードと呼びます。今回の LoRA では
pixel_artがトリガーワードになっています。
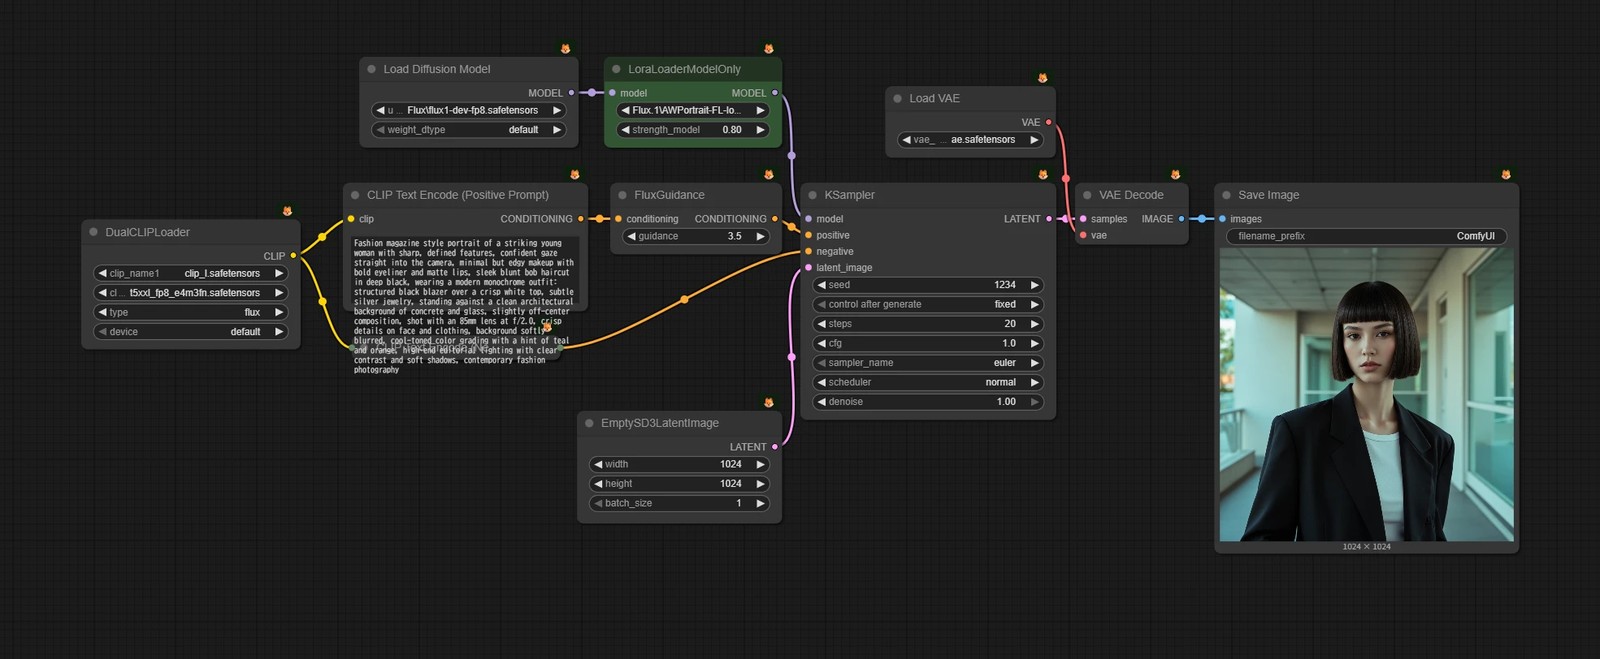
最近のモデルと LoRA
Stable Diffusion 1.5 や SDXL の頃は、画像を作る拡散モデルだけでなく、プロンプトを理解するテキストエンコーダも一緒に学習する LoRA がよく作られていました。
ただ、テキストエンコーダの学習は難しく、かえってプロンプトが効きづらくなることがあります。
SDXL ではテキストエンコーダが 2 つになり、その後に登場したモデルでは T5 や Qwen のような大きな言語モデルまで使われるようになりました。
そこで現在は、プロンプトの理解はベースのテキストエンコーダに任せ、拡散モデルだけを学習するのが主流になっています。
ComfyUI workflow
拡散モデルだけを学習した LoRA には、テキストエンコーダに適用するものが入っていないため、Load LoRA (Model and CLIP) ではなく Load LoRA ノードを使います。