什么是 LoRA?
Textual Inversion 虽然是将“用文本难以说明的外观”塞进 1 个单词的技术,但没有让模型从零画出原本不知道的东西的能力。
当想“让模型也能画出原本画不出的东西!”时,以前必须微调整个模型。
但是,学习成本相当高。
于是开始被使用的,就是原本在 LLM 中使用的 LoRA(Low-Rank Adaptation)。
LoRA 不是重写模型权重本身,而是采用将“变更部分”作为小的追加数据保存在外部的方式。
感觉就像是对基础模型,后来读取扩展包一样,可以增加新的风格和角色。
应用了 LoRA 的 text2image
LoRA 的下载
这次作为例子,使用变成像素艺术风的 LoRA。
-
  📂ComfyUI/
    └── 📂models/
        └── 📂loras/
            └── PX64NOCAP_epoch_10.safetensors
工作流
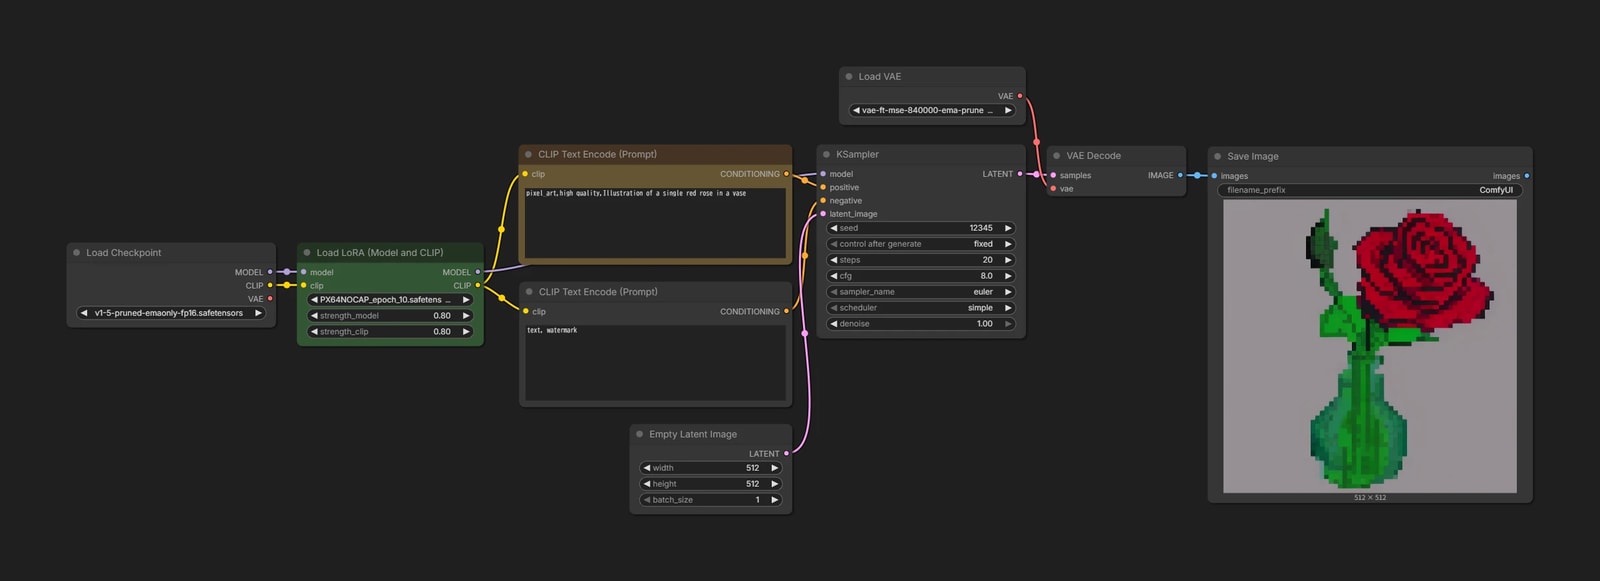
- 🟩 添加
Load LoRA (Model and CLIP)节点。- 以夹在
Load Checkpoint和CLIP Text Encode/KSampler之间的形式连接。 - MODEL 和 CLIP 两者都需要通过
Load LoRA (Model and CLIP)。
- 以夹在
strength_model/strength_clip: LoRA 的适用强度。基本是1.0,但如果效力太强就降低。- 🟨 触发词
- 虽然只是应用了 LoRA,但在内部,画点阵图的能力已经被叠加到了基础模型上。
- 但是,为了切实引出那个能力,需要在提示词中包含作者在学习时使用的词。
- 把这个称为触发词。这次的 LoRA 中
pixel_art是触发词。
最近的模型和 LoRA
在 Stable Diffusion 1.5 和 SDXL 的时期,经常会同时学习负责生成图像的扩散模型,以及负责理解提示词的文本编码器来制作 LoRA。
不过,文本编码器的学习很难,反而可能让提示词变得不容易生效。
SDXL 有两个文本编码器,后来登场的模型还开始使用 T5、Qwen 这样的大型语言模型。
因此,现在的主流做法是把提示词的理解交给基础文本编码器,只学习扩散模型。
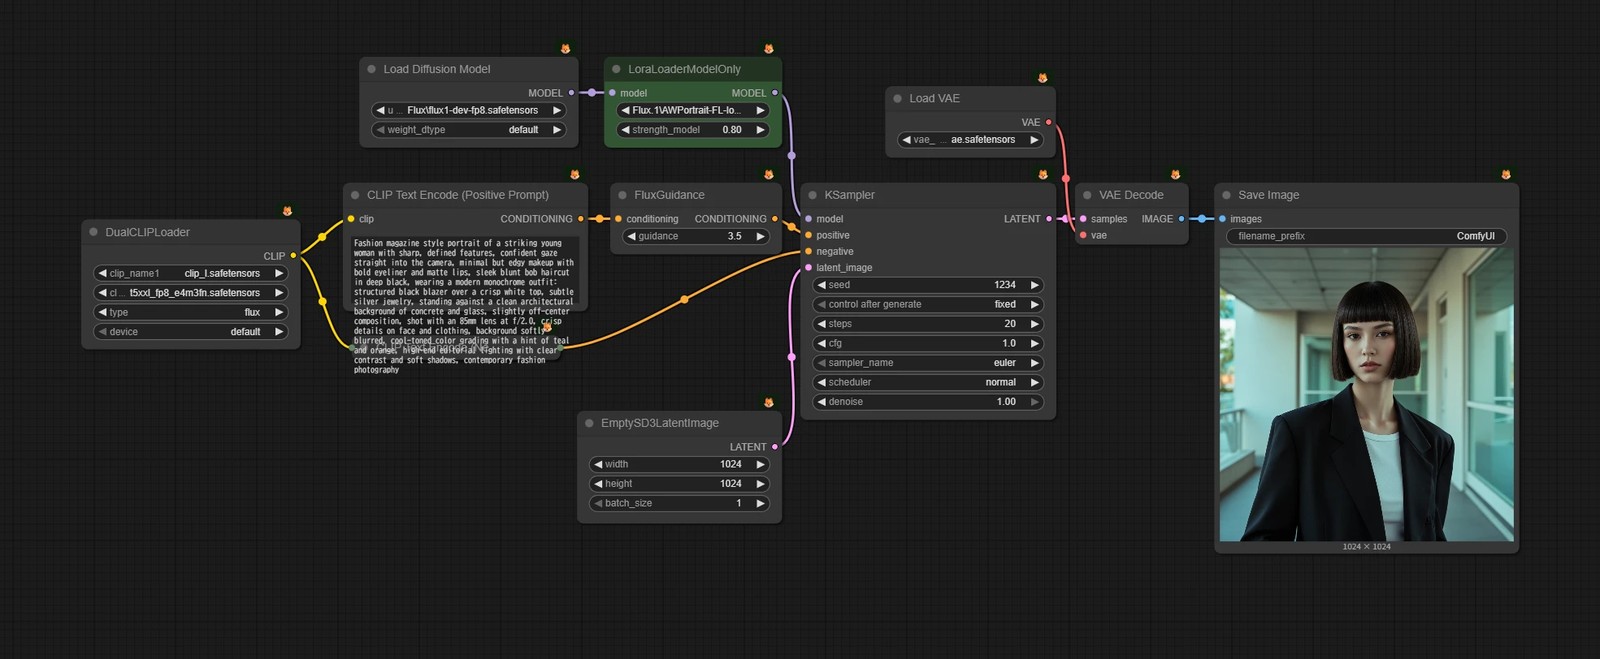
ComfyUI 工作流
只学习扩散模型的 LoRA 中没有需要应用到文本编码器的内容,因此使用 Load LoRA 节点,而不是 Load LoRA (Model and CLIP)。