什么是 LTX 2.3?
LTX 2.3 是 Lightricks 视频生成模型 LTX-2 的改良版。
基本思路和节点结构与 LTX-2 相同。
所以这一页只看 和 LTX-2 相比有什么变化。
推荐设定值
- 分辨率
- 最终输出建议在 1.5M 像素左右
- ※必须是 32 的倍数
- FPS
- 24 / 25 / 48 / 50
- 帧数
- 65 / 97 / 121 / 161 / 257
- 必须是
8n + 1
模型下载
- checkpoints
- ltx-2.3-22b-dev-fp8.safetensors (29.1 GB)
- latent_upscale_models
- loras
- text_encoders
- gemma_3_12B_it_fp8_scaled.safetensors (13.2 GB)
📂ComfyUI/
└── 📂models/
    ├── 📂checkpoints/
    │   └── ltx-2.3-22b-dev-fp8.safetensors
    ├── 📂latent_upscale_models/
    │   └── ltx-2.3-spatial-upscaler-x2-1.1.safetensors
    ├── 📂loras/
    │   └── ltx-2.3-22b-distilled-lora-384.safetensors
    └── 📂text_encoders/
        └── gemma_3_12B_it_fp8_scaled.safetensors
基本处理流程
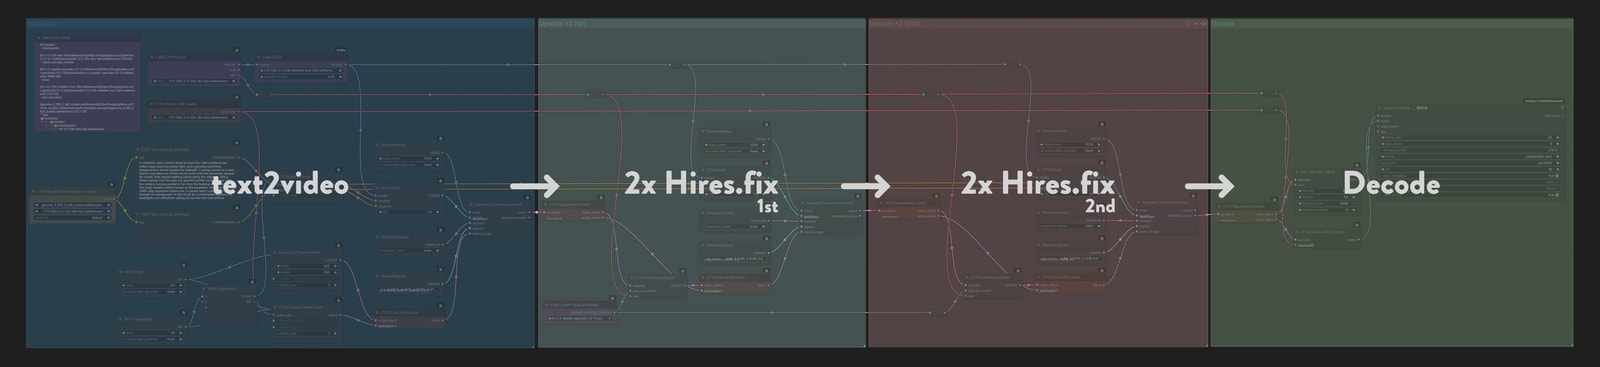
架构和 LTX-2 一样,所以 workflow 本身也可以直接沿用。
不过,如果原样照搬,结果通常不会太好。
所以这里采用社区总结出来的 3stage workflow。
原本 LTX-2 是先在低分辨率生成,再用 Hires.fix 放大到 1.5MP 的 2stage 方案。
而在 2.3 里,会再多加一段:先在非常小的分辨率生成,做一次 2 倍 Hires.fix,再做一次 2 倍 Hires.fix。
这不是官方推荐的方法,但结果明显更好,所以这里采用它。
这里全部使用
distilled-lora的 8 步生成。
关于提示词
和 LTX-2 一样,提示词的质量会直接影响生成视频的质量。
建议参考官方提示词指南,尽量写得更具体、信息量更足一些。
也可以让 LLM 帮你整理提示词。把参考链接和想生成的内容交给它,让它帮你润色即可。
ComfyUI 里有一个可以在核心中运行 LLM 的 TextGenerate 节点。
很多 LTX-2 workflow 会用它来整理提示词,不过它本质上也只是一个用来修正提示词的节点,所以这一页里的 workflow 并没有使用它。
就我个人来说,还是直接用 ChatGPT 或 Gemini 在外面先把提示词写好更轻松。
text2video
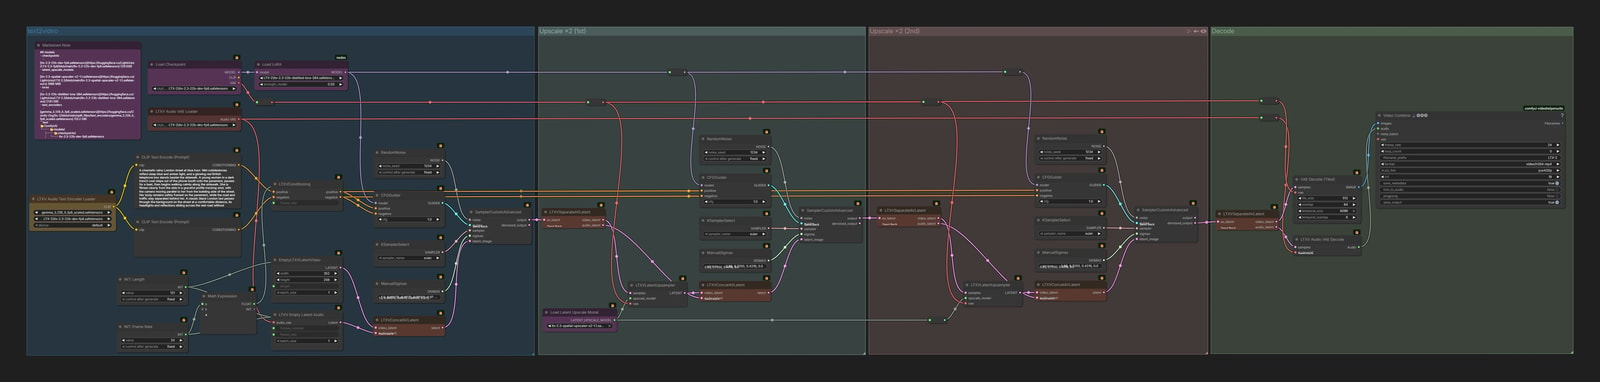
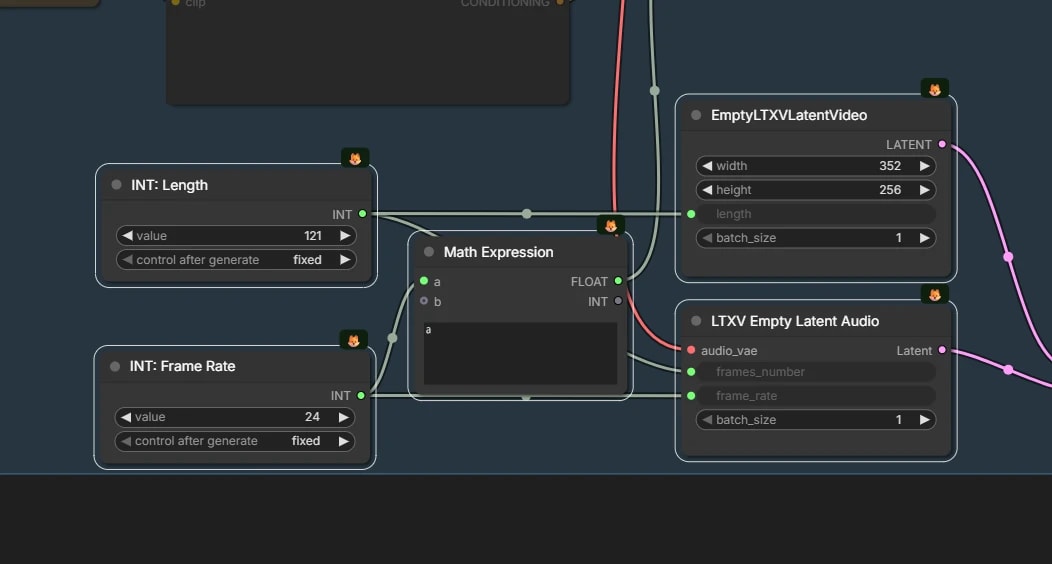
设置视频分辨率、时长和 FPS
这里决定你要生成的视频和音频参数。
- 在
EmptyLTXVLatentVideo/LTXV Empty Latent Audio中输入分辨率、帧数和 FPS - 🚨这里和 LTX-2 不同
- 因为要做两次 2 倍放大,最终宽高会变成 4 倍,所以这里要按这个前提,把初始值设在 0.1MP 左右
image2video

audio2video

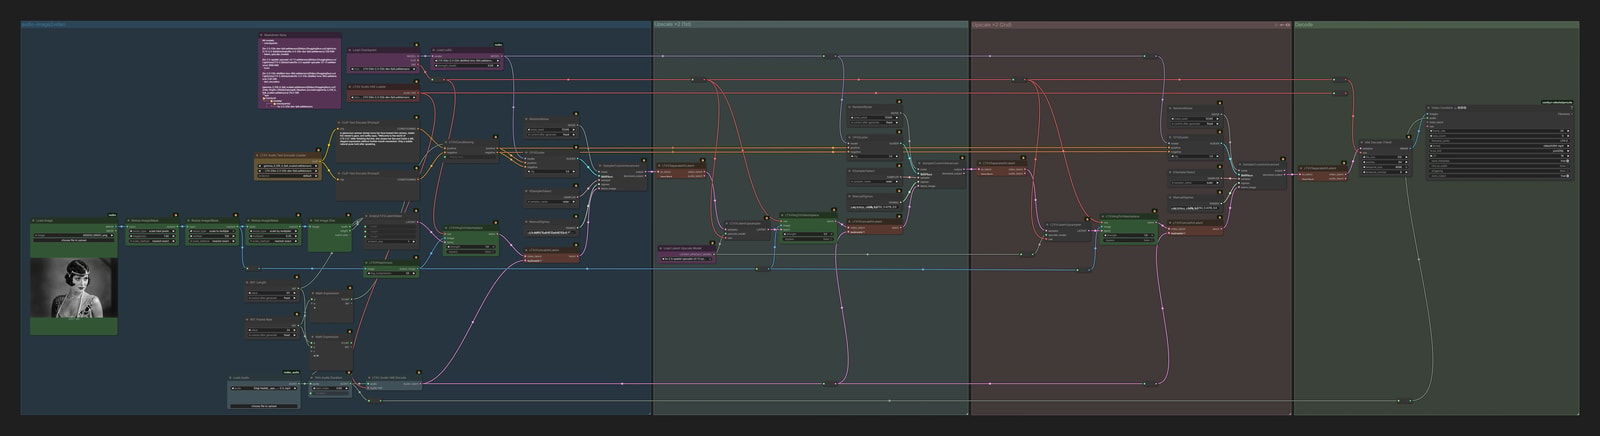
audio-image2video
Generative Interpolation
也叫 FLF2V 或 FMLF2V,可以理解为把图片插到中间帧里,再把这些图片当作参照来生成视频的机制。
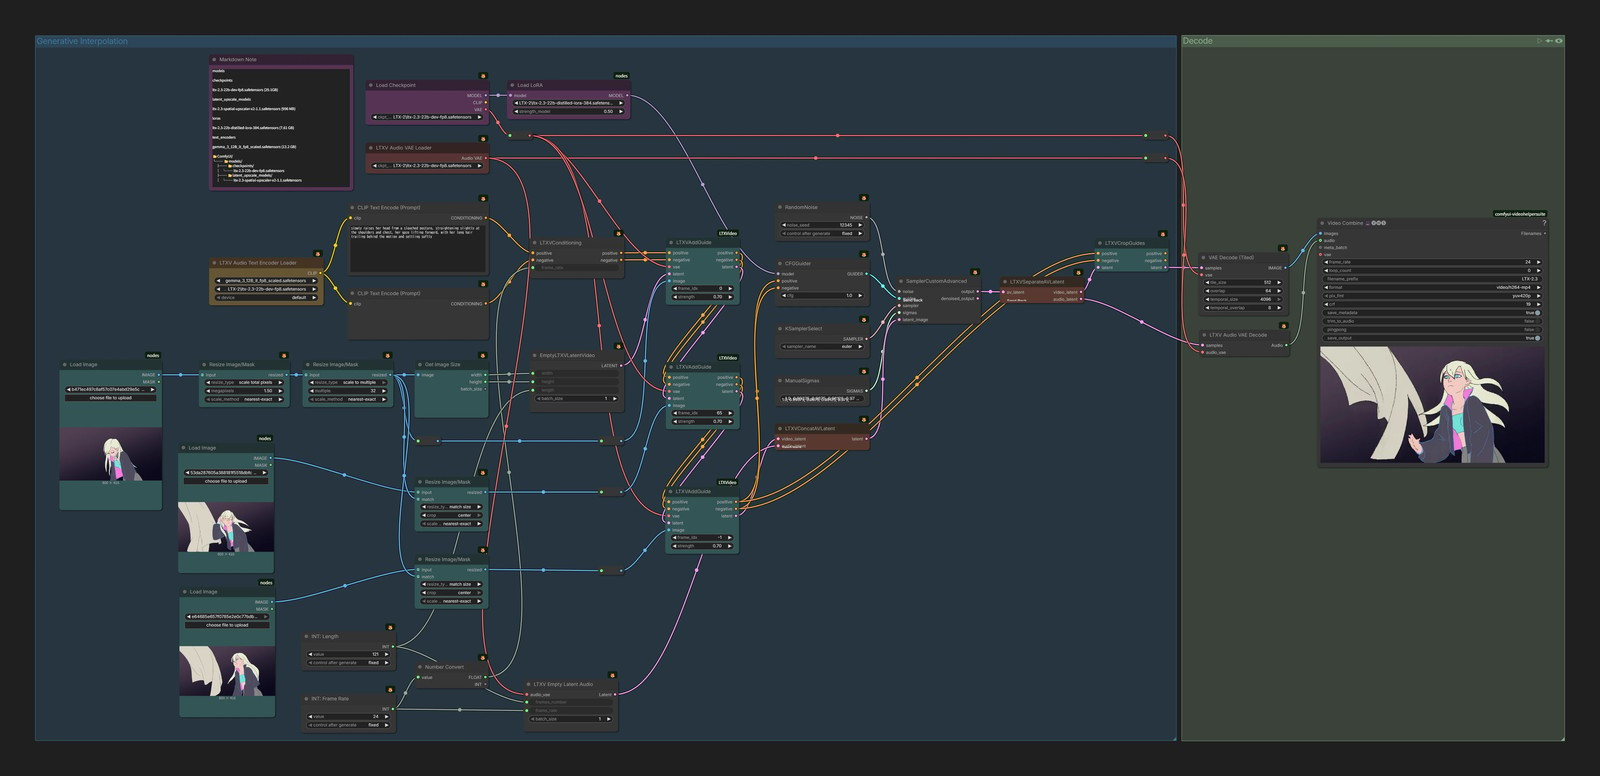
它看起来像是 image2video 的延伸,但底层机制其实不同。
image2video 是把第一帧直接替换成参考图,再生成后面的帧。
而这里则是在中间的多个帧位置旁边放上参考图,作为生成时的 guide。
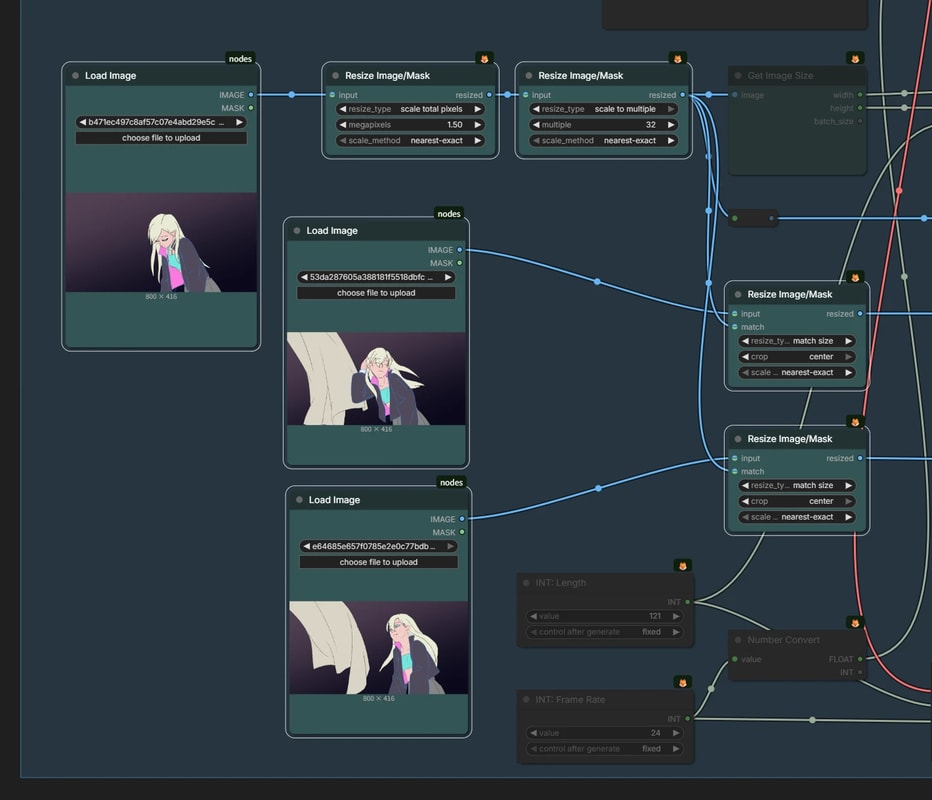
调整图片尺寸
先把参考图调整到合适的尺寸(约 1.5 MP)。
- 第二张之后的图片,也需要和第一张调整成相同尺寸。
Resize Image/Mask节点里的match size模式可以很方便地完成这件事。
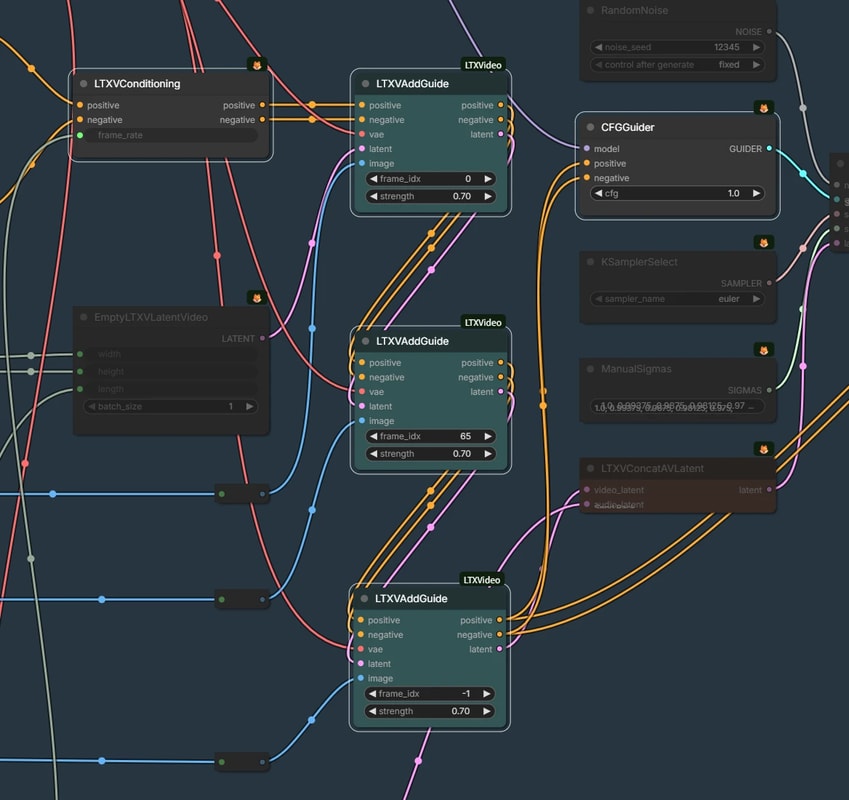
LTXVAddGuide
在这里把参考图作为 guide 插进去。
- 在
frame_idx中输入要插入的帧位置和图片。0: 第一帧-1: 最后一帧
- 这个 workflow 里放了 3 个参考帧,不过如果串联下去,也可以继续增加
- 反过来说,如果只放 1 张,就会有点像
image2video;如果只在最前和最后放图,那就是 FLF2V。
- 反过来说,如果只放 1 张,就会有点像

LTXVCropGuides
LTX-2 的 guide 机制里,如果直接输出,生成出来的视频会混入这些 guide 图片。
所以这里要用 LTXVCropGuides 节点把 guide 部分裁掉。
更具体的行为可以参考这里。
IC-LoRA
LTX-2.3 也可以像 LTX-2 一样使用 IC-LoRA 系扩展。
种类有几种,不过这里先介绍两种比较好理解的。
- Union
- 用 pose、深度图和 edge 作为条件来生成视频
- Outpaint
- 自然补全输入视频里的黑色区域
模型下载
- ltx-2.3-22b-ic-lora-union-control-ref0.5.safetensors (654 MB)
- ltx-2.3-22b-ic-lora-outpaint.safetensors (1.31 GB)
📂ComfyUI/
└── 📂models/
    └── 📂loras/
        ├── ltx-2.3-22b-ic-lora-union-control-ref0.5.safetensors
        └── ltx-2.3-22b-ic-lora-outpaint.safetensors
IC-LoRA Union (Pose)
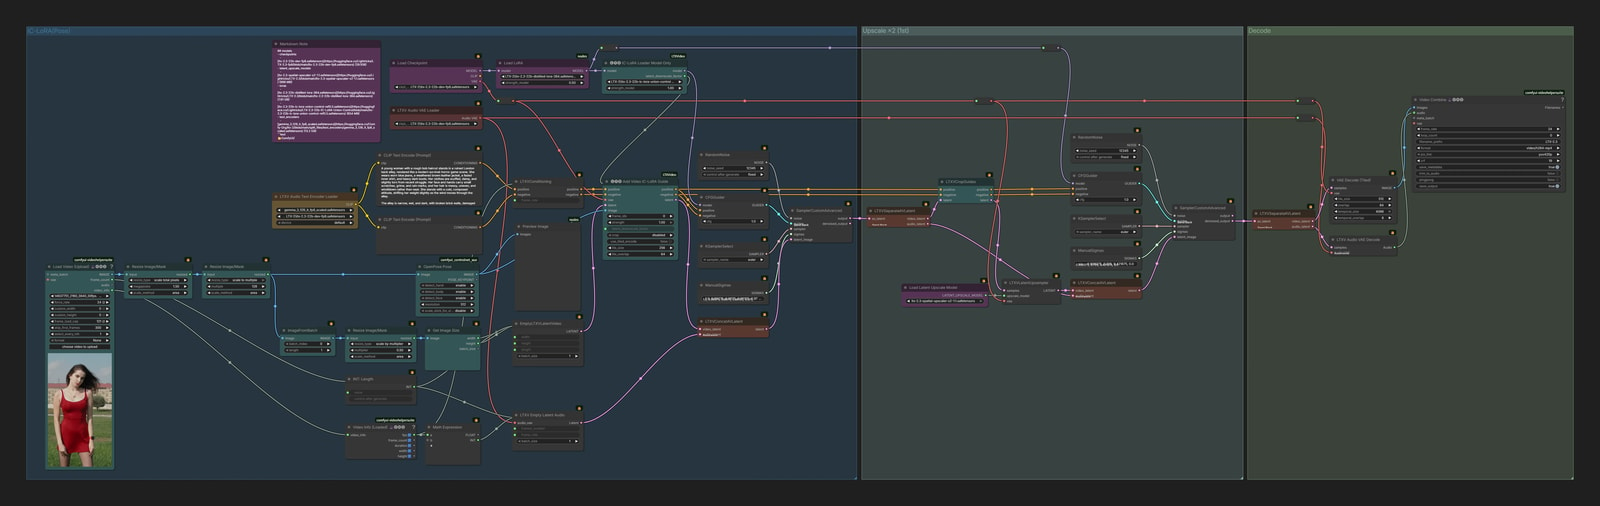
- 🚨IC-LoRA 时使用的不是 3 stage,而是 2 stage workflow
- IC-LoRA Union 有一点比较特殊:它使用的是生成视频一半分辨率的控制视频
- 所以如果用 3 stage,控制图像的分辨率会继续缩小,最后大概只剩 100px 左右
- 小到这个程度后,就很难继续保留足够的信息来做控制
- 所以 IC-LoRA 停在 2 stage 会更稳定
IC-LoRA Outpaint
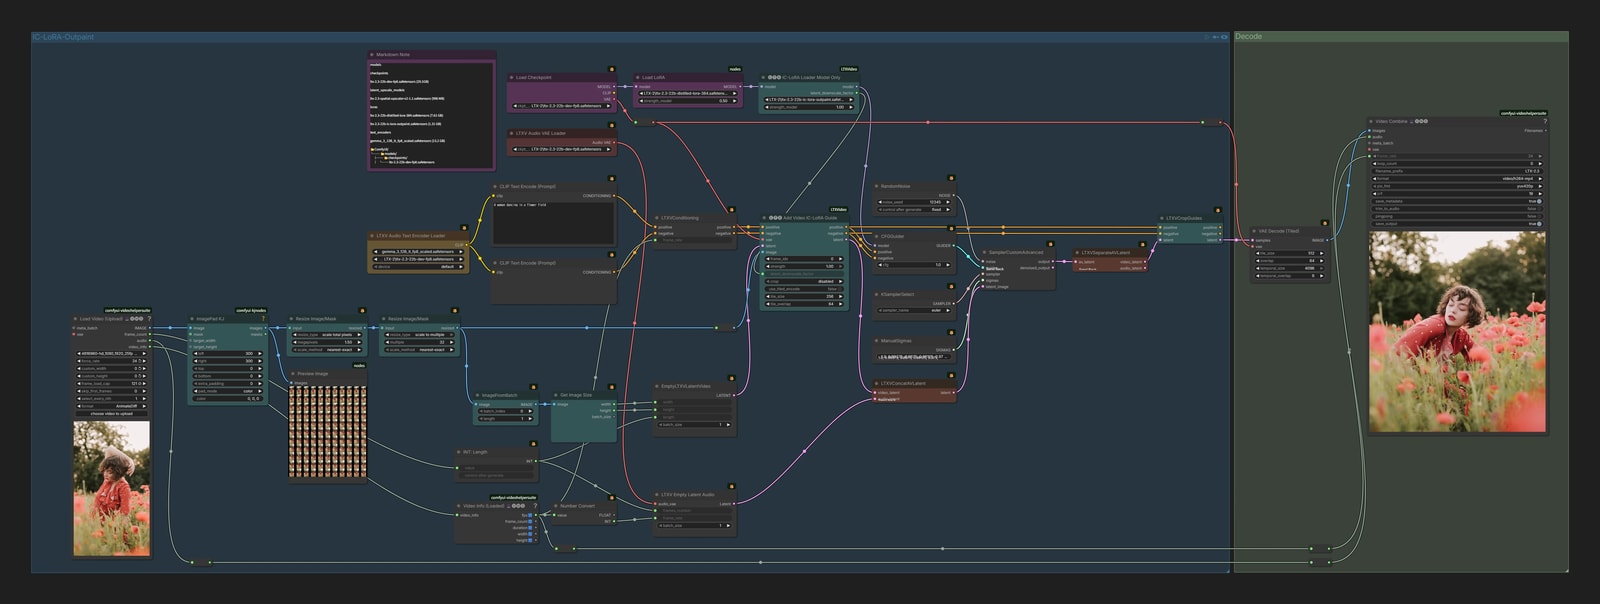
这是一个用来自然补全输入视频中黑色区域的 workflow。
为了尽量保留原始视频,不采用从低分辨率逐步放大的 3stage,而是使用 1stage。
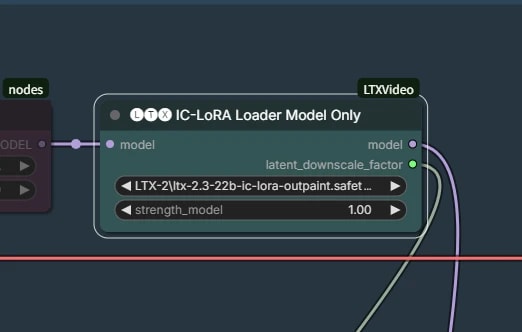
读取 LoRA 模型
在这里读取 IC-LoRA-Outpaint 的 LoRA。
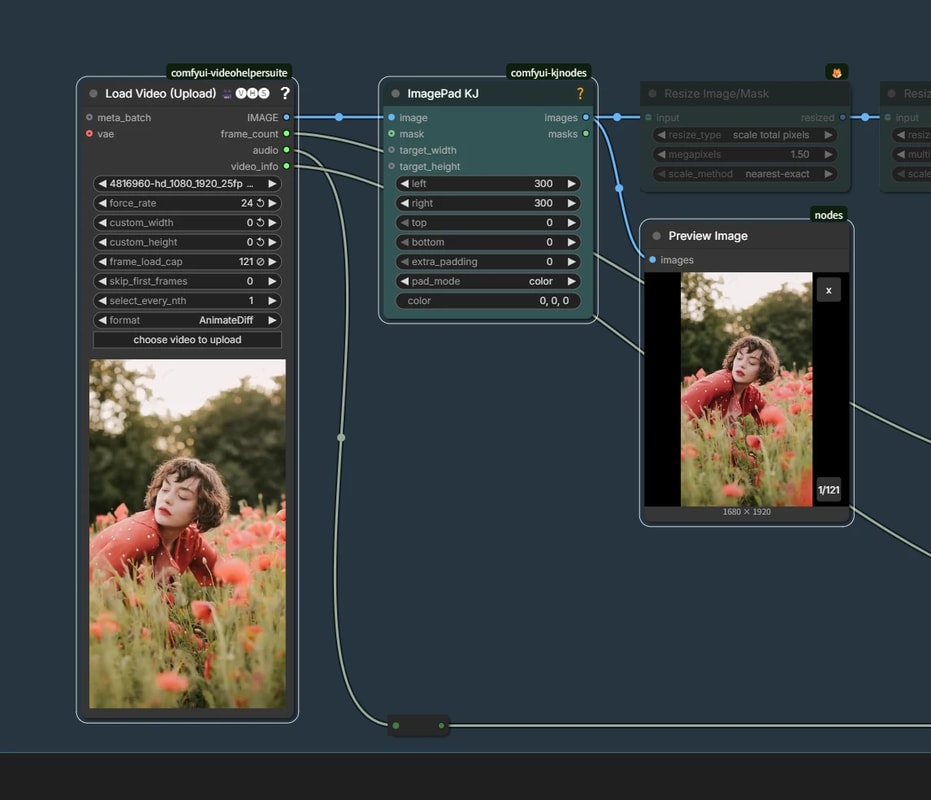
用黑色做 Padding
用黑色 Padding 把想扩展的区域加出来。
这里不需要特别准备 mask,只要新增区域是黑色就可以。
- 我还没试过,不过感觉也许可以拿来做类似 inpainting 的用法
ID-LoRA
通过 1 张参考图、1 段短参考音频和文本提示词,生成“这个人在这个场景里说出这些内容”的 talking head 视频。
它和先做语音克隆、再把音频送进 audio-image2video 不一样,ID-LoRA 是同时生成音频和视频的。
因此,嘴部动作和声音气质往往会更统一一些。
模型下载
- LTX-2.3-ID-LoRA-CelebVHQ-3K.safetensors (1.16 GB)
- LTX-2.3-ID-LoRA-TalkVid-3K.safetensors (1.16 GB)
这两个发布文件的名字都叫
lora_weights.safetensors。
为了便于区分,建议分别重命名为LTX-2.3-ID-LoRA-CelebVHQ-3K.safetensors和LTX-2.3-ID-LoRA-TalkVid-3K.safetensors。
📂ComfyUI/
└── 📂models/
    └── 📂loras/
        ├── LTX-2.3-ID-LoRA-CelebVHQ-3K.safetensors
        └── LTX-2.3-ID-LoRA-TalkVid-3K.safetensors
workflow
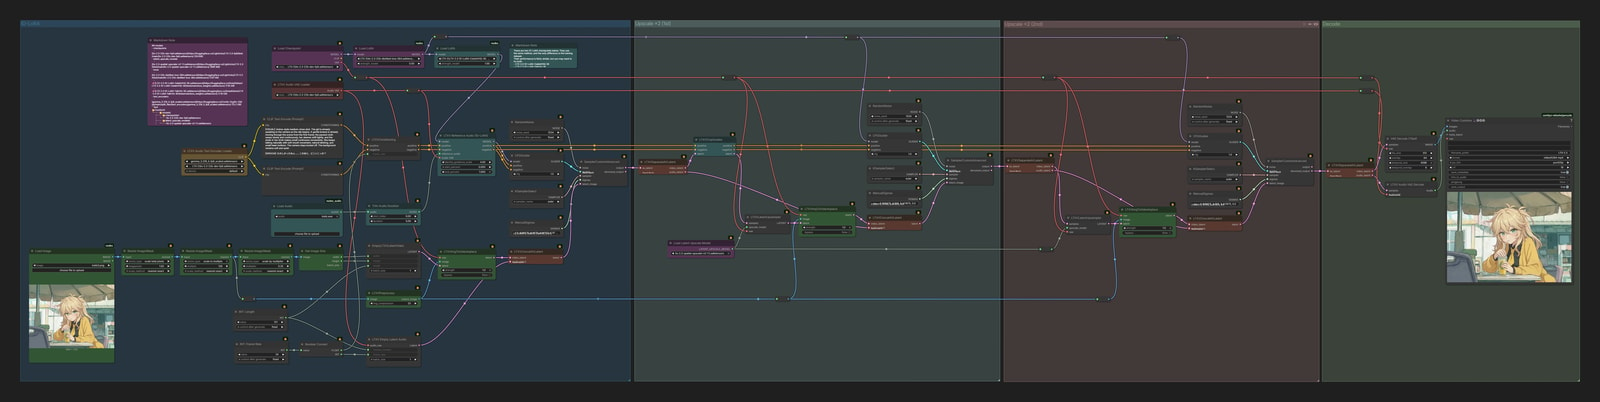
整体是以 image2video 为基础。
然后再加上 ID-LoRA 的 LoRA 和参考音频条件。
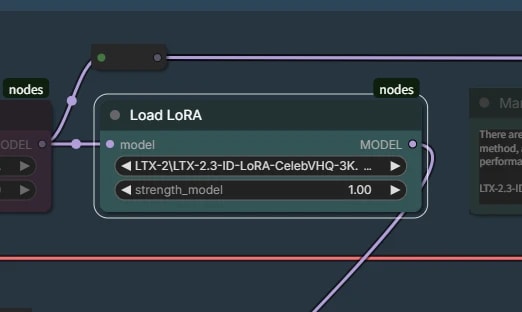
ID-LoRA 模型
加载 ID-LoRA。
- LTX-2.3-ID-LoRA-CelebVHQ-3K
- LTX-2.3-ID-LoRA-TalkVid-3K
这两个版本的方法本身是一样的,只是训练数据集不同。
差别不算太大,不过还是建议两个都试试,看看哪个和你的素材更合拍。
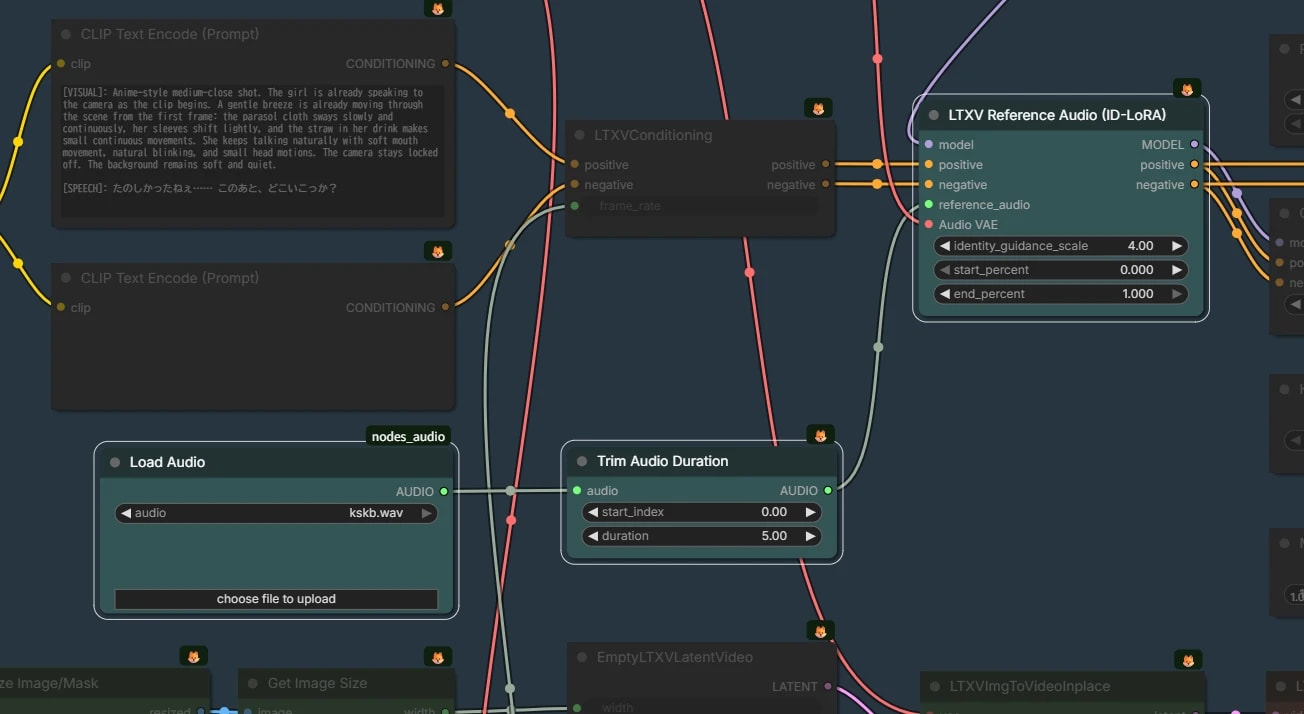
LTXV Reference Audio (ID-LoRA)
把 ID-LoRA 和参考音频连接起来。
- 参考音频建议裁成 5 秒左右
- 它只是作为参考,不会决定最终视频的时长
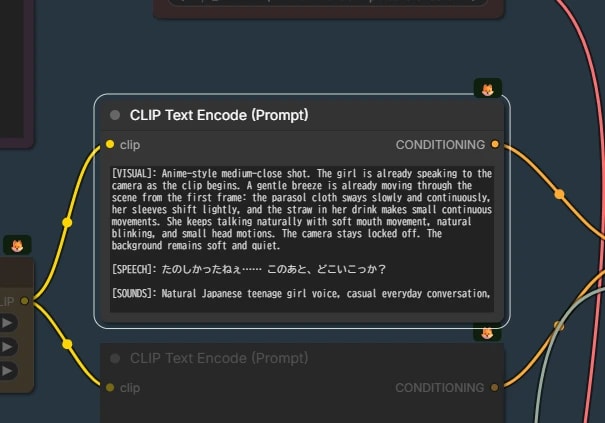
提示词
提示词格式是固定的,按这个结构来写。
[VISUAL]: 场景描写和人物外观
[SPEECH]: 人物说的台词
[SOUNDS]: 说话方式 + 环境音 / 周围声音
- 为了避免最后变成“只有声音盖在画面上”的感觉,最好也在
[VISUAL]里写清楚人物正在实际开口说话