3D 生成
3D 生成,顾名思义是根据文本提示词或参考图像制作 3D 模型的任务。
如果能像 text2image 那样,单纯地从噪点中出现模型就好了,但正如视频在时间轴方向上多了一个维度一样,3D 生成在空间方向上增加了维度,因此无法简单实现。
先说明一下,3D 生成还没有达到专业使用的性能。 但是,从图像中创造模型,甚至创造可以四处走动的世界的技术正在稳步成长。
让我们稍微追踪一下这项正处于发展中的技术的潮流。
※ 无论是时间顺序还是技术关联都相当随意。请随意看看。
3D 生成
多视角生成
原本就存在 NeRF 这种从图像制作 3D 空间・模型的技术。 但是,要用 NeRF 构建 3D,需要从各种视角观察同一对象的图像。
出于这个观点诞生的就是多视角生成。
Zero-1-to-3
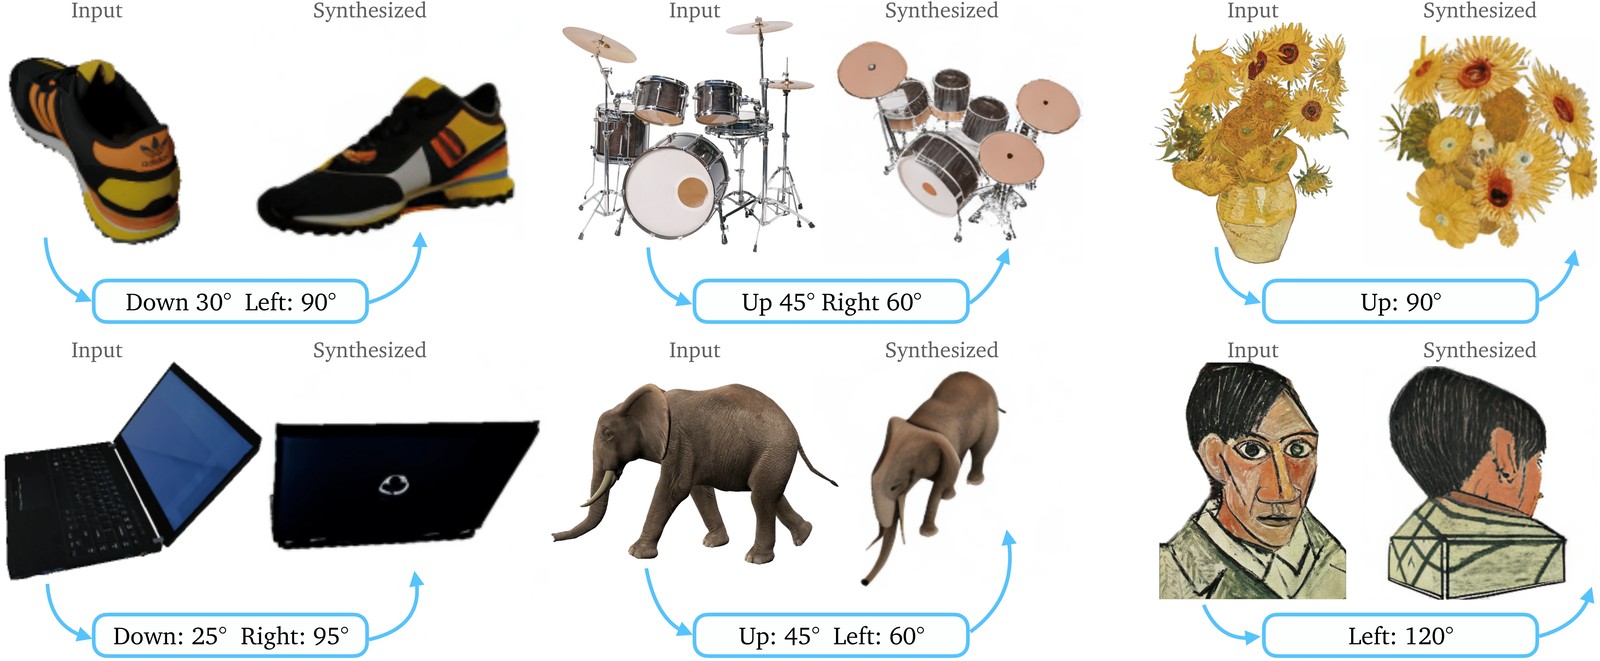
基于扩散模型的最初期的多视角生成,生成改变了输入图像相机构图的新视角的图像。
当时觉得无论是否用于 3D 生成都很方便,但要求规格太高没能用上。 现在,用基于指令的图像编辑可以很容易地做类似的事情呢。
Zero123++
Zero-1-to-3 是“制作一张输入图像的别角度图像 → 改变角度多次旋转”的用法,但 Zero123++ 是同时生成多个视角。
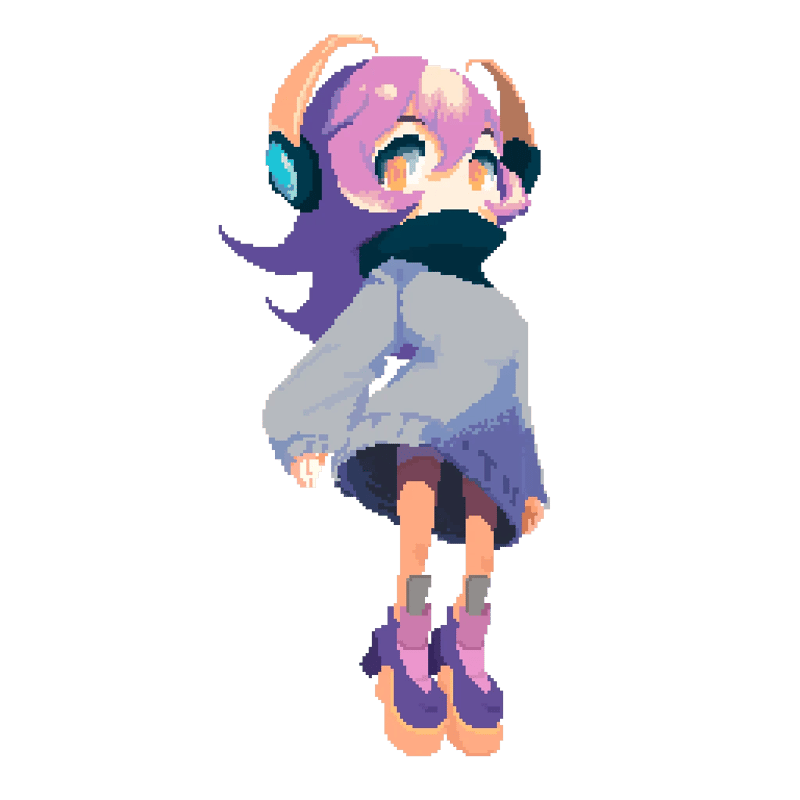
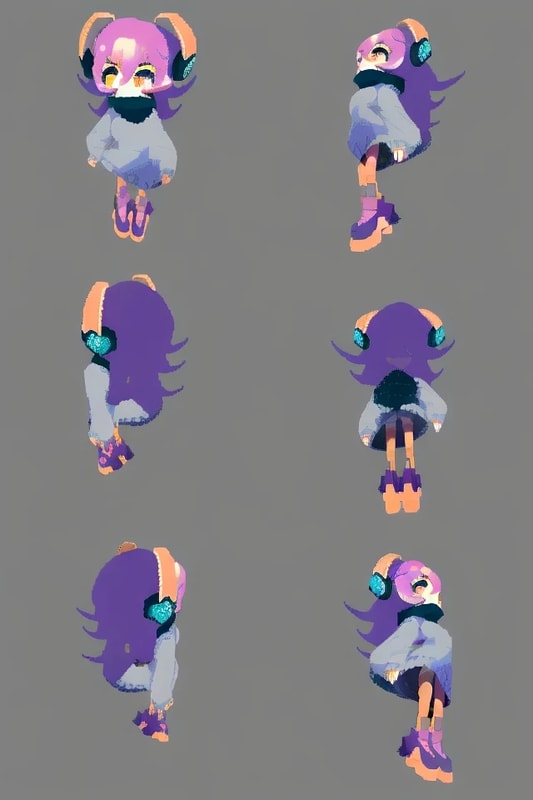
众所周知,扩散模型如果批量生成多张(cf. Batch・视频),生成的图像之间在某种程度上具有一致性。
3D 生成从一开始就需要全方位的多张图像。 Zero123++ 可以说是利用了这个性质,朝着“一次生成,尽可能汇总制作一致的多视角”方向发展的模型。
视频生成模型的登场
稍微晚一点,能够生成视频的模型开始登场。
在这里,出现了能不能不把多视角生成作为“图像编辑的一种”来处理,
绕着对象物体转一圈拍摄的视频 = 被切分得非常细的多视角
而是作为这样来处理呢?的想法。
Stable Video 3D
基于 Stable Video Diffusion 的 image2model。
- 输入一张静止画
- 生成该物体旋转一圈的 360 度视频
- 将视频的各帧作为别视角的图像处理,从中恢复 3D
将视频生成模型应用于 3D 模型生成这一潮流本身现在也在持续。
现在的视频生成模型比那时性能高得多,所以即使不进行专用的微调,也能生成高精细的 360 度旋转视频呢。
直接瞄准 image→3D 模型的模型
到现在为止,前提是
- 首先收集多视角(或者旋转视频)
- 用别的机制把它变成 3D
这样的“两段构成”。
从那里更进一步,
输入是图像(或文本),输出直接是 3D 模型
正面瞄准这种形式的模型已经出现了。
Hunyuan3D-2.1
Hunyuan3D-2.1 是用于从图像或文本制作 3D 资产的大规模模型。
- 首先是只输出“形状”部分的阶段(粗略的 3D 形状)
- 之后是贴上包含 PBR 纹理的高分辨率外观的阶段
是这样的两段构成。
SAM 3D Objects
SAM 3D Objects 是从一张实景图像恢复 3D 对象的模型。
- 2D 侧使用 SAM 系的分割,好好地切出对象物体
- 以切出的区域为线索,一边补充隐藏的部分一边推断 3D 形状和纹理
是这样的流程。
虽然技术上的内容完全是两码事,但两者都是试图从正面解开“image → 3D 模型”的东西。
World 模型
到此为止,都是关于将单一对象 3D 模型化的故事。 另一方面,从照片创造整个世界的尝试也在进行中。
这里说的“World 模型”,比起世界模型(物理预测),更多的是 构建 3D 世界(场景)的模型 的意思。
360 度全景生成
起步是 360 度全景生成。
Latent Labs 的工具,或 HunyuanWorld-1.0 等相当于此。
- 将输入图像贴在全景球面上
- 用 outpainting 补充没有拍到的方向
通过这种简单的想法,制作“通过 360 度填补的外观”。
在这个阶段还不能说是 3D,但试图通过组合深度图或网格恢复,来构建有进深的 3D 空间。
HunyuanWorld-Mirror
到了 HunyuanWorld-Mirror,就更接近于本质上制作可以走动的世界了。
- 由以图像(或视频)为输入,汇总推断相机信息、深度、3D 表现(3D Gaussian 等)的组件构成。