Ideogram 4.0 是什么?
Ideogram 4.0 是一个 9.3B 的 DiT 系模型。
它最大的特点是:用 JSON 格式的 caption,可以相当细致地指定图像里的各个元素。
以前也有类似思路的 FIBO,但 Ideogram 4.0 更擅长用 BBOX 指定坐标,也更擅长颜色指定。海报、Logo、UI、包装这类偏 DTP 的设计任务,会比较适合它。
作为换取可控性的代价,提示词必须按既定格式来写才能发挥出本来的性能,所以它可能算不上一个随手就能用的模型。
下载模型
- diffusion_models
- ideogram4_fp8_scaled.safetensors (9.28 GB)
- ideogram4_nvfp4_mixed.safetensors (5.49 GB)
- ideogram4_unconditional_fp8_scaled.safetensors (9.28 GB)
- ideogram4_unconditional_nvfp4_mixed.safetensors (5.49 GB)
- text_encoders
- qwen3vl_8b_fp8_scaled.safetensors (10.6 GB)
- vae
- flux2-vae.safetensors (336 MB)
📂ComfyUI/
└── 📂models/
    ├── 📂diffusion_models/
    │   ├── ideogram4_fp8_scaled.safetensors
    │   ├── ideogram4_nvfp4_mixed.safetensors
    │   ├── ideogram4_unconditional_fp8_scaled.safetensors
    │   └── ideogram4_unconditional_nvfp4_mixed.safetensors
    ├── 📂text_encoders/
    │   └── qwen3vl_8b_fp8_scaled.safetensors
    └── 📂vae/
        └── flux2-vae.safetensors
详细原因后面再说,它需要加载两个 Diffusion model,所以相当重。
ComfyUI 会在内部帮忙调配,所以即使 VRAM 不够,也不至于完全无法生成,但会非常慢。
想减轻负担,可以使用 nvfp4,不过画质会下降。
unconditional 那边对质量的影响较小,所以普通模型用 fp8、unconditional 模型用 nvfp4,也许是不错的选择。
提示词
只用普通自然语言也能生成,但如果不按既定的 JSON schema 来写,质量很难出来。
基本形式如下。
{
  "high_level_description": "图像整体的 1~2 句说明。",
  "style_description": {
    "aesthetics": "氛围、审美方向。",
    "lighting": "光照。",
    "medium": "illustration / photograph / graphic_design 等。",
    "art_style": "非照片时的画风。",
    "color_palette": ["#FFFFFF", "#000000"]
  },
  "compositional_deconstruction": {
    "background": "背景、环境说明。",
    "elements": [
      {
        "type": "obj",
        "bbox": [100, 200, 800, 700],
        "desc": "物体、人物、元素说明。",
        "color_palette": ["#FFFFFF", "#000000"]
      },
      {
        "type": "text",
        "bbox": [820, 200, 920, 800],
        "text": "HELLO",
        "desc": "文字外观说明。",
        "color_palette": ["#000000"]
      }
    ]
  }
}
整体说明、风格、背景、各元素的说明,结构本身很简单,但总不能每次都手写这么一大段。
尤其是坐标指定很麻烦。每个元素要放在图像的哪里,都要用 BBOX 指定,光靠脑子想象基本不可能。
所以这里介绍几种生成提示词的方法。
交给 LLM
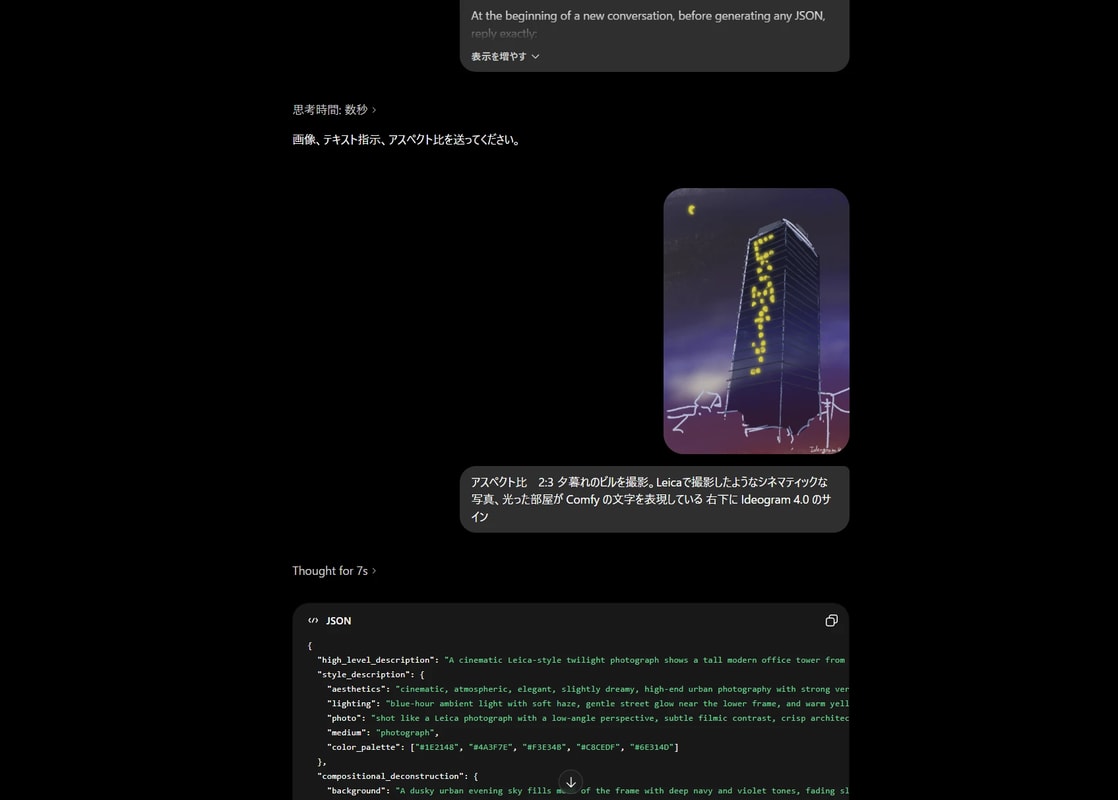
最轻松的方法,是把官方的 Prompting Guide 和想做的图像说明交给 LLM,让它转换成 JSON caption。
把参考图或者自己画的草图丢给它来生成,也是不错的办法。
能在 ComfyUI 上跑的本地模型,性能还不太够,所以还是老老实实交给 ChatGPT、Gemini 之类比较好。
使用专用提示词构建器
也可以用专用的提示词构建器,以可视化的方式制作提示词。
例如 ComfyUI-KJNodes 里的 Ideogram 4 Prompt Builder KJ 节点,就是比较常用的一个。
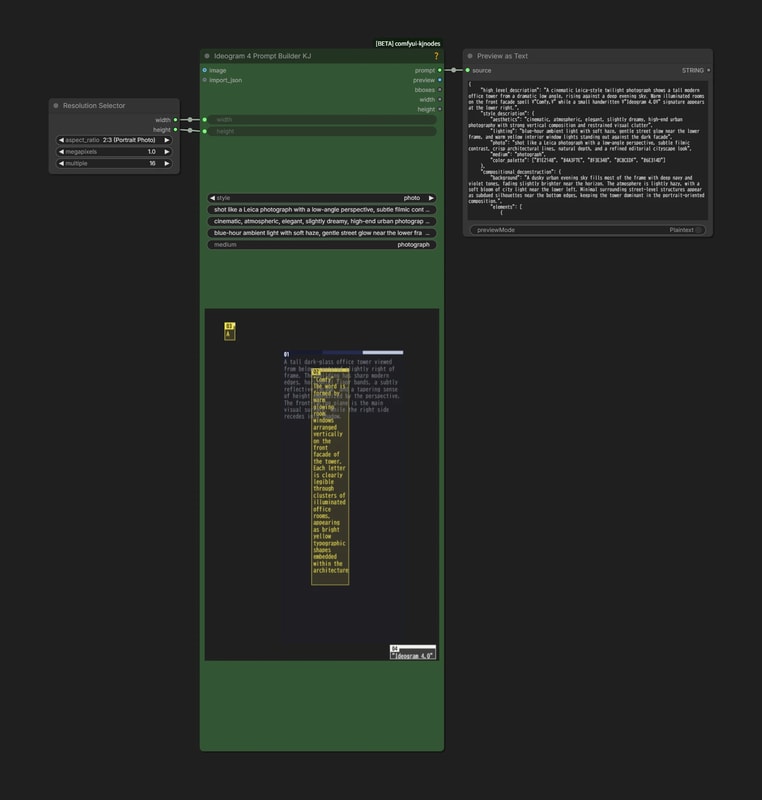
- 设置生成图像的尺寸,然后填写背景、风格等内容。
- 在 region 栏拖动即可创建 BBOX,并为该区域设置想画的内容提示词和颜色代码。
text2image
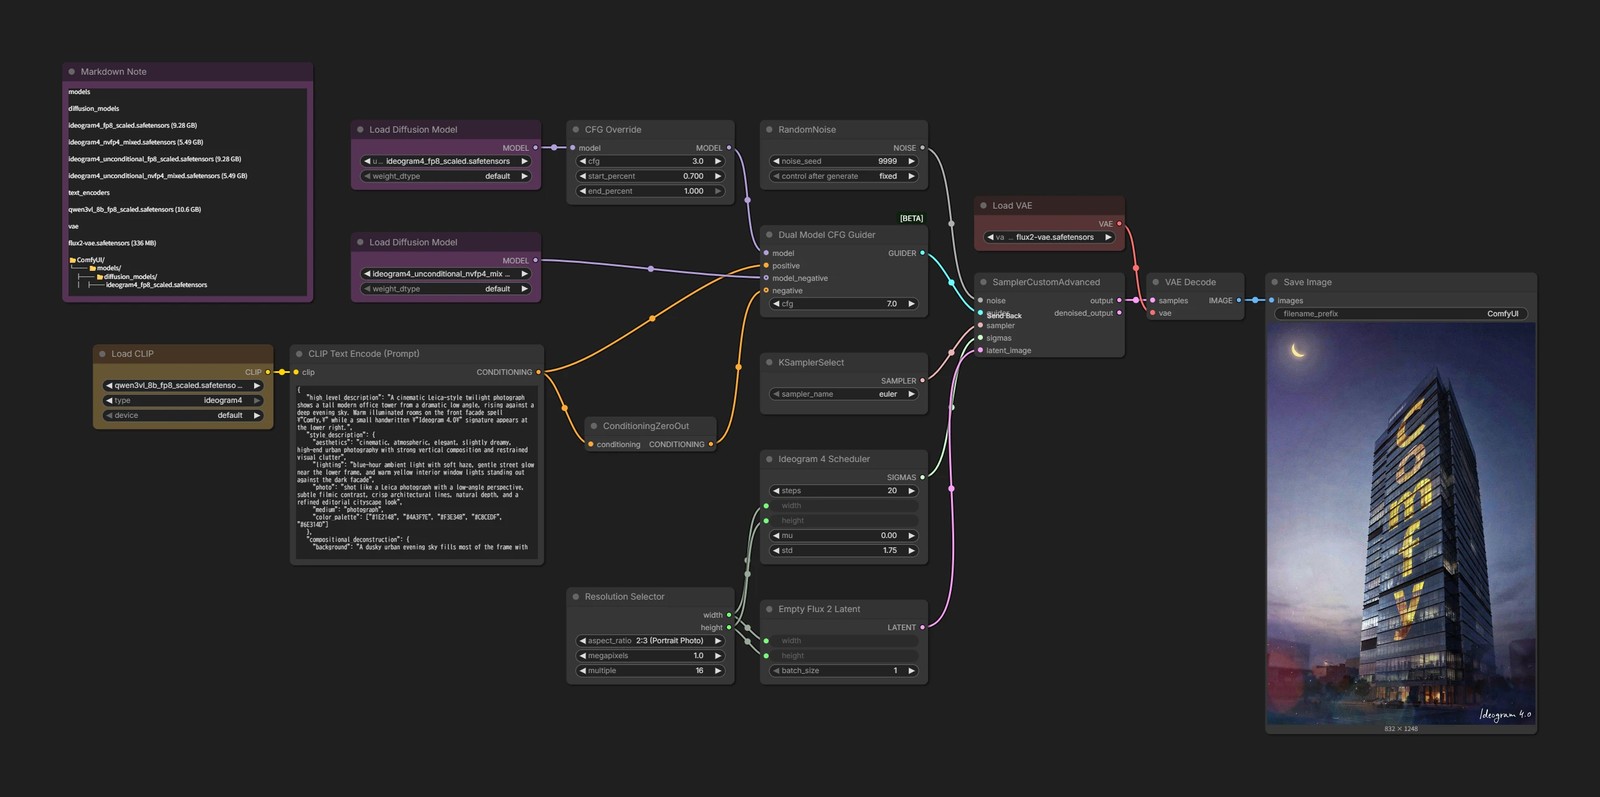
除了提示词之外,它和一般的工作流相比还有一些特殊的地方,这里只看这些部分。
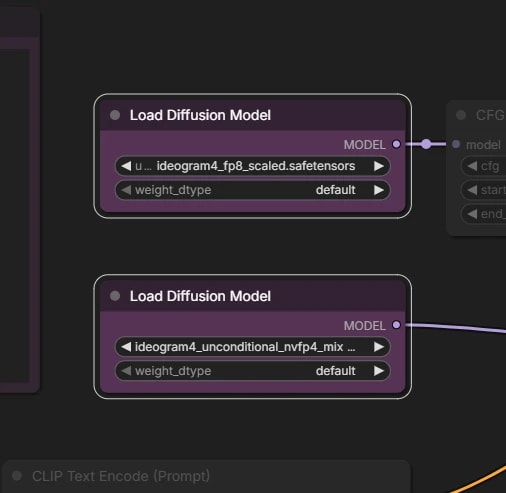
Load Diffusion Model
Ideogram 4.0 因为采用了一种稍微特殊的 CFG,需要加载两个 diffusion model。
- 普通的 CFG 会比较有提示词和没有提示词时的结果,把生成往提示词的方向推。
- 而 Ideogram 4.0 的 unconditional 侧不是传入空提示词,而是把不使用文本 token 的 image-only 输入送进 unconditional 专用模型。
- 可能会觉得这有什么不一样,大概可以理解成是为了更细腻地处理 positive prompt 而下的功夫吧。
Ideogram 4 TurboTime LoRA
这是 Ostris 发布的 LoRA,可以用于 2〜8 step 生成。
下载模型
- loras
- ideogram_4_turbotime_v1.safetensors (847 MB)
📂ComfyUI/
└── 📂models/
    └── 📂loras/
        └── ideogram_4_turbotime_v1.safetensors
text2image (8 step)
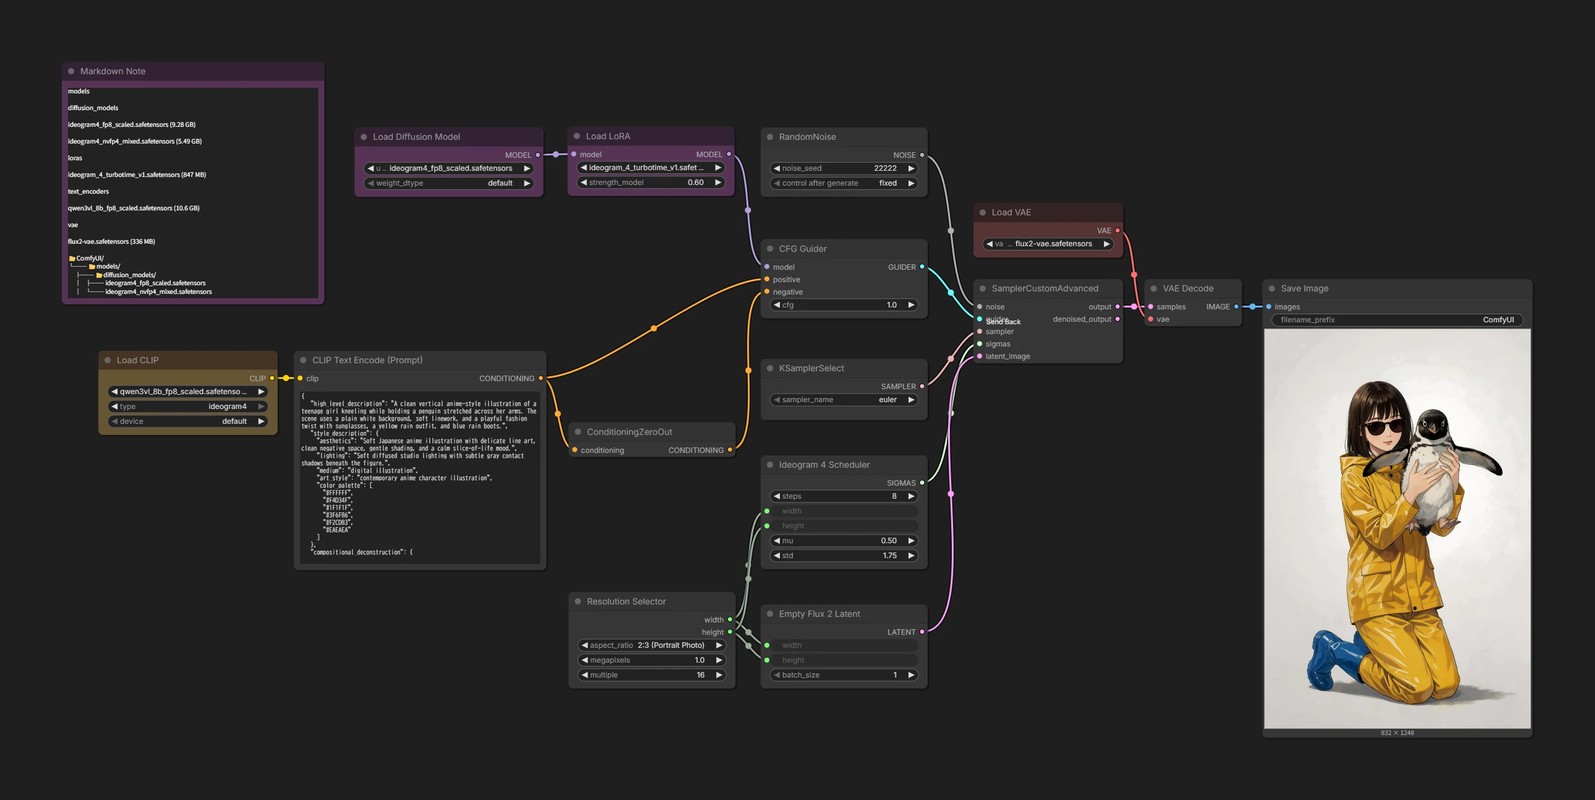
- 由于使用 CFG 1.0 生成,因此不需要 unconditional model。
- 虽然标称适用于 2〜8 step,但 step 数太少时画面会明显开始崩坏,所以目前用 8 step 比较好。
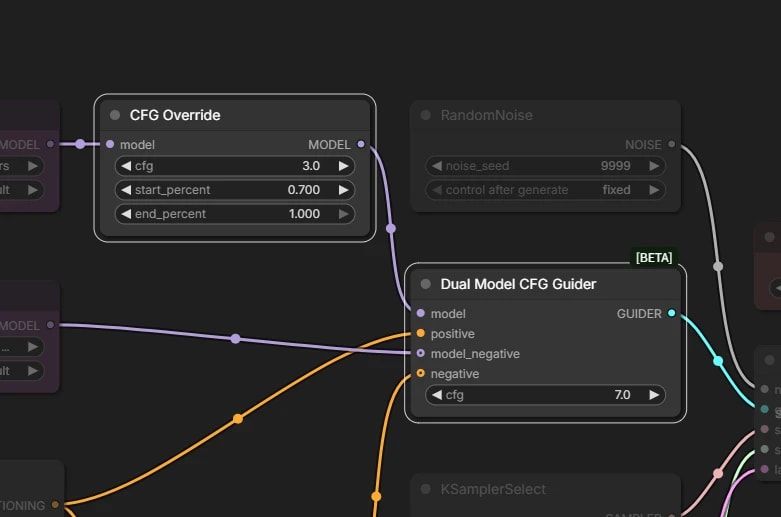
CFG
这是很早就有的小技巧:采样前半段和后半段使用不同的 CFG 值。
- 这个工作流里,前半段是 CFG 7,后半段是 CFG 3。
- 与其从头到尾一直用很高的 CFG,不如中途调低,这样更稳定。
- 这里使用的是
CFG Override节点。 - 它只会在指定的 step 范围内覆盖 CFG 值。
- 这个工作流里,整体进度过了 70% 之后,
cfg就会变成 3。