什么是模型合并?
准备新的检查点模型的方法,粗略分为下面 3 个。
- 从 0 学习
- 追加学习既有模型(微调 / LoRA 等)
- 混合既有模型彼此 (合并)
上 2 个专业知识和数据集的准备很麻烦,但第 3 个“合并”,可以在 ComfyUI 上简单地进行。
以 50:50 混合检查点
首先单纯地将 2 个模型混合一半吧。
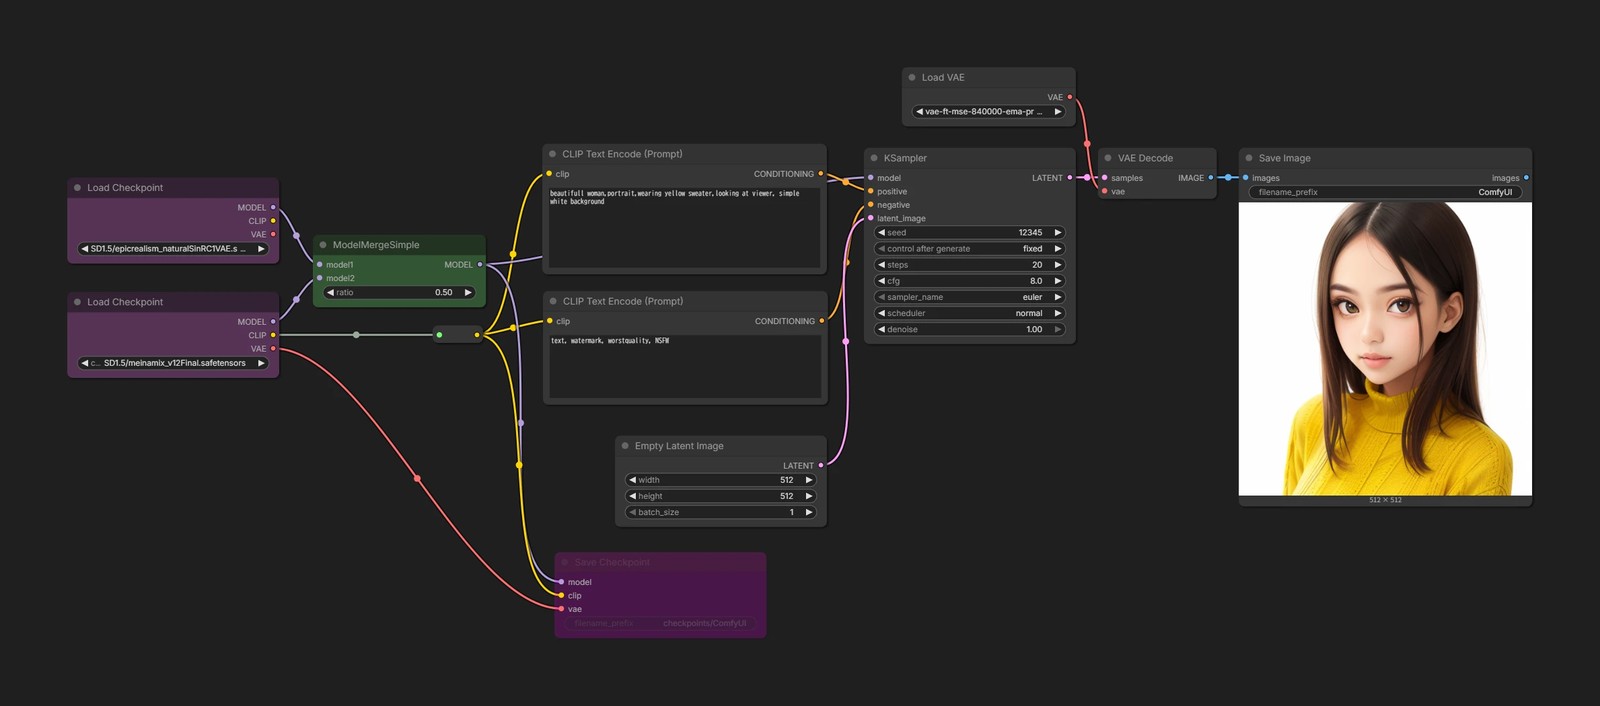
在这个工作流中,使用 ModelMergeSimple 节点将 2 个检查点以 1:1 合并。
- 🟩
ModelMergeSimple接收 2 个MODEL输入,输出以指定的比率线性插补了权重的新模型。ratio=0.5时,可以认为是“将模型 A 和模型 B 各混了一半的东西”。
- 如果将输出的
MODEL原样连接到KSampler,就能简单地尝试中间模型。- 虽然只是杂乱地混合了动漫系和真实系,但能做到像 2.5 次元那样的表现令人吃惊呢。
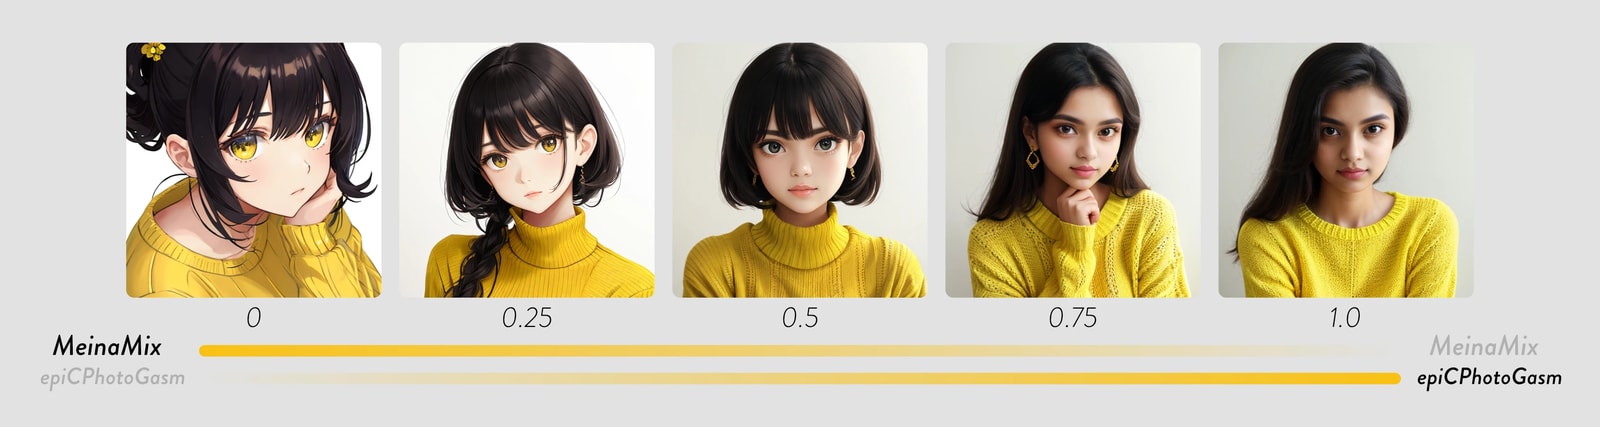
- 如果中意合并结果,连接到
CheckpointSave节点作为检查点保存。(在上面的工作流旁路着。)- 保存目的地默认为
ComfyUI/output/checkpoints/(Windows 便携版的标准设定)。
- 保存目的地默认为
模型合并的弱点
即使混合 2 个模型,参数的数量本身仍是“一个模型份”。 在加上什么新的力量的一方,也可以认为那分量的原来的拿手领域的表现力被削减了。
混合各一半擅长画角色的模型和擅长画风景的模型的话,角色和背景都变成不上不下的模型。
这样似乎不太有用呢… 没有什么好方法吗?
阶层合并
Stable Diffusion 中“从噪声复原图像的本体”是一个 U 字形网络,称为“U-Net”。 U-Net 由许多层组成,各层似乎有着不同的作用。外侧的层更容易影响纹理和颜色,中央附近的层则更容易影响形状和构图。(cf. P+)
阶层合并就是利用这种差异,尽量只混入想要的特征。
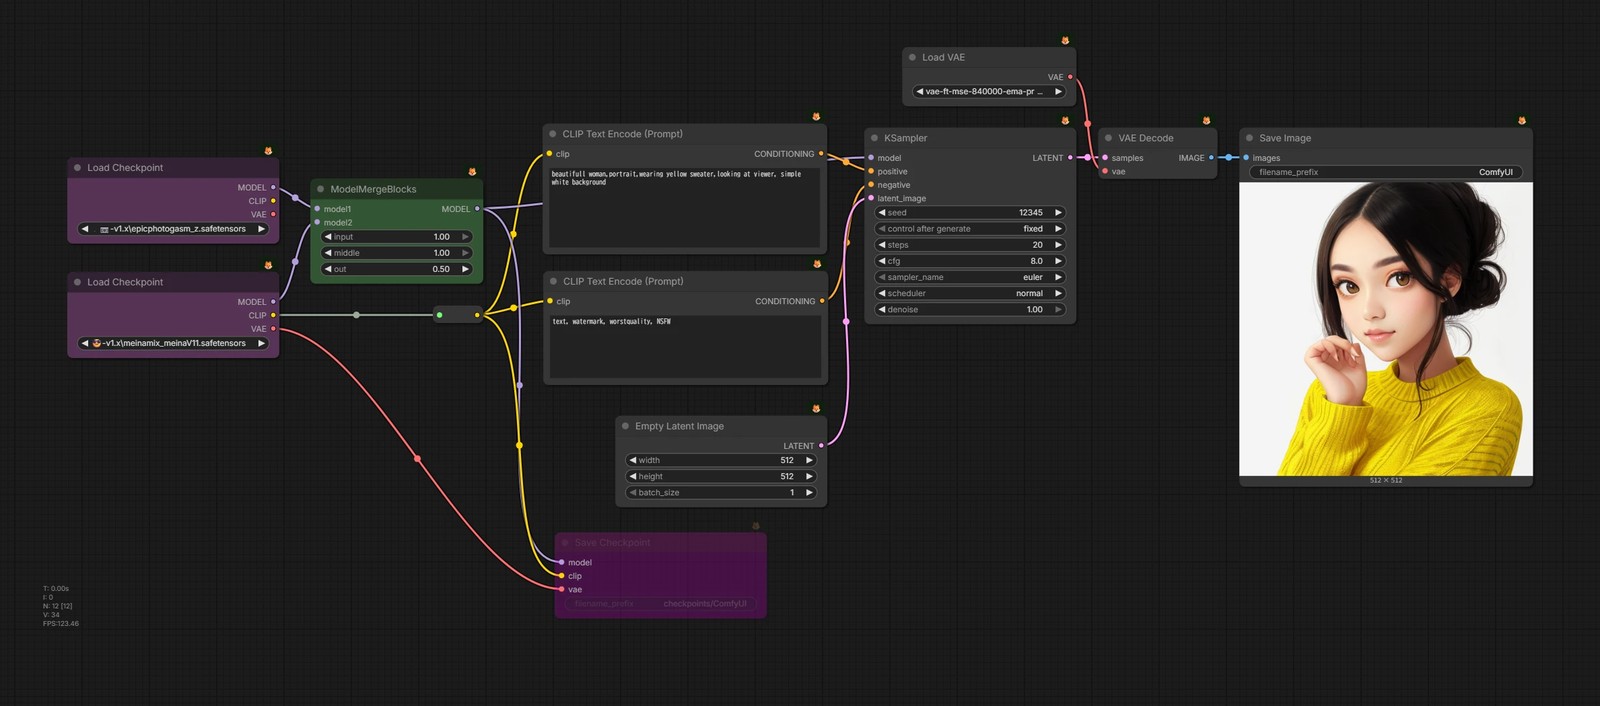
ComfyUI 的标准节点 ModelMergeBlocks 将 U-Net 分为从输入走向中央的 IN、位于中央的 MID,以及从中央走向输出的 OUT,并可分别指定合并比率。
在 ComfyUI,也有 ModelMergeSD1/ModelMergeSDXL 这样,虽然能一层层调整比率的节点。但,能运用自如这个是工匠技艺吧……
LoRA 的合并
LoRA 因为是像“能对原来的模型后加的差分补丁”那样的东西,所以与检查点彼此一样,LoRA 彼此也能相加合并。
在那以前,即使只读取 1 个 LoRA,背面也变成了“向基础的检查点加进 LoRA 的差分,当场制作合成模型”那样的举动。
也就是说,在向 checkpoint 适用 LoRA 的时间点,我们已经一直在做广义上的“像合并的事”了呢 (*゚∀゚)
差分 LoRA
到此为止的话题是“混合模型彼此制作新检查点”的方向,反过来也有 从检查点将“只差分”作为 LoRA 抽出 这样的构思。
- 基础模型
Base(例:v1-5-pruned) - 自定义检查点
Base+X(例:学习结束特定角色或画风的模型)
这时,Base+X 可以粗略视为“基础 + 追加风格 X”。
从这里取出“只 X 的部分”做成 LoRA,就是 差分 LoRA。
- 1.
Base+X - Base = X (← 做成 LoRA 的差分) - 2. 将那个差分压缩为 LoRA 格式
工作流
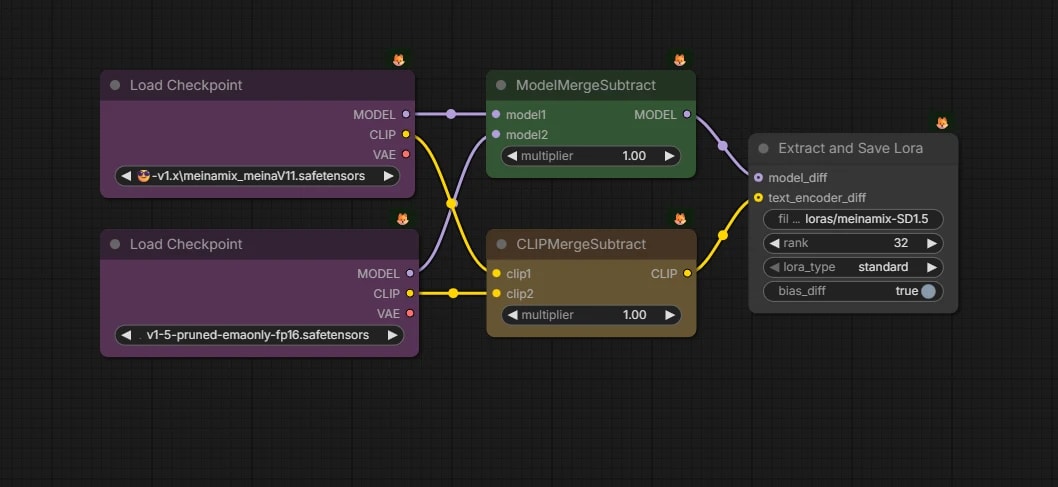
- 🟩 输入想取
ModelMergeSubtract节点的差分的模型。- 是
model1 - model2。
- 是
- 🟨 虽然上面没使用,但也有取文本编码器的差分的
CLIPMergeSubtract节点。- 因为文本编码器相当严峻所以也有可能恶化。
- 在
Extract and Save Lora节点作为 LoRA 保存。rank越大越能忠实地保存差分,但那分量模型尺寸变大。- 作为标准,如果是风格差分是 8〜32 左右,想从相当不同的模型大块取差分时是 64 以上,印象中大多这样区分使用。
- 被抽出的 LoRA 模型,被保存在
\ComfyUI\output\loras。
差分 LoRA 的测试
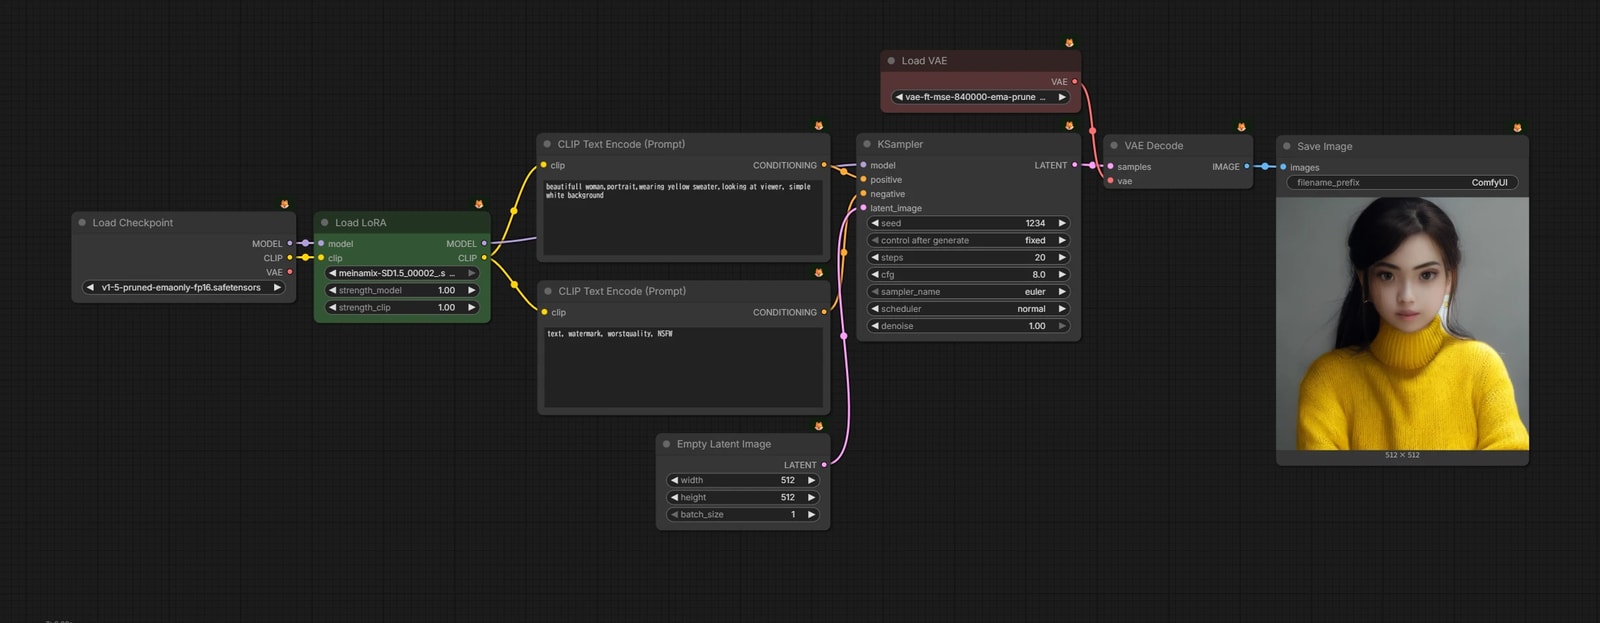
- 这次因为差分大,虽然并不是仅适用 LoRA 就能完美再现,但虽是 SD1.5,变得能生成像那样的图像了呢。