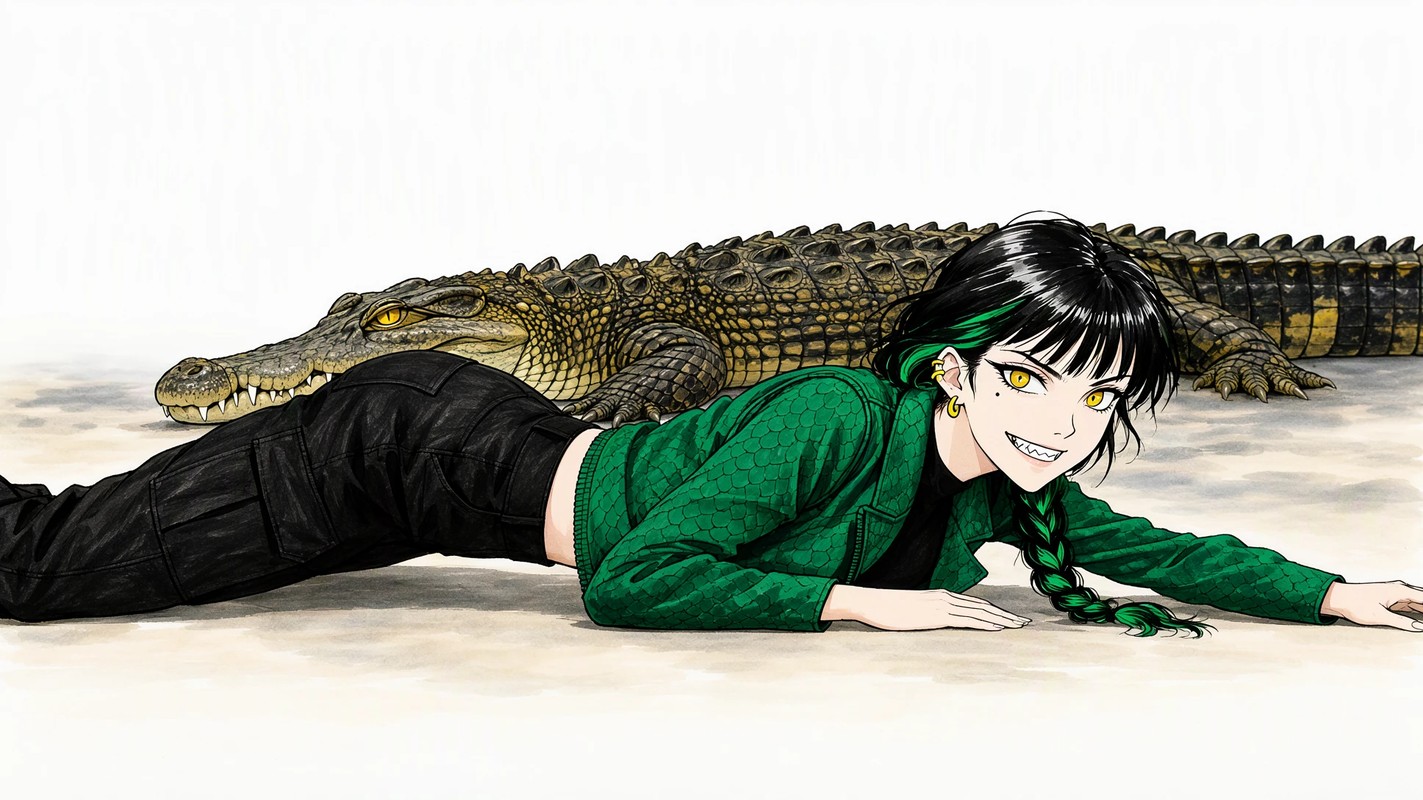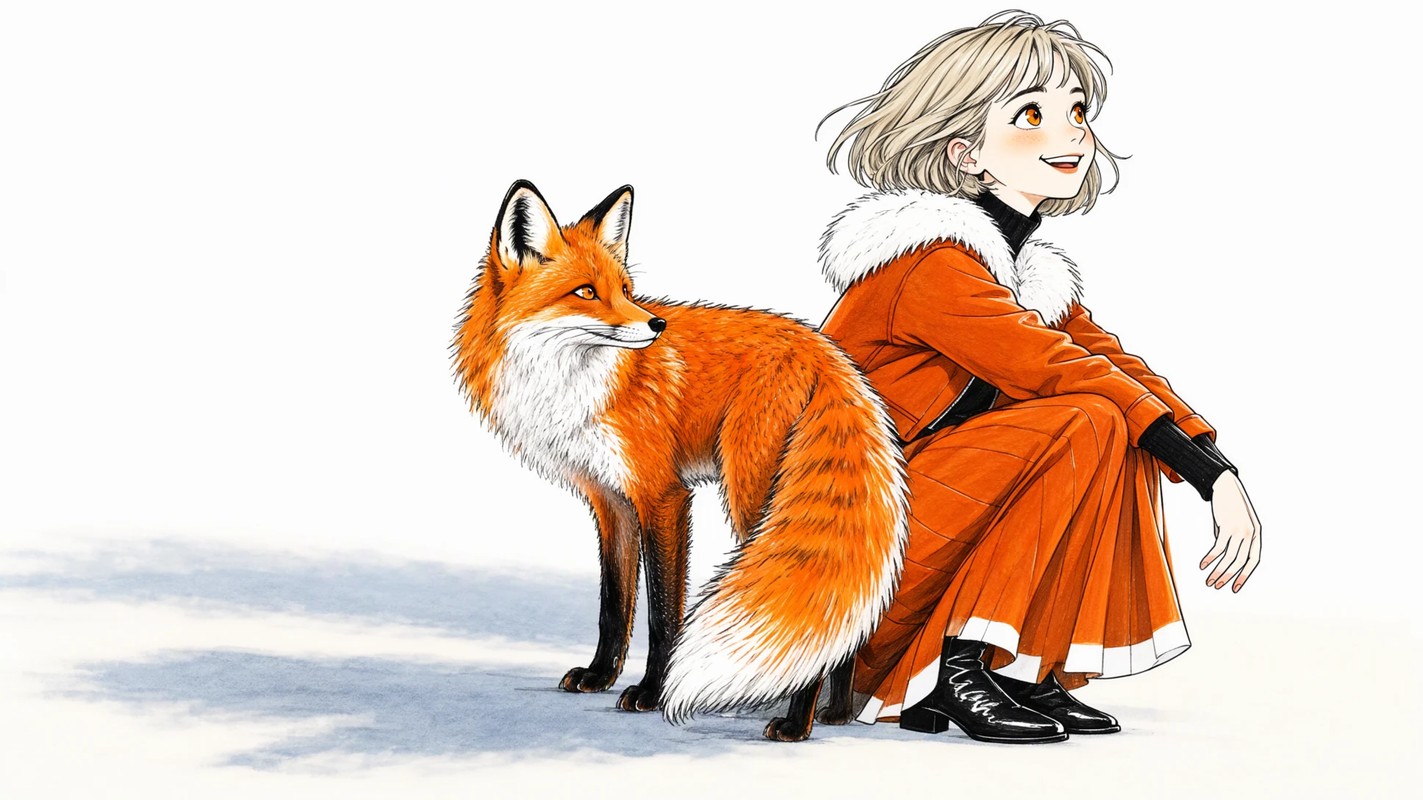
MOSS-Image 是什么?
MOSS-Image 是用约 32 亿张图像从零开始预训练的 5B 图像生成模型。
有意思的是,它的训练数据几乎没有做质量过滤。带水印或模糊的图像也没有丢掉,而是加上描述后一起拿来训练。
也许正因为如此,它的表现自由度非常高。尤其是动漫风格的画面能稳定到这种程度,放眼最前沿的模型也很少见。
它采用允许商用的宽松许可证,很期待它接下来会在社区里怎样发展。
推荐设置
- 分辨率
- 1MP ~ 2MP(最大 4MP)
- 宽和高都要是 16 的倍数
下载模型
- diffusion_models
- moss_image_sft_int8_convrot.safetensors (5.41 GB)
- text_encoders
- qwen3.5_9b_int8_convrot.safetensors (9.75 GB)
- vae
- flux2-vae.safetensors (336 MB)
📂ComfyUI/
└── 📂models/
    ├── 📂diffusion_models/
    │   └── moss_image_sft_int8_convrot.safetensors
    ├── 📂text_encoders/
    │   └── qwen3.5_9b_int8_convrot.safetensors
    └── 📂vae/
        └── flux2-vae.safetensors
提示词
除了自然语言,也支持标签格式。使用标签时,请按下面的顺序书写,和 Anima 有点像。
Quality -> Score -> Meta -> Year -> Character -> Series -> Artist -> General
text2image
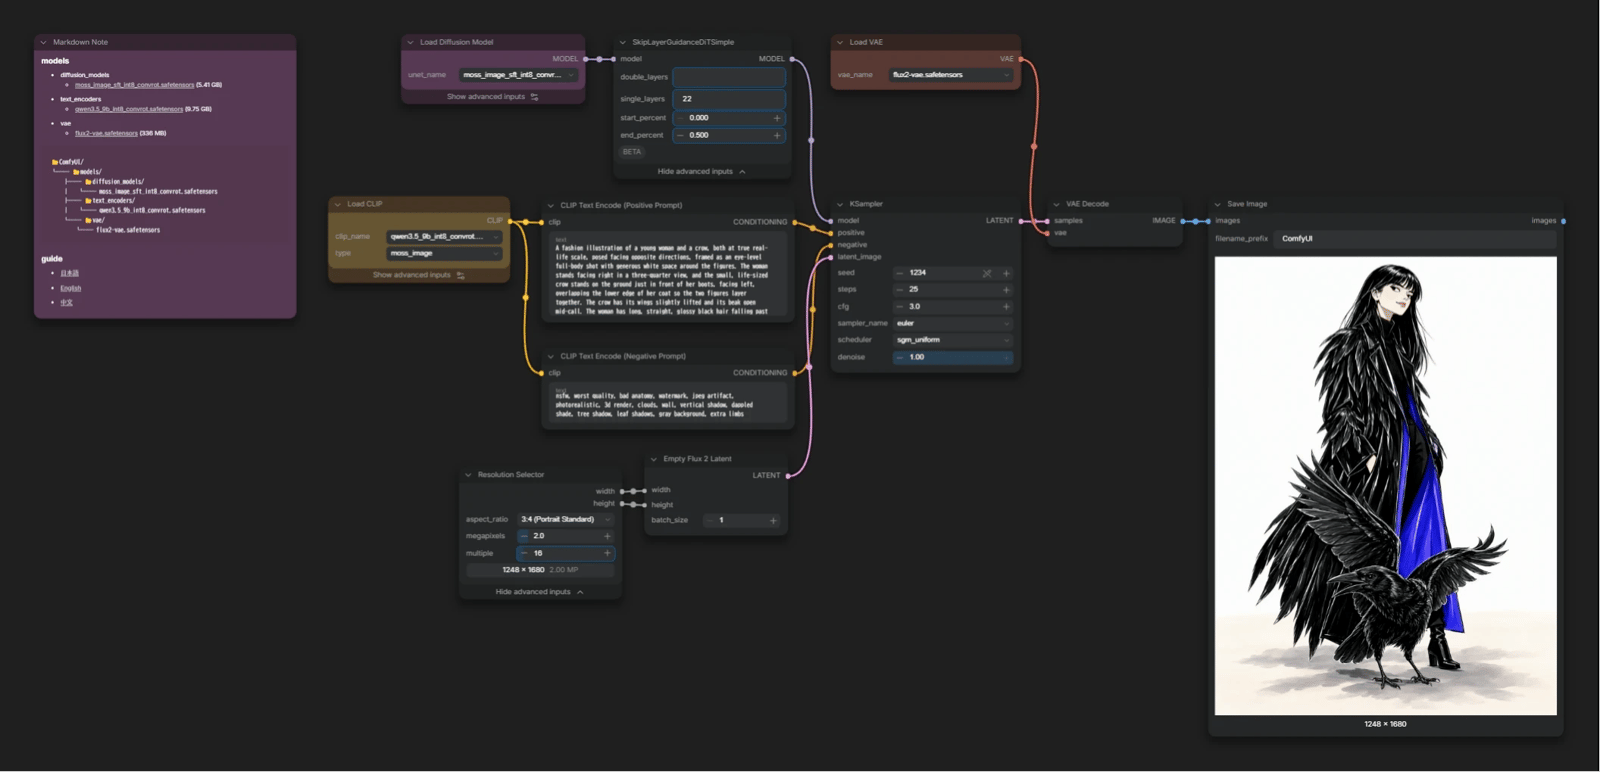
steps: 25cfg: 3.0SkipLayerGuidanceDiTSimplesingle_layers: 22end_percent: 0.5- 据说把它关掉后,画面会变得非常写实,代价是更容易崩坏……关掉时确实经常崩,所以这里折中设成了 0.5。
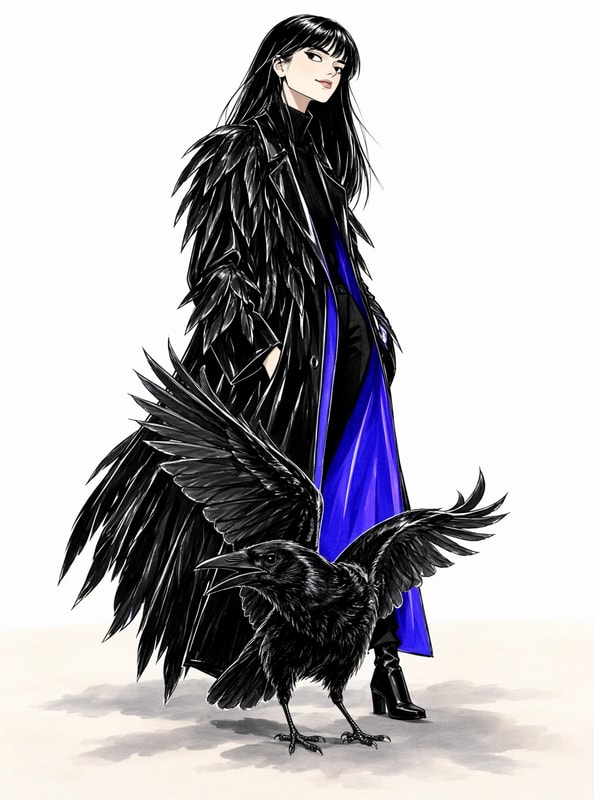
Outputs
text2image with BBOX
用 BBOX 可以指定什么东西放在哪里。
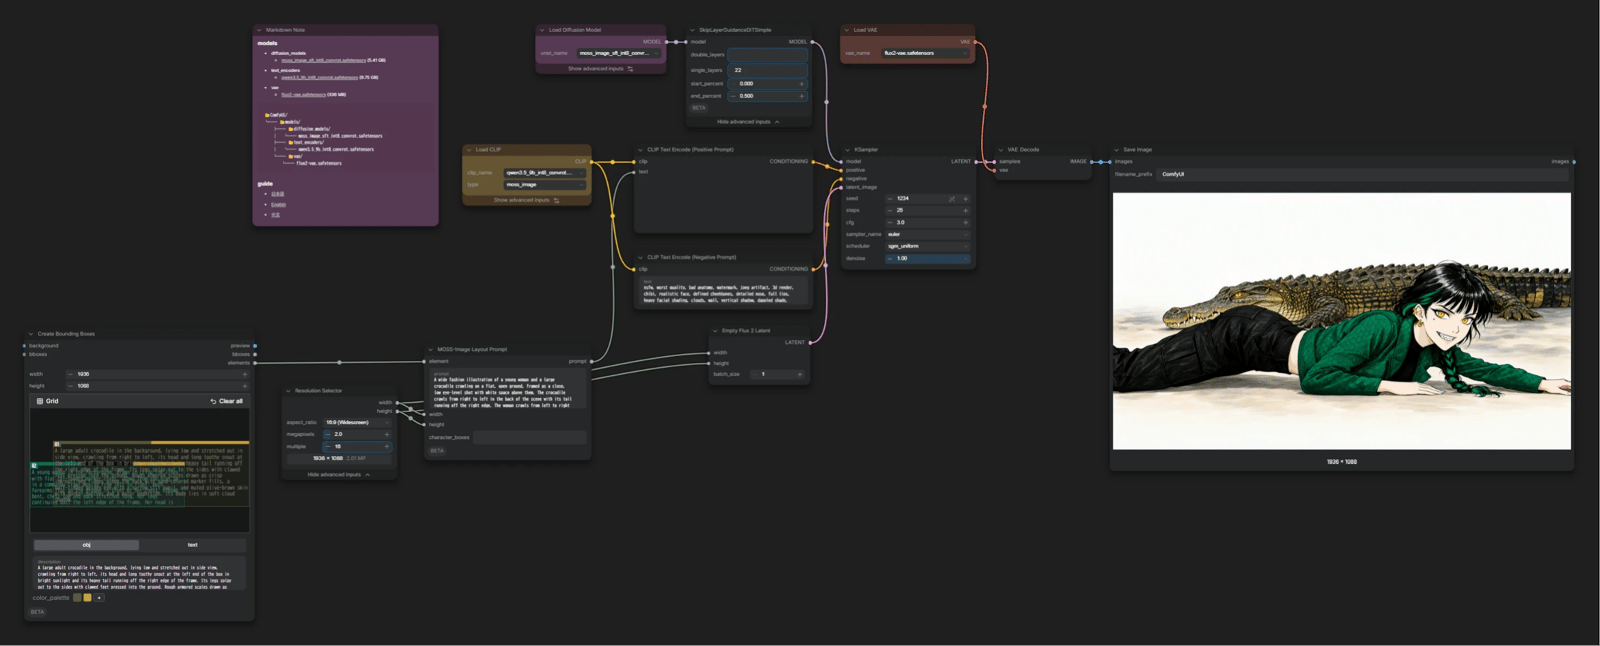
-
Create Bounding Boxes- 用来绘制 BBOX 的核心节点。拖动即可添加方框,然后写下想放在那里的内容。
width/height要和输出尺寸(Resolution Selector的值)一致。
很容易想把
Resolution Selector的值直接连到width/height,但目前有 bug,通过外部输入传入分辨率时,BBOX 的坐标会偏移。
请手动输入相同的数值。 -
MOSS-Image Layout Prompt- 在这里写整张图像的提示词。
- 它会把方框的信息和提示词整理成 MOSS-Image 训练时使用的 JSON 格式。
Outputs