什么是 Pika H3 Flex?
Pika H3 Flex 是 Pika 在 MiniMax H3 基础上追加训练的模型。
Pika 自己也在开发视频生成模型,训练时用的就是他们自己的数据集。
画质有所提升,又通过步数蒸馏缩减到 6 步,生成起来非常顺畅。
基本用法与 MiniMax H3 相同。提示词的写法和用到的节点,请参考那一页。
推荐设置
- 分辨率
- 768p、约 1 MP
- 宽度和高度应为 32 的倍数
- FPS
- 24 FPS
- 帧数
17n + 5
- 视频长度
- 5~15 秒
下载模型
LoRA
- loras
- pika_h3_flex_fl2va_v1_bf16.safetensors (1.96 GB)
- pika_h3_flex_ref2va_v1_bf16.safetensors (1.96 GB)
📂ComfyUI/
└── 📂models/
    └── 📂loras/
        ├── pika_h3_flex_fl2va_v1_bf16.safetensors
        └── pika_h3_flex_ref2va_v1_bf16.safetensors
基础模型
- checkpoints
- sam3.1_multiplex_fp16.safetensors (1.75 GB)
- diffusion_models
- text_encoders
- vae
📂ComfyUI/
└── 📂models/
    ├── 📂checkpoints/
    │   └── sam3.1_multiplex_fp16.safetensors
    ├── 📂diffusion_models/
    │   ├── minimax_h3_fl2va_pruned_int8_convrot.safetensors
    │   └── minimax_h3_ref2va_pruned_int8_convrot.safetensors
    ├── 📂text_encoders/
    │   └── qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors
    └── 📂vae/
        ├── minimax_h3_audio_vae_fp32.safetensors
        └── minimax_h3_video_vae_int8_convrot.safetensors
text2video / T2VA
使用模型:fl2va
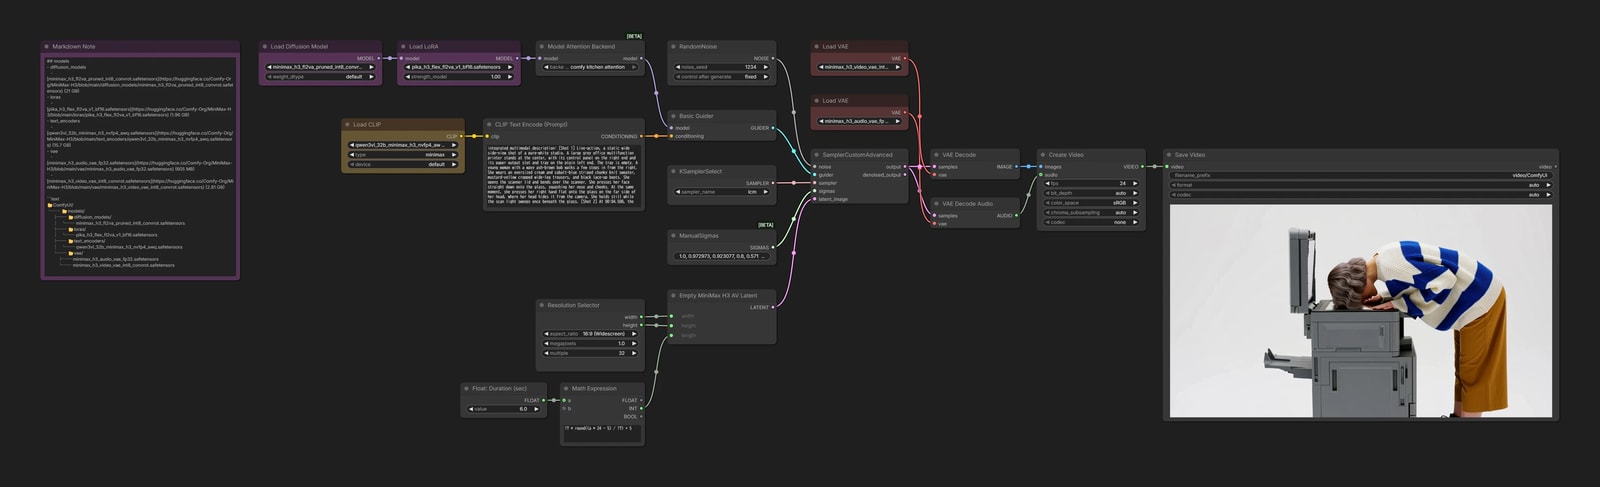
Load LoRA- 以 strength
1.0应用pika_h3_flex_fl2va_v1_bf16.safetensors
- 以 strength
SamplerCustomAdvanced+ManualSigmas- 使用 Pika 指定的 6 步 sigma
1.0, 0.972973, 0.923077, 0.8, 0.571429, 0.333333, 0.0- sampler 为
lcm
Outputs
image2video / I2VA
使用模型:fl2va
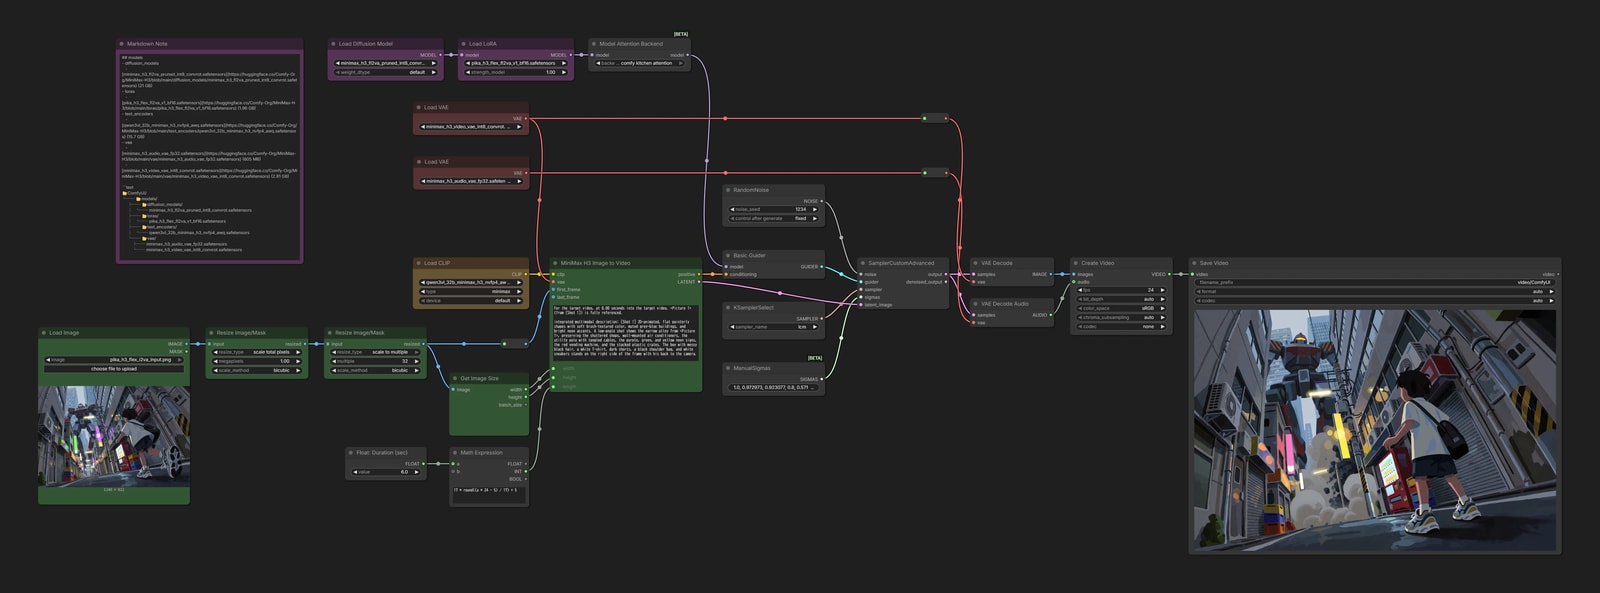
Outputs
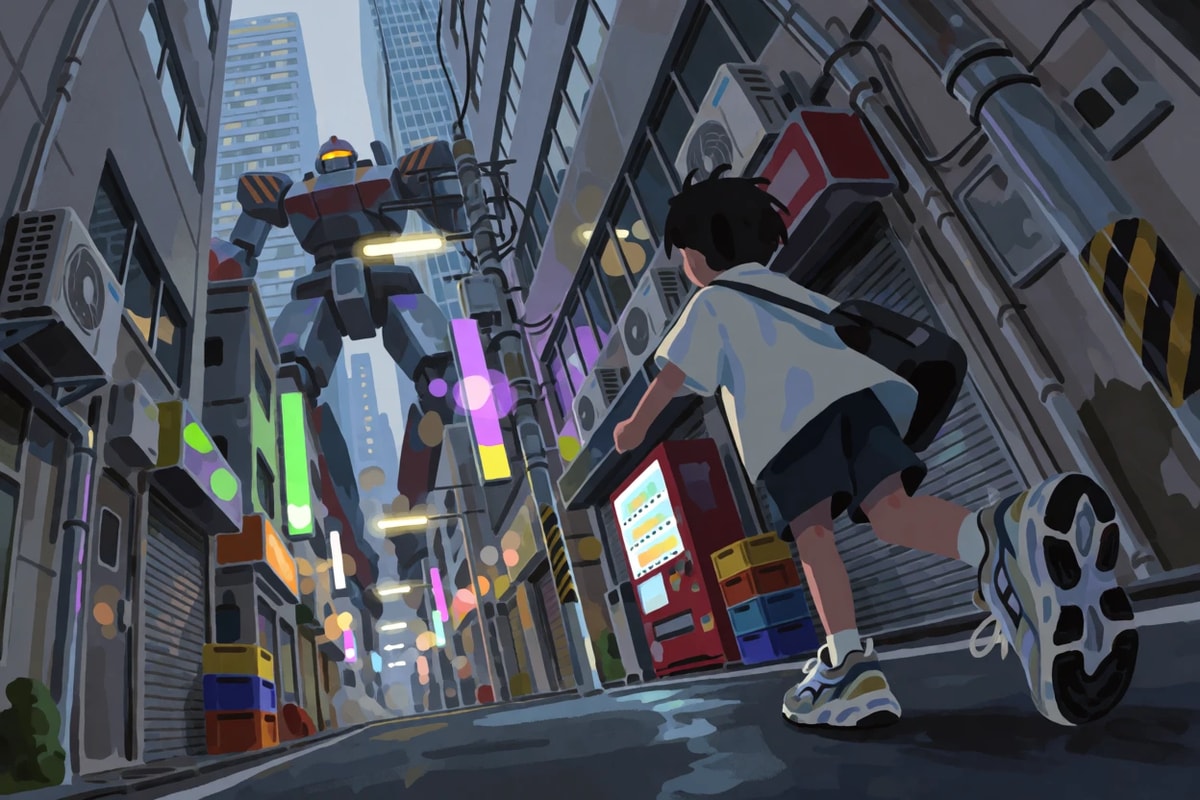
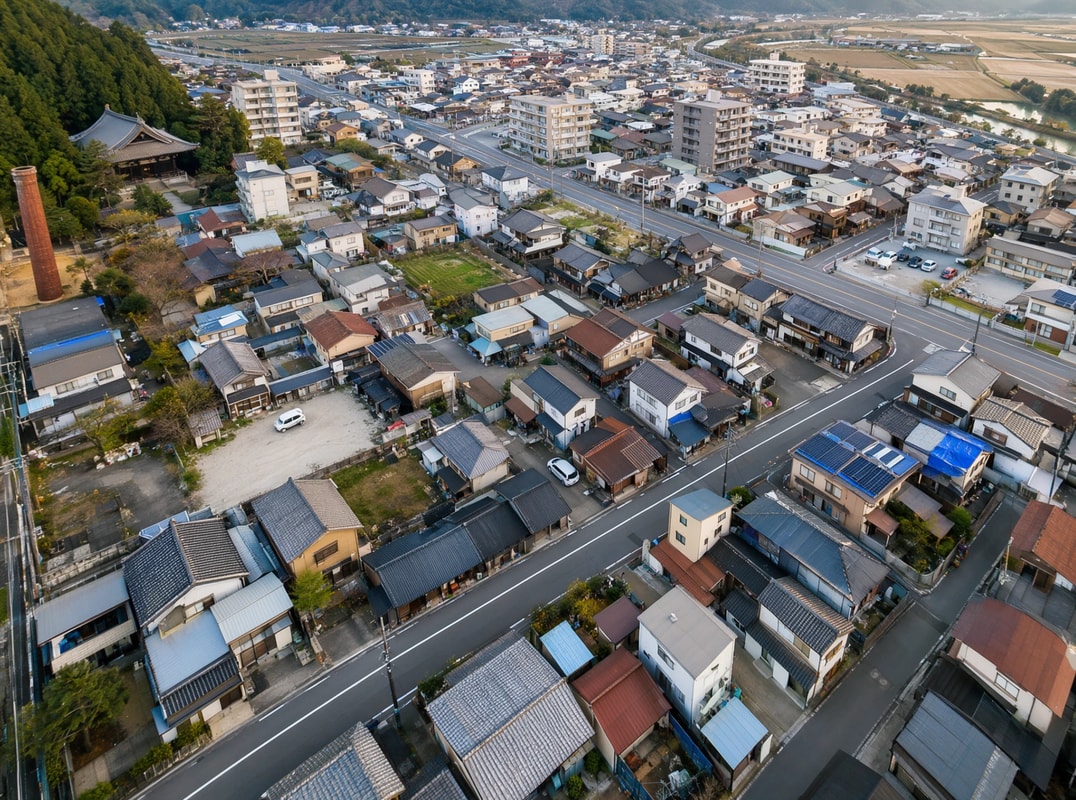
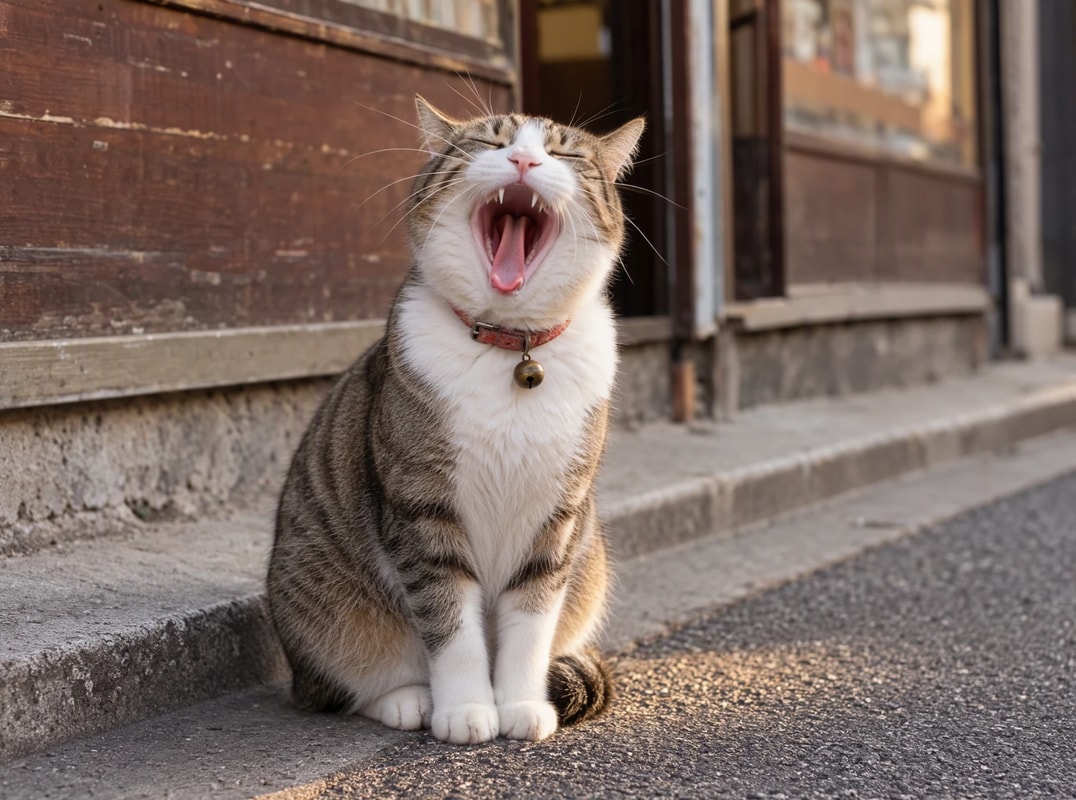
First / Last Frame to Video
使用模型:fl2va
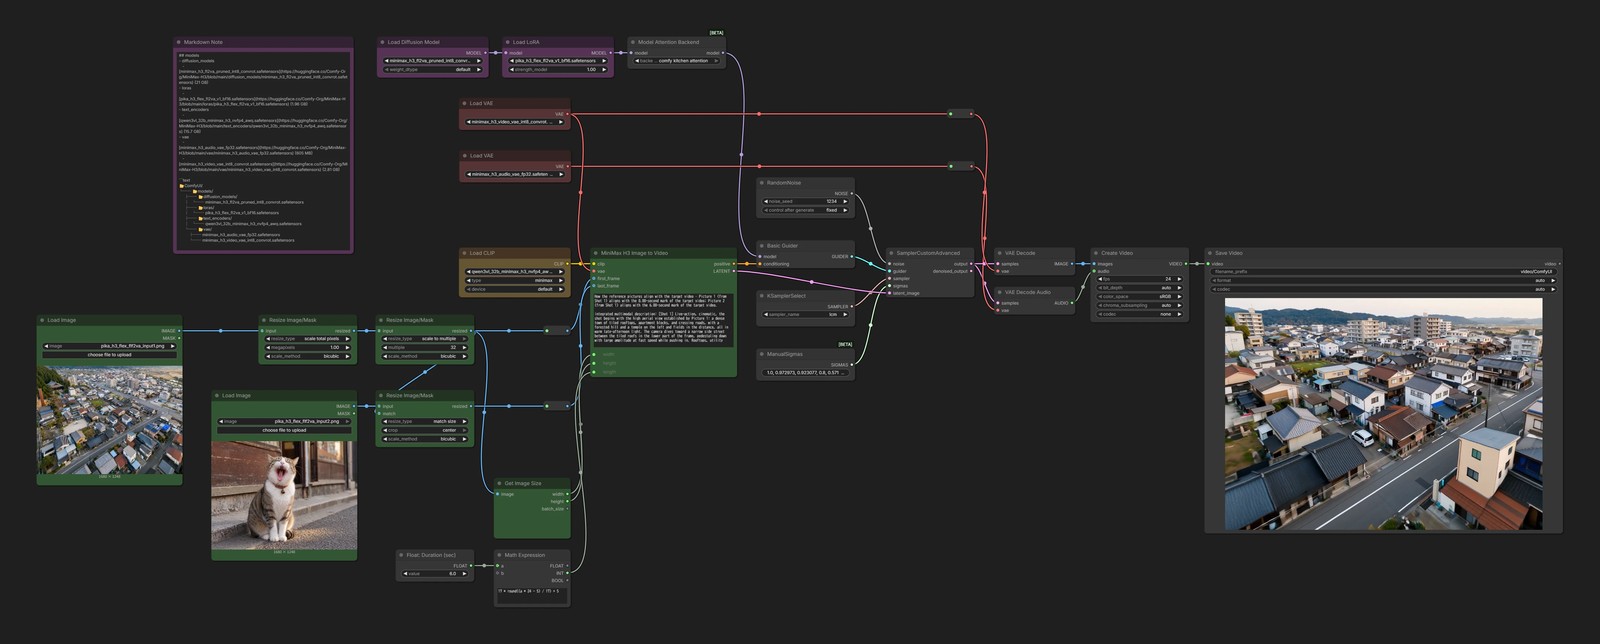
Outputs
Reference Generation
使用模型:ref2va
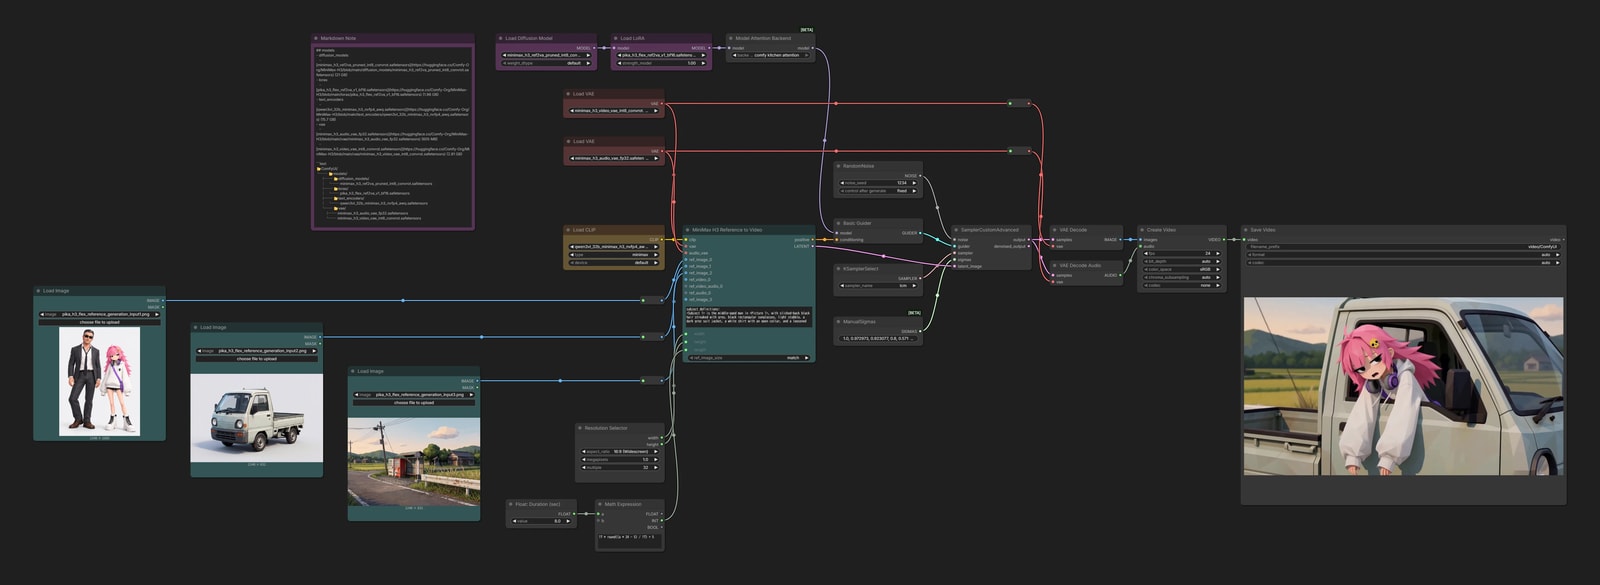
Load LoRA- 以 strength
1.0应用pika_h3_flex_ref2va_v1_bf16.safetensors
- 以 strength
Outputs
Video Editing
使用模型:ref2va
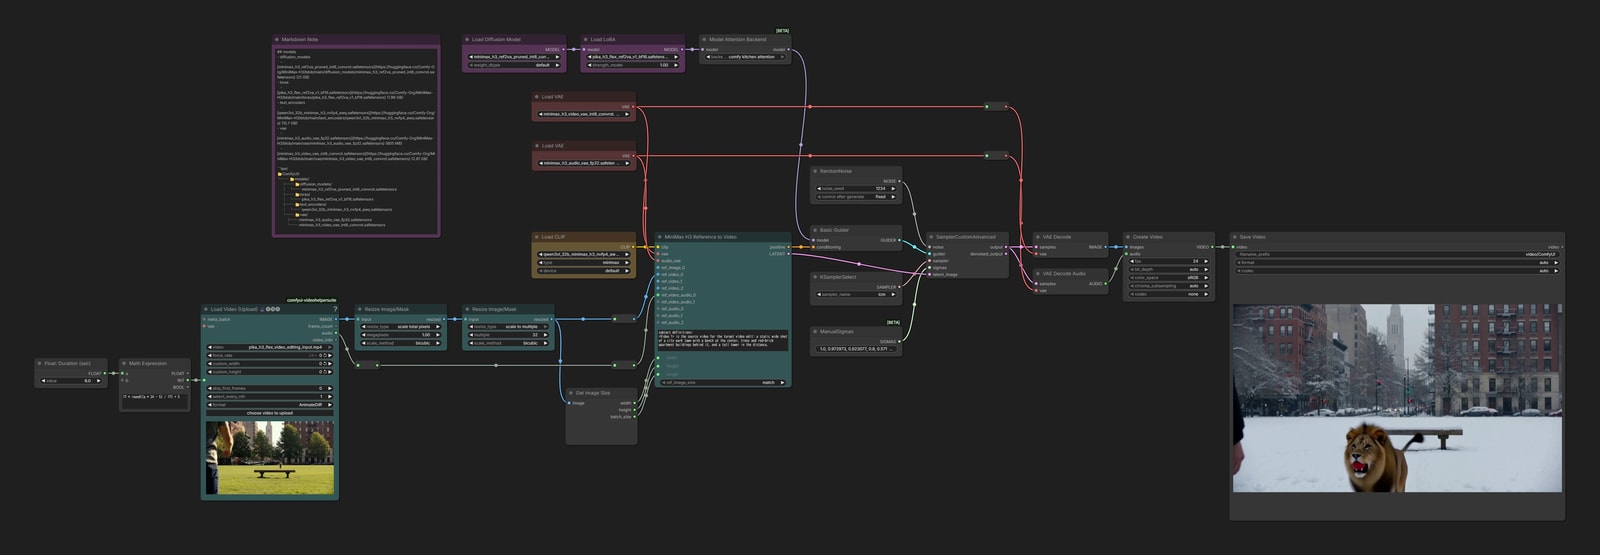
Outputs
空间 Inpainting
使用模型:ref2va
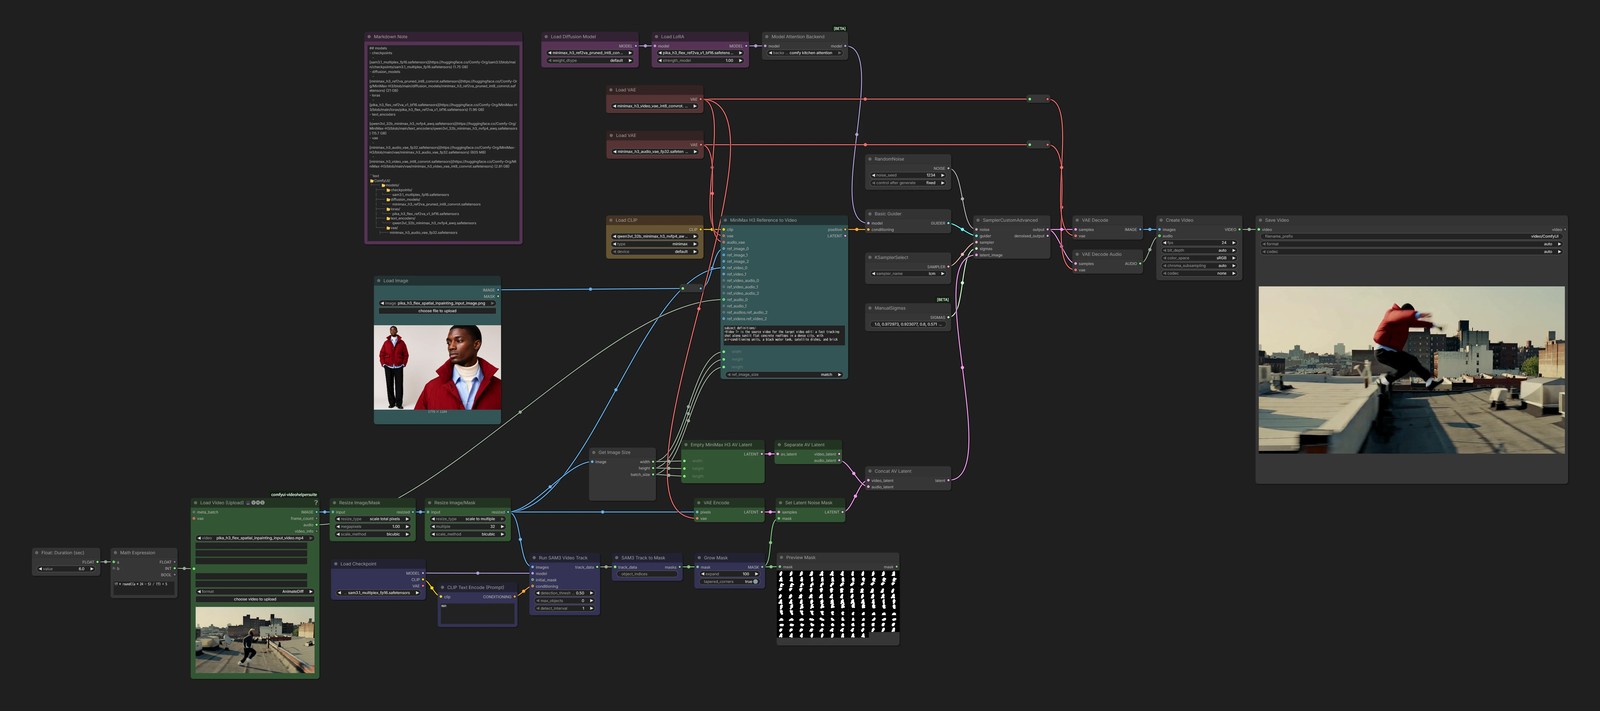
Outputs