什么是 Wan2.2?
Wan2.2 是相当于 Wan-2.1 的正统后继的视频生成模型家族。 大体由 2 个模型构成。
- 14B:切换
high_noise/low_noise2 个模型的二段构成 - 5B:在单一模型处理 text2video 和 image2video 的 TI2V 模型+Wan2.2 VAE
Wan2.2 14B 模型
Wan2.2-A14B 是前半段采样由 high_noise 模型,后半段由 low_noise 模型担当的二段管线。
通过分为 2 个模型,如果不增加 VRAM 的使用量,将模型的大小加倍,谋求性能提升。
推荐设定值
- 推荐分辨率
- 480p(854×480)〜 720p(1280×720)
- 最大帧数
- 81 帧
- FPS
- 经常以 16fps 附近输出
- 不过,16fps 的话经常会变成像慢动作一样的视频,所以请以 24fps 保存,或者用丢帧来调整。
模型的下载
- diffusion_models
- text_encoders
- umt5_xxl_fp8_e4m3fn_scaled.safetensors(与 Wan2.1 通用)
- vae
- wan_2.1_vae.safetensors(与 Wan2.1 通用)
- gguf(任意)
📂ComfyUI/
└── 📂models/
    ├── 📂diffusion_models/
    │   ├── wan2.2_t2v_high_noise_14B_fp8_scaled.safetensors
    │   ├── wan2.2_t2v_low_noise_14B_fp8_scaled.safetensors
    │   ├── wan2.2_i2v_high_noise_14B_fp8_scaled.safetensors
    │   └── wan2.2_i2v_low_noise_14B_fp8_scaled.safetensors
    ├── 📂text_encoders/
    │   └── umt5_xxl_fp8_e4m3fn_scaled.safetensors
    ├── 📂unet/
    │   ├── wan2.2_t2v_high_noise_14B-XXXX.gguf    ← 仅在使用 gguf 时
    │   ├── wan2.2_t2v_low_noise_14B-XXXX.gguf     ← 仅在使用 gguf 时
    │   ├── wan2.2_i2v_high_noise_14B-XXXX.gguf    ← 仅在使用 gguf 时
    │   └── wan2.2_i2v_low_noise_14B-XXXX.gguf     ← 仅在使用 gguf 时
    └── 📂vae/
        └── wan_2.1_vae.safetensors
text2video(14B)
使用 KSampler Advanced,前半用 high_noise,后半用 low_noise 模型处理。
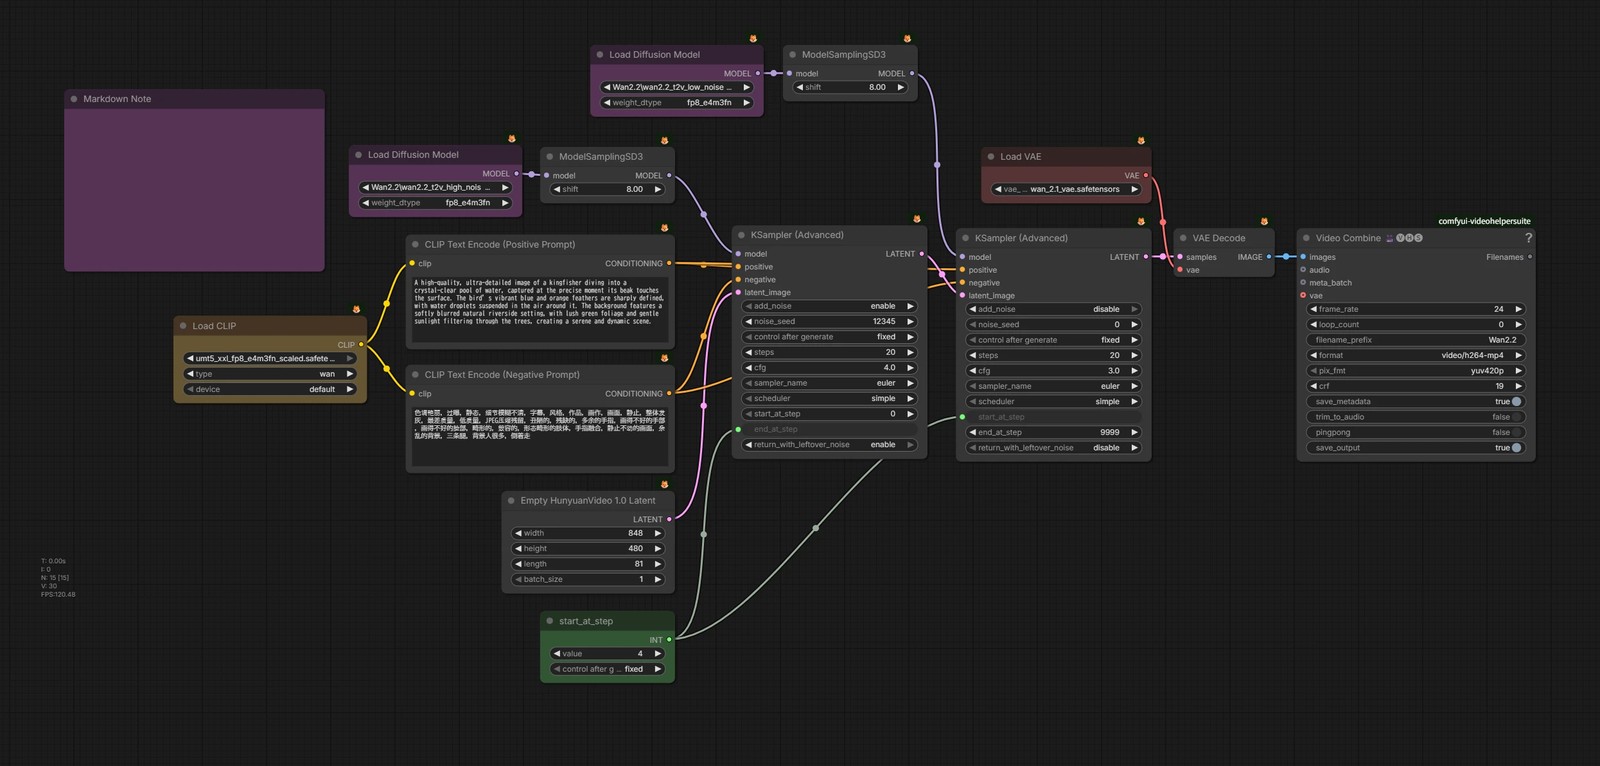
- 🟩 指定全体 20 steps 中,在第几 step 切换
high_noise→low_noise- 关于这个切换的时机,规定推荐 “非噪声部分”和“噪声部分”的比例 为
1 : 1时。 - 虽然可以计算这个,但 Sampler / Scheduler / sigma_shift / step 数相互纠缠很难。
- 而且,也没理由说完全对上的就一定是最佳。
- 在这个工作流中,在 4 steps 切换,首先请以此为基准尝试各种设定。
- 关于这个切换的时机,规定推荐 “非噪声部分”和“噪声部分”的比例 为
- 🟨🟥 文本编码器和 VAE 与 Wan2.1 相同。
image2video(14B)
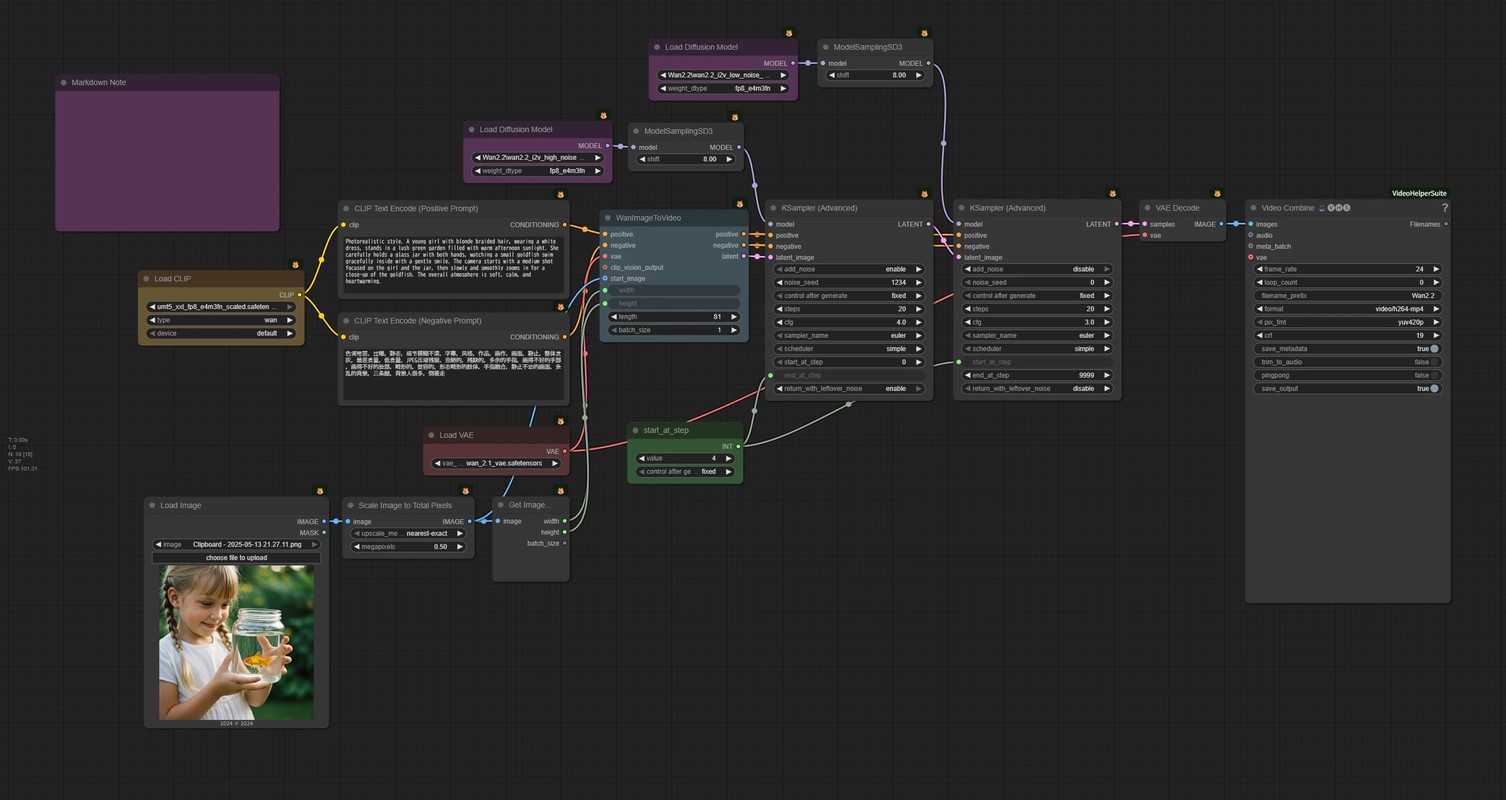
- 🟦 初始图像输入到
WanImageToVideo系节点。 - Wan2.2 与 Wan2.1 时不同,不使用
clip_vision。
FLF2V(14B / First–Last Frame to Video)
Wan2.1 中 FLF2V 有专用模型,但 Wan2.2 的 image2video 模型也对应 FLF2V。
在 ComfyUI 中,只要向 WanFirstLastFrameToVideo 节点输入 Start / End 的 2 张图像,就能生成补充了 2 张之间的视频。
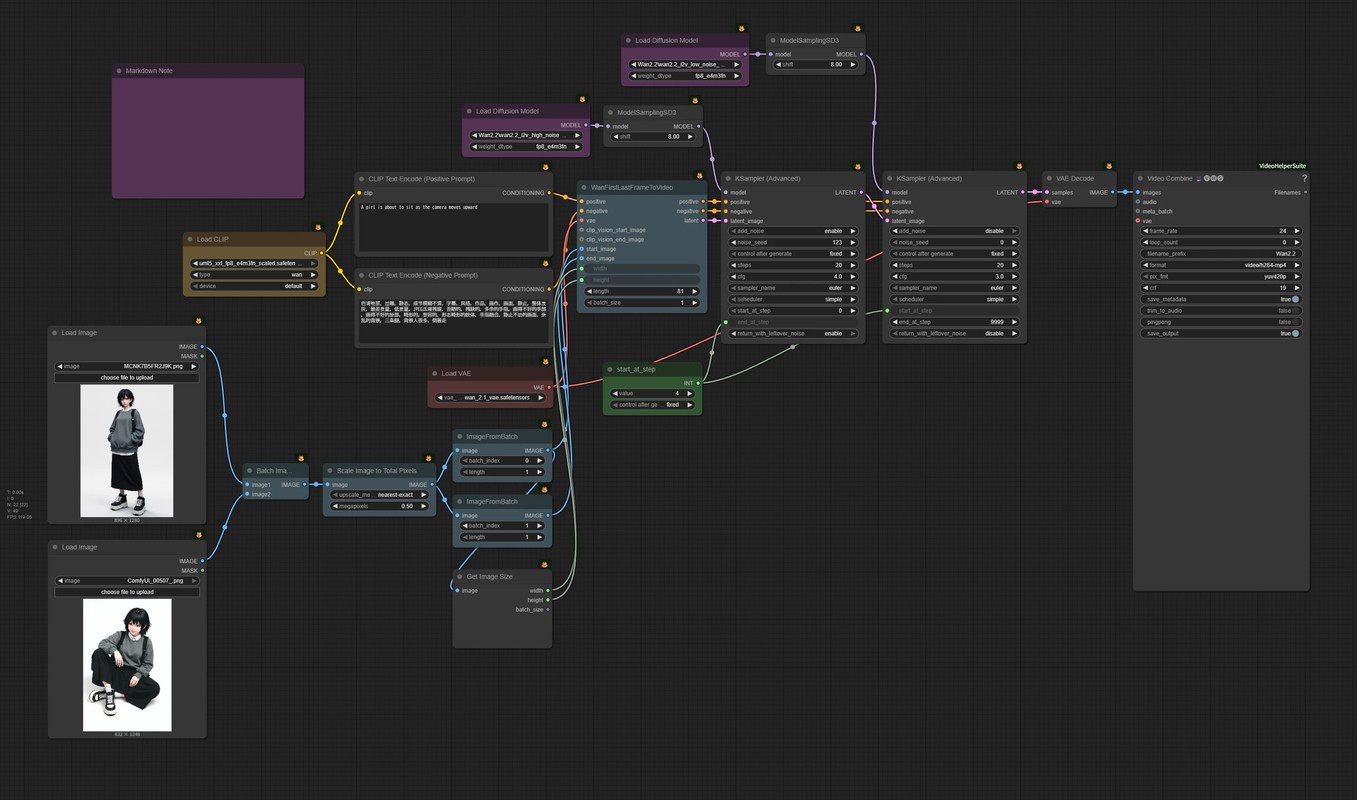
- 🟦 与 Wan2.1 同样,向
WanFirstLastFrameToVideo节点输入 Start / End 图像。
Wan2.2 5B 模型(TI2V-5B)
Wan2.2-TI2V-5B 是在 1 个模型处理 text2video / image2video 双方的 TI2V 模型。 通过组合压缩率更高的 VAE 和补丁化处理,可以用 比 14B 更轻的计算成本 生成 720p・24fps・5秒左右的视频。
与其说是 14B 的 1.3B 式的缩小版,不如认为是稍微从根本上设计不同的路线比较好吧。
虽然设计很有趣,但遗憾的是果然在性能上赢不了 14B,实际上几乎不被使用。
推荐设定值
- 推荐分辨率
- 720p(1280×720)
- 最大帧数
- 121 帧
- FPS
- 24fps
模型的下载
- diffusion_models
- vae
- gguf(任意)
配置例。
📂ComfyUI/
└── 📂models/
    ├── 📂diffusion_models/
    │   └── wan2.2_ti2v_5B_fp16.safetensors
    ├── 📂unet/
    │   └── Wan2.2-TI2V-5B-XXXX.gguf     ← 仅在使用 gguf 时
    └── 📂vae/
        └── wan2.2_vae.safetensors
text2video(5B)

5B 的 text2video,在内部经由“最初的帧 latent”生成视频。
- 🟥 VAE 使用
wan2.2_vae因为与 Wan2.1 的 VAE 压缩构造不同,所以忘记替换的话画质和动作会严重崩溃。 - 🟩 在 text2video 也夹入 TI2V 用的 latent 节点(例:
Wan22ImageToVideoLatent) 5B 是以“1 帧 latent → 视频”的管线为前提设计的,所以没有预想跳过这里的构成。
如果理解为“虽然是 text2video,但里面是 image2video 的特别案例”,就容易与其他 TI2V 系模型合并整理。
image2video(5B)
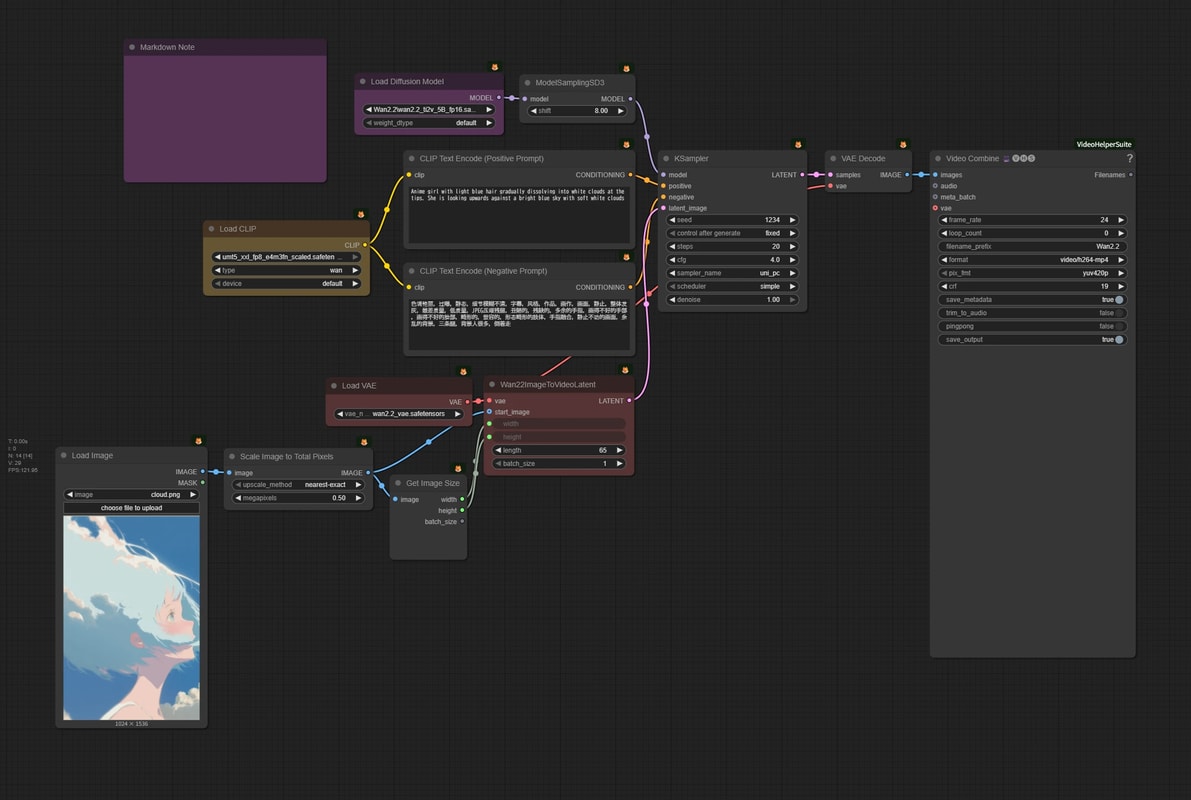
image2video 也使用与 text2video 相同的 TI2V 模型。 只是输入增加,后段的 KSampler 以后几乎通用。
- 🟦 start 图像输入到 TI2V 用的 latent 节点,制作压缩 latent。
- 🟩 text2video / image2video 双方都能用同一模型解决,所以 首先用 5B 固化工作流,再根据需要加上 14B,这样的运用变得容易了。