什么是 LTX-2?
LTX-2 是 Lightricks 公开的能同时生成音频+视频的扩散模型。
现在已经有后继模型 LTX 2.5。
由于架构是相同的,这一页仍然适合用来理解它的机制;如果是实际生成,还是更推荐直接使用新模型。
推荐设定值
- 分辨率
- 640×640(1:1)
- 768×512(3:2)
- 704×512(4:3)
- ※因为后处理会以 2 倍放缩,所以实际的输出是 1280×1280
- ※必须是 32 的倍数
- FPS
- 24 / 25 / 30
- 帧
- 最大:257 frames(25fps 时约 10 秒)
- 推荐:121–161(品质和内存的平衡)
- ※必须是 8n+1
模型的下载
-
checkpoints(VAE 同捆)
-
latent_upscale_models
-
loras
-
text_encoders
📂ComfyUI/
└── 📂models/
    ├── 📂checkpoints/
    │   └── ltx-2-19b-dev-fp8.safetensors
    ├── 📂latent_upscale_models/
    │   └── ltx-2-spatial-upscaler-x2-1.0.safetensors
    ├── 📂loras/
    │   └── ltx-2-19b-distilled-lora-384.safetensors
    └── 📂text_encoders/
        └── gemma_3_12B_it_fp8_scaled.safetensors
基本的处理流程
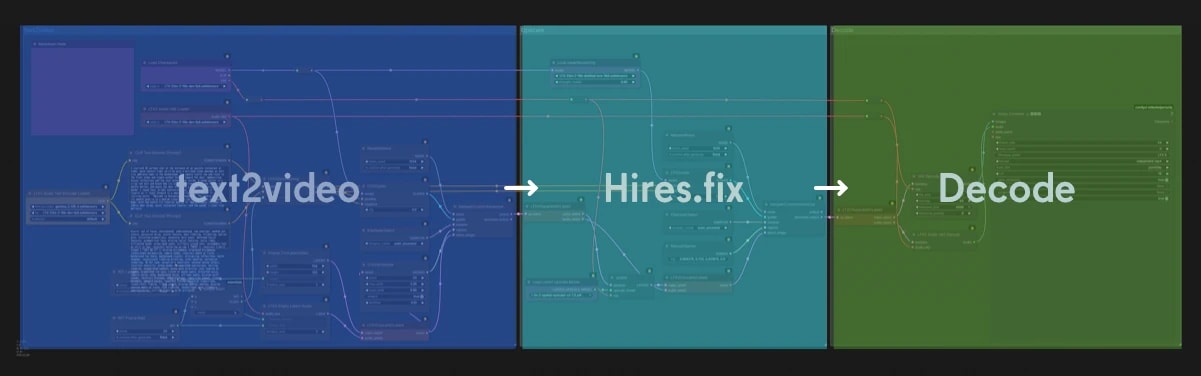
因为与 Wan 等相比节点数多,所以可能感觉复杂,但做的只有这个。
- 1. text2video + audio
- 首先生成作为基础的视频(音频也是)。
- 2. Hires.fix(第 2 阶段)
- 将做好的视频 2 倍放缩,用 video2video 再转一次进行精炼。
- 虽然也可以跳过这个直接解码,但从品质上推荐进行 Hires.fix。
- 3. 解码
- 将视频和音频分别解码输出。
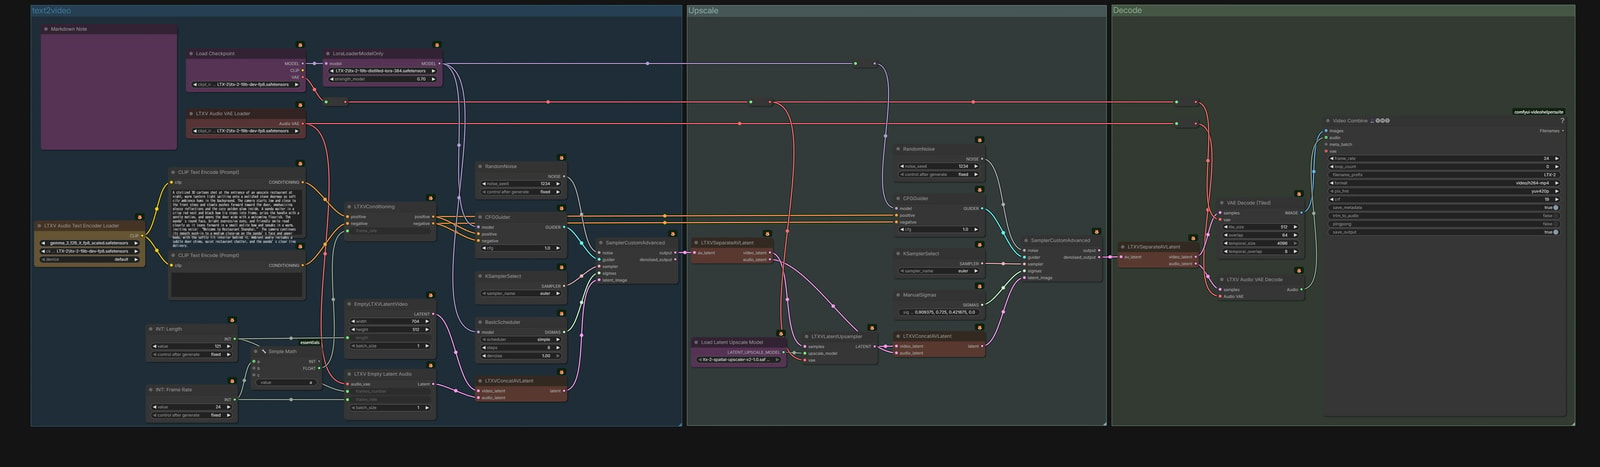
text2video
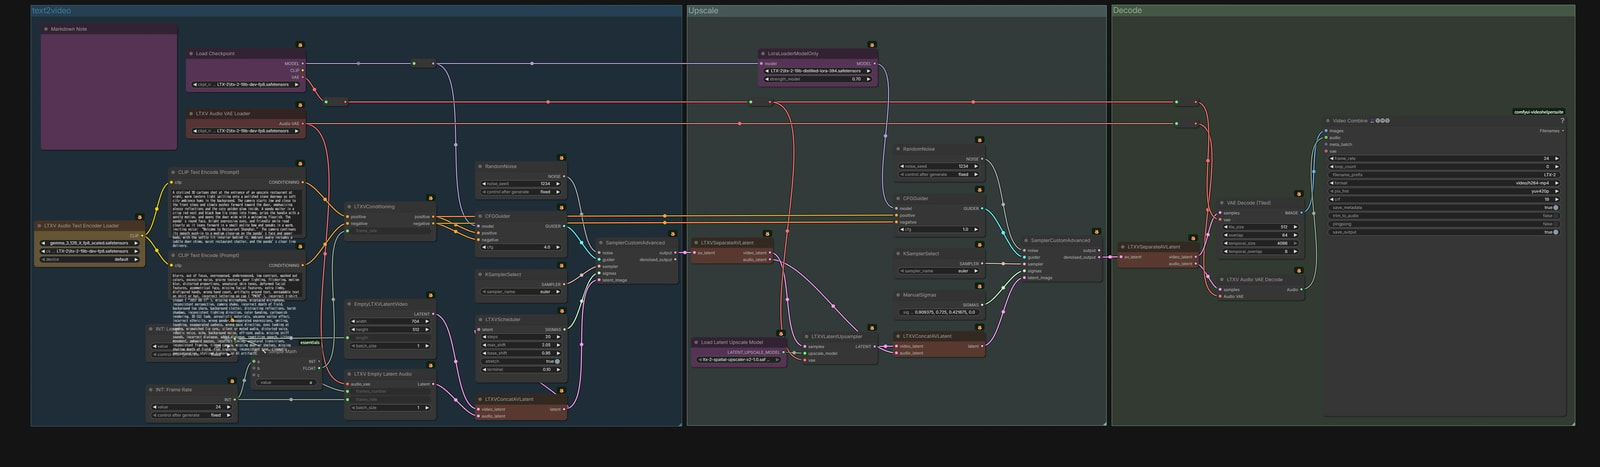
沿着上面说明的基本处理组建工作流。
- 1, 2, 3 是第 1 段
- 4, 5 是 Hires.fix
- 6 是解码
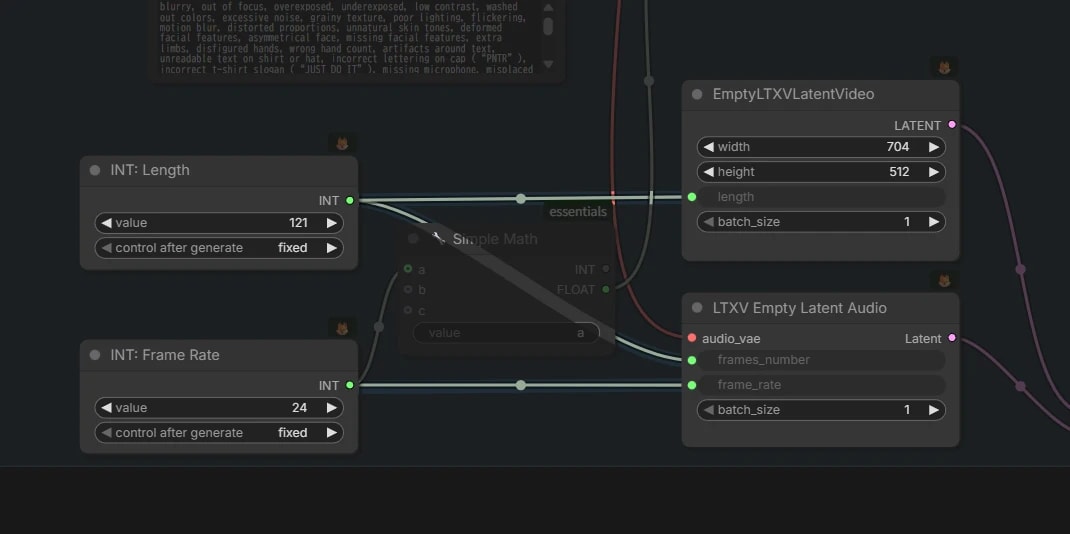
视频分辨率・长度・FPS 的设定
在这里决定想生成的视频和音频的参数。
- 在
EmptyLTXVLatentVideo/LTXV Empty Latent Audio输入分辨率・帧数・FPS。 - 请遵从 推荐设定值 设定。
- 🚨后处理会将分辨率变为 2 倍。
- 也就是说,这里设定的分辨率,请设为想制作的视频的 一半 的值。
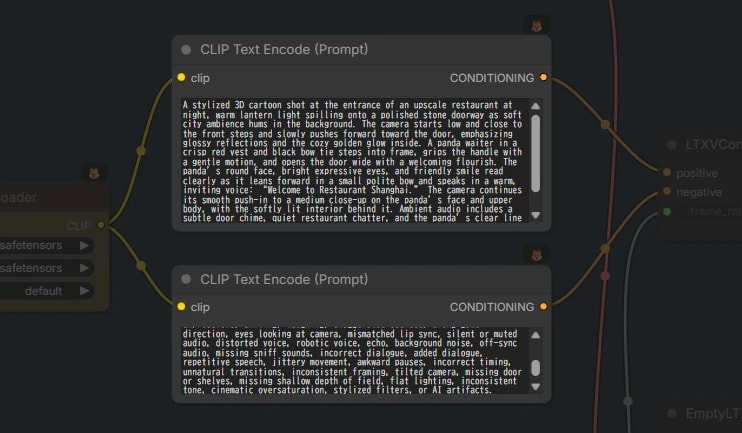
提示词
虽然是 LTX 系列的特征,但提示词如果不多少讲究的话做不出什么大不了视频。
- 虽说如此,并没有像借用 LLM 的力量那样精细的格式。
- 请像写小说那样,记述想生成的视频。
- cf. Prompting Guide for LTX-2
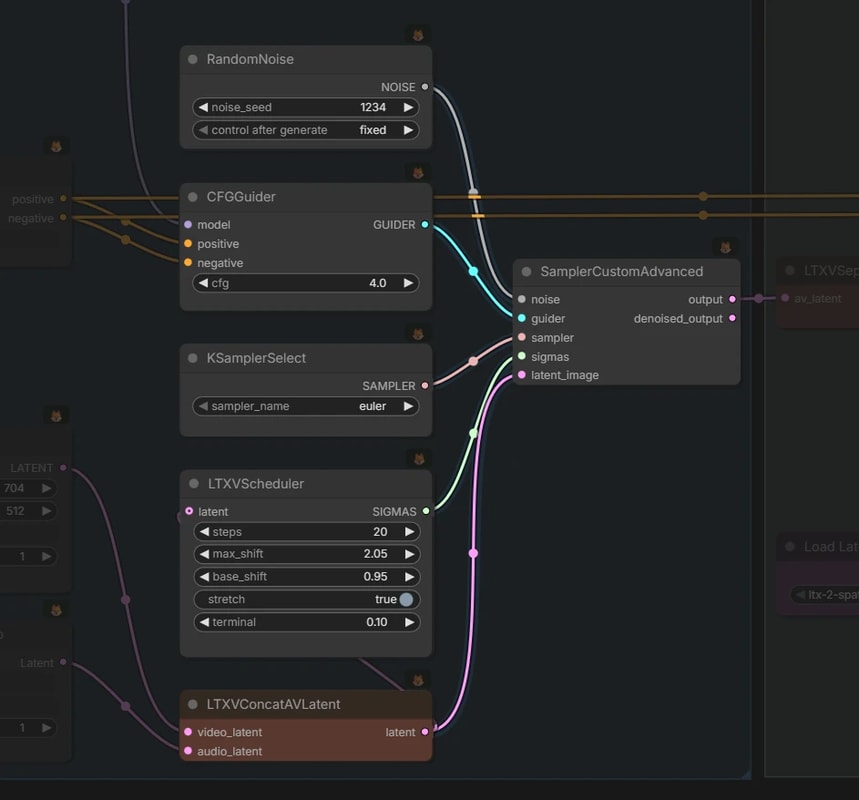
采样(第 1 段)
因为不是看惯的 KSampler 所以看起来有点复杂,但基本只是“决定步数和 CFG 进行采样”。
- 在这个工作流中,以 20 steps / CFG 4.0 运转第 1 段。
- 使用名为
LTXVScheduler的专用调度器。- 虽然动作与
linear_quadratic相似,但不用太在意。
- 虽然动作与
- LTX-2 因为同时处理视频和音频,所以在 🟫
LTXVConcatAVLatent,将视频 latent 和音频 latent 汇总为 1 本。
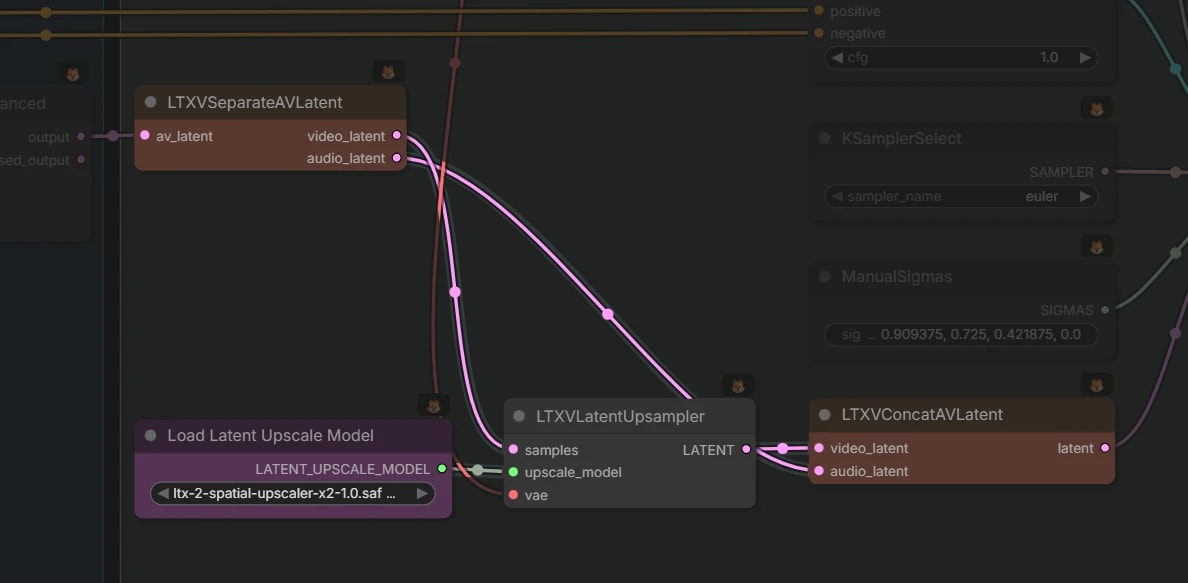
latent 的放缩(x2)
将视频 latent 的分辨率放缩为二倍。
- 使用专用的模型 (
ltx-2-spatial-upscaler-x2)。
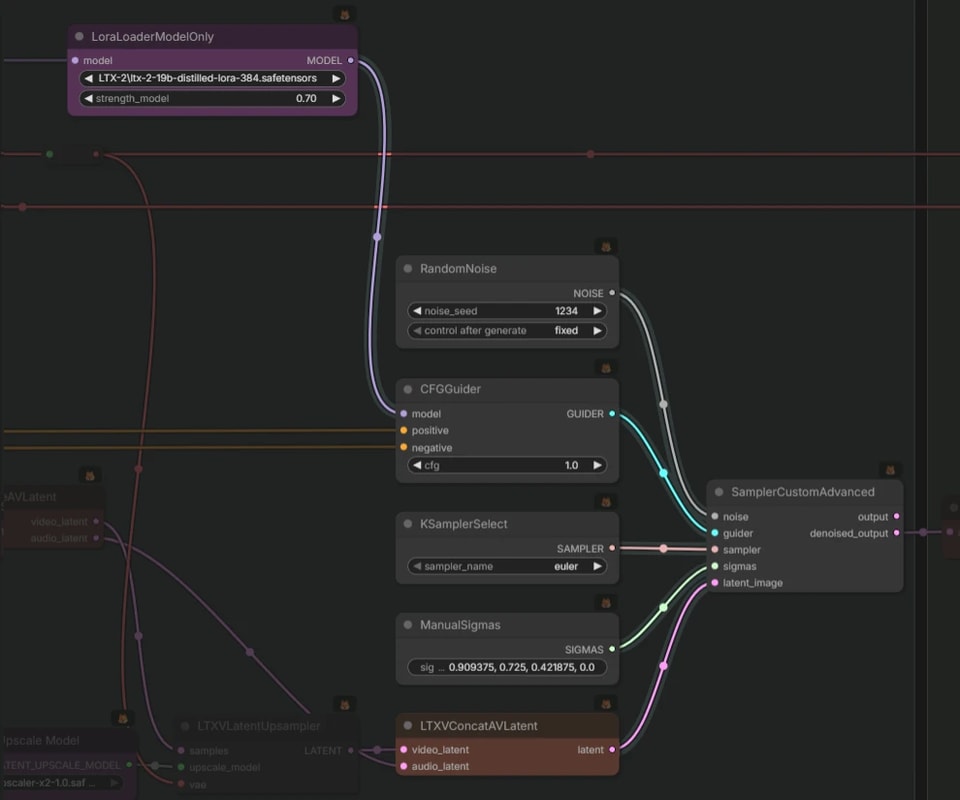
采样(第 2 段 / video2video)
将放缩后的 latent 用短步数精炼。
- 这里使用能用 4~8 步生成的
distilled-lora。- 请认为是其他模型所说的 Lightning / Turbo 那样的东西。
- 在这个工作流中以 3 steps 运转。
- 配合这个,CFG 变更为
1.0。
- 因为使用了
Manual Sigma所以有点难以理解,但如果以Simple相当考虑的话是接近denoise = 0.47前后的举动。
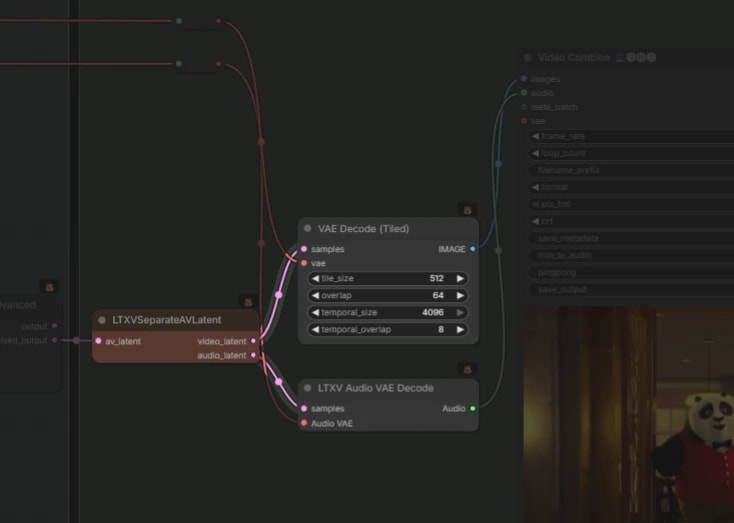
解码
最后,将视频和音频分别解码并导出。
- 将 latent 分为视频用 / 音频用,用适当的 VAE 解码。
- (因为没有 VRAM 余裕所以使用 Tiled VAE。)
text2video 8 步
上面只在 Hires.fix 使用了 distilled-lora,但也适用于第 1 段,用 8 步高速生成看看吧。
为了适用 distilled-lora,变更几个采样设定。
- CFG :
1.0 - scheduler :
Simple - steps :
8
20 步 / 8 步 distilled-lora 比较
据我尝试,适用 distilled-lora 更能安定地生成。
因此,兼顾速度提升,以后的工作流全部 从第 1 段开始适用 distilled-lora。
image2video
single-frame I2V
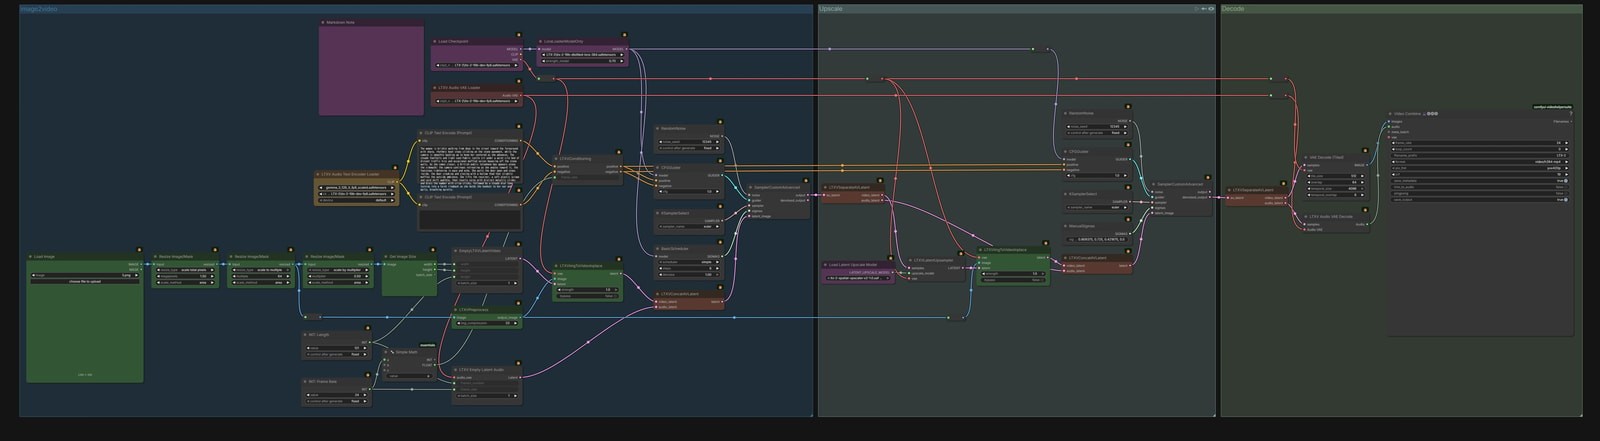
基本是“固定第 1 帧为输入图像,生成剩余”。
例如制作 121 帧的视频的话,粗略是这样的流程。
(1) 制作 121 frames 的框(8n+1)
    [ 🌫️ 🌫️ 🌫️ 🌫️ 🌫️ ... 🌫️ ]

(2) 只将第 1 帧用输入图像覆盖
    [ 🖼️ 🌫️ 🌫️ 🌫️ 🌫️ ... 🌫️ ]

(3) 生成剩余的 120 帧
    [ 🖼️ ✨ ✨ ✨ ✨ ... ✨ ]
以 🖼️ 为起点,后面的帧(✨)被填埋的印象。
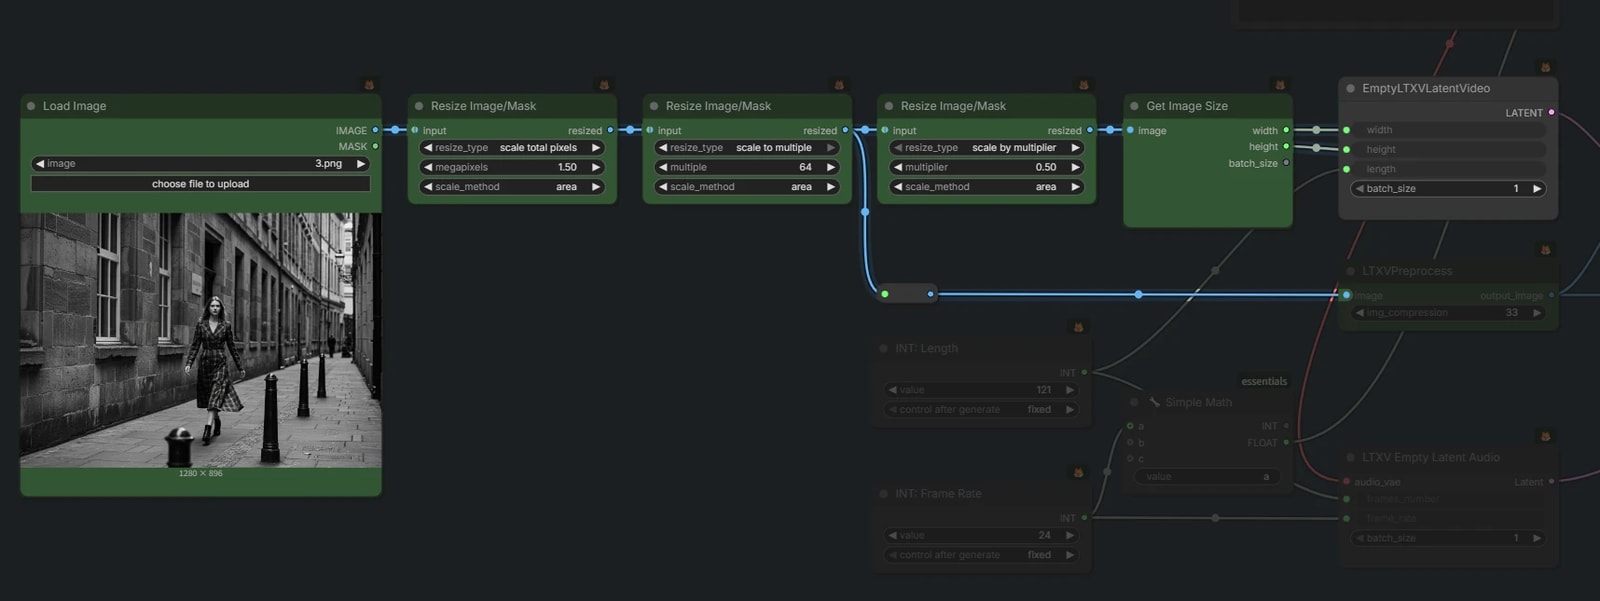
输入图像的调整尺寸(制作 2 系统)
- 首先,制作配合最终想输出的分辨率的 全分辨率版。
- 调整为任意的尺寸 (这里是 1MP)。
- 宽・高设为 64 的倍数。
- 因为第 1 段以 1/2 分辨率运转,所以为了即使减半也成为 32 的倍数而设为 64 的倍数。
- 其次,为第 1 段(半分辨率)用,也制作将上面的图像纵横变为 1/2 的版本。
- 向
EmptyLTXVLatentVideo输入这个 半分辨率侧的 width/height。
- 向
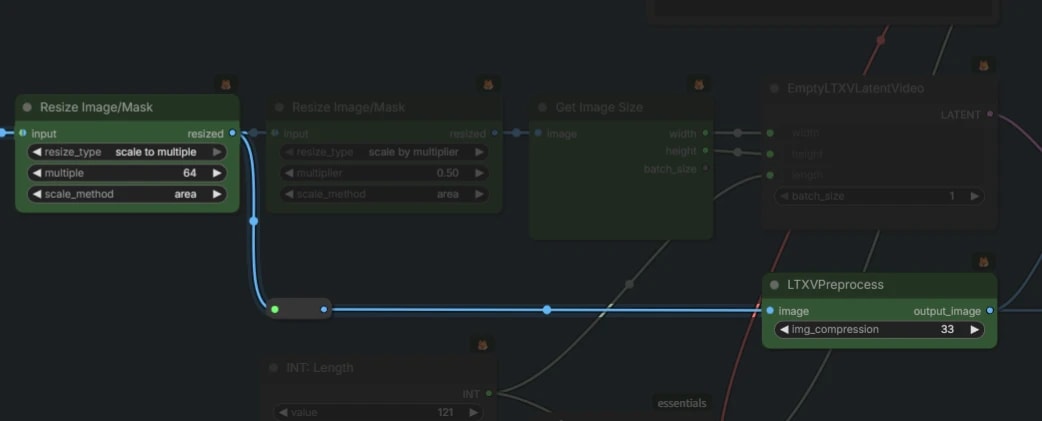
图像的预处理
是来自 LTX-Video 的特征,与静止画不同,视频被稍微压缩劣化了,所以如果使用太漂亮的图像,会生成完全不动的视频。
- 为了回避这个,在
LTXVPreprocess故意像视频的压缩那样劣化。
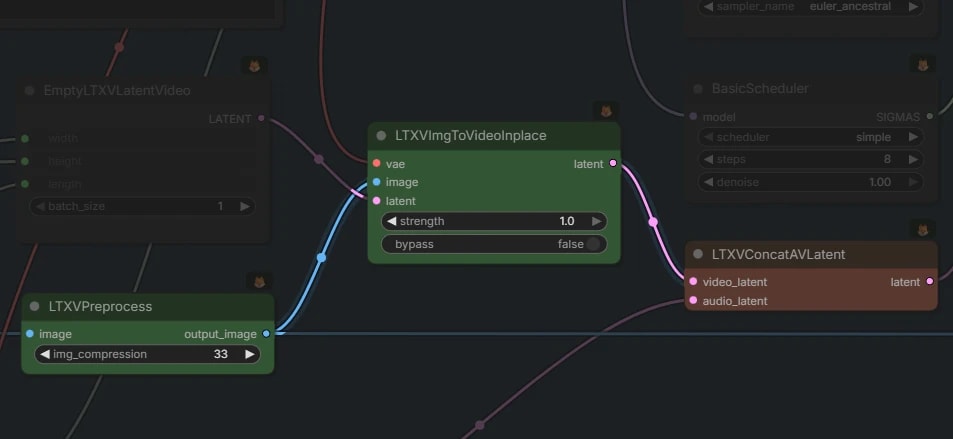
LTXVImgToVideoInplace(第 1 段的插入)
这里是 image2video 的本体。
- 针对第 1 段(半分辨率)的 video latent,用图像插入第 1 帧。
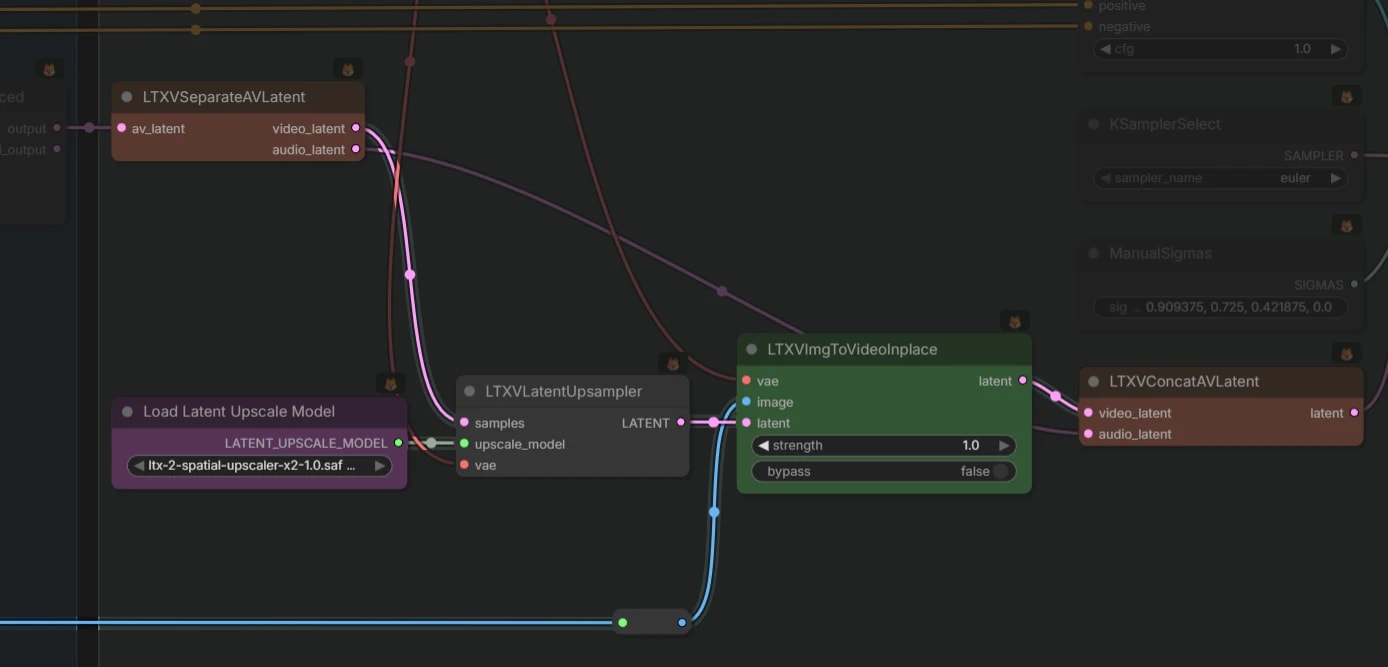
对放缩侧(第 2 段)也做同样的事
第 2 段也同样插入图像。
- 请务必在 spatial 节点 之后 连接这个节点。
- strength 设为
1.0。- 减小这个的话,插入的图像本身也变成被 image2image 那样的举动。
- 如果想让整体适应的话那样也可以,但如果想让输入图像和第 1 帧完全一致的话设为
1.0。
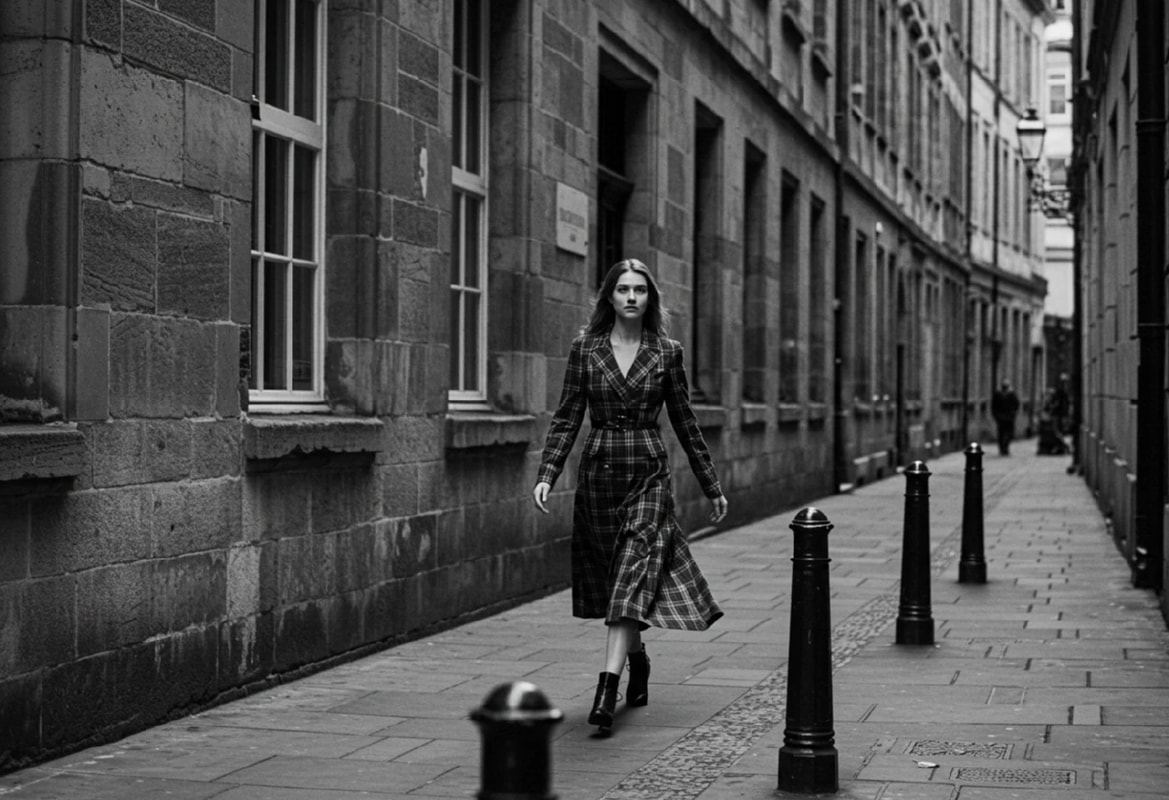
作为已知的问题,有时画面几乎不动,或者变成只是缩小(Zoom Out)的视频。
通过使用适当的提示词会好转多少,但也介绍了为了对此的 LoRA。link + workflow : LTX-2 Image2Video Adapter LoRa
multi-frame I2V
刚才的 image2video workflow,作为输入不仅能传递 1 张图像 也能传递 图像批次(=视频)。
应用这个的话,就能制作将任意的视频的末尾作为“重叠部分”,延长那个前方的 workflow。

取得输入的视频的末尾数帧,生成那个后续,做这样的事。
(1) 输入视频(=图像批次)
    [ 🖼️ 🖼️ 🖼️ 🖼️  ... 🖼️ 🖼️ 🖼️ ]

(2) 从末尾取得 N frames(N = 8n+1)
    [ 🖼️ 🖼️ 🖼️ 🖼️... 🖼️ 🖼️ 🖼️ ]
                      └─── N ───┘

(3) 制作 121 frames 的框,在开头覆盖放入 N frames
    [ 🖼️ 🖼️ 🖼️ 🌫️ 🌫️ 🌫️ ... 🌫️ ]
      └── N ──┘

(4) 生成剩余(121 - N frames)制作后续
    [ 🖼️ 🖼️ 🖼️ ✨ ✨ ✨ ... ✨ ]

(5) 删除开头的 N frames(因为与原视频末尾重复)
    [ ✨ ✨ ✨ ... ✨ ]

(6) 结合原来的视频 + 后续
    [ 🖼️ 🖼️ 🖼️ ... 🖼️] + [ ✨ ✨ ✨ ... ✨ ]
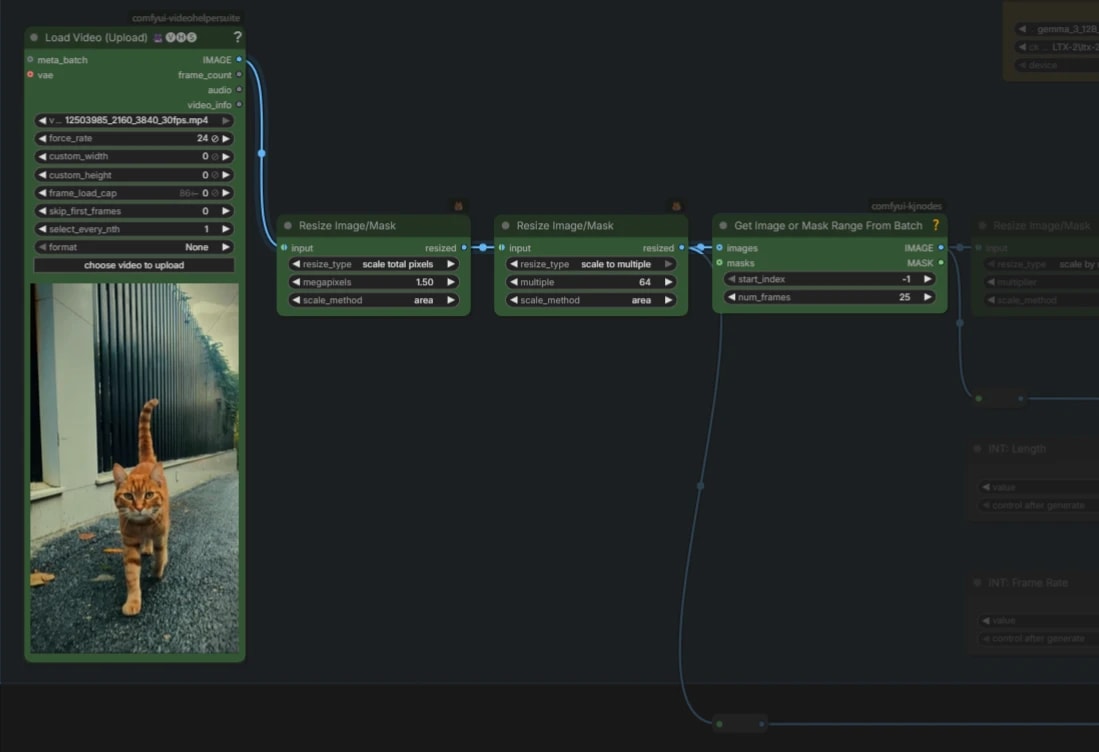
末尾的图像批次取得
从输入视频的末尾,取得成为重叠部分的图像批次。
- 在
Get Image or Mask Range From Batch的num_frames输入任意的张数(有 8n+1 的束缚)。 - 越增加 N 越容易继承原视频的动作和氛围。
- 但是,生成的区间变成 121 - N frames,所以 N 越增加“后续”就越短。
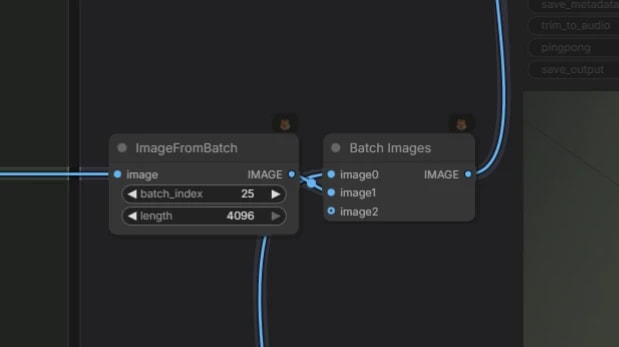
结合生成的视频和原来的视频
虽生成结果在开头包含“重叠部分(原视频末尾 N frames)”,但这部分与原视频重复,所以在结合前删除。
- 删除生成的视频的开头 N frames(在这个例子中是 25 frames)
- 结合到原来的视频的末尾
audio2video
LTX-2 因为是同时处理“视频+音频”的模型,所以也可以传递音频作为输入,构成制作 被声音牵引的视频。
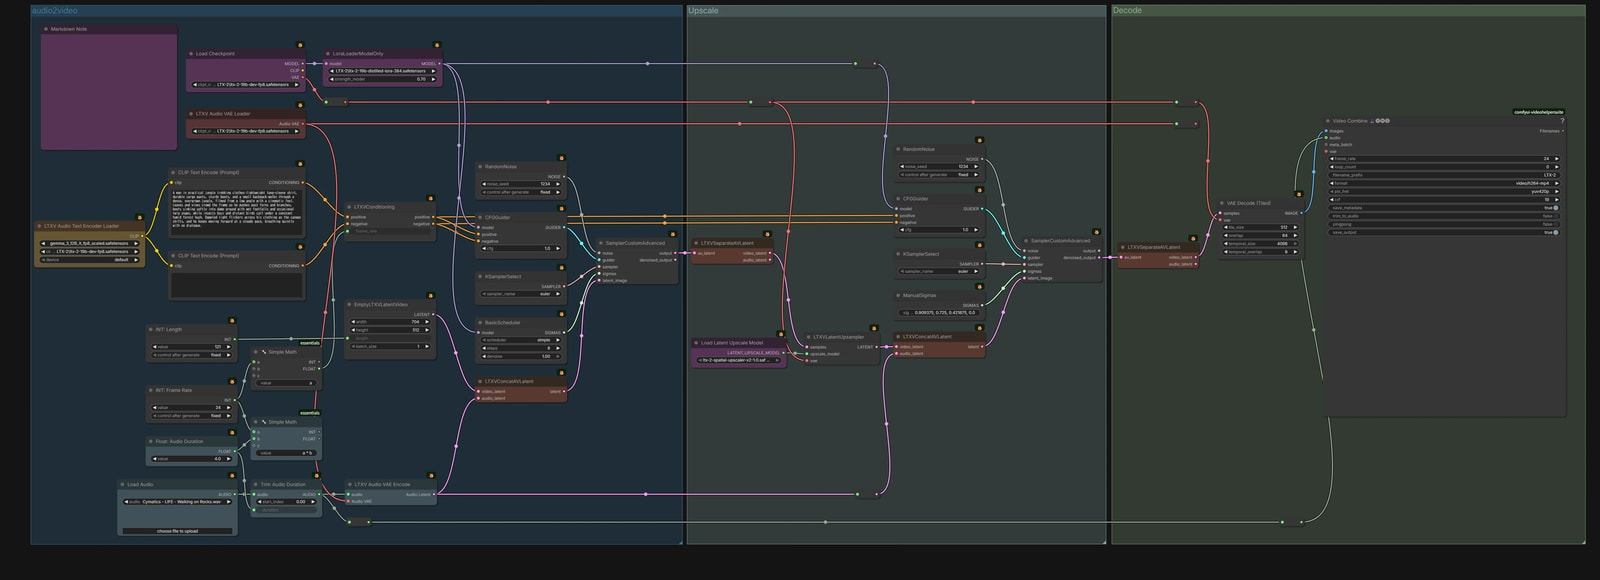
- 在
Trim Audio Duration将音频裁剪为适当的长度 - 编码音频,连接到
LTXVConcatAVLatent。 - 也连接到第 2 段的
LTXVConcatAVLatent。 - 输出视频,直接使用输入音频(不使用生成音频)。
音频的长度比生成的视频的长度 短 的情况下,音频条件不生效。会生成与声音无关的视频。
哪怕是无声也好,必须让其比生成的视频的长度更长。
虽然也看见在这里使用 Set Latent Noise Mask 的工作流,但有没有都是一样的结果。
audio-image2video
也可以组合上面 2 个。
如果在脸部图像组合说话的声音,也可以做 talking head 那样的事。试试看吧。
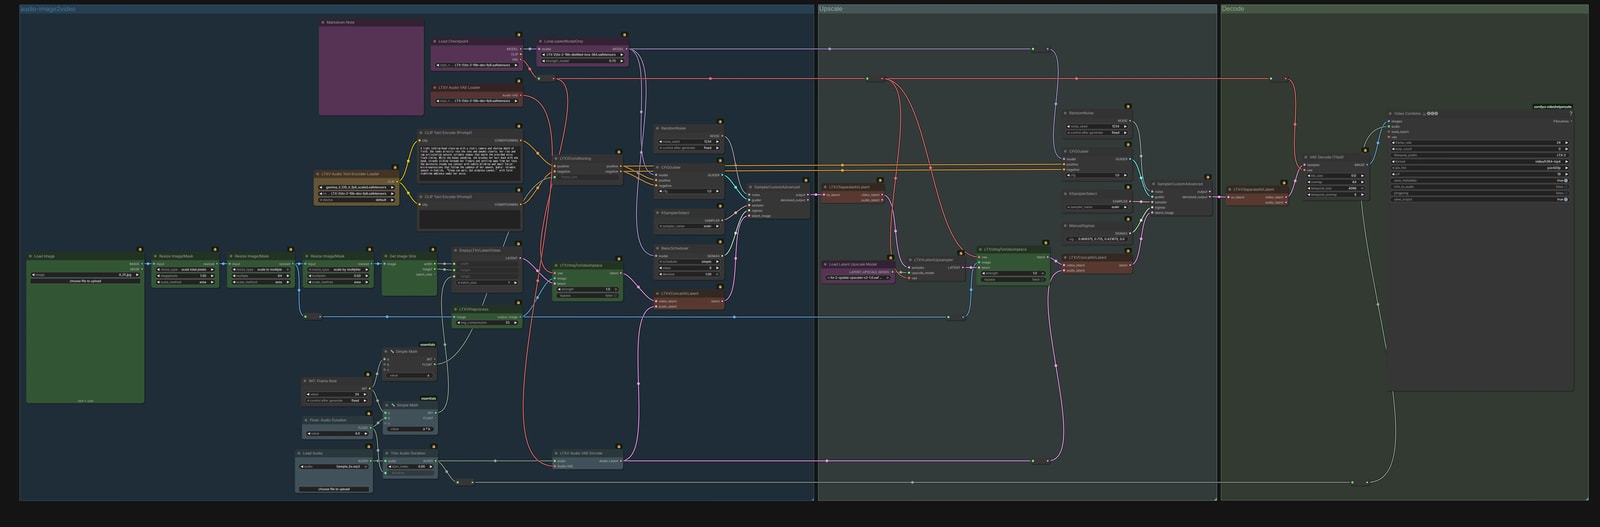
- 只是组合了 audio2video / image2video 这 2 个工作流。
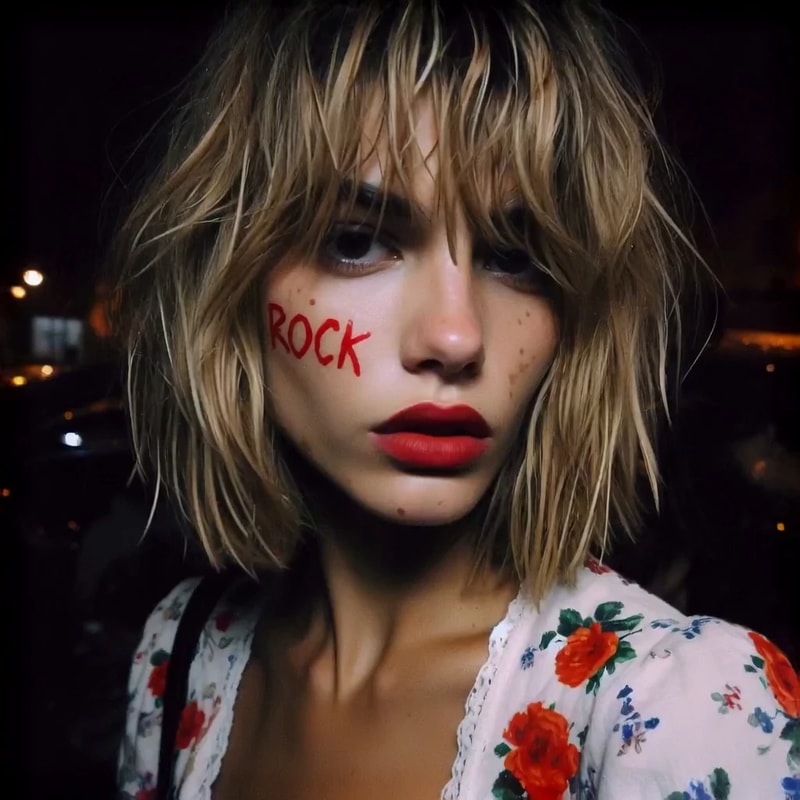
其实因为视频不太跟随台词,所以在提示词加入了台词。也许有更好的工作流。
video2audio
audio2video 的反面,输入视频,也可以生成 适合那个的声音(效果音和环境音)。
这个任务不安定。恐怕需要改良。
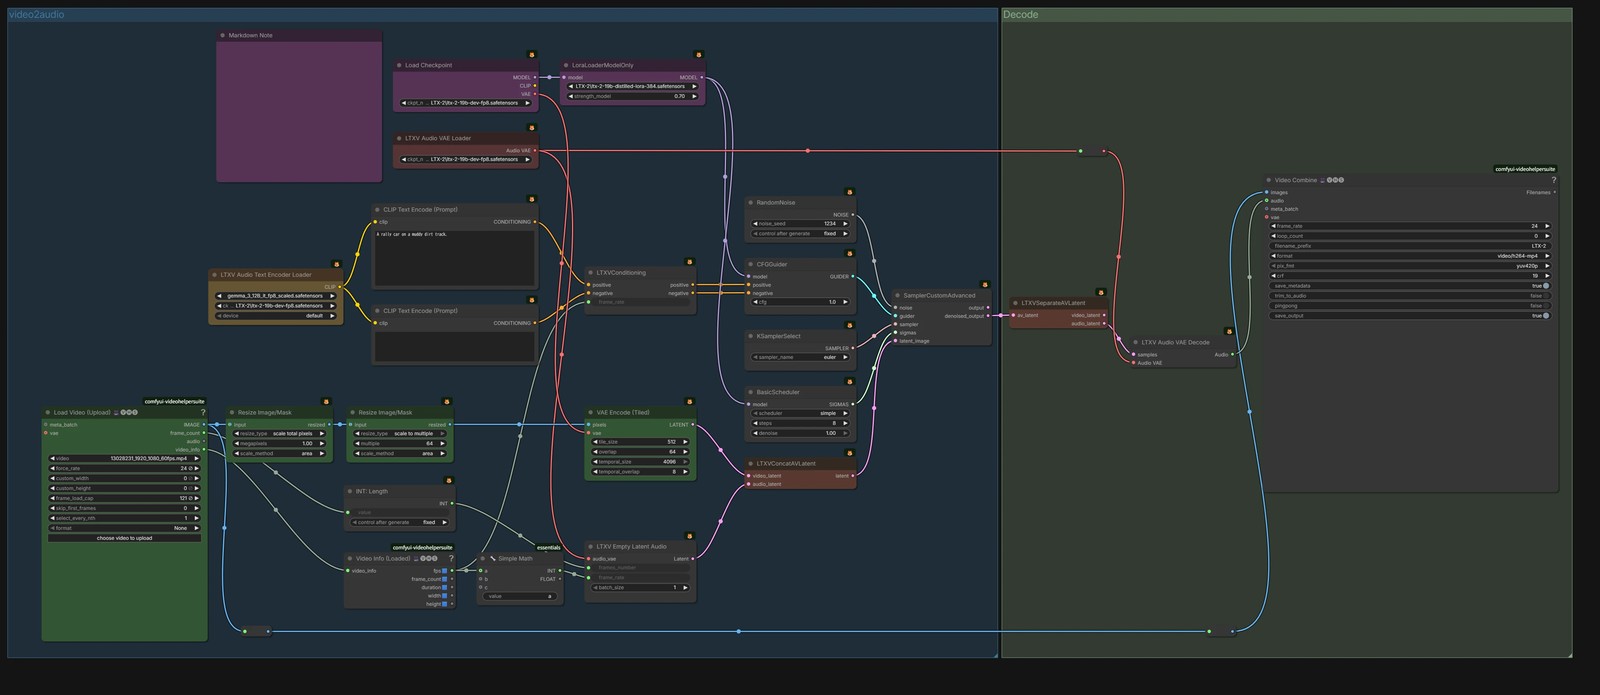
※因为声音很大请注意。
Temporal inpainting
时间方向的 inpainting(=只重新制作视频的一部分)。像 VACE Extension 那样的东西呢。
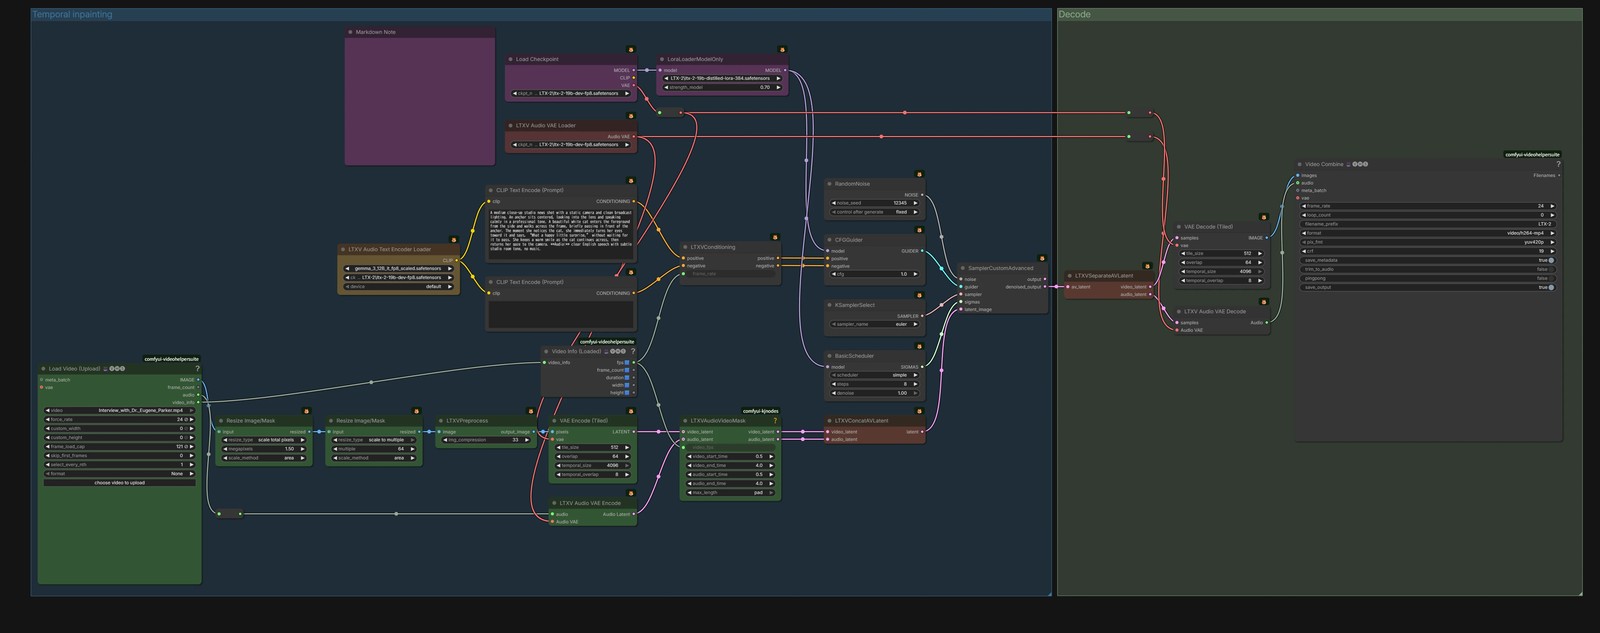
基本是 video2video。
将视频中“想重新制作的时间范围”掩膜,让其只再生成那个区间。
(1) 输入视频(= 既有的 video latent)
    [ 🖼️ 🖼️ 🖼️ 🖼️ 🖼️ 🖼️ 🖼️ 🖼️ 🖼️ 🖼️ ]

(2) 指定想重新制作的区间(start_time ~ end_time)
    例: 2.0s ~ 4.0s
    [ 🖼️ 🖼️ | 🖼️ 🖼️ 🖼️ | 🖼️ 🖼️ 🖼️ ]
             ^           ^
         start_time   end_time

(3) 只对指定区间竖起掩膜
    [   0    0 |  1   1   1 |  0   0   0  ]
               └─── Mask ───┘

(4) 只再生成掩膜区间
    [ 🖼️ 🖼️ | ✨ ✨ ✨ | 🖼️ 🖼️ 🖼️ ]
             └─ inpaint ─┘
构造上,因为难以组建二阶段工作流(低分辨率 → Hires.fix),所以从最初就以 1.5MP 生成。
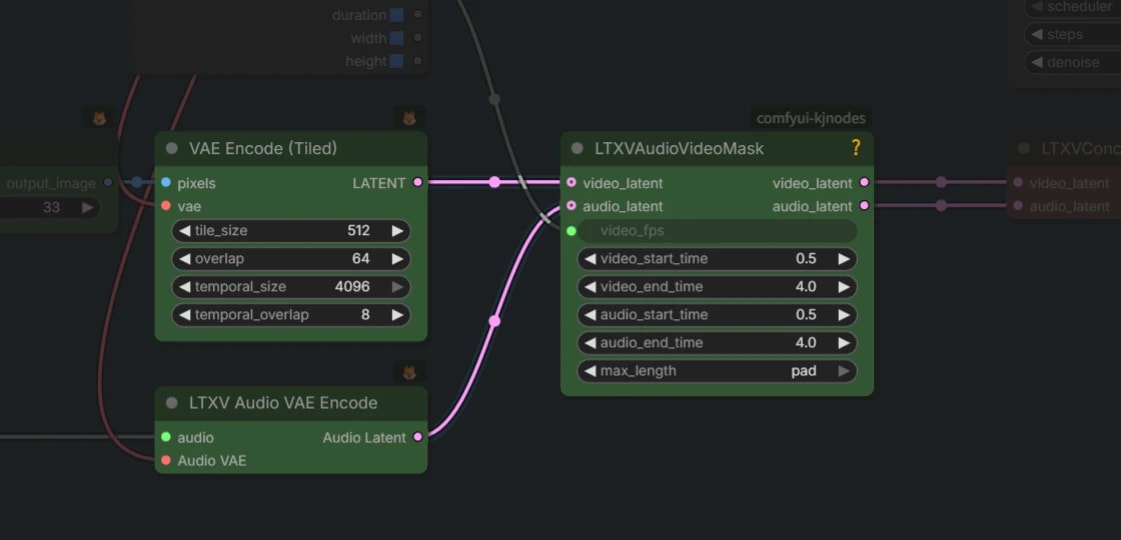
LTXVAudioVideoMask
指定想 inpainting 的时间范围。
video_fps:基本上设为与输入视频相同的 fpsvideo_start_time: inpainting 开始(秒)video_end_time: inpainting 结束(秒)audio_start_time/audio_end_time:基本设为与 video 相同,但通过错开也可以“保持声音原样只编辑影像”“保持影像原样只编辑声音”
也可以延长
指定 end_time 为 比输入视频的长度 后面,超出的部分会被新规生成,结果视频被延长。
例:输入如果是“2秒”
- 重新制作 2.0s → 5.0s(= 新规生成 2 秒以后并延长)
start_time = 2.0/end_time = 5.0
IC-LoRA
IC-LoRA 从姿势和深度图、边缘等的 引导信号制作视频。
模型的下载
- loras
📂ComfyUI/
└── 📂models/
    └── 📂loras/
        ├── ltx-2-19b-ic-lora-canny-control.safetensors
        ├── ltx-2-19b-ic-lora-depth-control.safetensors
        ├── ltx-2-19b-ic-lora-detailer.safetensors
        └── ltx-2-19b-ic-lora-pose-control.safetensors
IC-LoRA (Pose)
以 text2video 的工作流为基础,添加像 ControlNet 那样的控制用的视频输入。
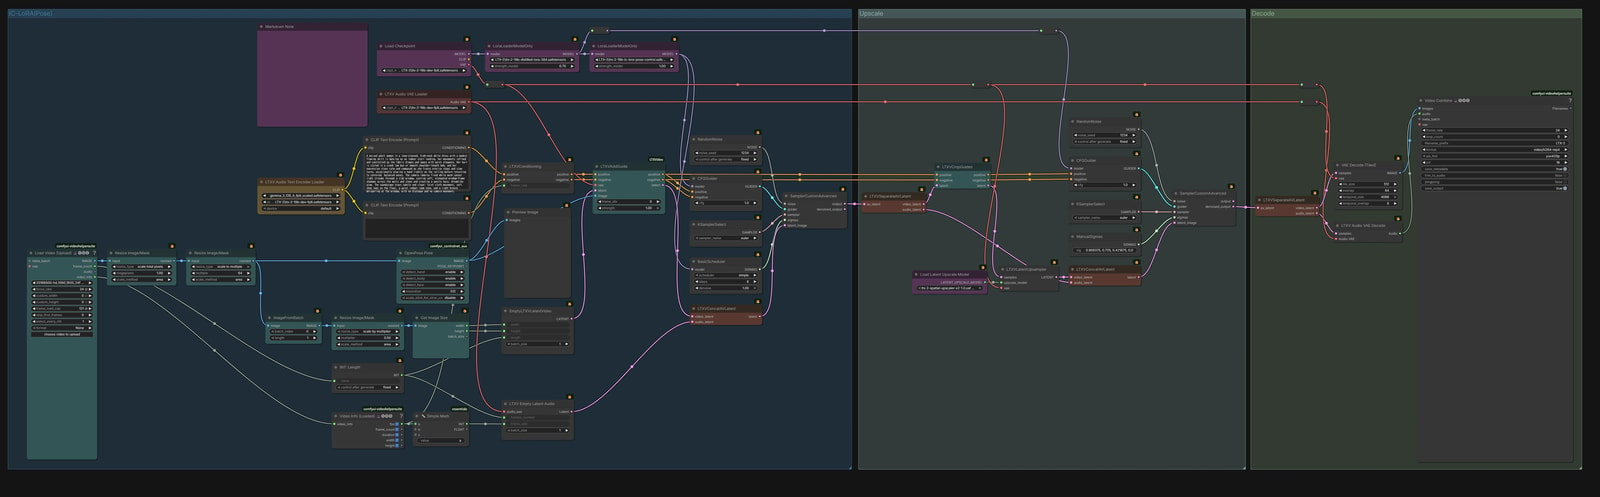
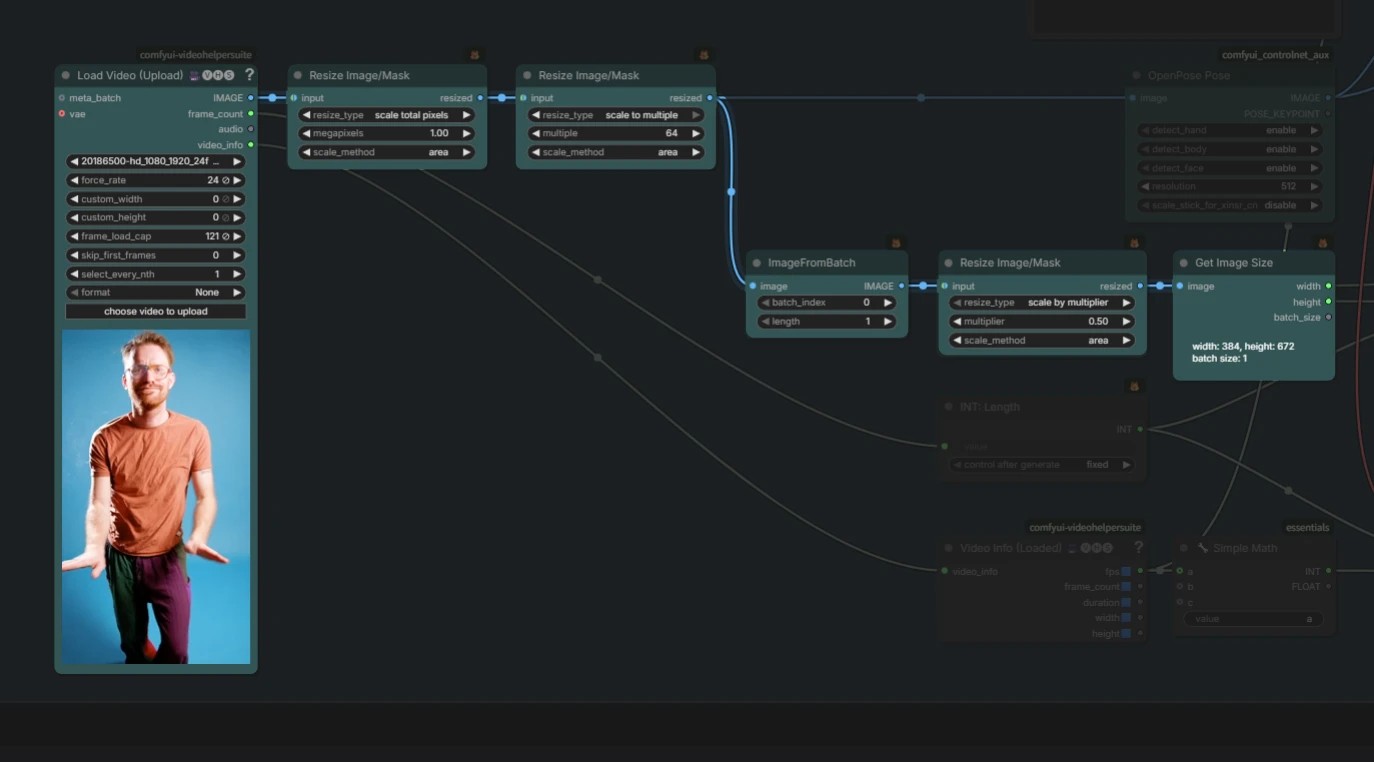
控制视频的调整尺寸
凑齐与由生成的视频相同的比例・分辨率。
- 调整为任意的尺寸 (这里是 1.5MP)。
- 宽・高设为 64 的倍数。
- 在
EmptyLTXVLatentVideo,输入将纵横变为 1/2 的图像的 width/height。
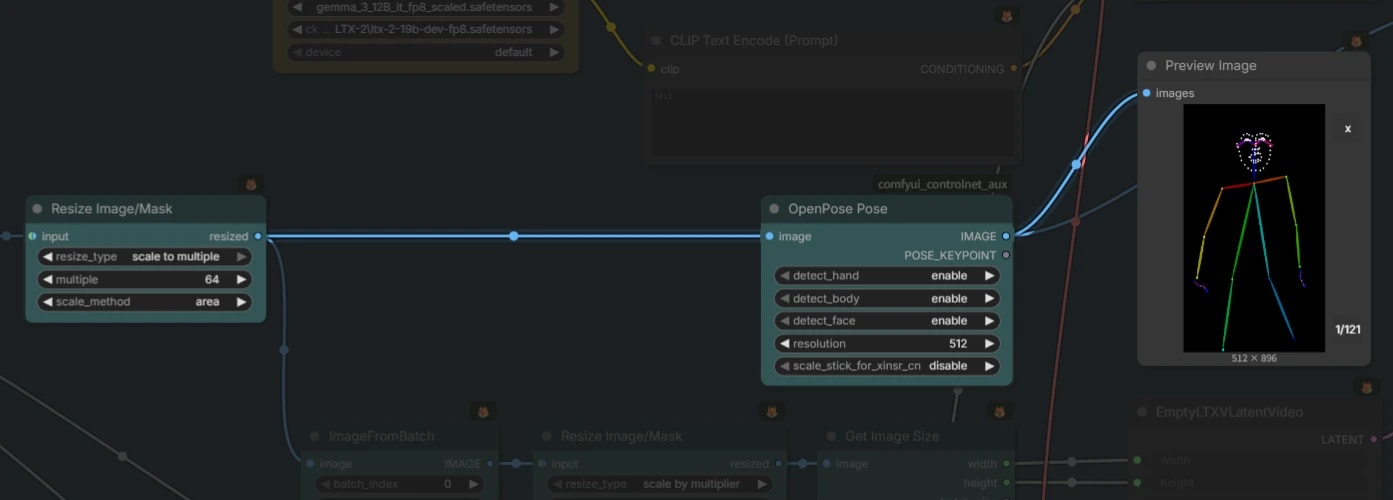
姿势图像的生成
从视频制作火柴人的图像。
- 在 OpenPose 或 DWPose 抽出姿势
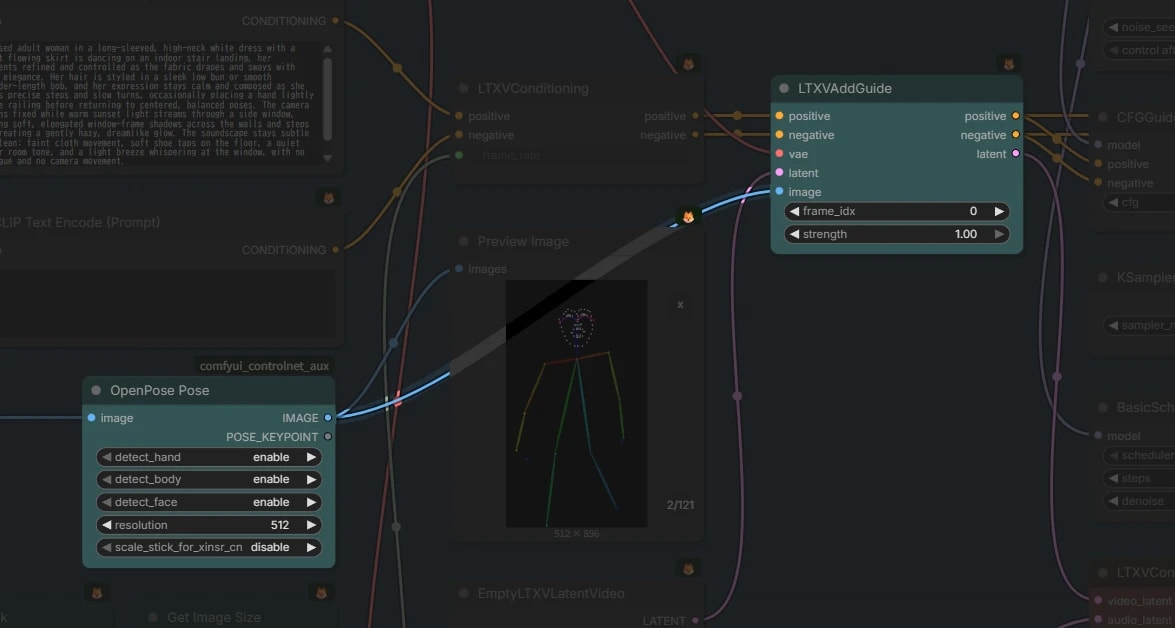
LTXVAddGuide
将控制信号(姿势视频)放入 conditioning。
- 向
LTXVAddGuide输入刚才制作的姿势视频。
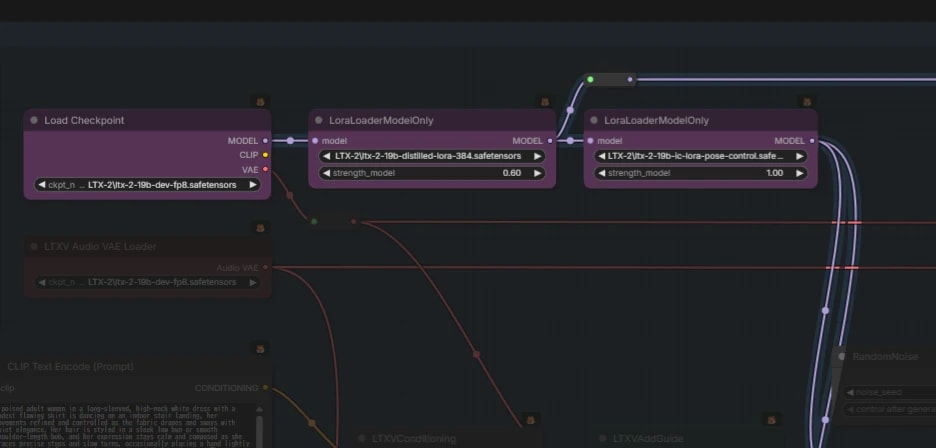
IC-LoRA 的适用
适用 IC-LoRA (这次是 Pose) 并采样。
- IC-LoRA 以
strength = 1.0为前提设计的。 - 在这个工作流中只对第 1 段的采样适用 IC-LoRA。
- 第 2 段专心致志于精炼的话会变成漂亮的视频。
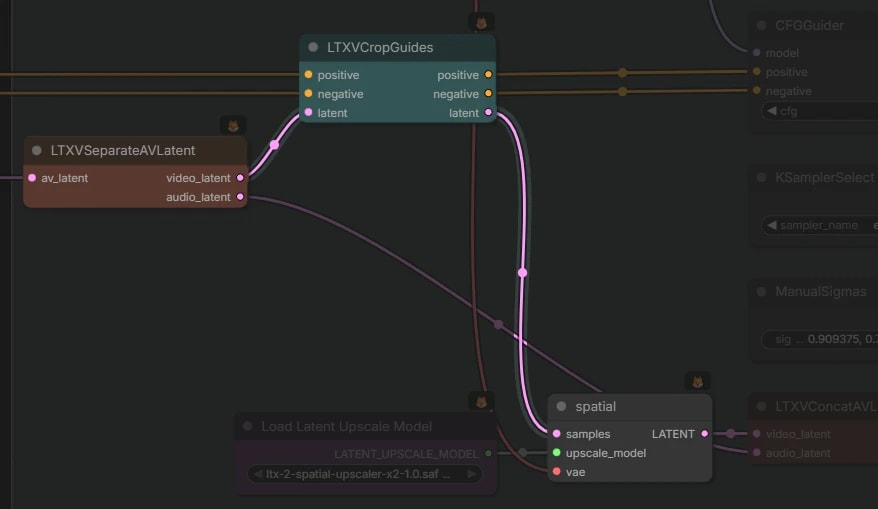
LTXVCropGuides
第 1 段结束后,试着一度解码就容易理解,生成的视频混杂着刚才制作的姿势视频。
- 注目后半 : LTXVCropGuides 前.mp4
这正是 IC-LoRA 的机制,但因为对输出是不需要的东西,所以在进入第 2 段之前删除。
LTXVCropGuides是为了从 latent / conditioning 除去 控制图像 的节点。
如果将姿势图像・IC-LoRA,变更为 Canny / Depth 就能同样地使用。
作为注意点,推荐基本使用 1 种类。(同时适用 Pose 和 Depth 等是非推荐的。)
IC-LoRA (Pose) + image2video
虽然不能重叠复数 IC-LoRA,但可以与 image2video 或 audio2video 组合。
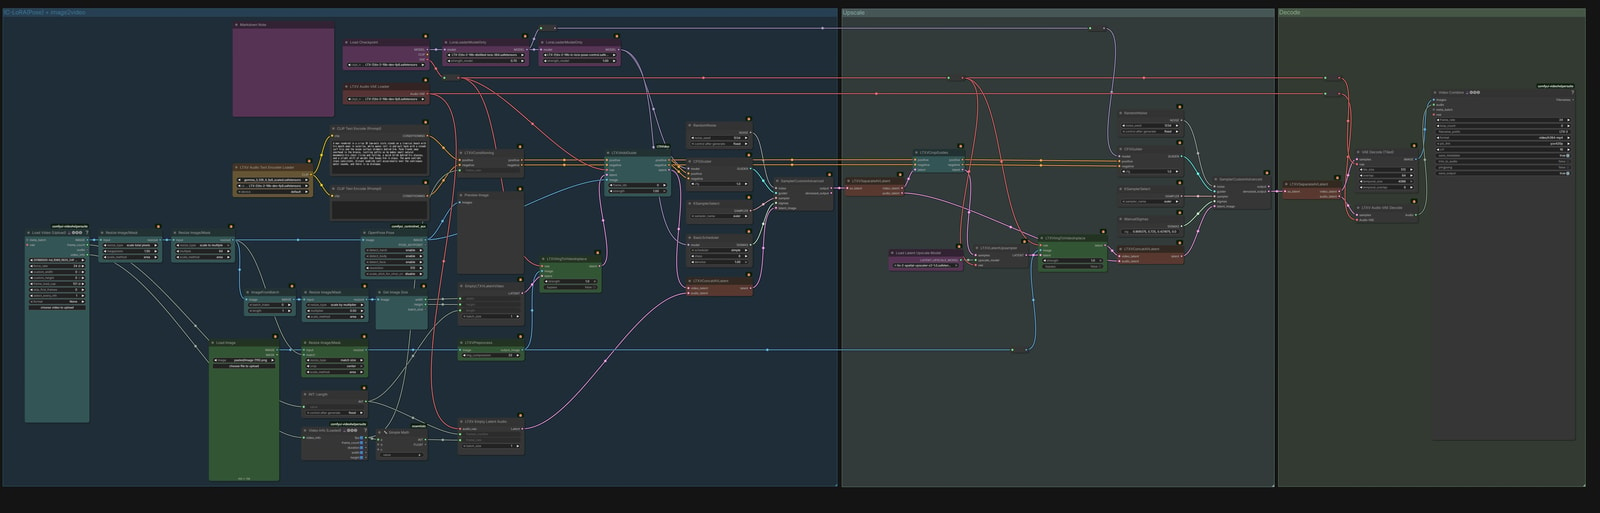
在做的事,只是合体了上面的 IC-LoRA (Pose) 和 image2video。
- 作为注意点,
LTXVAddGuide连接在LTXVImgToVideoInplace的 之后。- 逆过来的话控制不生效。
- 这到底只是 image2video,不是 VACE 那样的 reference2video。
- 因为输入图像是“作为第 1 帧被固定的图像”,所以如果与姿势视频的第 1 帧大幅偏离的话不会变成期待那样的视频。
- 事前在 ControlNet 或 Qwen-Image-Edit 等制作“靠近姿势第 1 帧的图像”吧。
IC-LoRA (Detailer)
IC-LoRA (Detailer) 修复低分辨率的视频的细节和质感。
自定义节点的安装
-
如果只用核心节点虽然能让其动作本身,但为了处理大的分辨率・长时间视频需要自定义节点。
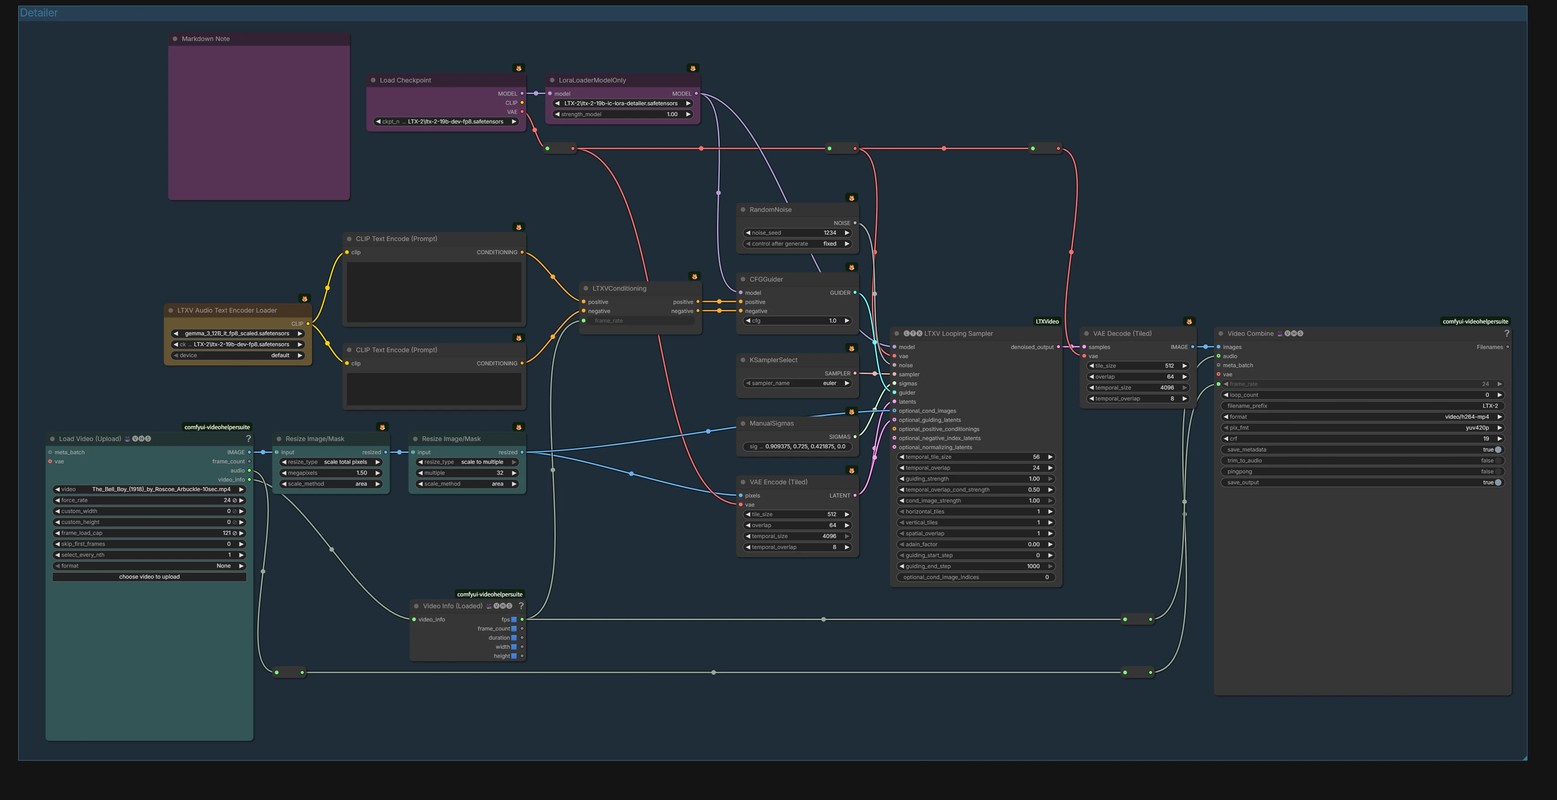
基本是适用了 IC-LoRA(Detailer) 的 video2video。
- 🟦 先将输入视频 リサイズ 为 最终想要的尺寸。
- 代替
SamplerCustomAdvanced使用🅛🅣🅧 LTXV Looping Sampler。- 这像 Ultimate SD upscale 那样将时间・空间分为瓦片处理,所以可以节约 VRAM。
- 在这个工作流中只平铺 时间方向。
- 虽然没有使用蒸馏 LoRA,但以 3 步生成。