什么是 Wan-Animate?
Wan-Animate 是专注于向人・角色传送动作的 Wan2.1-14B-I2V 基础 的模型。
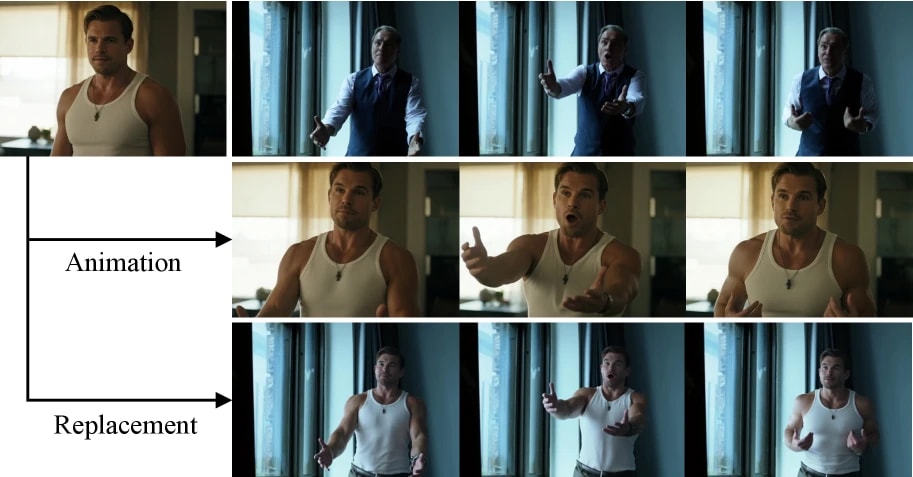
- 配合参照视频的人物的动作,让输入的图像动起来的 Animation 模式
- 将输入视频的人物,替换为参照图像的人物的 Replacement 模式
有 2 种生成模式,如果将 Replacement 模式认为是向 Animation 模式添加了“适应背景那样的处理”的东西,我想比较容易理解。
因为是 Wan2.1 基础,所以只能生成到 77 帧,但也和 Wan2.1 VACE 的 Extension 一样,通过抽出最后的数帧并重复生成那个后续的处理,也可以实质上处理长视频。
必要的自定义节点
作为事前处理进行人脸检测和姿势推断。有以下的自定义节点非常方便。
- ComfyUI-WanAnimatePreprocess
- 通过 YOLO 的人脸检测
- 通过 ViTPose 的姿势(火柴人)抽出
- ComfyUI-segment-anything-2
- 使用 SAM2 的人物掩膜的生成(在 Replacement 模式使用)
模型的下载
凑齐 Wan-Animate 本体和 Wan2.1 系共通的模型。
- diffusion_models
- loras
- clip_vision
- text_encoders
- vae
- gguf(任意)
配置例。
📂ComfyUI/
└── 📂models/
    ├── 📂clip_vision/
    │   └── clip_vision_h.safetensors
    ├── 📂diffusion_models/
    │   └── Wan2_2-Animate-14B_fp8_e4m3fn_scaled_KJ.safetensors
    ├── 📂loras/
    │   └── WanAnimate_relight_lora_fp16.safetensors
    ├── 📂text_encoders/
    │   └── umt5_xxl_fp8_e4m3fn_scaled.safetensors
    ├── 📂unet/
    │   └── Wan2.2-Animate-14B-XXXX.gguf      ← 仅在使用 gguf 时
    └── 📂vae/
        └── wan_2.1_vae.safetensors
Animation 模式
是配合参照视频的人物的动作,让输入的静止画动起来的模式。
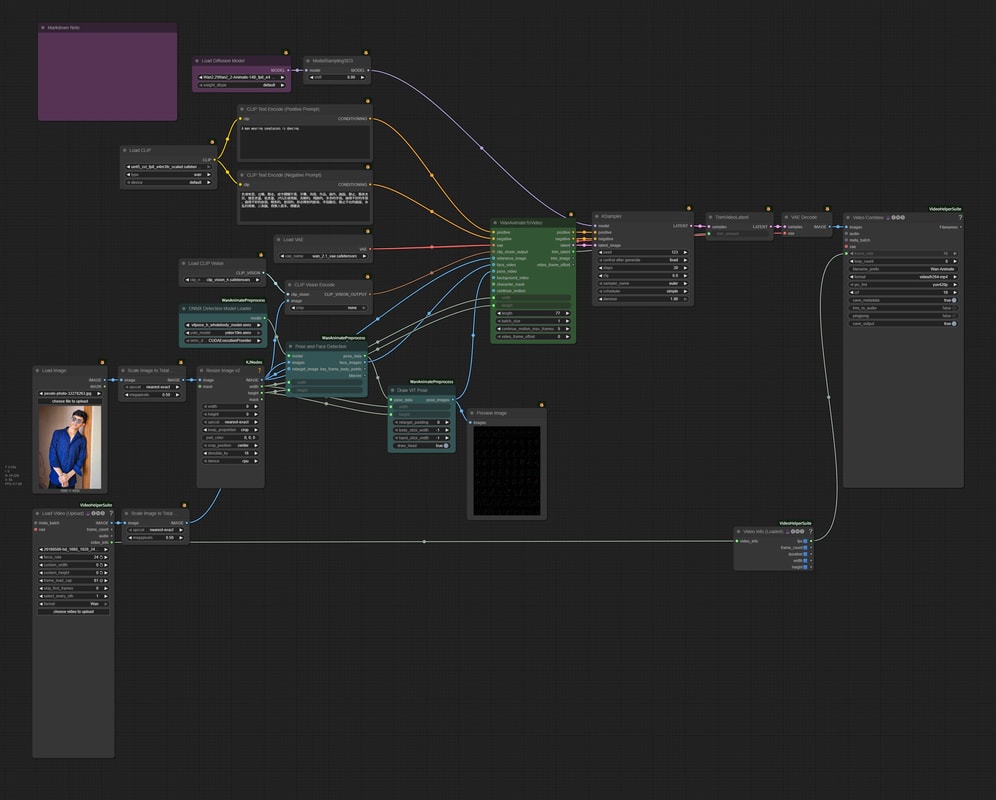
因为相当巨大所以心跳加速,但基础原样是 Wan2.1 image2video 的形式。不要畏惧前进吧。
读取 Wan-Animate 模型
- 在
Load Diffusion Model读取Wan2_2-Animate。
决定生成分辨率
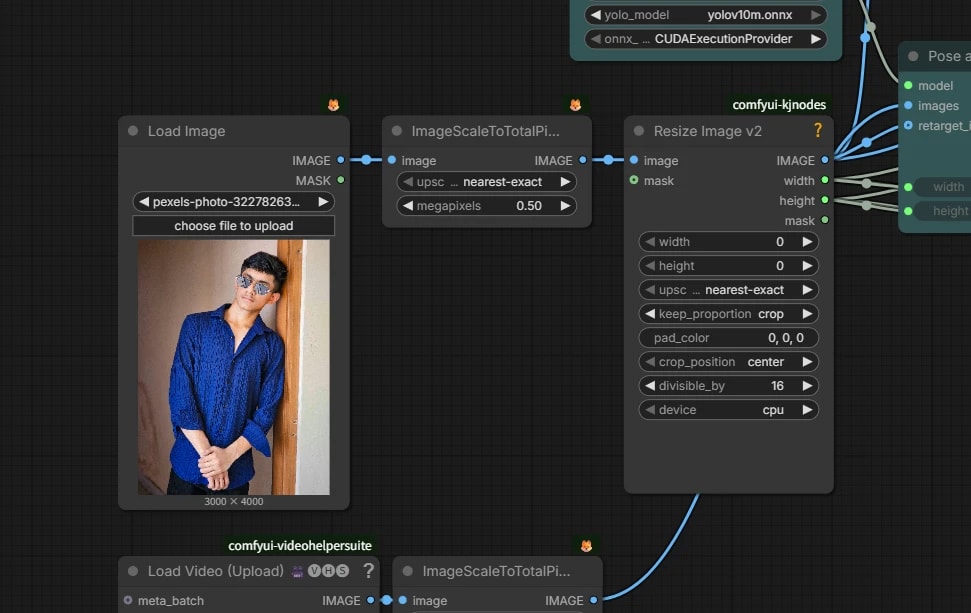
- 配合输入图像在
Scale Image to Total Pixels调整总像素数。 - 请配合 PC 的规格改变数值。
- 最后将分辨率 裁剪为 16 的倍数。
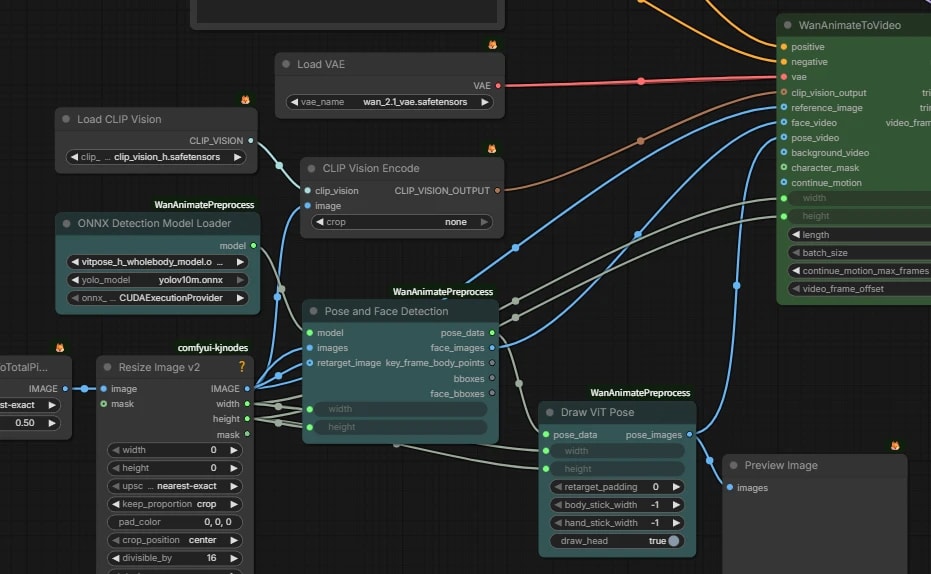
向 WanAnimateToVideo 节点输入追加信息
reference_image想动的静止画。face_video从参照视频裁剪颜部分的视频。Pose and Face Detection自动通过 YOLO 进行人脸检测 → 裁剪。pose_video从参照视频通过 ViTPose 生成火柴人(关键点)的视频。 因为驱动视频和想动的图像骨骼和位置不同,所以在 retarget 处理进行调整。
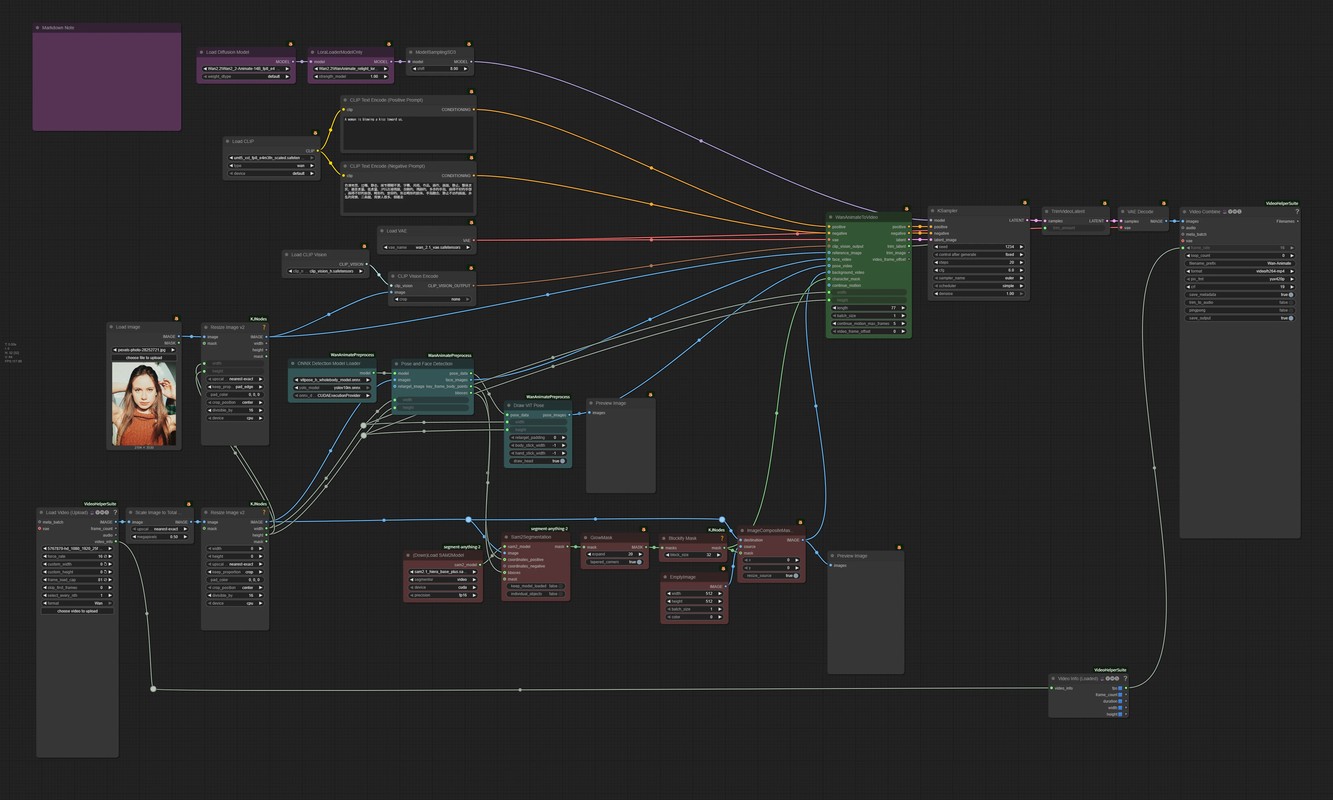
Replacement 模式
将输入视频的人物,替换为参照图像的人物的模式。
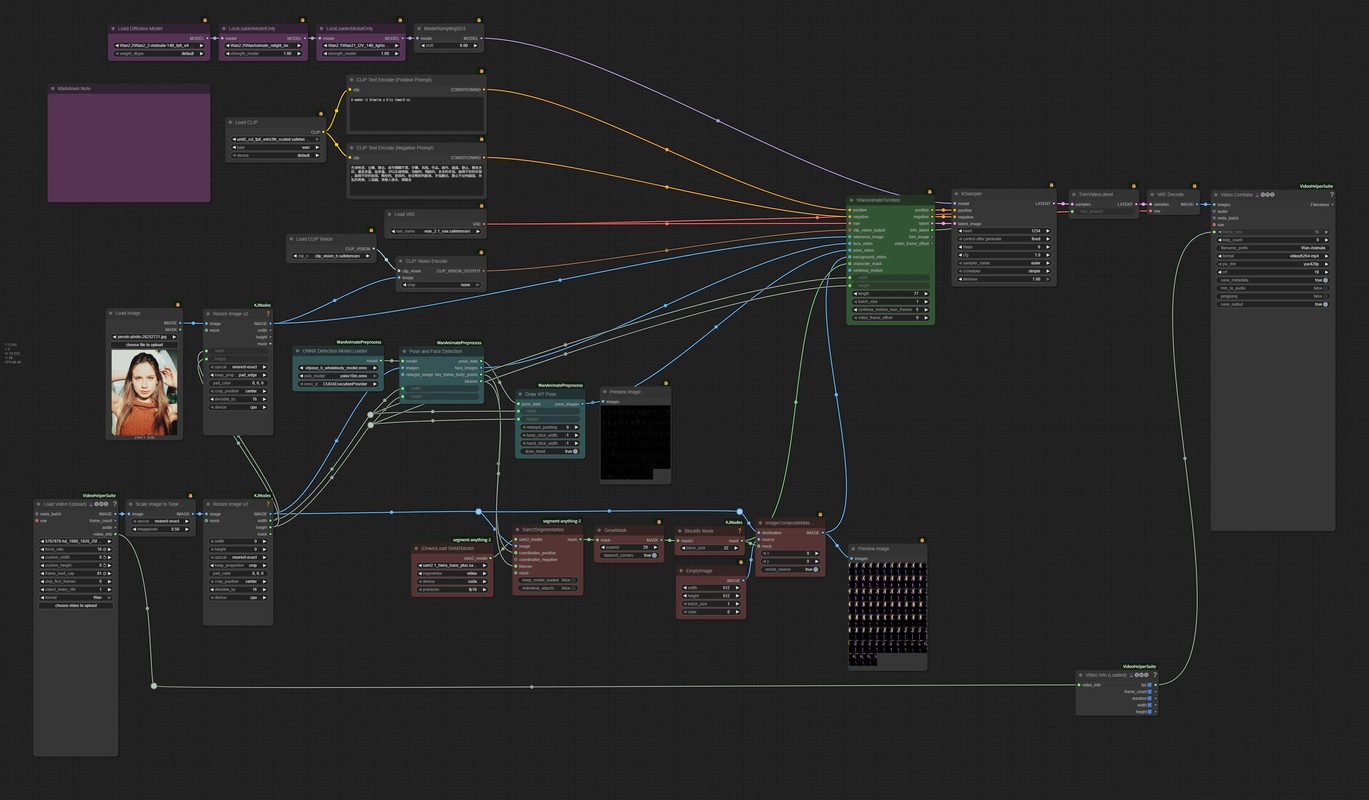
变成向 Animation 模式添加了,为了 inpainting 人物的掩膜,和为了适应背景のリライト処理的东西。
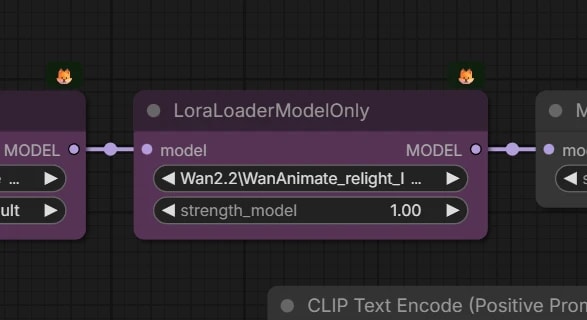
リライト LoRA 的追加
- 为了让替换后的人物溶入背景,添加 રિライト LoRA。
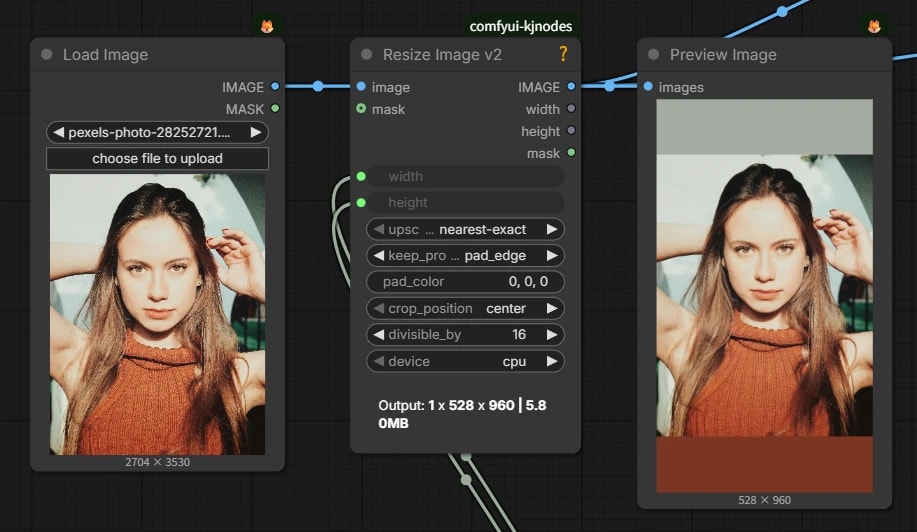
参照图像的 padding
- 因为这次基准是视频,所以配合视频的分辨率 padding 参照图像。
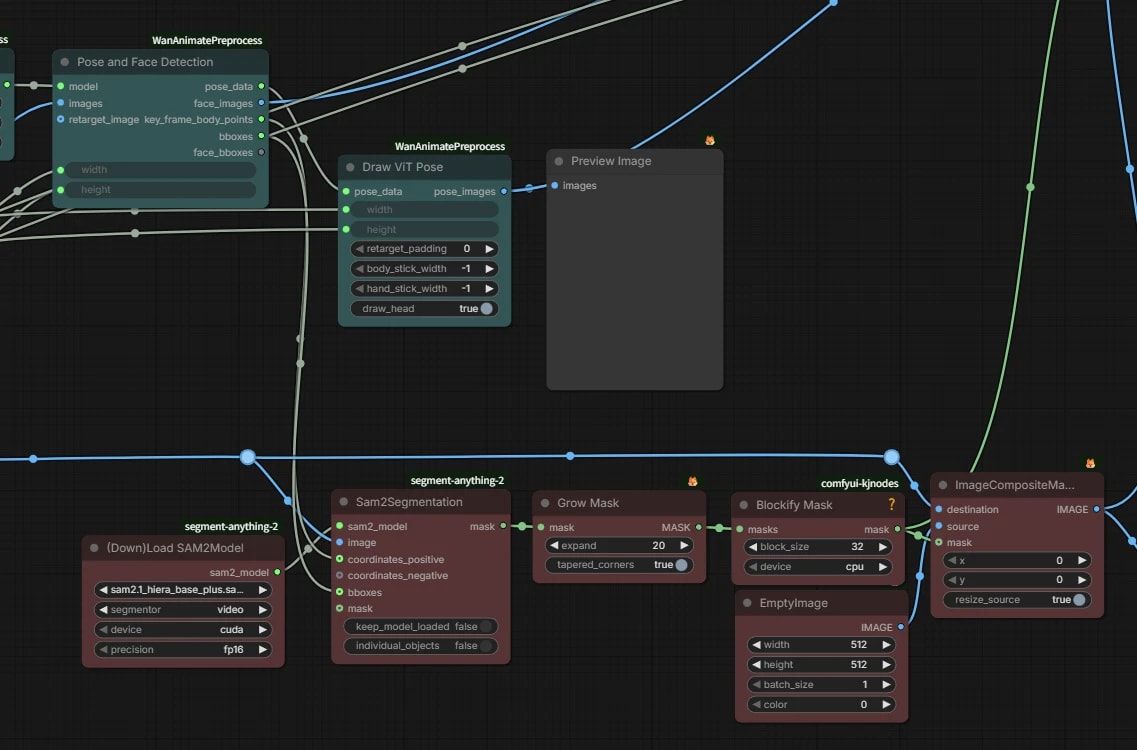
人物掩膜生成
- 将
Pose and Face Detection取得的人物坐标传递给 SAM2.1 生成掩膜。 - 将掩膜稍稍膨胀,在
Blockify节点转换为像点绘那样锯齿状的掩膜作为character_mask。 不这样做的话不知为何生成的视频的轮廓会残留细边。 - 将在
ImageCompositeMasked将掩膜的部分涂黑的视频作为background_video使用。
6 步推论(Lightx2v LoRA)
使用蒸馏 LoRA,可以减少采样步数到 4〜6 steps。
在 text2video 使用的话会介意劣化,但在 Wan-Animate 因为不是从 0 制作视频,所以不怎么介意。想积极地活用。
模型的下载
📂ComfyUI/
└── 📂models/
    └── 📂loras/
        └── Wan21_I2V_14B_lightx2v_cfg_step_distill_lora_rank64.safetensors
Animation 模式(高速版)
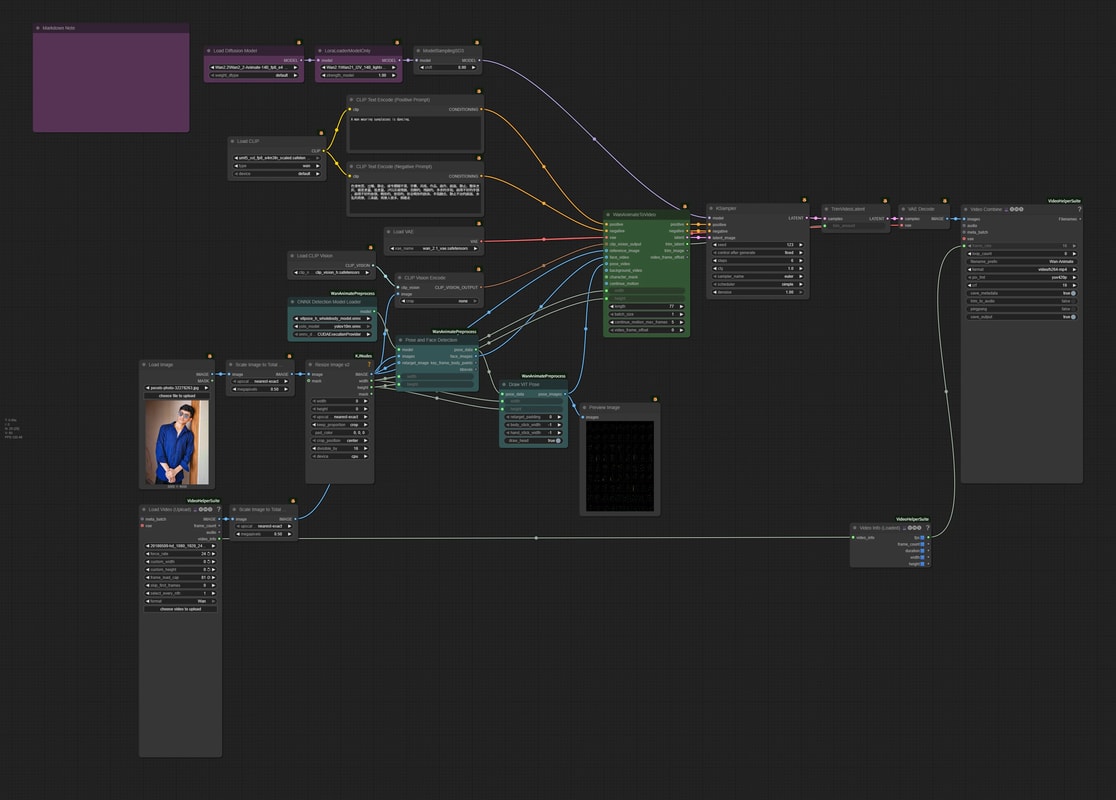
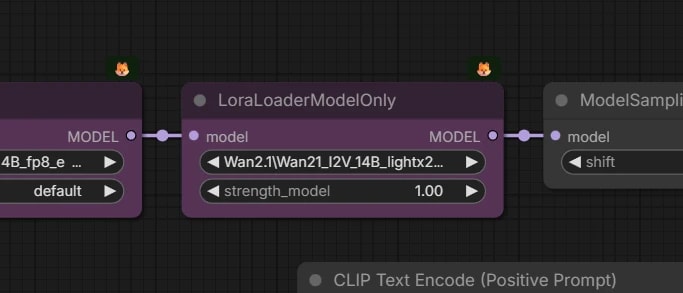
LoRA 的适用
-
🟪 在
LoraLoaderModelOnly读取 Lightx2v LoRA。 -
KSampler 的设定
steps… 4〜6cfg… 1.0
Replacement 模式(高速版)
为了长视频重复处理
Wan-Animate 的基础和 Wan2.1 I2V 同样,1 次推论能生成的上限是 77 帧。 制作超过这个的长视频的情况下,要构成“一边继承最后的数帧,一边重复好几次生成”。
在 ComfyUI 无法进行循环处理,所以变成向后向后串联连接几乎相同的工作流的形式。
这里老实说称不上 SMART 的处理,是向 Kijai 先生的 ComfyUI-WanVideoWrapper 的实现退让一步的部分。
Animation 模式(Repeat)
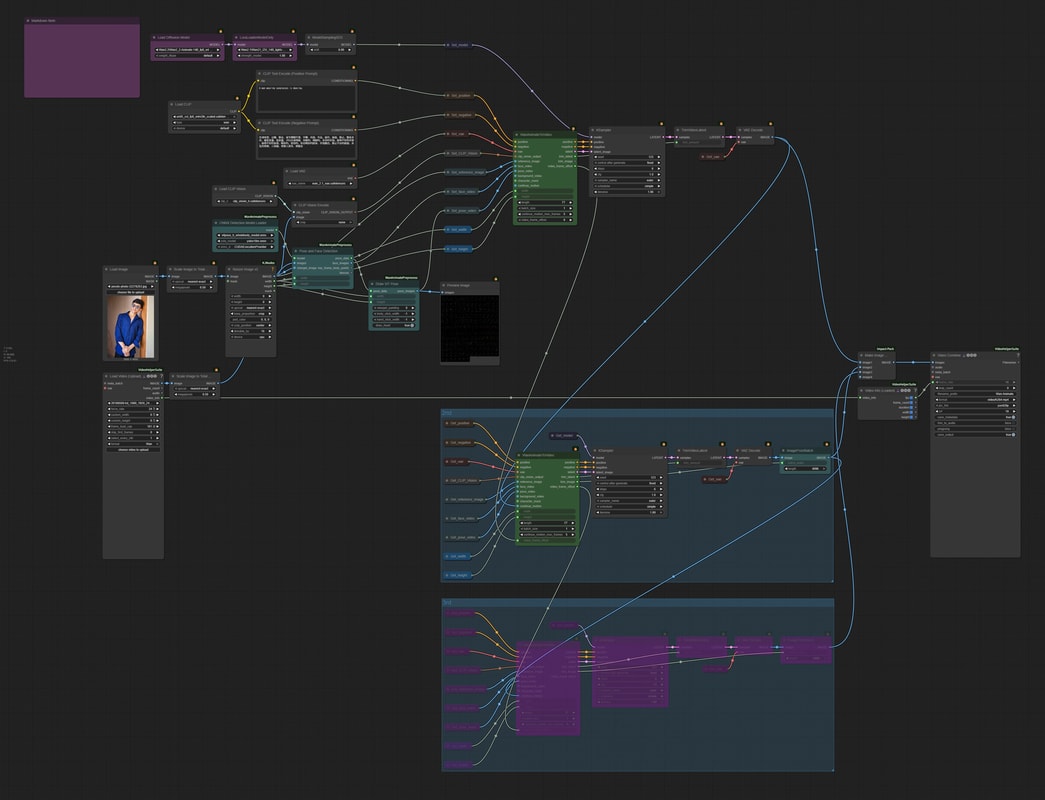
乍一看是巨大的工作流,但与至今的东西不同的点只有以下 2 点。
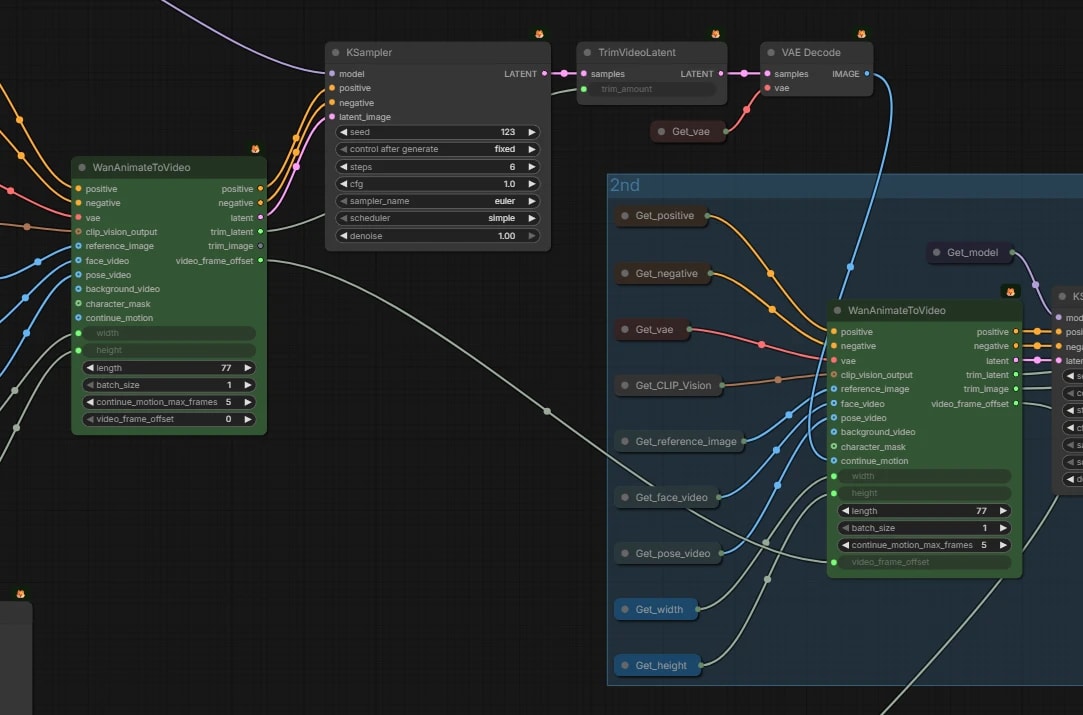
-
video_frame_offset- 第 1 次生成了 77 帧的情况下,第 2 次必须从第 78 帧以后使用
face_video和pose_video。 - 向
video_frame_offset输入偏移帧数的话,会自动错开face_video/pose_video的参照开始位置。
- 第 1 次生成了 77 帧的情况下,第 2 次必须从第 78 帧以后使用
-
continue_motion_max_frames- 设定作为重叠部分的帧数。
- 例如将
length设为 77,continue_motion_max_frames设为 5 的话,使用上次的最后 5 帧,新生成剩余的 72 帧。
如果重复连接这个组,理论上可以制作无限长的视频。 但是和复印机一样,误差会一点点积累下去。
Replacement 模式(Repeat)