什么是 SCAIL-2?
SCAIL-2 是一个基于 Wan2.1 的模型,专门用于人物和角色的动作迁移。
它和 Wan-Animate 以及前作 SCAIL-1 最大的区别是,不会先转换成火柴人之类的中间表示。
用 ViTPose 或 OpenPose 做出火柴人,再把它作为条件来驱动人物。过去这算是很自然的想法,但一旦转换成火柴人,很多信息都会丢失。
深度、接触、多人之间的交错动作、非人类角色的动作等等……
所以 SCAIL-2 会把参考图像和动作视频几乎原样传给 DiT。
与其由人来手搓复杂的处理流水线,不如准备合适的数据集,让 AI 理解这个任务。这样得到的东西往往更灵活,也更好用。这种思路今后应该会越来越常见。
下载模型
- checkpoints
- sam3.1_multiplex_fp16.safetensors (1.75 GB)
- clip_vision
- clip_vision_h.safetensors (1.26 GB)
- diffusion_models
- loras
- text_encoders
- umt5_xxl_fp8_e4m3fn_scaled.safetensors (6.74 GB)
- vae
- wan_2.1_vae.safetensors (254 MB)
📂ComfyUI/
└── 📂models/
    ├── 📂checkpoints/
    │   └── sam3.1_multiplex_fp16.safetensors
    ├── 📂clip_vision/
    │   └── clip_vision_h.safetensors
    ├── 📂diffusion_models/
    │   └── wan2.1_14B_SCAIL_2_fp8_scaled.safetensors
    ├── 📂loras/
    │   └── Wan21_I2V_14B_lightx2v_cfg_step_distill_lora_rank64.safetensors
    ├── 📂text_encoders/
    │   └── umt5_xxl_fp8_e4m3fn_scaled.safetensors
    └── 📂vae/
        └── wan_2.1_vae.safetensors
Animation 模式
用动作视频来驱动 参考图像。
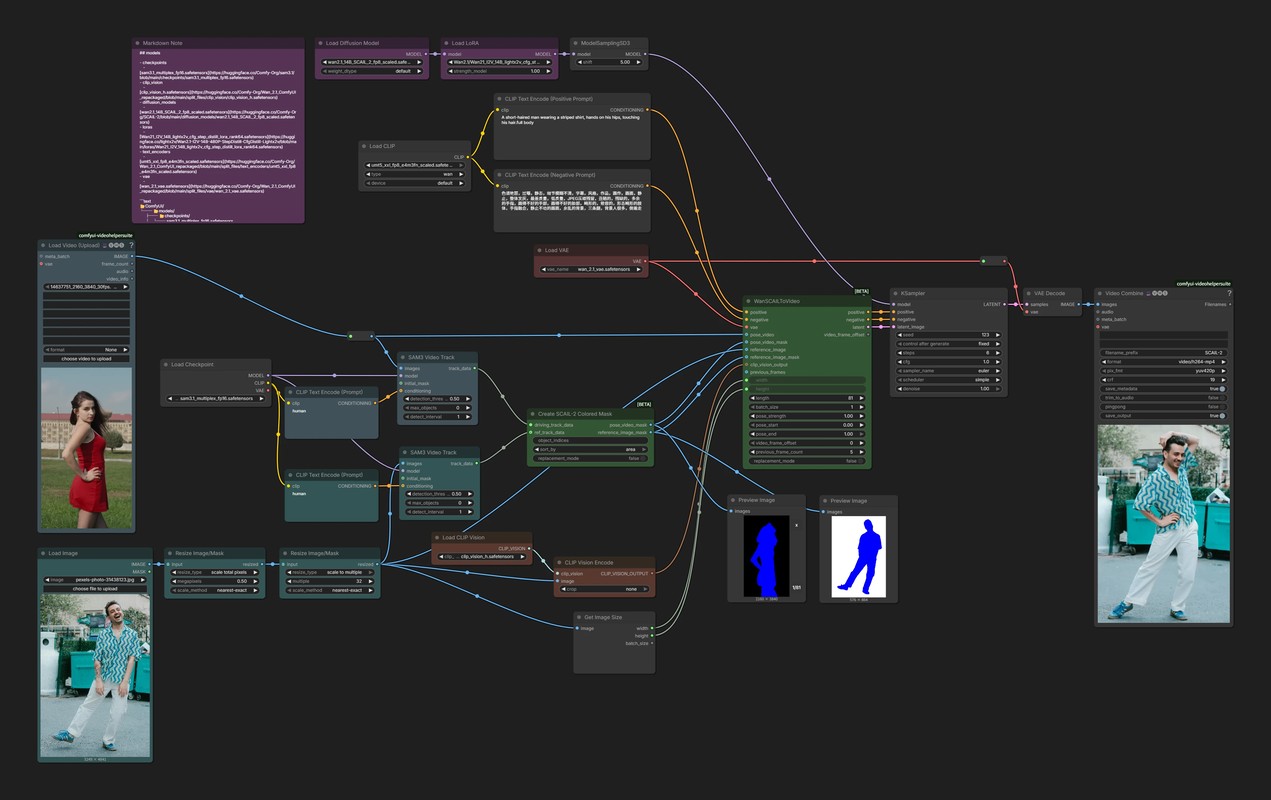
基础工作流和 Wan-Animate 相同,但简单了很多,放轻松往下看吧。
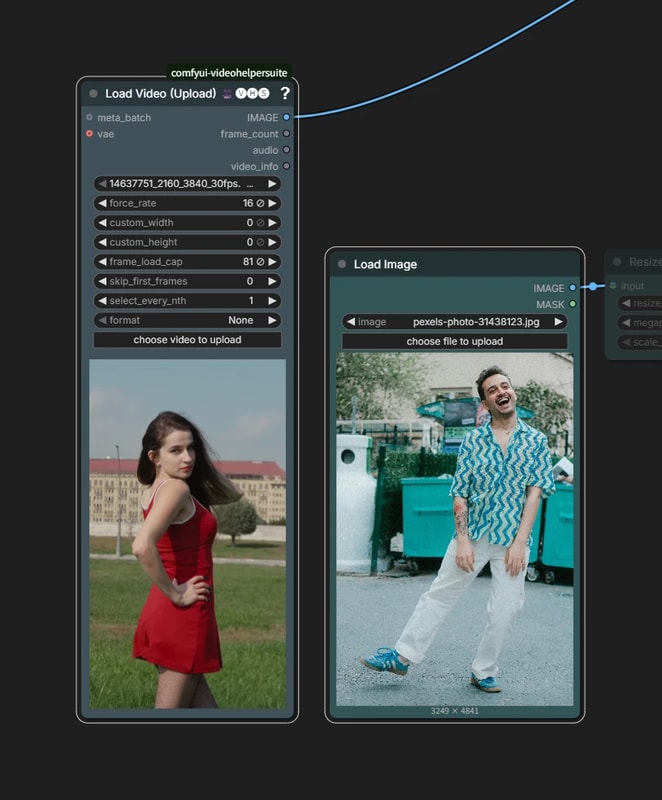
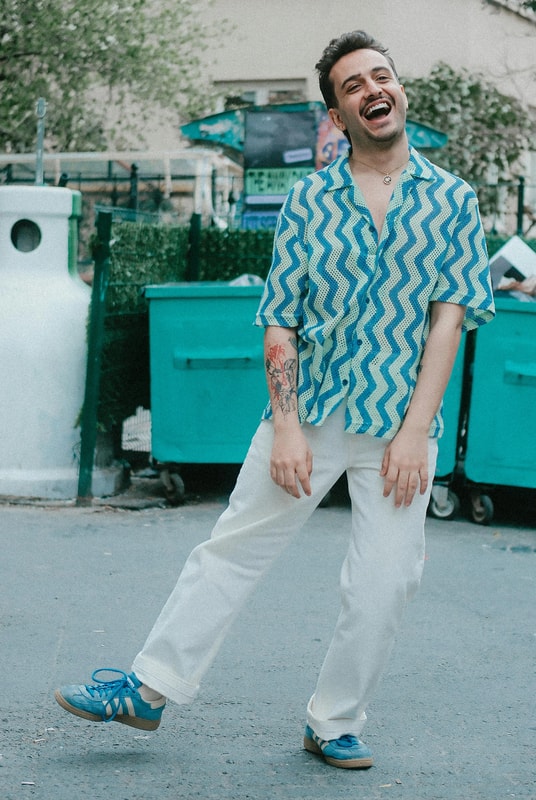
参考图像与动作视频
参考图像和动作视频会在内部缩放,所以不需要统一成相同尺寸。
- 长宽比相近会更好处理。
- 图像和视频中的姿势不需要完全一致。
- 不过差得太多就会失败。
- 参考图像最好选择接近动作视频第 1 帧的图像。
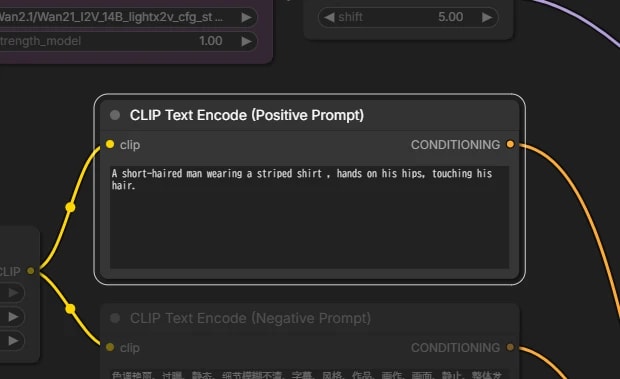
提示词
只是迁移动作而已,所以不需要很详细的提示词。
- 不过太短的话容易失败,尤其是在 Replacement 模式 下。
- 以这次为例,可以像
穿着衬衫的男性一只手扶着腰,另一只手摸着头发这样,写出足以说明想要什么样视频的提示词。
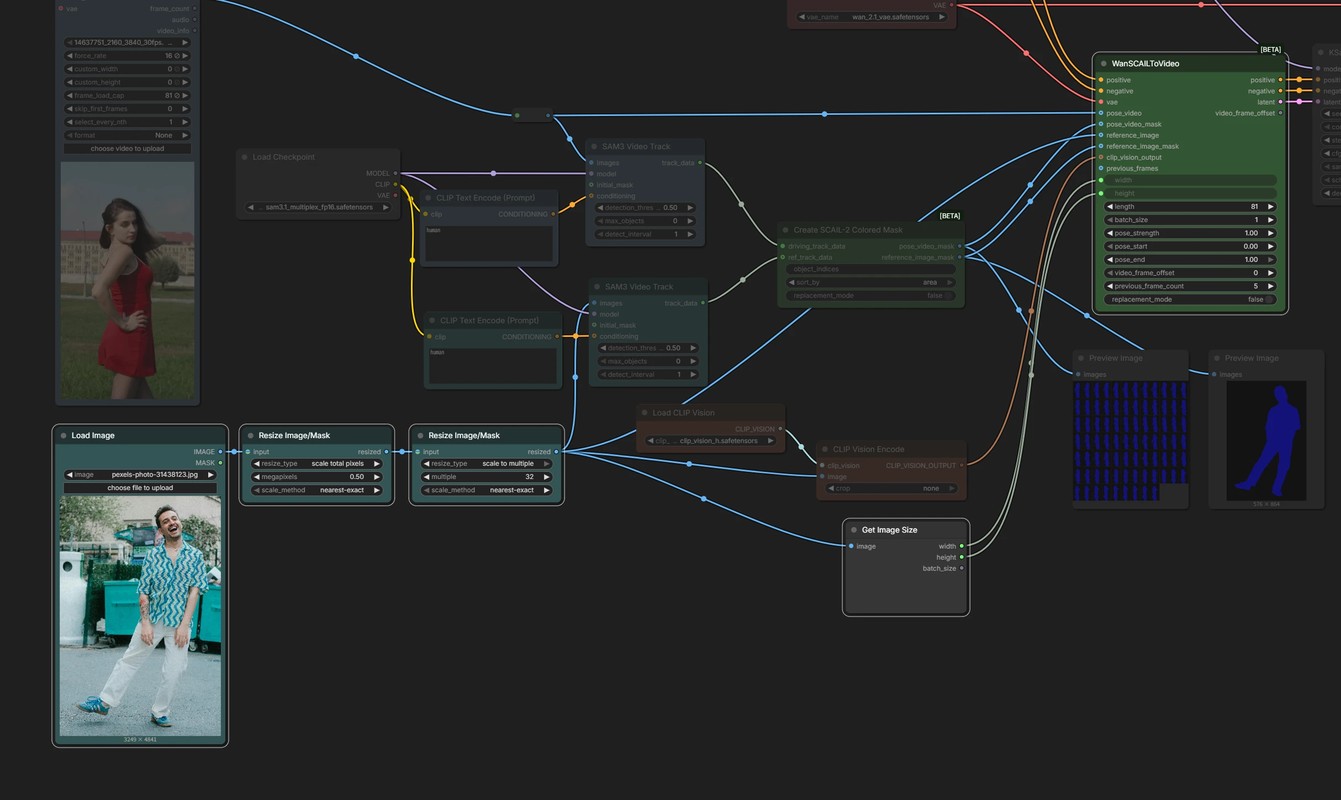
分辨率与帧数
生成尺寸和帧数在 WanSCAILToVideo 中设置。
- 推荐分辨率为 480p(864×480)到接近 720p(1280×704),并且是 32 的倍数
- 最大帧数为 81
- 这次把参考图像缩放后,用它的尺寸作为生成分辨率。
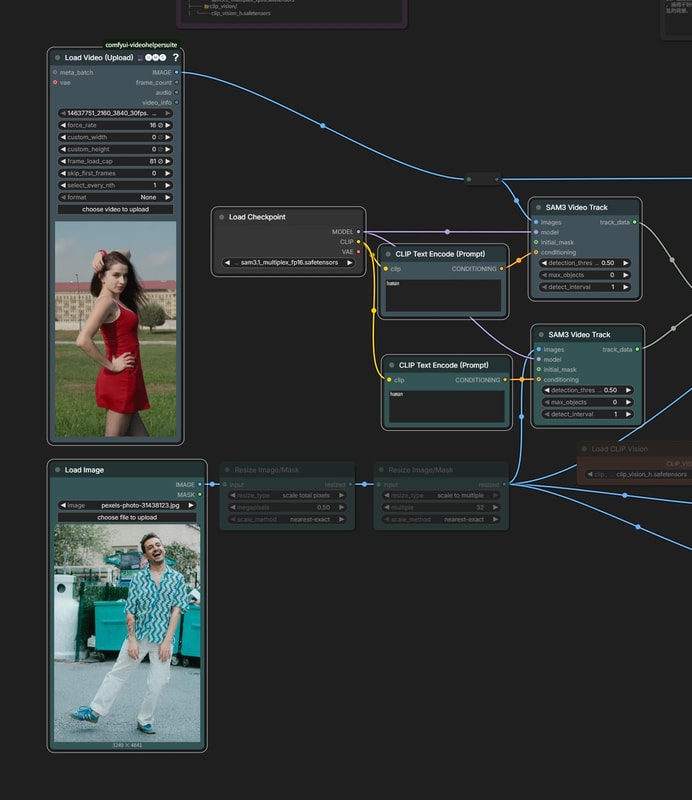
用 SAM3.1 生成遮罩
用 SAM 3 / 3.1 给参考图像和动作视频中的人物生成遮罩。
- 这不是 inpainting 用的那种精确遮罩,只是用来告诉 SCAIL-2 人物对应关系的辅助信息,所以稍微有点偏差也没问题。
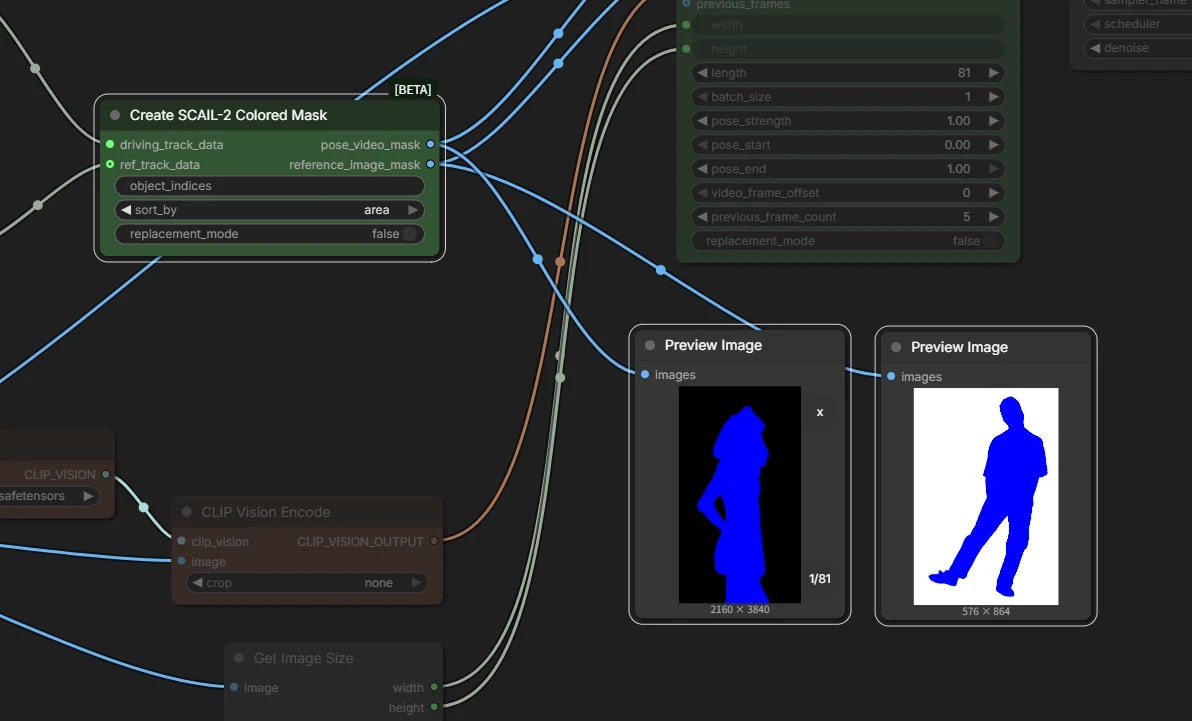
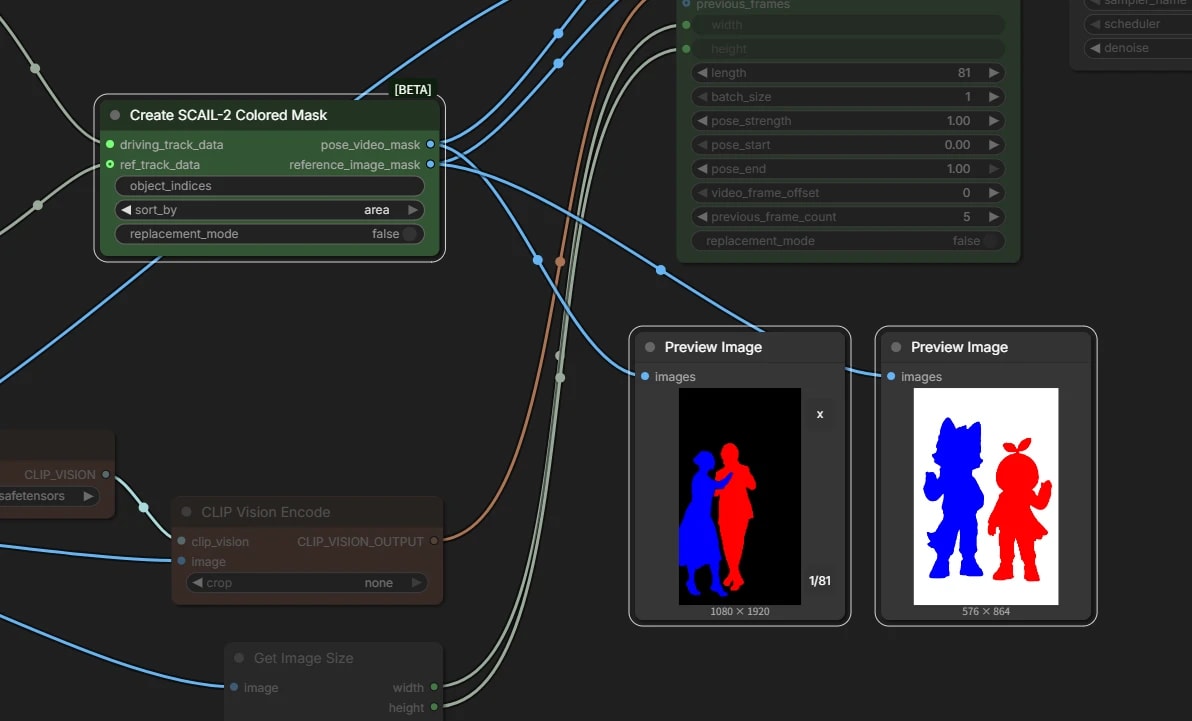
Create SCAIL-2 Colored Mask
会给生成的遮罩涂上合适的颜色。
- 多人时这一步会稍微重要一些,详见后文。
Replacement 模式
将 视频中的人物 替换为 参考图像中的人物。
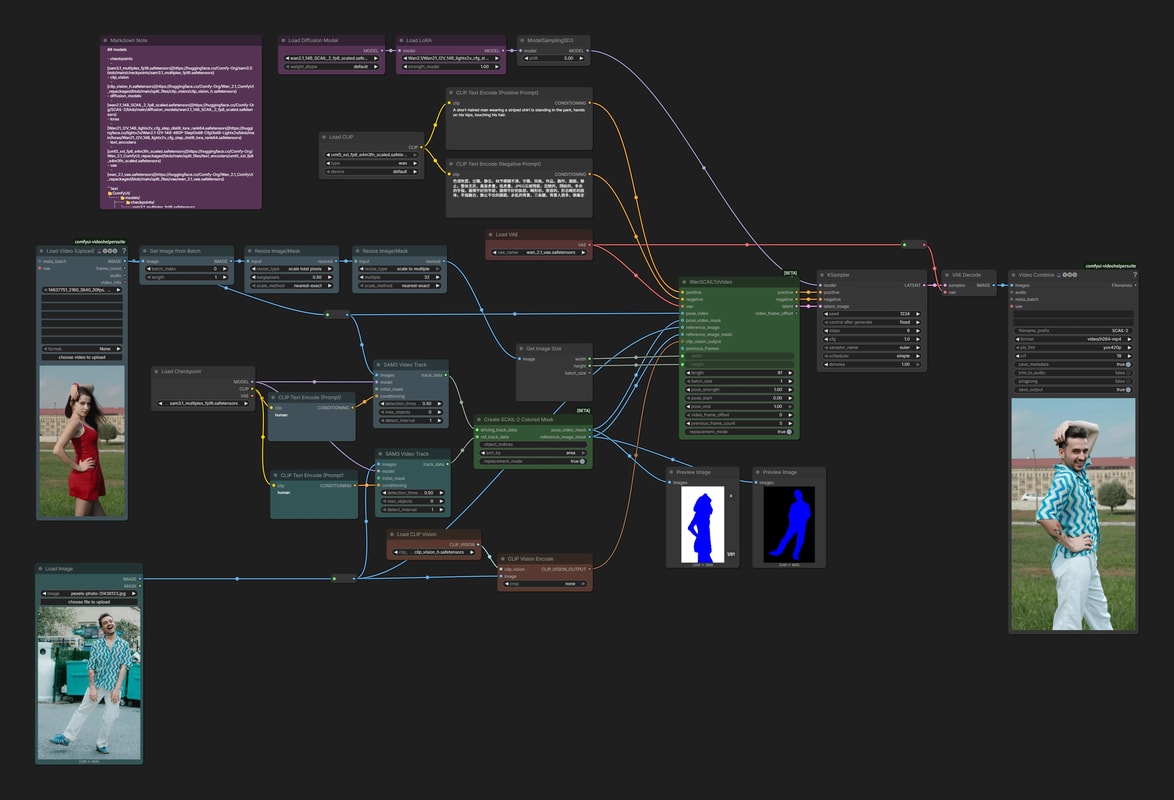
基本上只要把 Create SCAIL-2 Colored Mask 和 WanSCAILToVideo 的 replacement_mode 设为 true 就行。
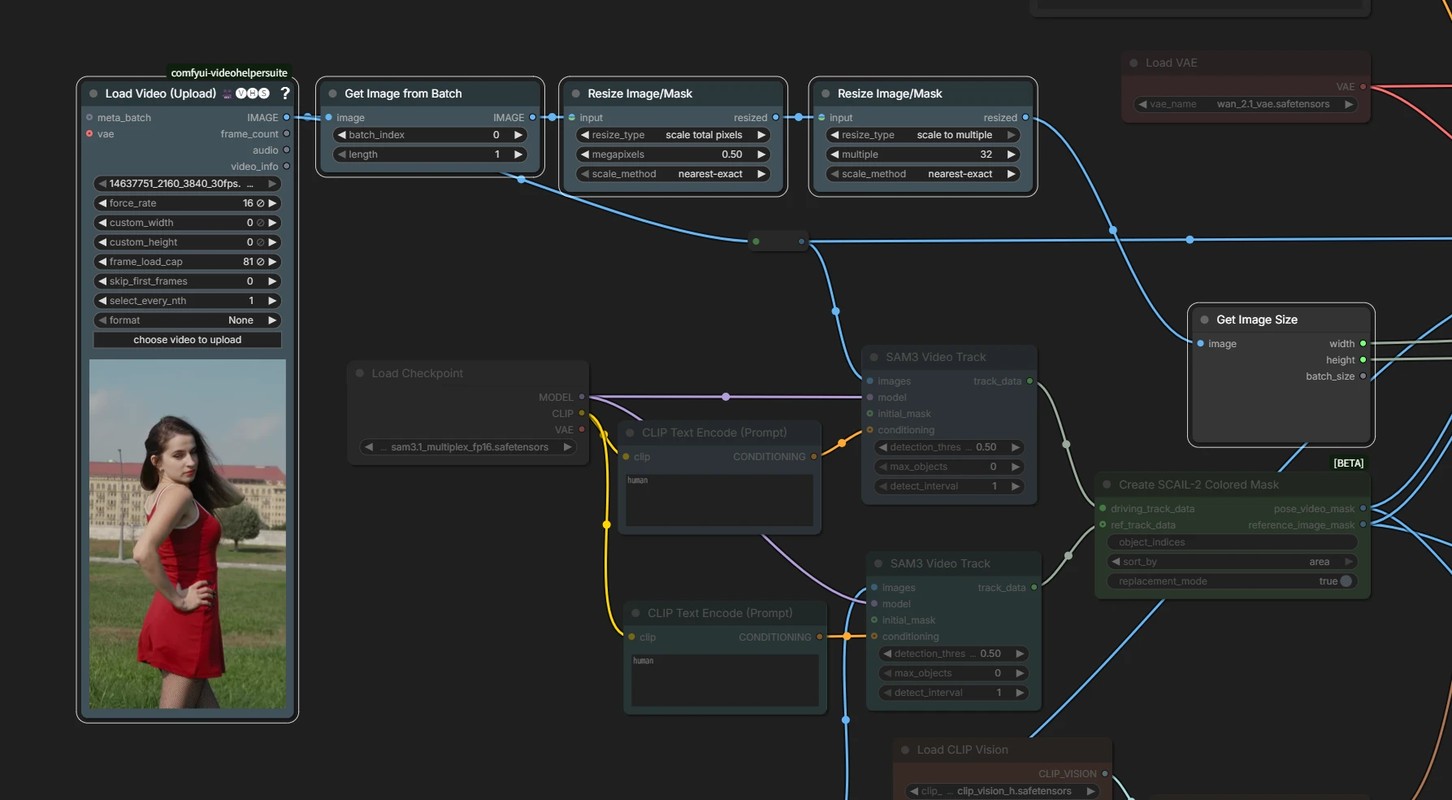
分辨率
Replacement 以视频的尺寸为基准。
- 这个工作流会取缩放后的视频第 1 帧的尺寸来设置。
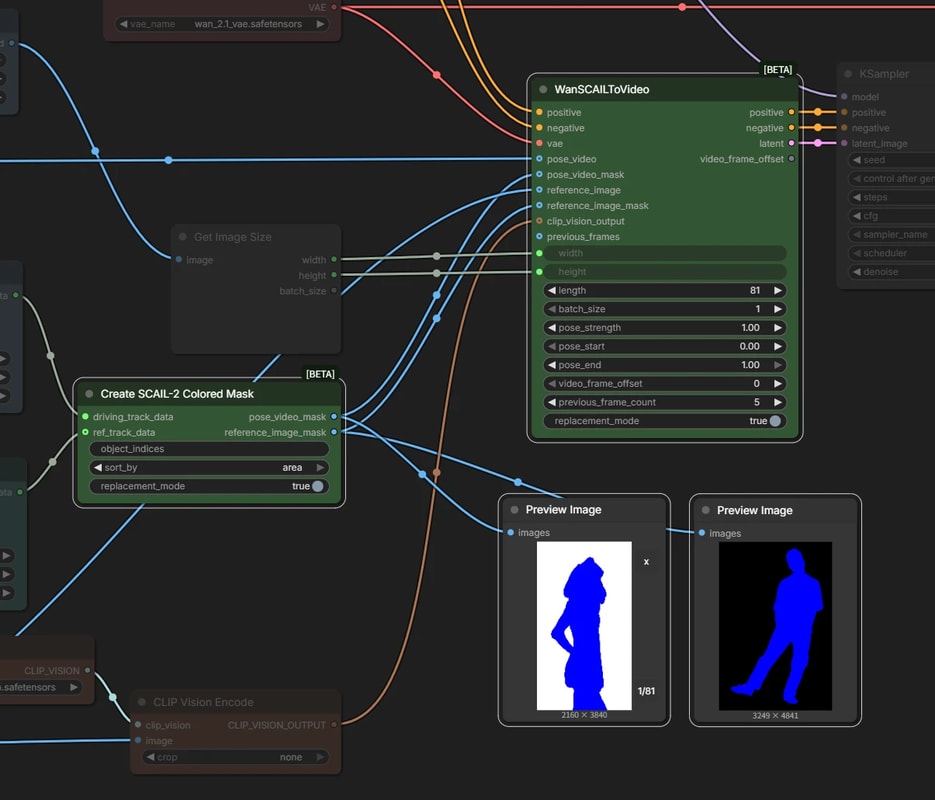
Create SCAIL-2 Colored Mask 与 WanSCAILToVideo
将 replacement_mode 设为 true。
- 顺便一提,
Create SCAIL-2 Colored Mask的输出只是把 pose_video 那边的背景变成白色而已。
从这里开始的示例使用 Animation 模式,但这些内容也都可以用于 Replacement 模式。
Animation 模式(多人)
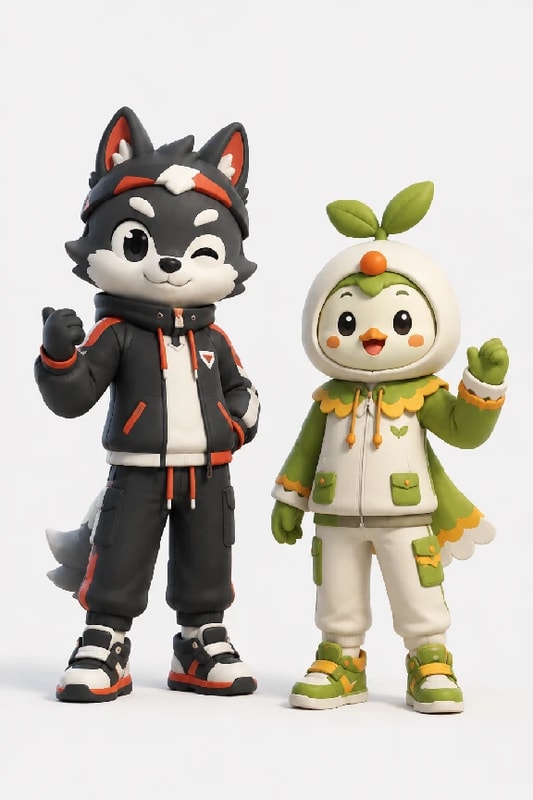
SCAIL-2 也支持多人视频和图像。
不需要什么特别的操作,和前面一样输入视频和参考图像就行。
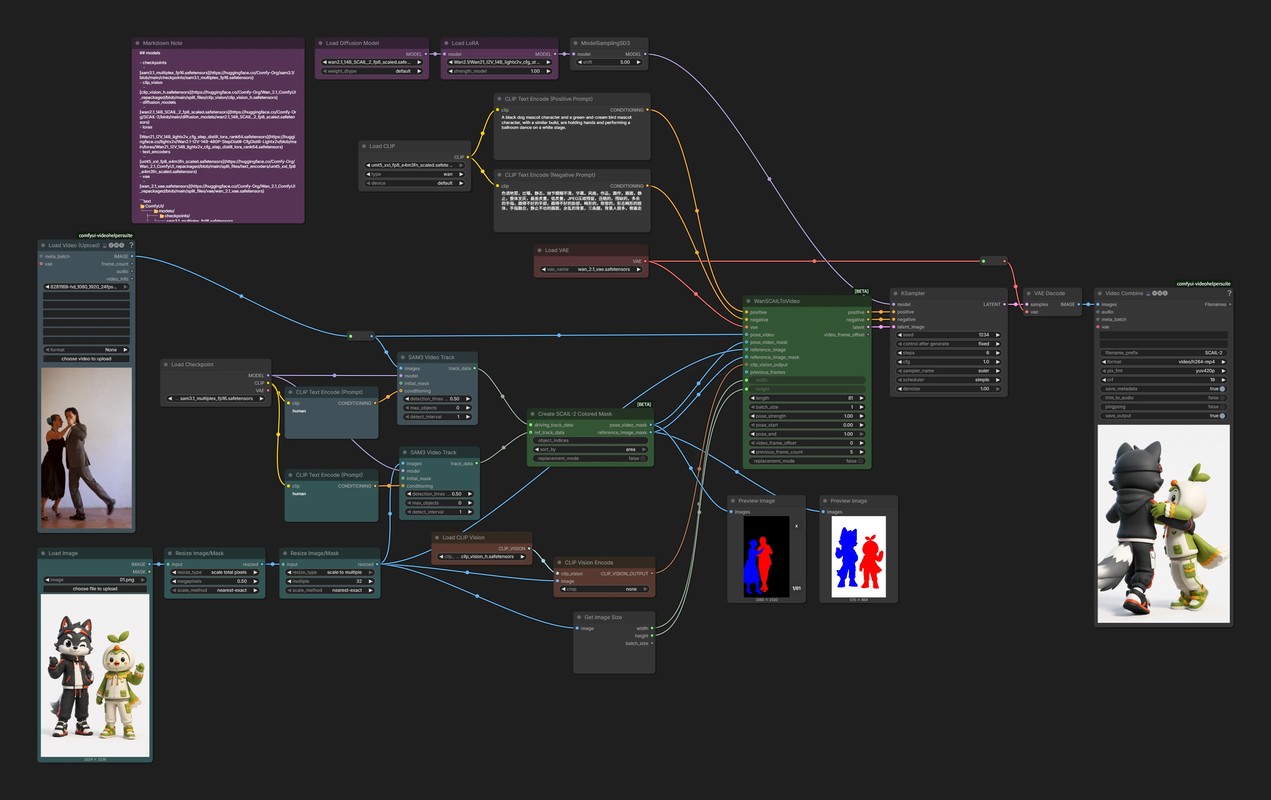
Create SCAIL-2 Colored Mask
多人时,哪个人物对应哪段动作就变得很重要,SCAIL-2 用彩色遮罩来控制这一点。
- 当 SAM3.1 分割出多个目标时,
Create SCAIL-2 Colored Mask会按顺序把它们涂成不同颜色。 - 基本上颜色相同的会被对应起来,所以请用
sort_by等参数把颜色对齐。
不过,就像下面的输出示例那样,颜色的对应和动作有时会对不上。这终究只是一个较弱的条件,模型有时也会单纯选择构图上更接近的一方。
Animation 模式(多参考图像)
也可以把参考人物其他角度的图像、背景用的图像一起作为参考。
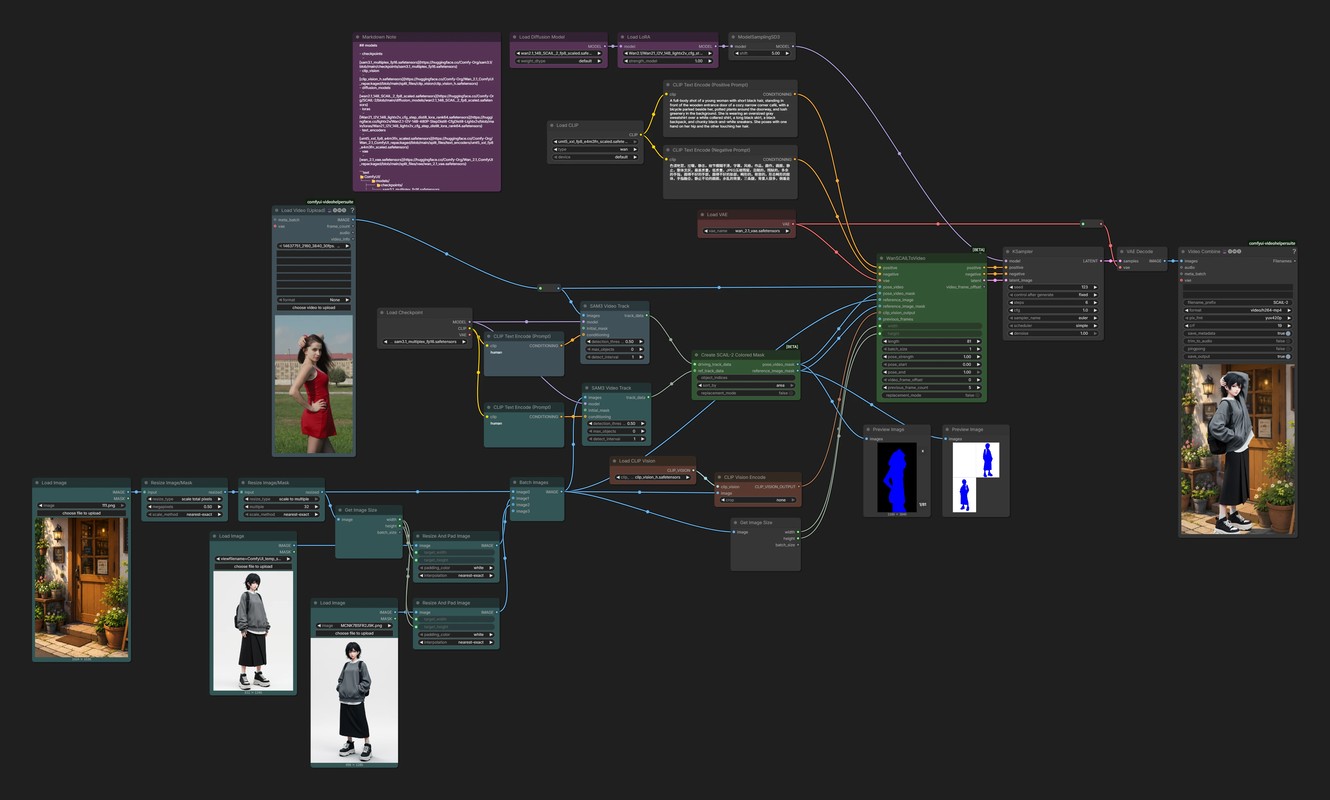
基本流程和普通的 Animation 模式相同,区别在于参考图像不是 1 张,而是以 batch 的形式输入。
Batch 输入
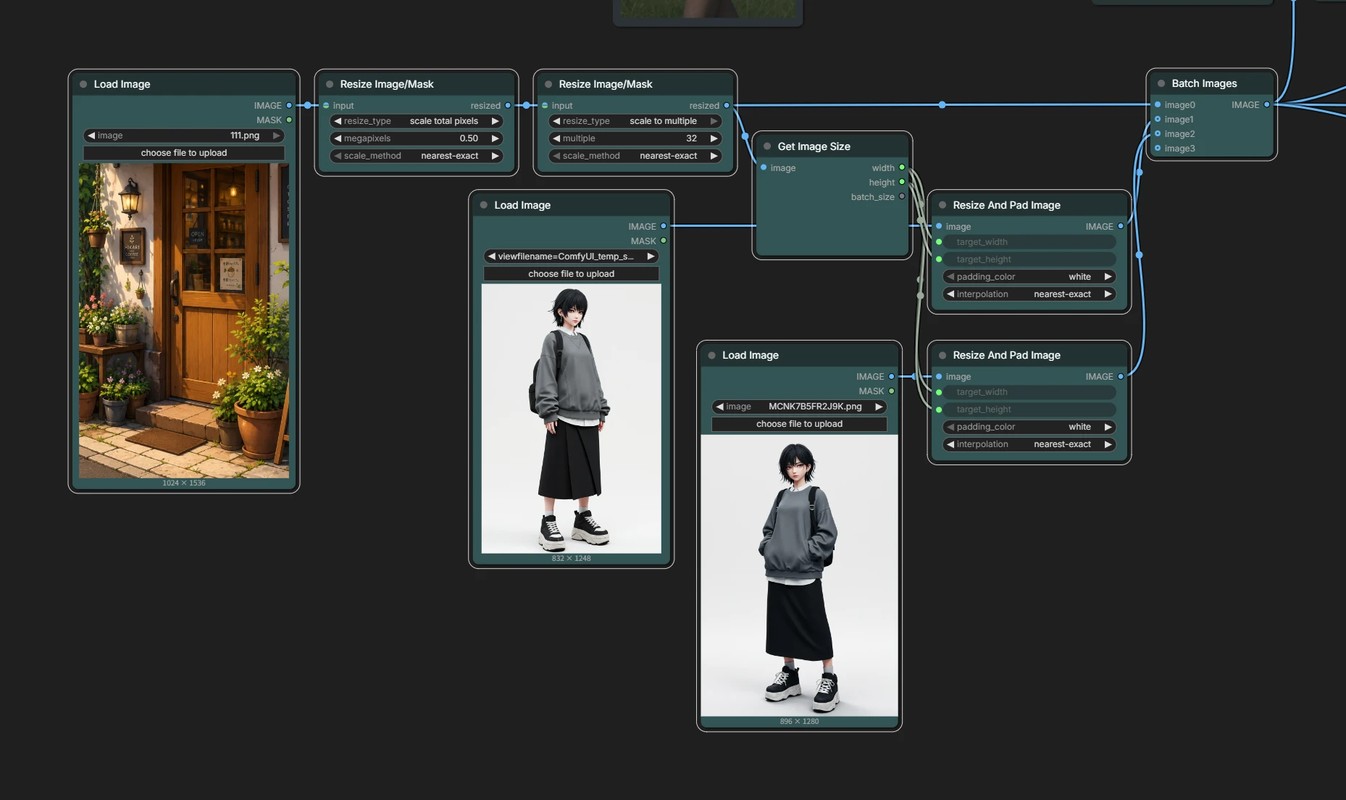
把想作为参考的图像输入到 Batch Images。
- 组成 batch 时,所有图像都会被裁剪成和第 1 张相同的尺寸。
- 第 2 张及之后的图像基本上不缩放也可以,但超出的部分不会被反映。
- 这个工作流用 padding 把它们补成和第 1 张相同的尺寸。
- 最后 输入的图像会被反映得最强。
- 相比背景,把想要驱动的人物放在后面似乎更好。
虽然可以使用多张参考图像,但它不会根据人物大小调整背景,也不会对整体做自然的重新打光(relight)。
它适合用来补充人物其他角度的信息,但如果想合成背景,与其用这个功能,不如先用图像编辑把 1 张图做好。
Animation 模式(81 帧以上)
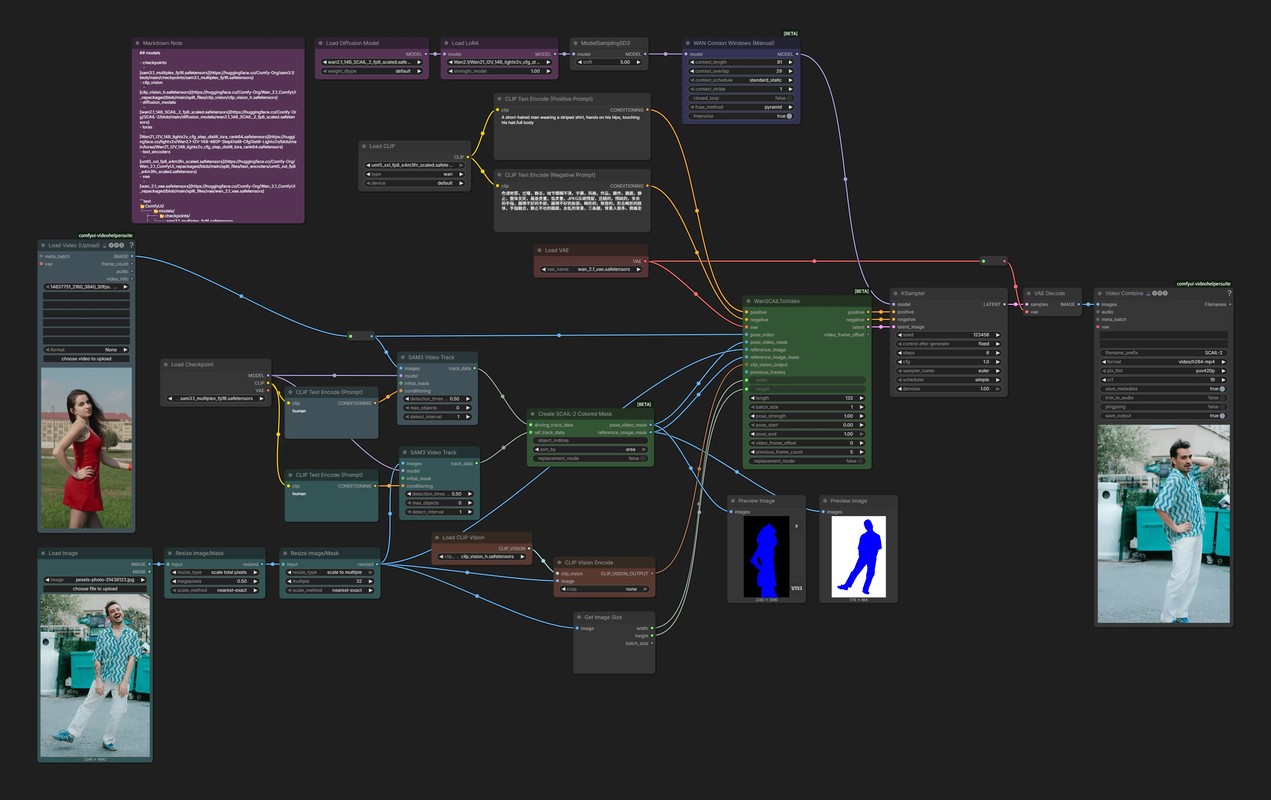
SCAIL-2 基本上最多生成 81 帧,但使用 WAN Context Windows (Manual),就能沿时间方向分段,生成更长的视频。
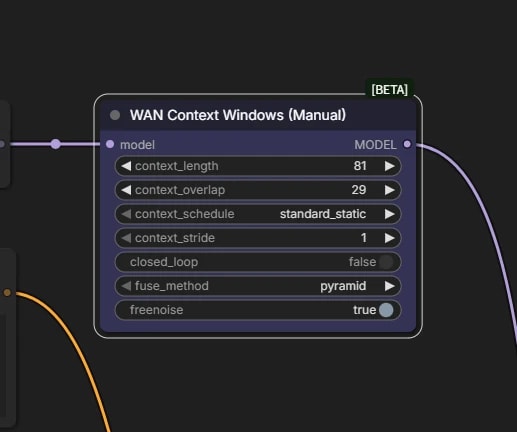
WAN Context Windows (Manual)
可以理解为时间轴方向的 tiling,或者 context sliding。
- 把
context_length设为 81,内部就会每 81 帧切成一段来生成。 - 直接这样的话接缝会很明显,所以要在
context_overlap里设置适当的帧数作为重叠部分。