PixelDiT
PixelDiT 是 NVIDIA 公开的 像素扩散模型。
Stable Diffusion 之后的很多图像生成模型,都使用 Latent Diffusion Model 这种机制。
逐像素计算图像的成本很高,所以模型会先把图像压缩成较小的 latent。这样可以减少计算量,同时也更容易处理形状、颜色、构图等特征。
不过,从 latent 还原回像素时,细小文字、纹样这类细节还是容易劣化。
像素扩散模型 不经过 latent,而是直接在像素空间里处理图像。因此,VAE 还原带来的劣化在机制上不会以同样的方式发生。
那不是正因为计算量大,才要用 latent 吗?PixelDiT 的做法是把图像切成 patch,一边粗略地看整体,一边在像素侧补细节。
模型的下载
- diffusion_models
- text_encoders
- gemma_2_2b_it_elm_bf16.safetensors (5.23 GB)
📂ComfyUI/
└── 📂models/
    ├── 📂diffusion_models/
    │   └── pixeldit_1300m_1024px_bf16.safetensors
    └── 📂text_encoders/
        └── gemma_2_2b_it_elm_bf16.safetensors
text2image
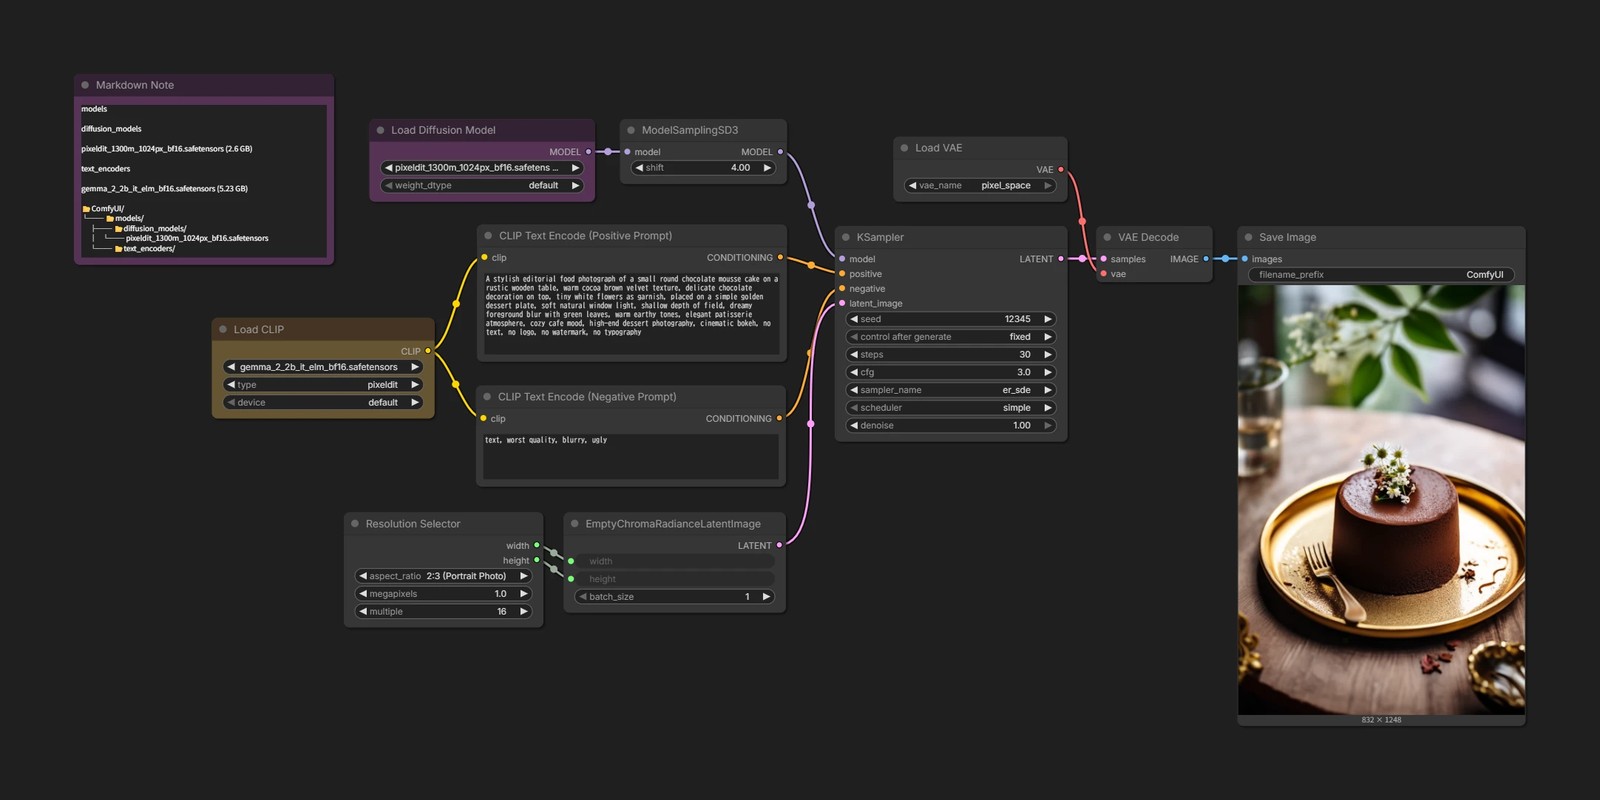
因为是像素扩散模型,本来并不需要 Load VAE 或 VAE Decode。
不过在 ComfyUI 里,为了配合既有的 workflow 形式,需要在 Load VAE 里选择 pixel_space,再连接到 VAE Decode。
看起来像是用名为 pixel_space 的 VAE 在解码,但这里可以理解为从 KSampler 取得 IMAGE 输出的操作。
PiD
PiD 是用来替代 VAE Decode 的 PixelDiT。
通常情况下,生成出的 latent 会经过 VAE Decode 还原成图像。 PiD 则是把这个 latent 交给 PixelDiT,让图像还原和放大一起完成。
例如,先用 Z-Image-Turbo 生成 1024×1024 的 latent,再在 VAE Decode 之前交给 PiD。
如果使用 1024_to_4096 的 PiD,就会输出 4096×4096 的图像。
也就是说,可以利用现有模型的生成能力,同时避开 VAE Decode 对细节造成的劣化。
模型的下载
-
SDXL 用
-
Qwen-Image 用
-
Flux.1 / Z-Image 用
-
Flux.2 用
📂ComfyUI/
└── 📂models/
    └── 📂diffusion_models/
        ├── pid_sdxl_1024_to_4096_4step_bf16.safetensors
        ├── pid_1.5_qwenimage_1024_to_4096_4step_bf16.safetensors
        ├── pid_flux1_512_to_2048_4step_bf16.safetensors
        ├── pid_1.5_flux1_1024_to_4096_4step_bf16.safetensors
        ├── pid_flux2_512_to_2048_4step_bf16.safetensors
        └── pid_1.5_flux2_1024_to_4096_4step_bf16.safetensors
不需要全部放进去。只放和使用的基础模型对应的 PiD 就可以。
模型的选择
选择 PiD 模型时,需要注意两点。
-
基础模型的种类
- 需要和原模型使用的 latent 类型一致。
- SDXL 就用 SDXL 用,Z-Image 就用 Flux.1 用。
-
放大倍率
- 模型名里会看到
1024_to_4096这样的字样,这表示放大倍率。 - 并不是选了这个模型就会自动放大。比如
1024_to_4096,需要把 1024px 左右的 latent / 输出交给 PiD,并设置参数,让 PiD 输出 4096px 的图像。 - 大致分辨率对上即可,宽高比可以自由调整。
- 模型名里会看到
Z-Image-Turbo → PiD
试着用 PiD 解码 Z-Image-Turbo 的 latent。
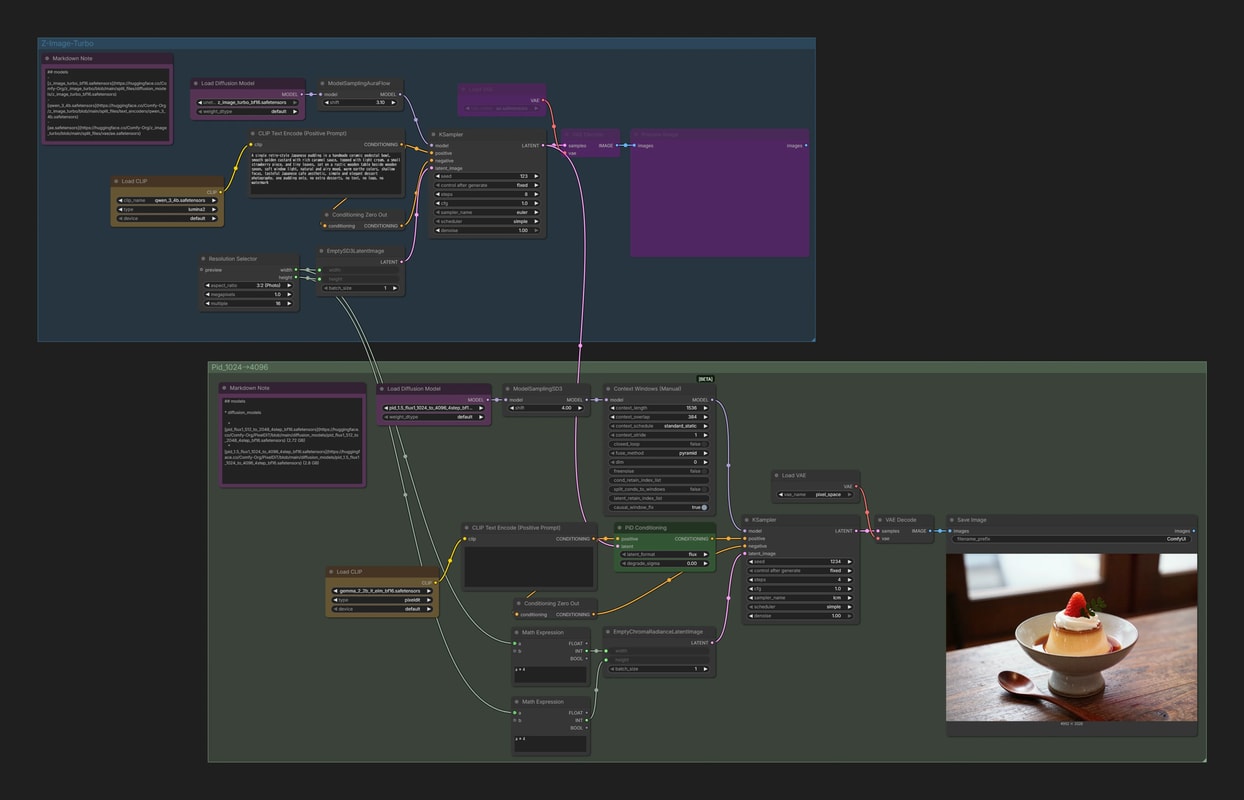
- 🟦 左上是普通的 Z-Image-Turbo workflow。
- 🟩 输出的 latent 不走 VAE Decode,而是连接到 PixelDiT 侧的
PiD Conditioning。
- 🟩 输出的 latent 不走 VAE Decode,而是连接到 PixelDiT 侧的
- 这里使用
1024_to_4096模型。- Z-Image-Turbo 侧以约 1M 像素生成,PiD 侧指定为 4 倍分辨率。
- PiD 是 4 step 蒸馏模型,所以这里把
steps设为 4,cfg设为 1.0。 Context Windows (Manual)节点用于 tiling。 OOM 时,或者纵长 / 横长图像输出变粗糙时使用。
放大任意图像
传给 PiD Conditioning 的,只是普通的 latent。
因此,前面不一定要专门做 text2image。把任意图像先 VAE Encode,再交给 PiD,就可以像 upscaler 一样使用。
这里使用面向 Flux.2 的 PiD 1.5 模型和 flux2-vae.safetensors。
- flux2-vae.safetensors (336 MB)
📂ComfyUI/
└── 📂models/
    └── 📂vae/
        └── flux2-vae.safetensors
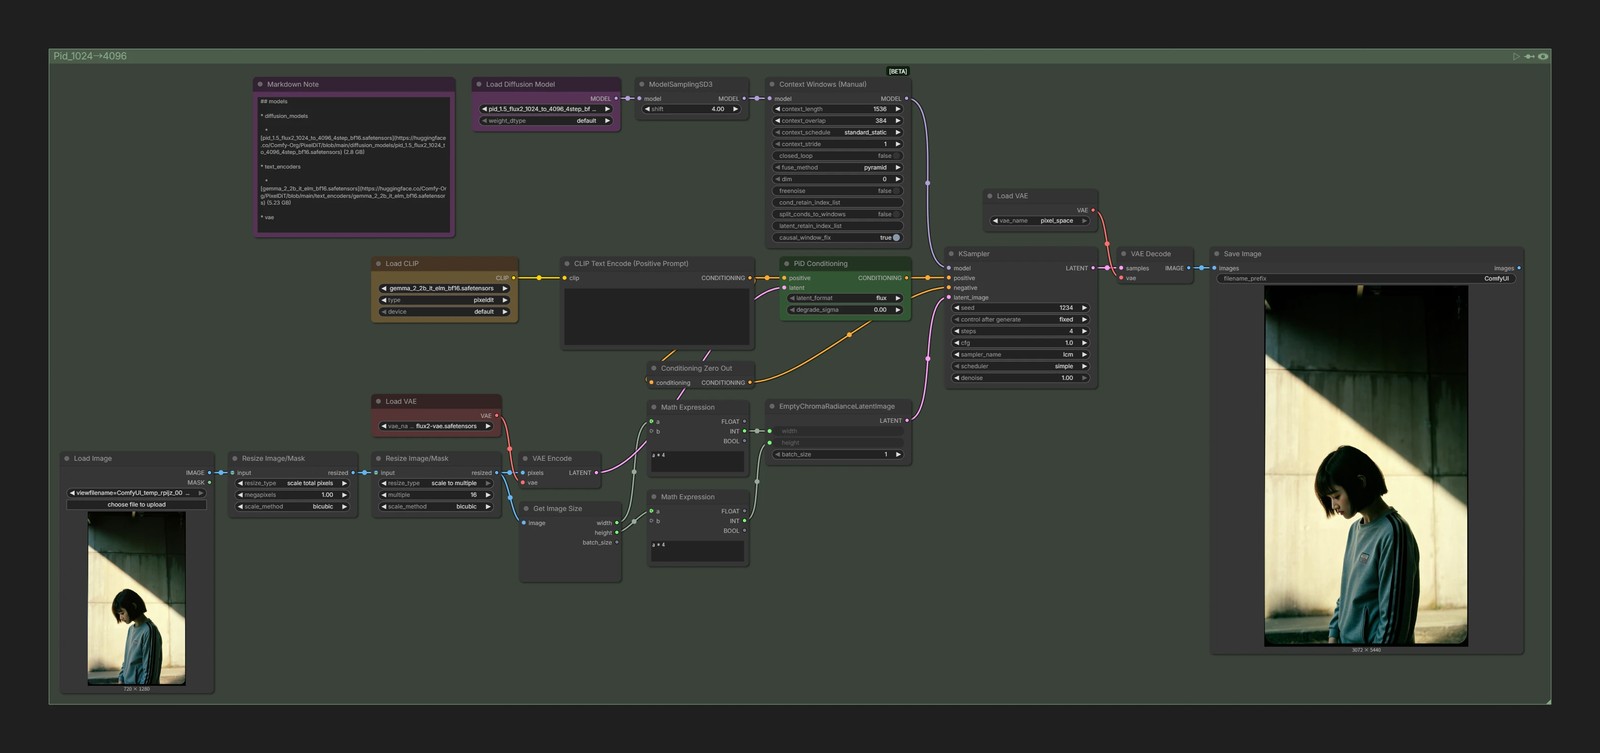
- 将输入图像 resize 到约 1M 像素,并让尺寸成为 16 的倍数
- 取得 resize 后的高和宽,把它们乘以 4,作为 PiD 侧的输出尺寸
本质上做的是重新描绘,所以与其说是 upscaler,不如说是 enhance。
不太适合需要忠实再现的用途。