什么是 IP-Adapter?
看着画或照片想“希望用和这个一样的氛围画”,但只用文本详细说明细节几乎是不可能的。
于是,“不介由文本,直接让 AI 看图像”的机制被提出了几个。
其中,被用于 风格和被摄体的“转印” 的古典手法之一就是 IP-Adapter。
请认为是“reference2image”、“Subject 转印”的元祖定位。
必要的自定义节点
SD1.5 × IP-Adapter
IP-Adapter 有几种种类,首先试一下最标准的东西吧。
模型的下载
- IP-Adapter 本体(SD1.5 用)
- CLIP Vision 模型
- model.safetensors
- 很难懂所以请重命名为
OpenCLIP-ViT-H-14。
- 很难懂所以请重命名为
- model.safetensors
📂ComfyUI/
  └── 📂models/
      ├── 📂clip_vision/
      │   └── OpenCLIP-ViT-H-14.safetensors
      └── 📂ip_adapter/
          └── ip-adapter_sd15.safetensors
工作流
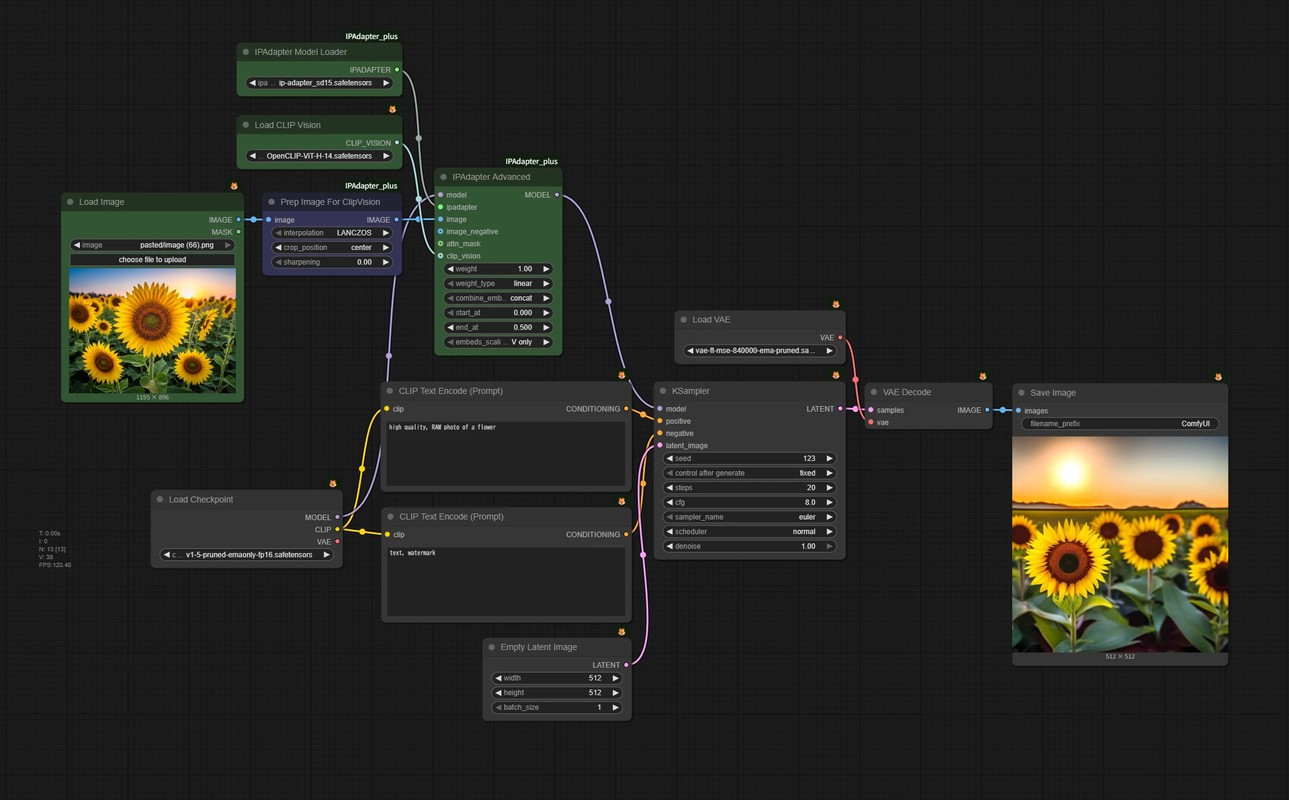
- 🟩 将各种模型和想参考的图像连接到
IPAdapter Advanced节点。 - 🟦 在
Prep Image For ClipVision节点裁剪参考图像。- 详情在下面
在“看”哪里
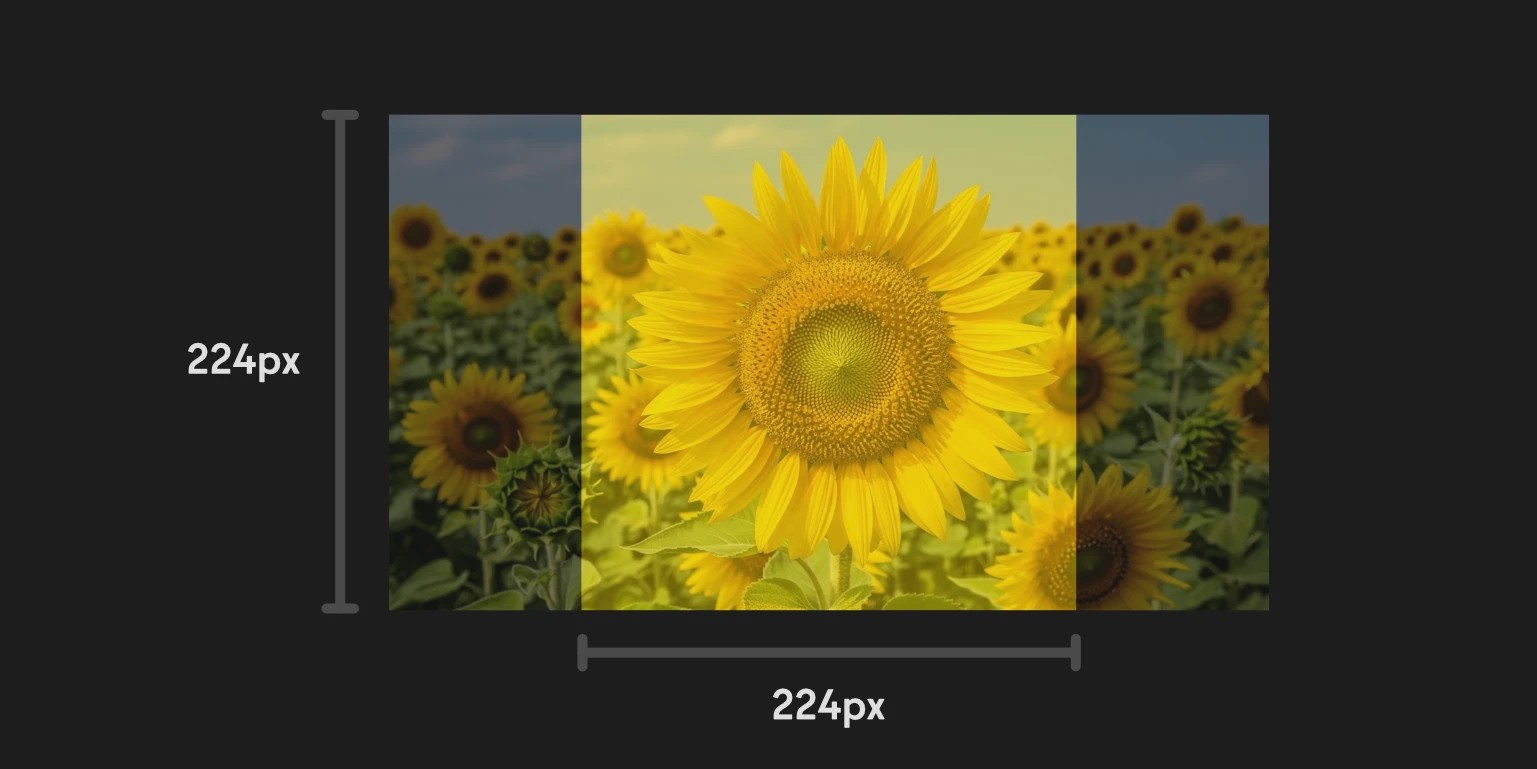
相当于 IP-Adapter “眼睛”的 CLIP ViT-H-14,基本只看 224 × 224 的范围。
因此,如果原样传递纵长的人物照片,脸和脚会被切掉,或者只以身体中间附近为线索获取特征。
如果想决定以哪个部分为基准,请像上面的工作流那样先进行缩放・裁剪。
IP-Adapter 的主要模型
虽然有几个派生模型,但从参照图像“借来什么到什么程度”,每个模型的性格相当不同。
ip-adapter-plus_sd15
强力转印构图和对象位置的模型。
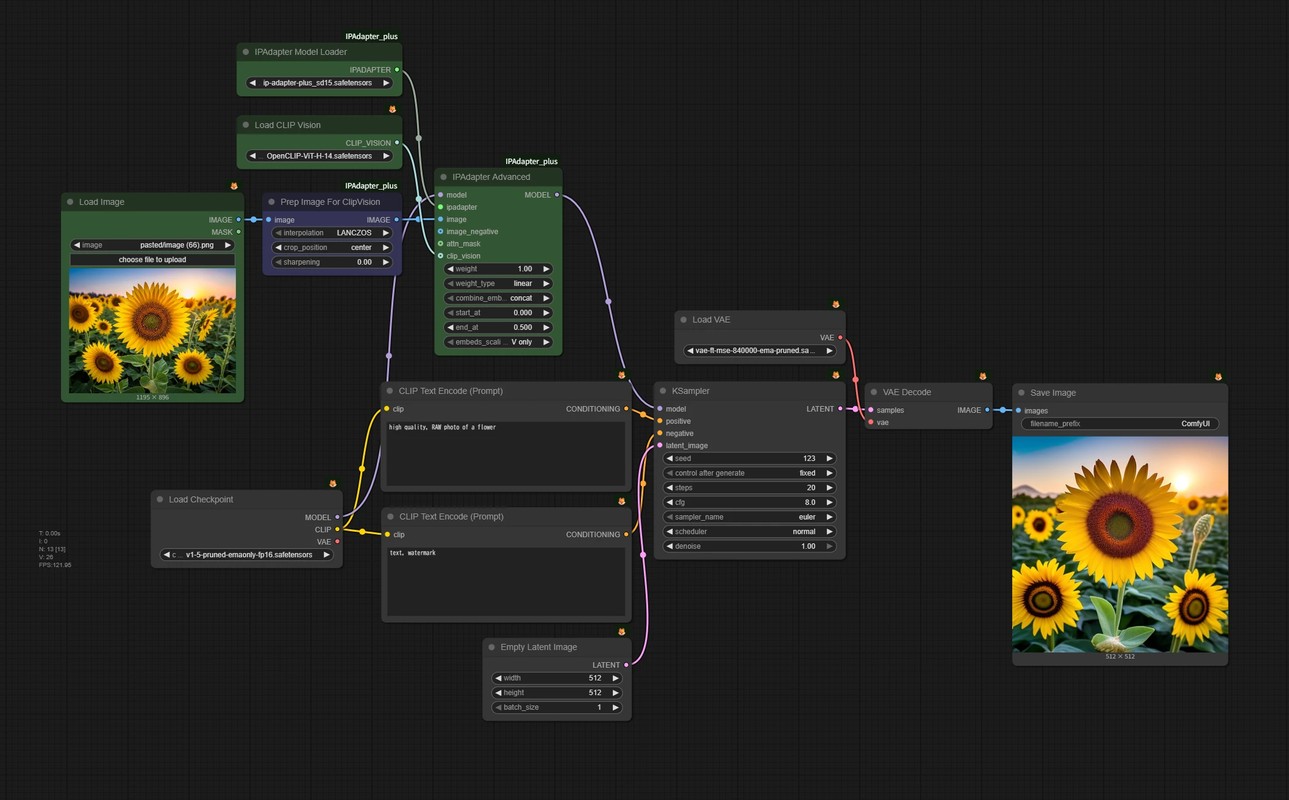
- ip-adapter-plus_sd15.safetensors
- 变成与参照图像相当接近的构图
ip-adapter_sd15_light
偏向文本提示词优先的模型。
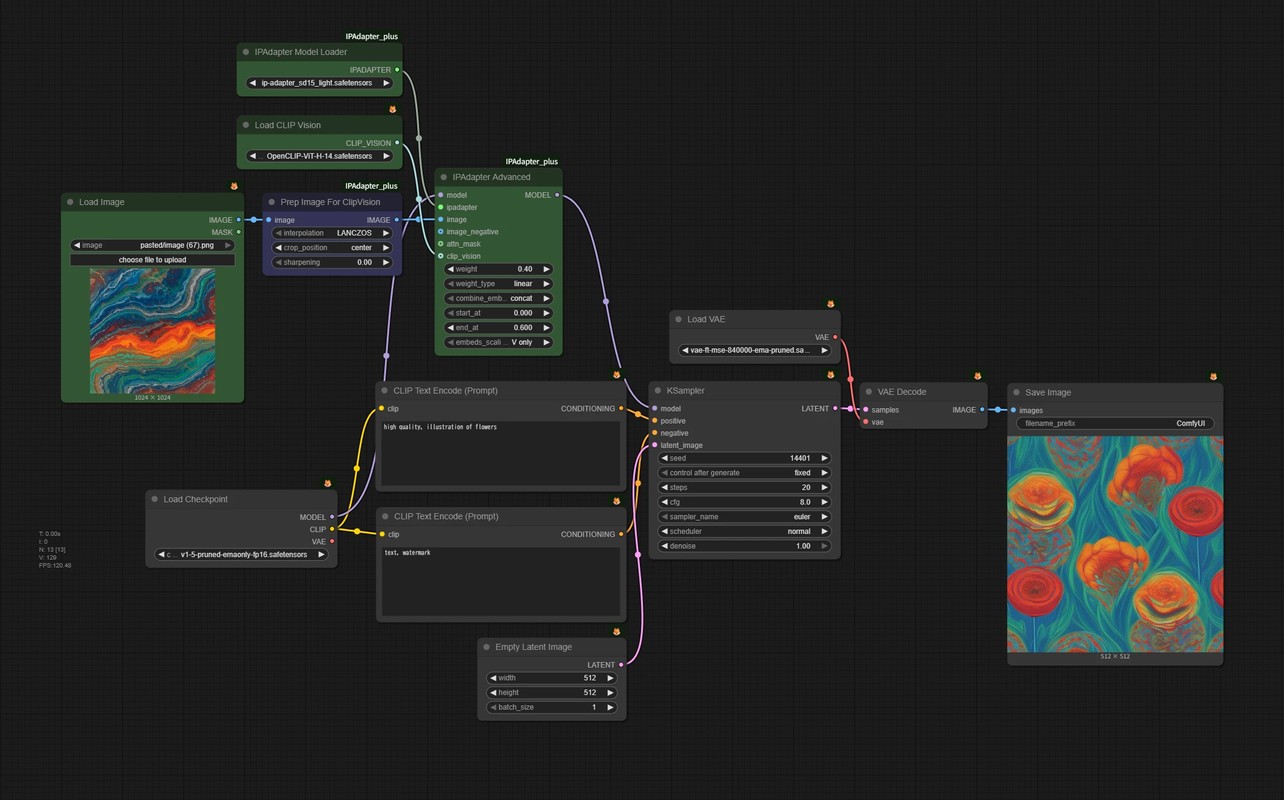
- ip-adapter_sd15_light.safetensors
- 强力保留文本的指示
- 参照图像主要只是“风格・氛围”的提示程度
ip-adapter-plus-face_sd15
专注于脸(头部)的 IP-Adapter。
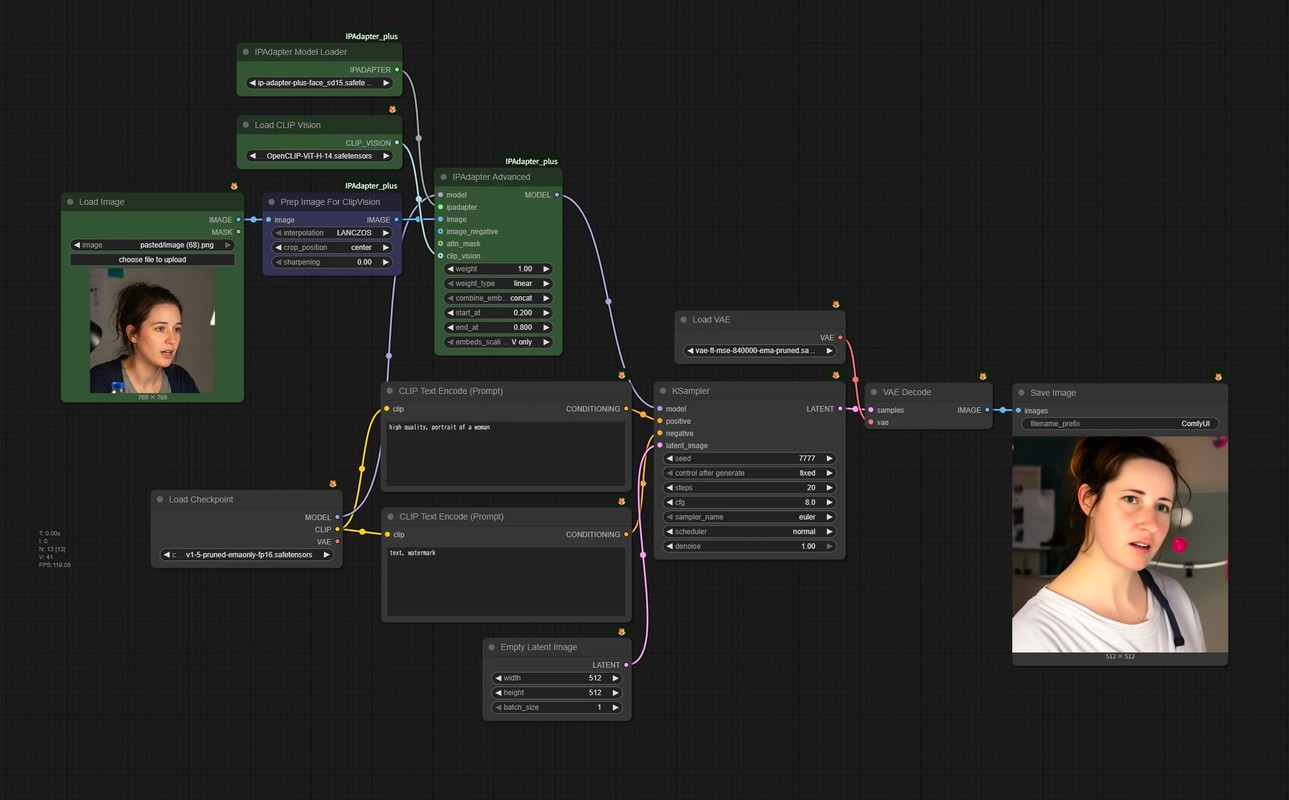
- ip-adapter-plus-face_sd15.safetensors
- 相当强地固定长相・轮廓・五官等
SDXL 用模型链接
面向也想试试 SDXL 的人,这里是 SDXL 用模型链接的一览。