MiniMax H3 Image 是什么?
MiniMax H3 Image 是 MiniMax 发布的图像生成模型。
它和视频生成模型 MiniMax H3 出自同一个祖先,一个模型就能同时完成图像生成和图像编辑。
最大的特点是能一次生成 16 MP 这样超大尺寸的图像。再加上 6 步蒸馏,在 4 MP 下生成速度非常快。
推荐设置
- 分辨率
- 4–16 MP
- 1:1 时为 2048 × 2048 到 4096 × 4096 px
- 宽和高都要是 32 的倍数
- 4–16 MP
与其说它能生成大尺寸,不如说必须用大尺寸才能生成好。低于 4 MP 时,画面会崩坏。
下载模型
- diffusion_models
- text_encoders
- vae
- minimax_h3_image_vae_fp16.safetensors (1.17 GB)
📂ComfyUI/
└── 📂models/
    ├── 📂diffusion_models/
    │   └── minimax_h3_image_pruned_int8_convrot.safetensors
    ├── 📂text_encoders/
    │   └── qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors
    └── 📂vae/
        └── minimax_h3_image_vae_fp16.safetensors
提示词
下面是 MiniMax 官方的提示词指南。不过和视频模型 MiniMax H3 相比,它对提示词的要求没那么严格。用自己的话把想要的内容详细写出来就可以了。
Ref2Image 与图像编辑
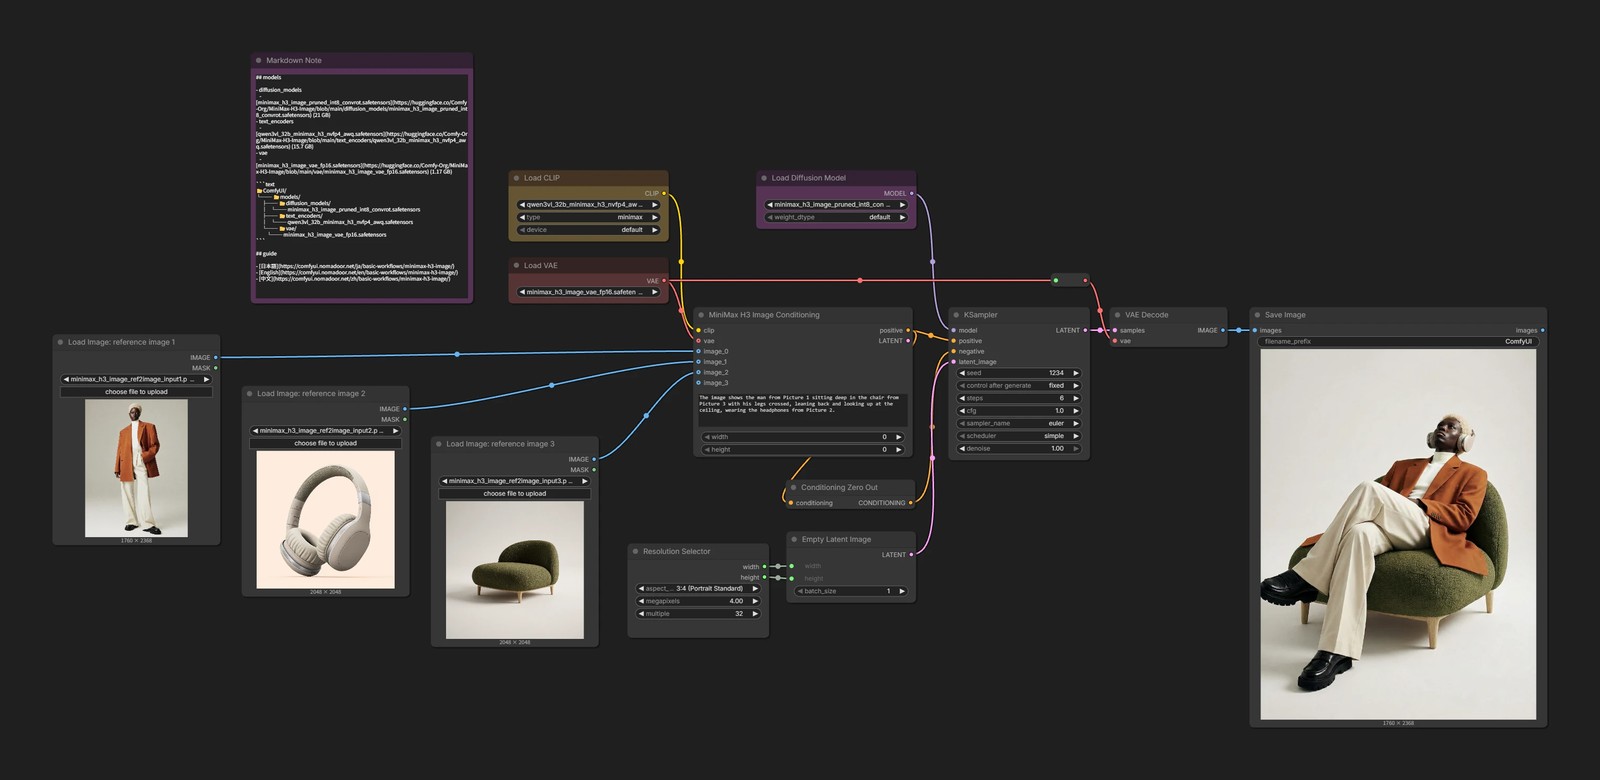
官方写法需要先用 <Subject 1> 之类的标签定义对象,但就我试下来,按参考图连接的顺序直接写 Picture 1、Picture 2 就行。
另外,即使是图像编辑,与其用“改成……”这种指令的写法,不如直接描述完成后的画面,感觉会更稳定一些。
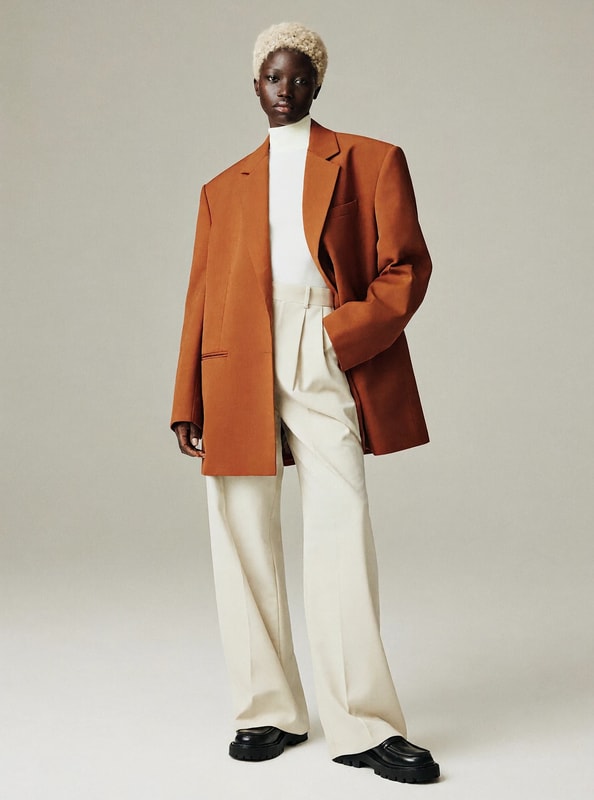
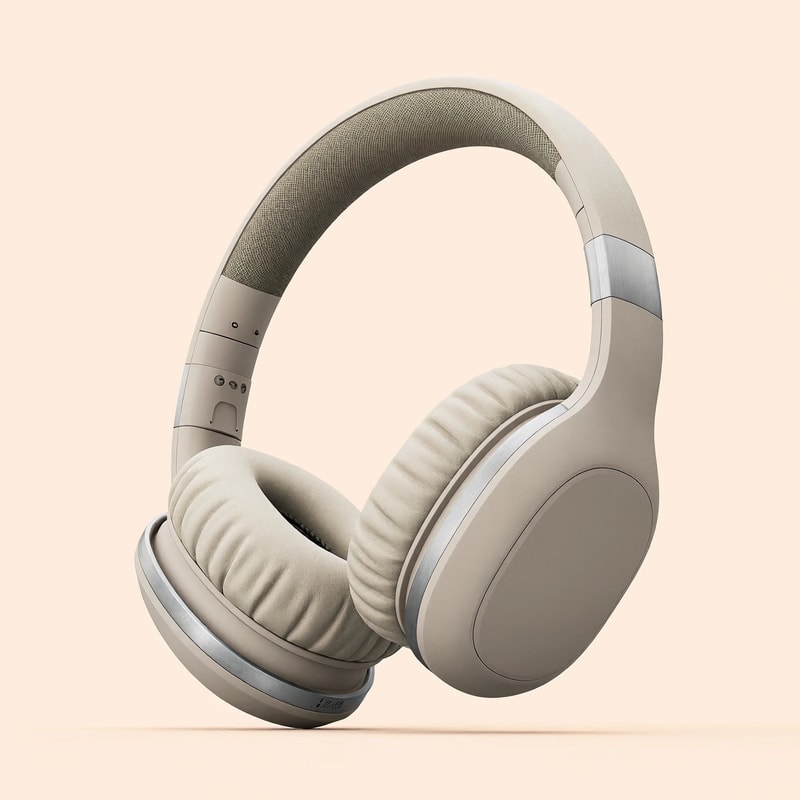
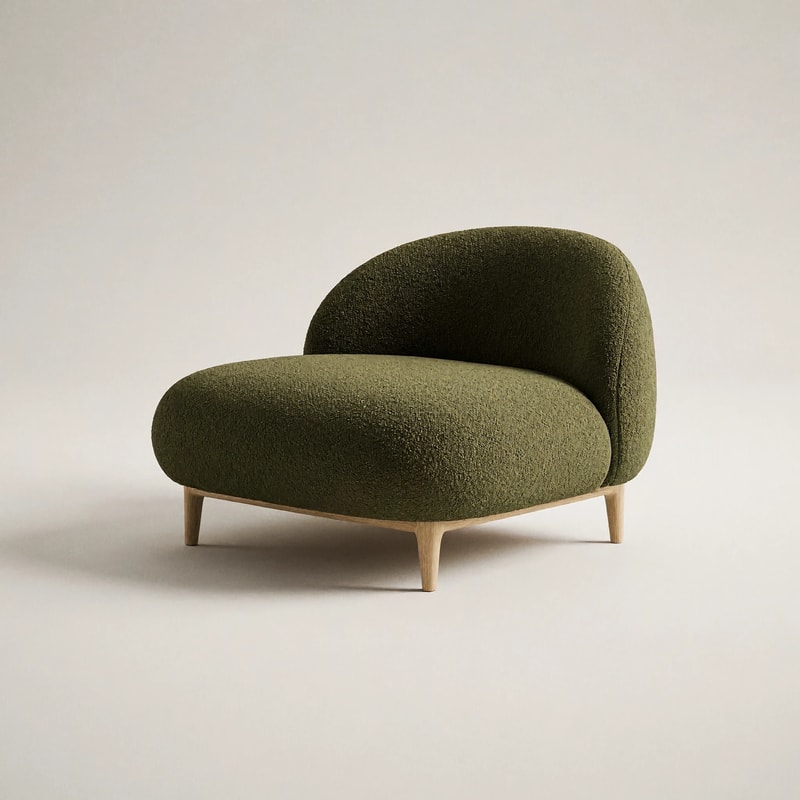
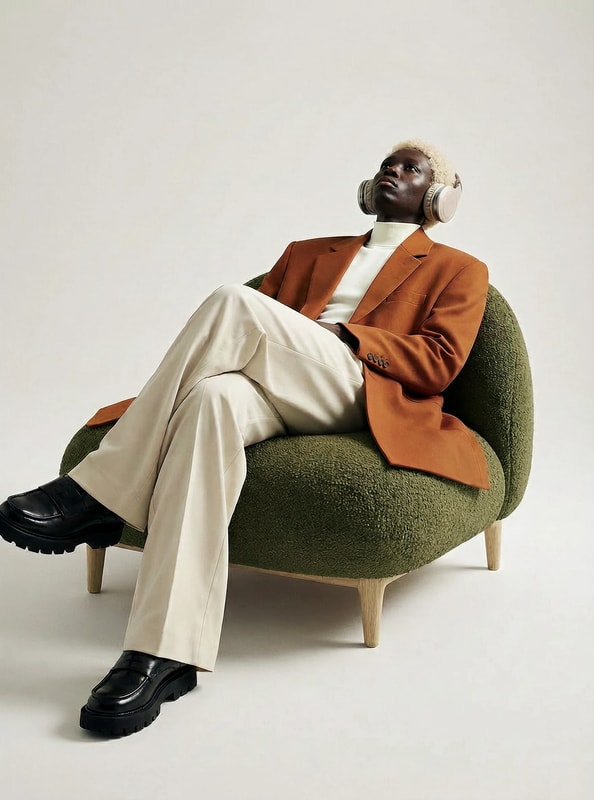
The image shows the man from Picture 1 sitting deep in the chair from Picture 3, wearing the headphones from Picture 2.
这里没有使用提示词增强(prompt enhance)。用 Qwen3.5 9B 时处理时间变长,出错也不少,而且用短句也已经能生成得足够好。
text2image
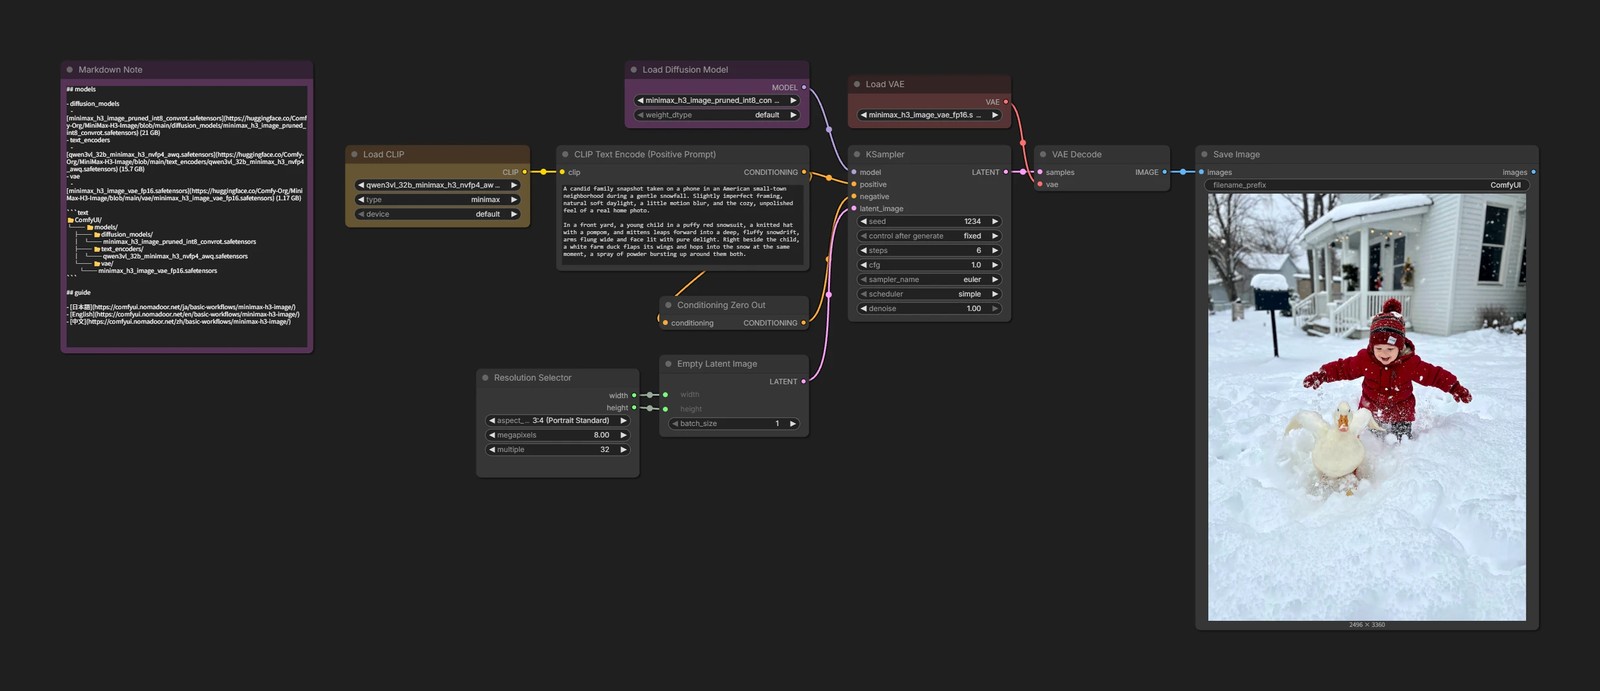
Outputs
Ref2Image
把多张参考图组合起来,生成新的图像。
参考图最多可以用 16 张。
Outputs
图像编辑
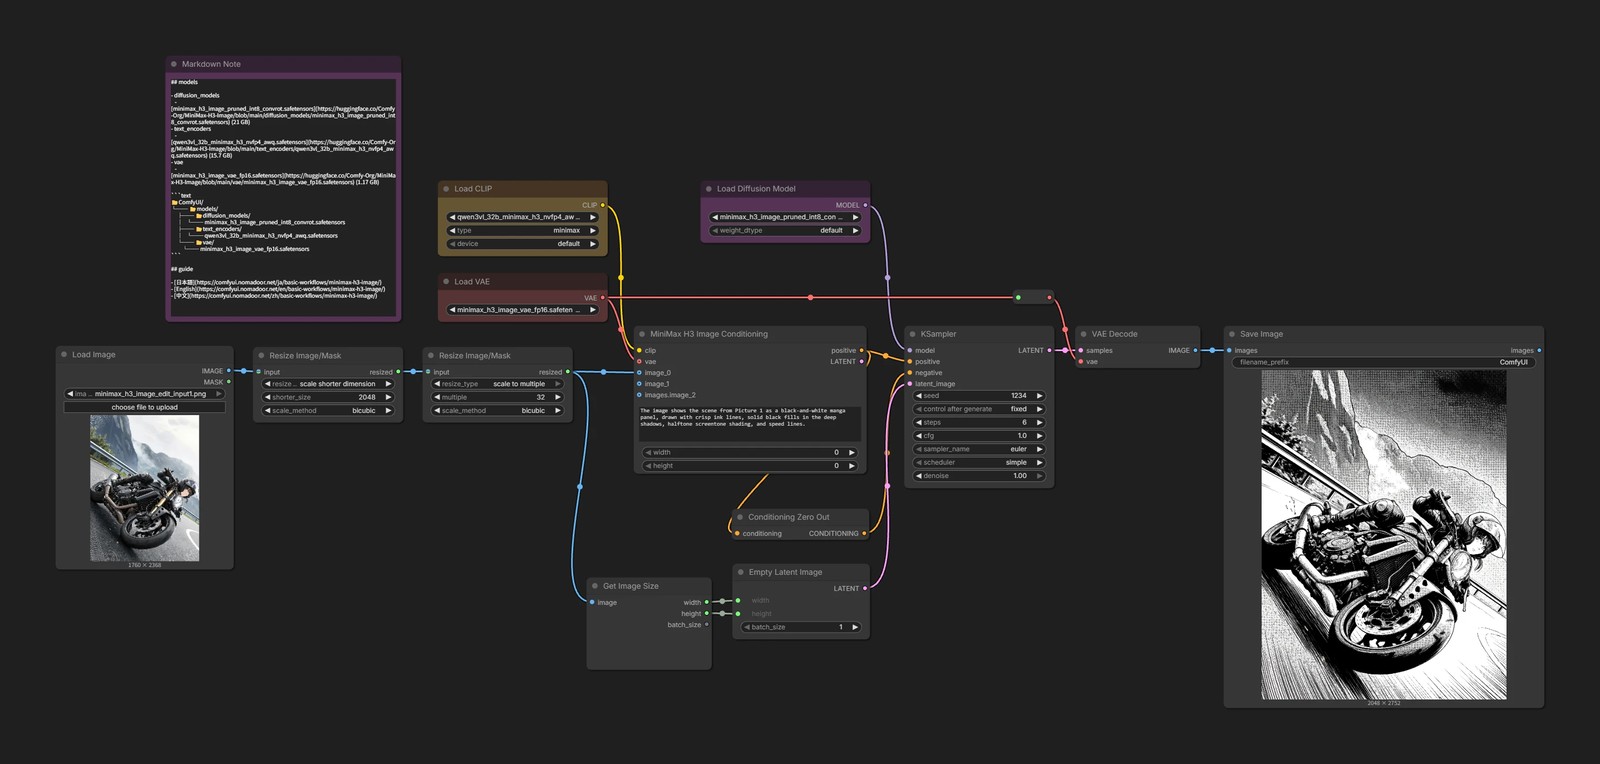
Resize Image/MaskMiniMax H3 Image Conditioning会在内部自行缩放输入图像,让短边落在 1024–2048 px 之间。- 为了让输入和输出的尺寸完全一致,这里先把短边缩放到 2048 px。
有时构图会自己变掉,比如全身照变成了特写。这时可以把不想改变的部分也写进提示词。
The framing, pose, and background are the same as Picture 1.
Outputs