什么是 Textual Inversion?
即使想让它生成某个图像,很多时候也很难用文本很好地进行说明。
Textual Inversion 是将这种“难以用文本表现的外观和概念”,作为新单词让其记住的技术。
- 首先,准备 1 个像
<my_keyword>这样的虚拟单词。 - 将那个单词和几张〜几十张氛围相似的图像作为一套展示给模型。
- 模型学习“这些图像共通的特征”,并将那个信息埋入
<my_keyword>这 1 个词中。
著名的例子有 easynegative 和 badhandv4 等。
通过收集大量的“失败图像”让其学习,将“图像生成中常发生的失败”的概念总结为一句话。
但是,这无法让原本的模型从零画出完全不会画的东西。
终究只是 模型原本知道,但不知道该用什么指令表达的东西。
那种情况下,需要 LoRA 或全量微调等,重新学习模型本体的手法。
由 Textual Inversion 制作的这 1 个词份的数据,习惯上被称为 embedding。
几乎不再被使用
Textual Inversion 虽然有学习轻便的优点,但现在几乎被 LoRA 取代了。
easynegative 和 badhandv4 等,也因为模型本身的性能提高了,基本不需要了。
例外的是,Checkpoint 或 LoRA 的作者,为了接近预想的输出,有时会一起分发专用的 embeddings。
为了引出模型的性能,使用者需要正确输入“作者预想的提示词”。但是,不限于所有使用者都会遵从那个,每次写细致的提示词也很麻烦。
于是,作者会预先准备 embeddings,让使用者加入这个单词,使输出更容易接近作者预想的效果。
应用了 embedding 的 text2image
embedding 的下载
试着使用名为 Porsche 911 Turbo 的 embedding 吧。
- Porsche 911 Turbo
-
 📂ComfyUI/
   └── 📂models/
       └── 📂embeddings/
           └── porsche911_ti.pt
工作流
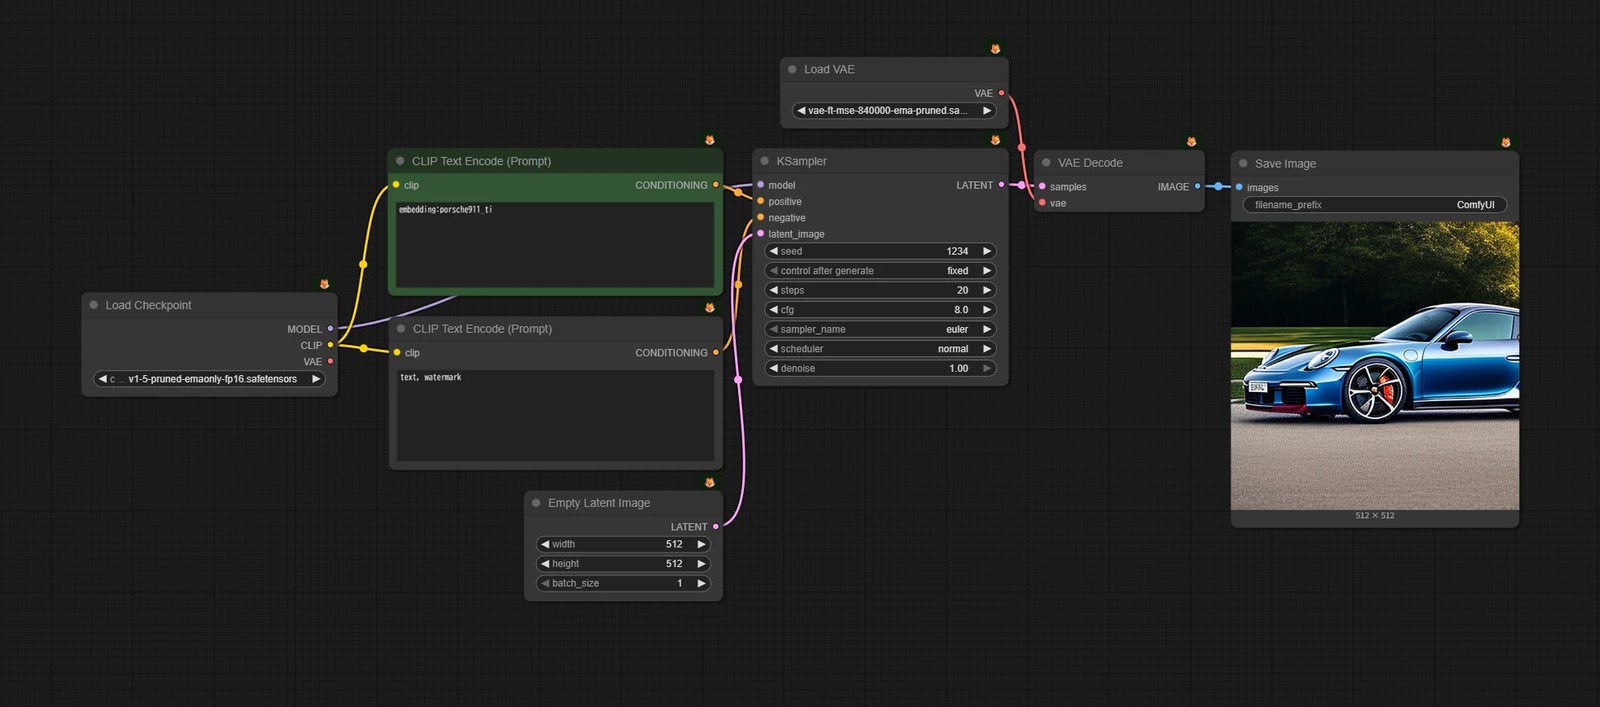
- 在 CLIP Text Encode 中写入
embedding:文件名这样来调用 embedding。- e.g.
embedding:porsche911_ti
- e.g.