Textual Inversionとは?
何か画像を生成させたくても、それをテキストでうまく説明できないことはよくあります。
Textual Inversion は、そのような「テキストで表現しづらい見た目や概念」を、新しい単語として覚えさせる技術です。
- まず、
<my_keyword>のようなダミーの単語を 1 つ用意。 - その単語とセットで、似た雰囲気の画像を数枚〜数十枚モデルに見せます。
- モデルは「これらの画像に共通する特徴」を学習し、その情報を
<my_keyword>という 1 語に埋め込みます。
有名な例としては、easynegative や badhandv4 などがありますね。
大量の「失敗した画像」を集めて学習させることで、「画像生成でよく起きる失敗」の概念を一言にまとめたものです。
ただし、もともとのモデルがまったく描けないものを、ゼロから描けるようにすることはできません。
あくまで モデルが元々知っていたけど、なんて指示すればいいかわからなかったもの だけです。
そのような場合は、LoRA やフルファインチューニングなど、モデル本体を学習し直す手法が必要になります。
Textual Inversion で作られたこの 1語ぶんのデータは、慣例的に embedding と呼ばれます。
もうほぼ使われない
Textual Inversion は、学習が軽いという利点こそあれど、現在はほとんど LoRA に置き換えられています。
easynegative や badhandv4 なども、モデル自体の性能が向上したこともあり、基本的には不要です。
例外的に、チェックポイントや LoRA の作者が、想定する出力に近づけるために専用の embeddings を一緒に配布していることがあります。
モデルの性能を引き出すには、「作者が想定したプロンプト」を利用者が正しく入力する必要があります。しかし、すべての利用者がそれに従ってくれるとは限りませんし、毎回細かいプロンプトを書くのも面倒です。
そこで、あらかじめ embeddings を用意し、その単語を入れてもらうことで、作者が想定した出力に近づけやすくしているということですね。
embeddingを適用したtext2image
embeddingのダウンロード
Porsche 911 Turboというembeddingを使ってみましょう。
- Porsche 911 Turbo
-
 📂ComfyUI/
   └── 📂models/
       └── 📂embeddings/
           └── porsche911_ti.pt
workflow
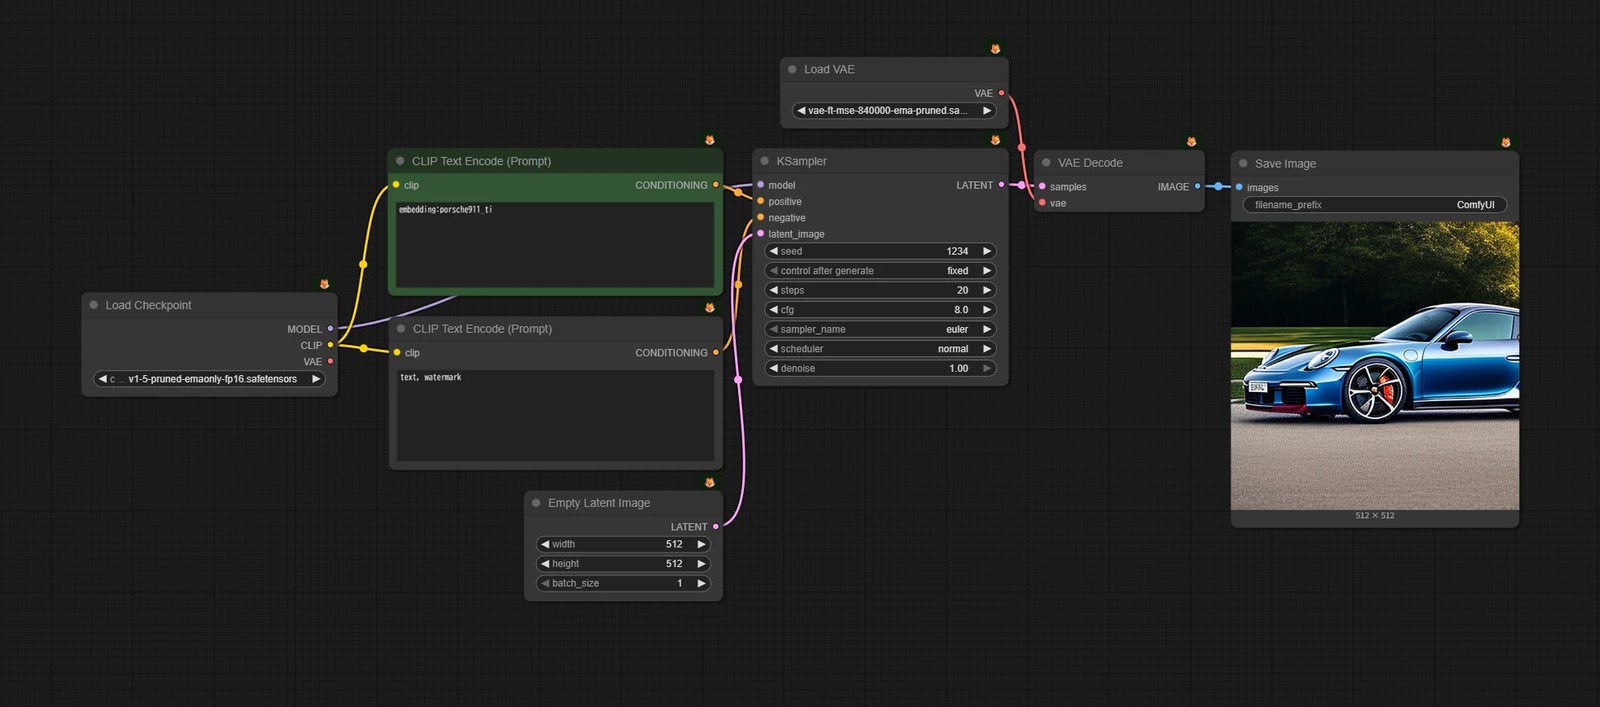
- CLIP Text Encodeに
embedding:ファイル名のように書くことでembeddingを呼び出します。- e.g.
embedding:porsche911_ti
- e.g.