Subject転送とは?
正式には「Subject-Driven Image Generation」と呼ばれるタスクです。
Subjectは、人に限らず、キャラクター・ぬいぐるみ・特定の犬・マスコット・フィギュアなど、「この画像に写っている"それ"」全般を指します。
Subject転送は、参照画像に写っている同じSubjectが含まれる画像を生成するための技術です。
ID(人物の顔・本人性)を転送する技術は、Subject転送に含まれますが、特別視されており、ID転送に特化した技術も多いため別で扱います。
LoRA
言わずもがな、モデルが描けないものを学習して描けるようにする方法です。
登場時から現在に至るまで、柔軟性・安定性においてこれに勝るものはありません。
大きな問題は学習が必要ということ。気軽さはありません。
image2prompt
もっとも素朴なやり方として、「画像からキャプションを生成し、そのキャプションでtext2imageを回す」という手法があります。
そんな原始的な方法で?と思うかもしれませんが、参照画像を完璧に説明できるMLLMと、その説明を完璧に再現する画像生成モデルがあれば原理的には可能です。
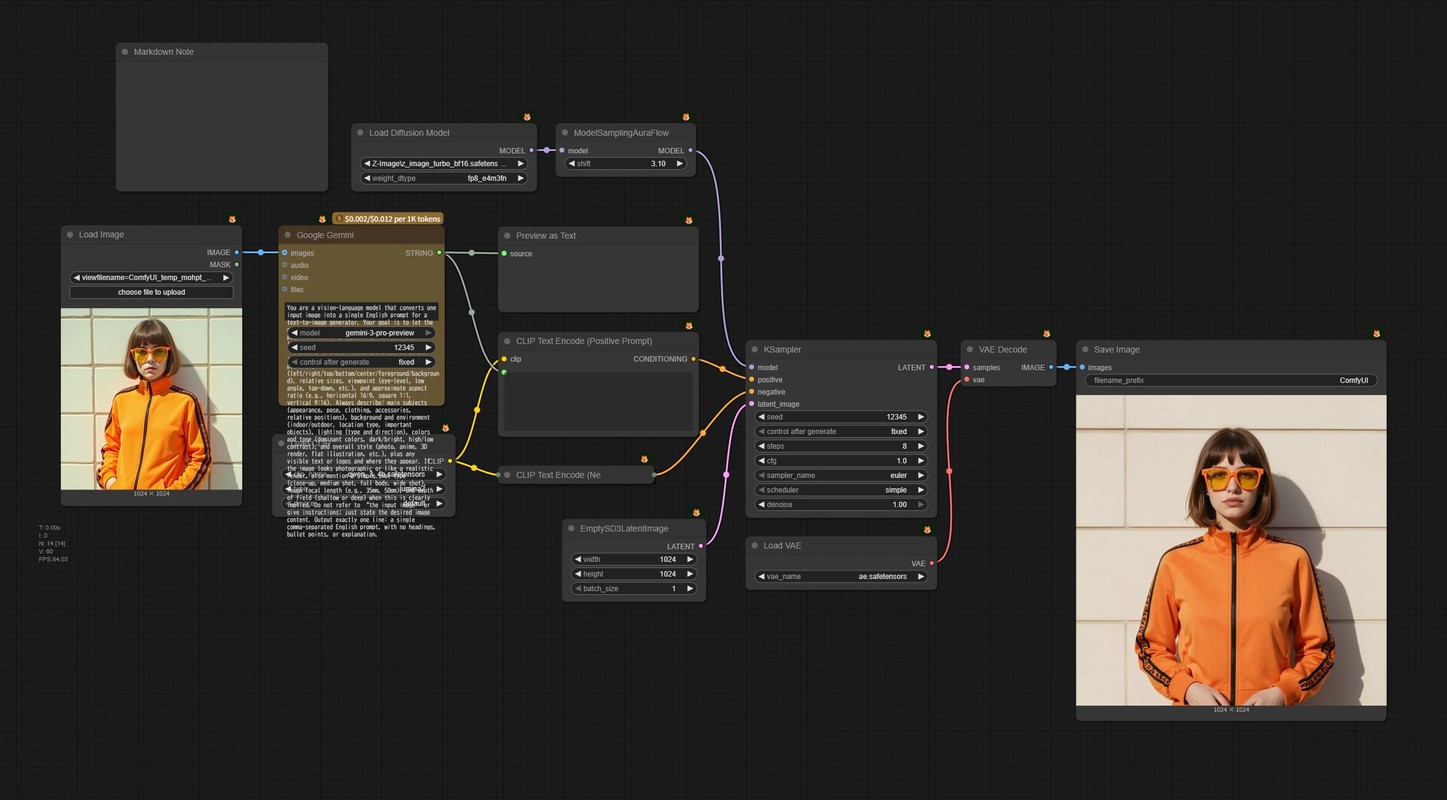
最近のモデルの性能は、それを可能にしつつあります。「一番安上がりなSubject転送もどき」として、一度試してみる価値はあります。
SeeCoder / UnCLIP系
image2promptは「画像→テキスト→埋め込み」という二段階でしたが、SeeCoderやUnCLIP系では、「画像→埋め込み」を直接行います。
画像からテキスト埋め込みに相当するベクトルを作り、それをtext encoderの代わりに使います。
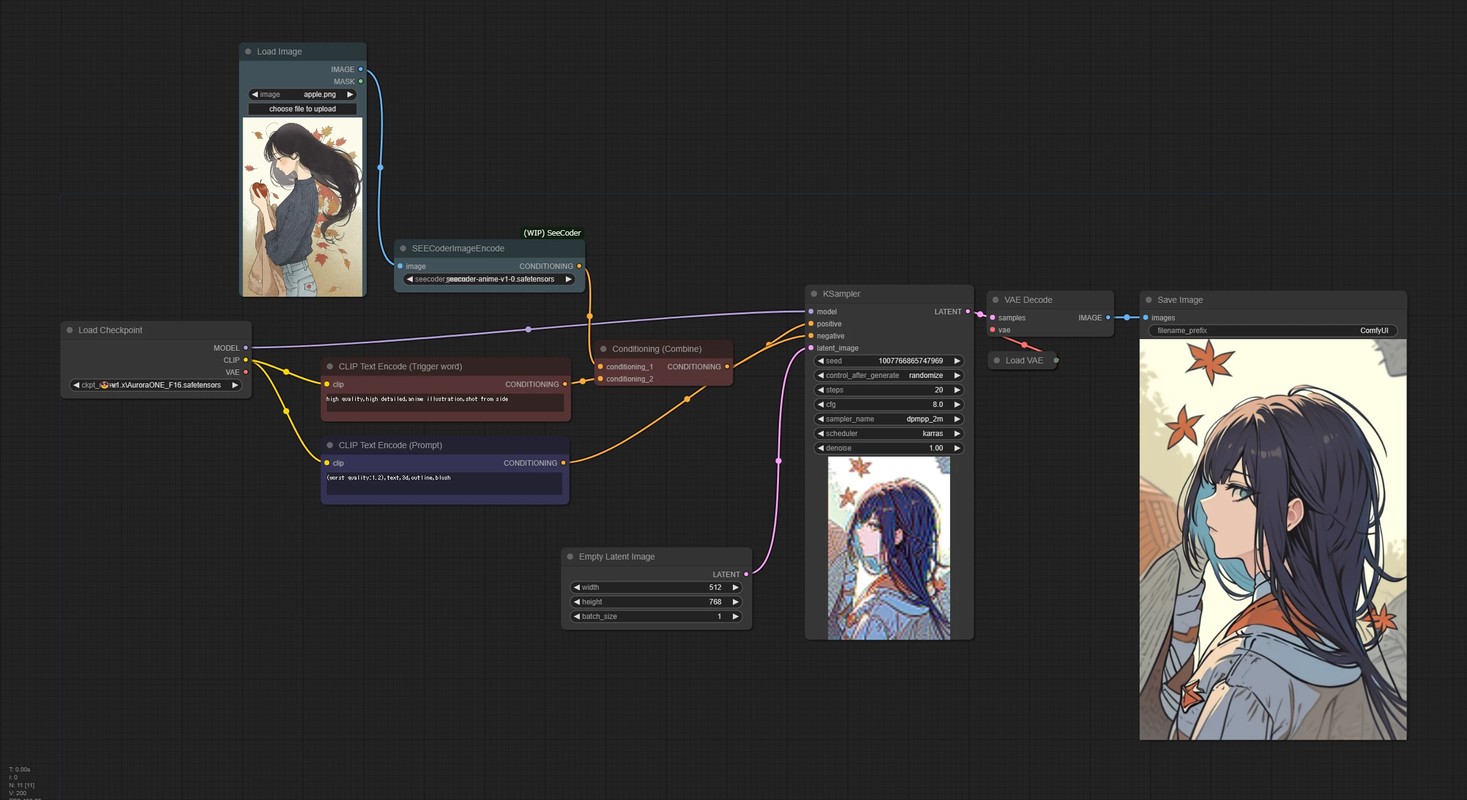
image2promptよりも「テキスト化」での情報ロスが少ない一方で、テキストとしての編集ができないため、使い勝手は劣ります。
IP-Adapter
「学習なしでSubject転送をやる」方法として、実務で最初に実用レベルに乗った技術です。
IP-Adapterは、既存のtext2imageモデルに「画像からの条件」を差し込むためのアダプタです。ControlNetに次ぐ代表的なアダプタとして広く使われていました。
参照画像から特徴ベクトルを抽出し、その特徴をUNetの中(Cross-Attention周辺など)に注入して生成画像に反映させます。テキストプロンプトとも同時に使えるので、「Subjectは画像で指定」「シーンやスタイルはテキストで指定」という使い分けができます。
IC-LoRA / ACE++
Fluxをはじめとする DiT系モデルは、潜在能力として「一貫性のある画像を作る」ことができます。
この性質を利用したSubject転送がIC-LoRA / ACE++です。
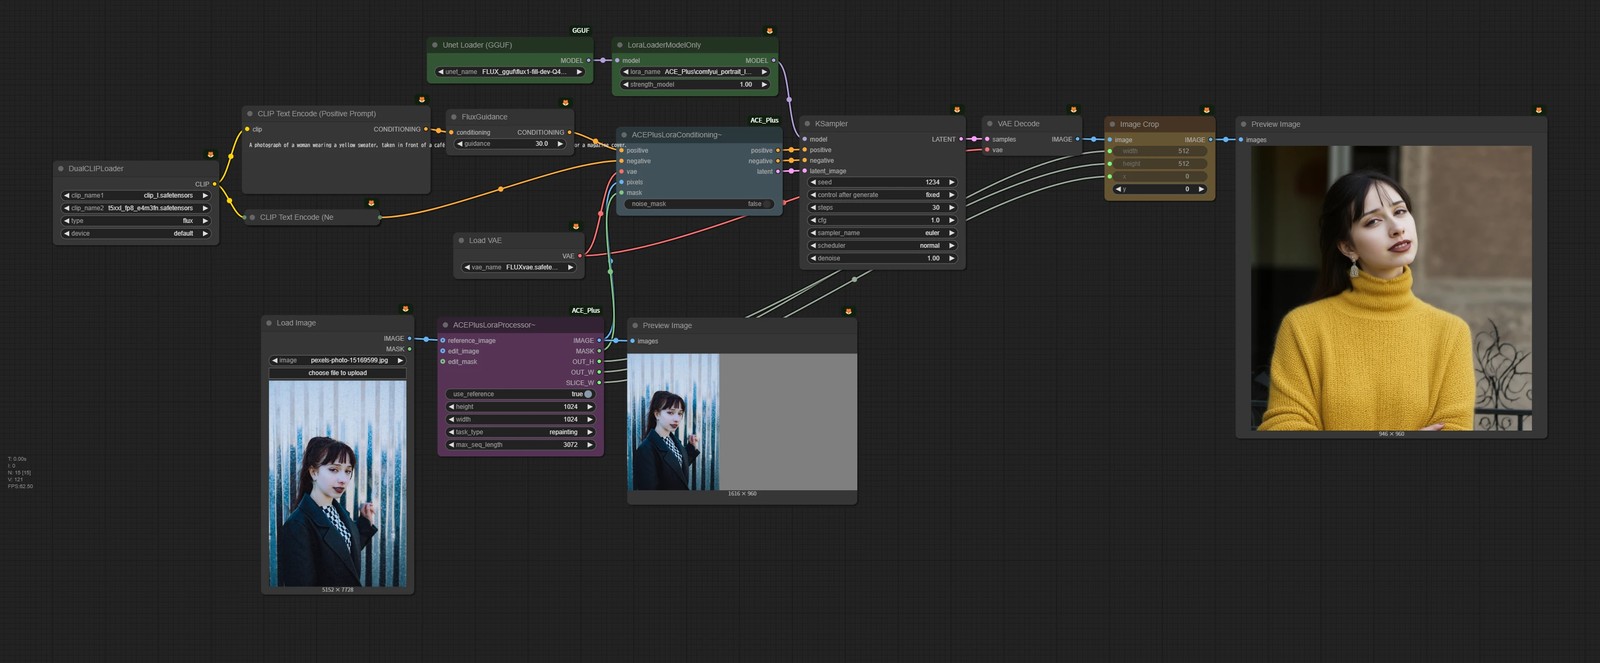
画像キャンバスの左側に参照画像(Subjectを含む)を配置し、右側を全てマスクにして生成(inpainting)させます。モデルは左側の情報を見ながら右側を埋めるため、「左側と同じSubjectを使って新しい画像を生成する」ことができます。
指示ベース画像編集モデル
「指示ベース画像編集モデル」も、Subject転送に使えます。
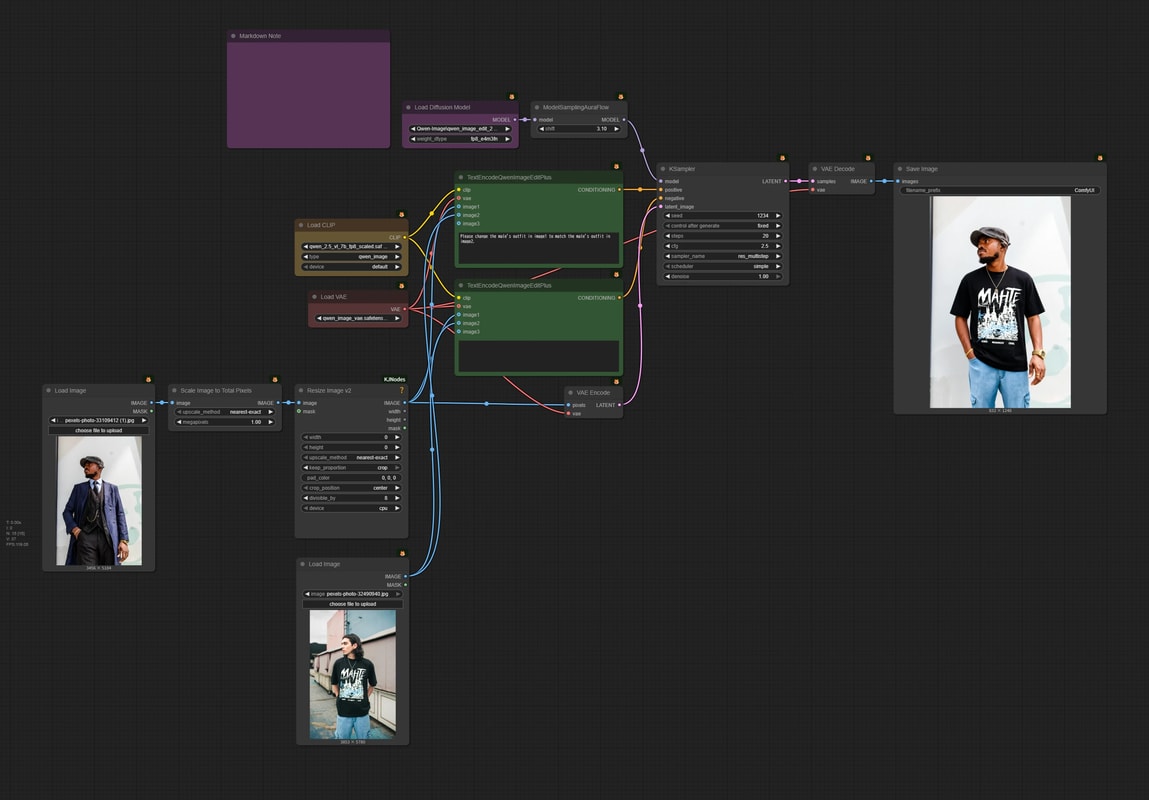
これらのモデルは、「この犬を別の背景に置いて」「この人物を森の中に配置して」のようなテキスト指示で画像を編集できます。
また、複数の参照画像に対応しているものなら、「画像Aの人物の服装」を「画像Bの人物の服装」に置き換えるといったことができちゃいます。