セグメンテーションとは?
セグメンテーションというと実は色々な種類があるのですが、ComfyUIにおける文脈では、ポイントやBBOX、マスク・テキストで指定したオブジェクトの形のマスクを作る技術です。
マッティングとの違い
マッティングに似ていると感じるかもしれませんが、以下の大きな違いがあります。
-
マッティング
- 「前景」か「背景」かの二択でマスクを作る
-
セグメンテーション
- 任意の物体を切り抜く(マスクを作る)ことが目的
ではマッティングがセグメンテーションの下位互換か、というと全くそういうわけではなく、そもそも役割が違います。
- 分類タスク寄りなセグメンテーション
- 透過表現も可能な高品質な切り抜きが出来るマッティング
SAM
Introducing Meta Segment Anything Model 3 and Segment Anything Playground
ComfyUIで「セグメンテーション」といったとき、実際に使われているのはほぼSAM(Segment Anything)系のモデルです。
任意の物体を切り抜く(マスクを作る)ことが目的といいましたが、そのためには、AI が「その物体の形」をある程度理解している必要があります。
例えば机の上にフルーツバスケットが置かれているとして、りんごを切り抜きたいと思っても、「りんご」の形を知っていなければどこまでをりんごとして扱っていいのかがわかりません。これを実現したのが SAM です。
主なモデル
-
SAM
- Meta発表の初期モデル。
- 任意の場所をクリックするだけで、その領域のマスクを返します。
-
- SAMをベースにマスク品質を高めた派生モデルです。
-
SAM 2 / 2.1
- 動画にも対応。動画の中で同じ物体を追跡しながらマスクを出力できます。
-
SAM 3
- テキストで対象を指定することが可能に。
- これまではポイントやBBOXで対象を指定する必要があったため、自動でマスクを作ろうと思うと物体検出と組み合わせる必要があった。
ComfyUIでの使いどころ
切り抜きからinpaintingに至るまで、あらゆる場面で使用します。
他にもSegment Anything Playgroundには、顔をぼかしたり、背景を白黒にしたりといった例がいくつもあります。(ちなみにこれらのほとんどをComfyUIで再現することが出来ます。)
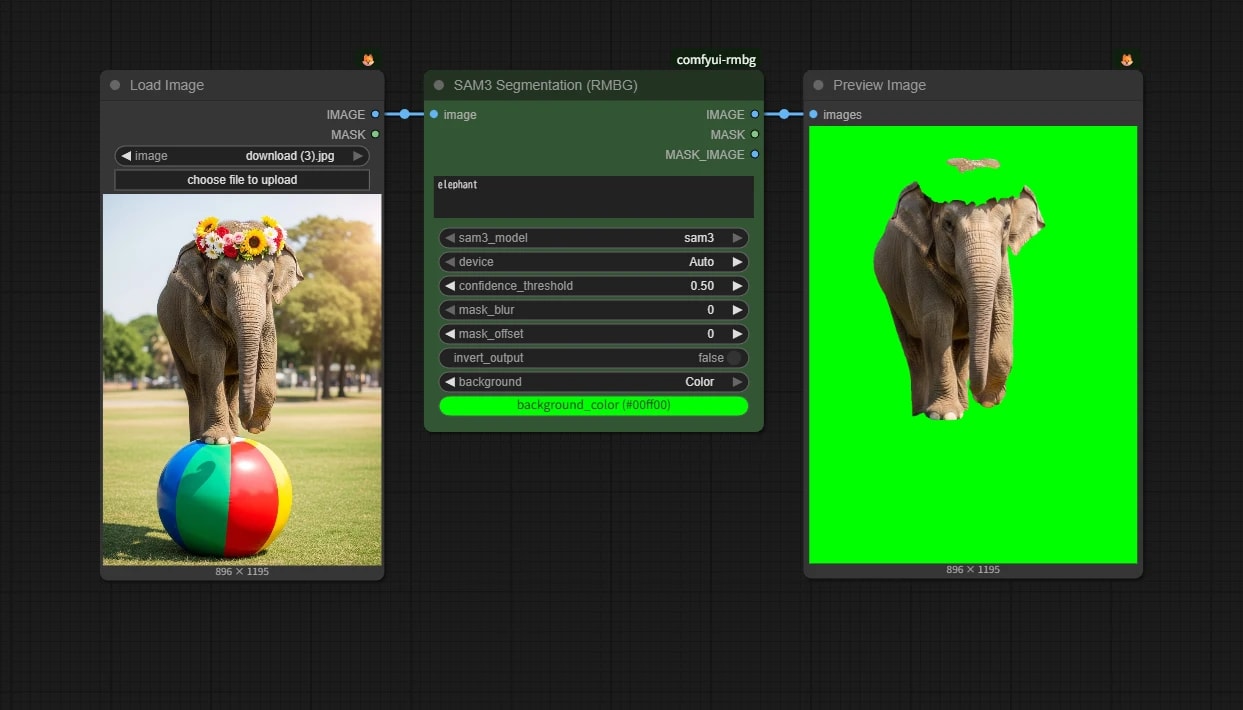
SAM 2.1以前はテキストでのオブジェクト指定ができなかったため、Grounding DINOやFlorence2といった物体検出と組み合わせて使用されることが多かったですね。
SAM 3はテキストでの指定もできますが、物体検出という意味ではSAM以上のモデルは今後も出ると思うので、このコンビネーションは覚えておきましょう。
補足:SAM以前のセグメンテーション
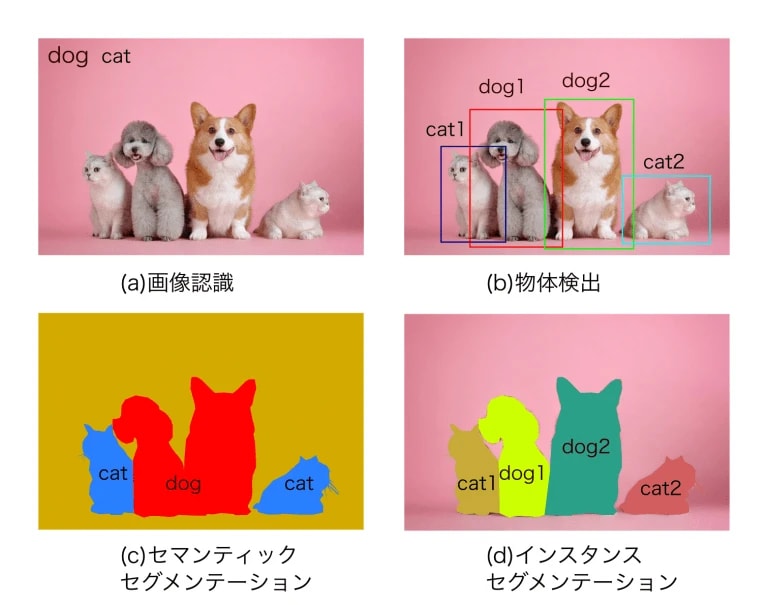
教科書的には、セグメンテーションには次のような分類があります。
-
セマンティックセグメンテーション
- 各ピクセルに「クラスラベル」を付けます。
- person / sky / road / buildingなど。何人いようが、すべて「person」クラスとしてまとめて扱います。
-
インスタンスセグメンテーション
- セマンティックに加えて、「個体ごとのマスク」を分けます。
- person_1 / person_2 / person_3 …と個別に分割します。
SAMはこの2つを同時に行っているようなものですが、これらも自動運転や監視カメラの分野では今でも重要なタスクです。